Moonshot AI a tenu sa promesse en publiant les poids complets de Kimi K3, son modèle le plus vaste et le plus ambitieux à ce jour. Le modèle...
Moonshot AI a tenu sa promesse en publiant officiellement les poids complets de son modèle le plus vaste et le plus ambitieux à ce jour — Kimi K3.
Le modèle est désormais téléchargeable via les pages officielles Hugging Face et GitHub de Moonshot AI, accompagné d’un rapport technique détaillé et d’un projet d’infrastructure complémentaire.
Kimi K3 est un modèle natif multimodal à mélange d’experts, avec 2,8 billions de paramètres totaux, environ 104 milliards de paramètres activés par jeton, et une fenêtre contextuelle d’un million de jetons.
Moonshot le positionne comme un modèle frontal à poids ouverts, conçu pour la programmation longue durée, la recherche, la compréhension multimodale, le travail de connaissance agentique et les tâches de raisonnement pouvant impliquer des centaines ou des milliers d’étapes.
L’importance de cette publication réside dans deux aspects.
Premièrement, le modèle lui-même repousse l’échelle des poids ouverts au niveau des 3 billions de paramètres.
Deuxièmement, Moonshot dévoile bien plus que de simples points de contrôle. Les documents publics décrivent en détail son architecture, ses stratégies de post-entraînement, son infrastructure d’apprentissage par renforcement pour longs contextes, son système d’entraînement parallèle pour experts, ses optimisations d’inférence, ses résultats de benchmarks et plusieurs études de cas d’ingénierie à long terme.
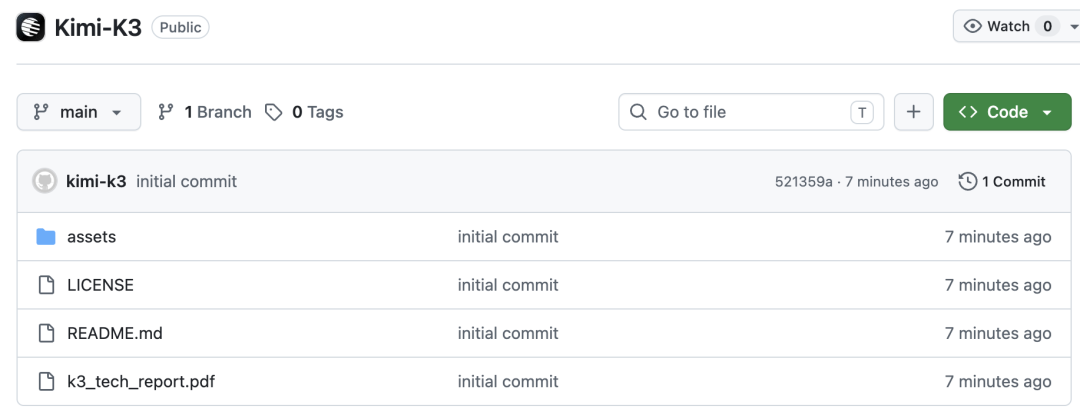
Moonshot avait précédemment annoncé le lancement de Kimi K3, promettant la publication des poids complets avant le 27 juillet 2026.
Cette publication est désormais effective.
Le modèle officiel est accessible via les canaux suivants :
Le dépôt GitHub contient un fichier README, la licence Kimi K3, le rapport technique complet, des ressources d’architecture et de benchmarks, un guide de déploiement et des instructions d’utilisation.
La fiche modèle Hugging Face fournit la configuration du modèle et l’accès aux poids publiés.
Cela signifie que le modèle est passé d’un système frontal hébergé, prévu pour une publication ouverte, à un modèle que les chercheurs et les équipes d’infrastructure qualifiées peuvent effectivement télécharger, inspecter, déployer, affiner et adapter selon les termes de la licence Kimi K3.
Kimi K3 est mieux décrit comme un modèle à poids ouverts avec code et documentation publics.
La licence accorde des droits étendus, permettant aux utilisateurs d’utiliser, copier, modifier, affiner, déployer, créer des œuvres dérivées, redistribuer, sous-licencier et vendre des copies, conformément aux termes de la licence.
Cependant,
la licence inclut des exigences commerciales supplémentaires.
Par exemple, une société exploitant un service de modèle en tant que service (Model-as-a-Service) avec un chiffre d’affaires total supérieur à 20 millions de dollars sur une période de 12 mois consécutifs doit conclure un accord séparé avec Moonshot AI avant d’utiliser Kimi K3 ou ses dérivés à des fins commerciales.
La licence impose également des exigences d’affichage pour certains très grands produits ou services commerciaux dépassant des seuils spécifiques d’utilisateurs ou de revenus.
L’utilisation interne ainsi que celle via les produits officiels de Moonshot ou les partenaires d’inférence certifiés sont traitées différemment.
Par conséquent, toute personne utilisant Kimi K3 à des fins commerciales devrait lire attentivement la licence réelle, plutôt que de supposer qu’elle est équivalente à Apache 2.0, MIT ou d’autres licences permissives standard.
La capacité totale de Kimi K3 est extrêmement vaste, mais sa conception à mélange d’experts (MoE) signifie que tous les 2,8 billions de paramètres ne sont pas activés pour chaque jeton.
La fiche modèle officielle indique ce qui suit :
| Spécification | Kimi K3 |
|---|---|
| Architecture | Mélange d’experts (MoE) |
| Paramètres totaux | 2,8T |
| Paramètres activés | 104B |
| Nombre de couches | 93 |
| Couches denses | 1 |
| Experts routés | 896 |
| Experts sélectionnés par jeton | 16 |
| Experts partagés | 2 |
| Taille du vocabulaire | 160K |
| Longueur de contexte | 1 048 576 jetons |
| Encodeur visuel | MoonViT-V2 |
| Paramètres de l’encodeur visuel | 401M |
| Quantification | MXFP4 poids / MXFP8 activations |
| Modalités | Texte et image |
Le rapport technique fournit une comparaison architecturale plus précise avec Kimi K2.
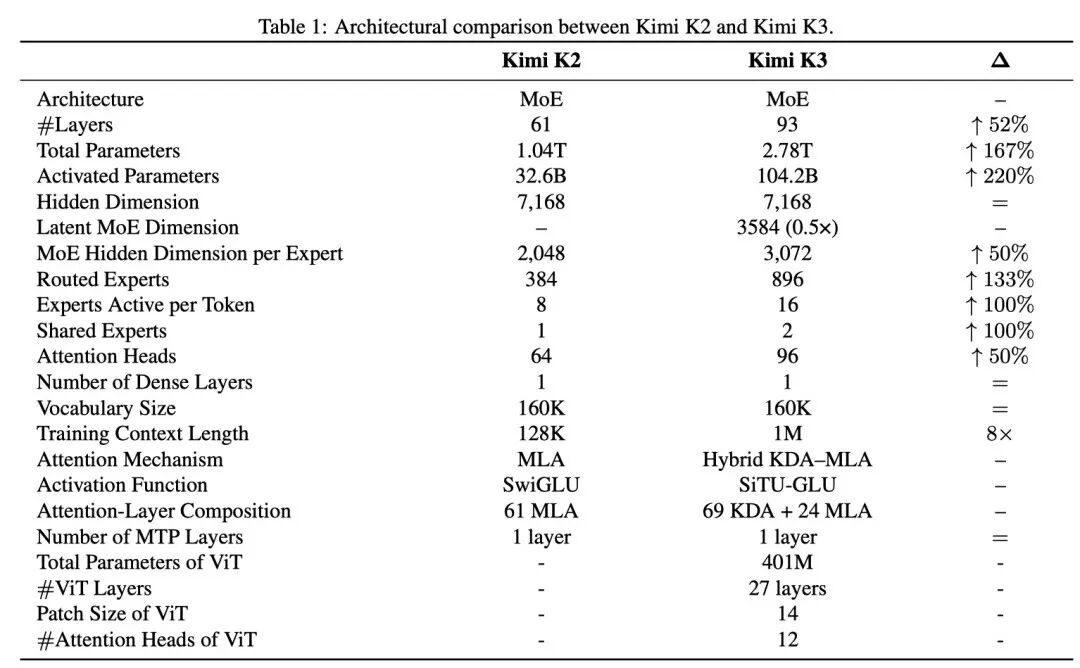
Par rapport à Kimi K2, K3 augmente la profondeur du modèle et la parcimonie des experts, tout en introduisant de nouveaux mécanismes d’attention et de résidu.
Moonshot indique que, grâce à des améliorations combinées de l’architecture et de la méthode d’entraînement sur la base de Kimi K2, l’efficacité globale de passage à l’échelle a été multipliée par environ 2,5.
Cette affirmation fait référence à l’efficacité avec laquelle la capacité de calcul supplémentaire est convertie en capacité du modèle, et non à une augmentation générale de 2,5 fois de la vitesse d’inférence.
Kimi K3 est conçu comme un modèle natif multimodal, et non comme un modèle linguistique auquel un module visuel est ajouté en fin d’entraînement.
Son encodeur visuel MoonViT-V2 compte environ 401 millions de paramètres.
Le rapport technique indique que MoonViT-V2 est entraîné de zéro via l’objectif de prédiction du prochain jeton du modèle, et non initialisé à partir d’un modèle visuel pré-entraîné contrastif comme SigLIP.
Moonshot rapporte que cette méthode reste stable pendant l’entraînement et atteint des performances visuelles compétitives.

La longueur de contexte prise en charge par ce modèle est :
1 048 576 tokens
Cette échelle est particulièrement importante pour les systèmes d'agents, car une tâche de codage ou de recherche de longue durée peut accumuler le contenu du dépôt, les sorties d'outils, les journaux, les captures d'écran, les documents de recherche, les plans intermédiaires, les échecs de test, les résultats de raisonnement antérieurs et les informations de correction multi-tours.
Un contexte de million de tokens ne supprime pas le besoin de gestion de contexte, mais il permet à K3 de conserver un historique de travail bien plus grand que les systèmes traditionnels à contexte court.
Le rapport technique attribue l'échelle et la stabilité de K3 à plusieurs modifications architecturales.
Les trois plus notables sont :
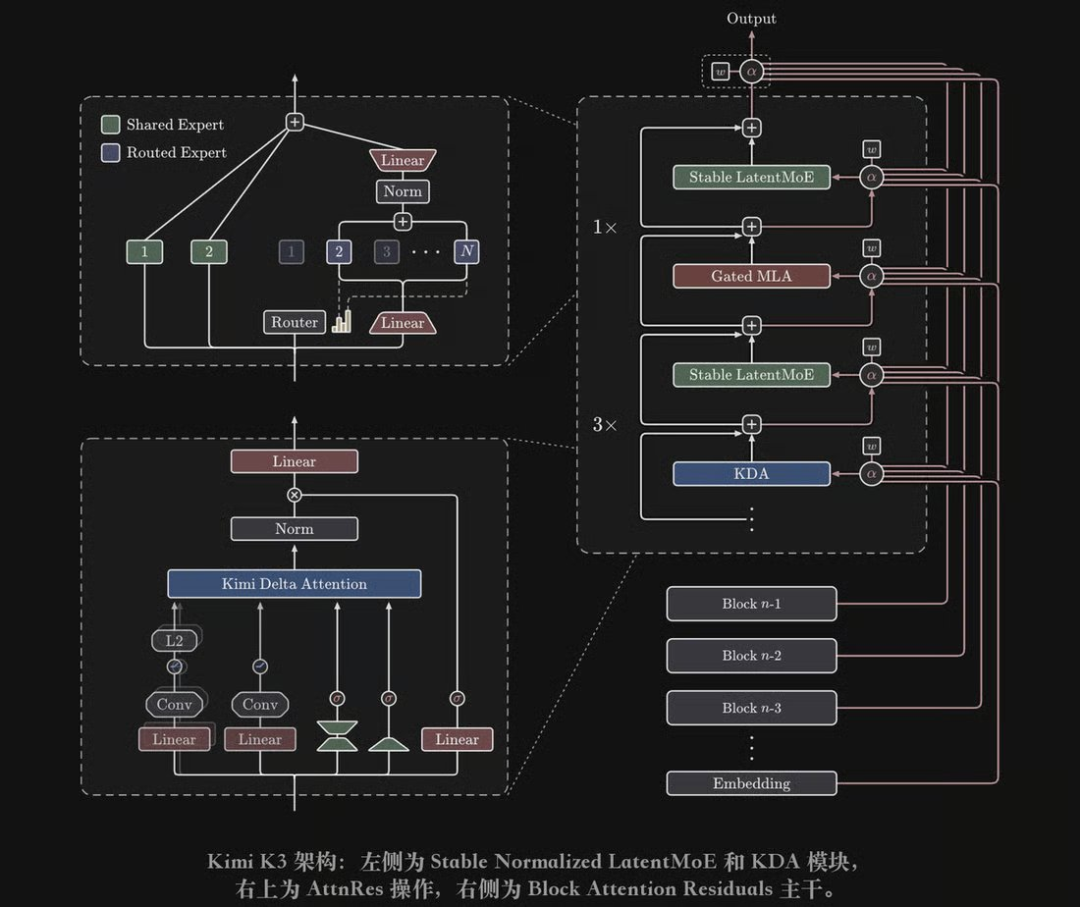
Kimi K3 adopte une conception d'attention hybride.
La fiche officielle du modèle indique :
69 couches KDA + 24 couches Gated MLA
Cette architecture suit un motif répétitif où plusieurs couches d'attention Kimi Delta sont combinées avec des couches périodiques d'attention latente multi-têtes avec portes.
KDA est un mécanisme d'attention linéaire conçu pour réduire la charge mémoire et de calcul associée aux contextes extrêmement longs.
Au lieu de maintenir un cache KV qui croît avec chaque token comme dans l'attention standard complète, KDA conserve un état récurrent.
Cela le rend intéressant pour les séquences de millions de tokens.
Moonshot a précédemment introduit KDA via la série de recherche linéaire Kimi, et l'équipe rapporte que, dans ses conditions d'évaluation, KDA réduit les besoins en cache KV et améliore le débit de décodage pour les longs contextes.
K3 ne remplace pas entièrement l'attention globale.
Les couches Gated MLA périodiques préservent la capacité du modèle à récupérer des informations globalement dans le contexte.
Ainsi, cette conception hybride tente d'équilibrer deux objectifs :
L'idée n'est pas que l'attention linéaire soit toujours meilleure que l'attention globale, mais que chaque mécanisme traite une partie différente du problème des longs contextes.
Les réseaux neuronaux profonds doivent transmettre des informations à travers plusieurs niveaux tout en évitant la perte progressive de représentations utiles.
Kimi K3 introduit le résidu d'attention (AttnRes) pour modifier la façon dont l'information est transmise en profondeur.
Ce mécanisme ne repose pas sur un flux résiduel séquentiel uniforme, mais permet aux modules suivants de récupérer sélectivement les représentations produites par les modules précédents.
Conceptuellement, cela fournit un mécanisme d'apprentissage au réseau, lui permettant de décider quelles informations antérieures doivent rester directement accessibles.
L'objectif est d'améliorer le flux d'informations dans un modèle de 93 couches sans forcer chaque caractéristique à passer exactement par le même chemin résiduel.
Kimi K3 améliore considérablement la rareté du MoE.
Le modèle contient :
896 experts routés
Mais chaque token n'active que :
16 experts routés
De plus, le modèle comprend deux experts partagés.
Cela donne un nombre total de paramètres très élevé, mais le calcul actif est bien inférieur au nombre total de paramètres.
À ce niveau de rareté, la stabilité de l'entraînement et l'équilibre des experts deviennent des problèmes épineux.
La conception du LatentMoE stable de Moonshot intègre plusieurs mécanismes visant à résoudre ces problèmes.
Kimi K3 remplace SwiGLU par SiTU-GLU, une fonction d'activation conçue pour éviter une croissance non bornée en cas d'expansion extrême.

Le système utilise également une méthode d'équilibrage de charge basée sur un biais de routage dynamique, plutôt que de se reposer entièrement sur les fonctions de perte auxiliaires d'équilibrage traditionnelles.
L'objectif est de répartir plus uniformément les tokens routés entre les experts sans introduire trop de perturbations dans l'entraînement.
Le rapport technique de Kimi K3 met particulièrement l'accent sur le post-entraînement pour les agents de longue durée.
Le modèle a été entraîné dans trois domaines :
Il prend également en charge plusieurs niveaux de finesse de raisonnement :
Le modèle final combine plusieurs stratégies spécialisées via le distillation multi-enseignante en ligne par politique (MOPD).
Au lieu d'entraîner des modèles permanents distincts pour chaque domaine et niveau de finesse, Moonshot entraîne des modèles enseignants spécialisés et intègre leur comportement dans une politique unifiée K3.
Le rapport technique décrit AgentENV, une couche d'infrastructure construite pour le déploiement persistant d'agents.
Ce système utilise Firecracker
L'environnement de micro-machine virtuelle permet aux agents d'exécuter de longues séquences d'opérations dans un bac à sable reproductible.
Une tâche d'entraînement peut inclure :
Cela diffère de l'apprentissage par renforcement basé sur de courts échanges de questions-réponses.
Un agent peut exécuter des centaines d'appels d'outils et maintenir un état dans l'environnement simulé pendant plusieurs jours virtuels.
L'article source décrit un environnement simulé impliquant des applications comme Slack, Notion et Gmail.
Le principal défi d'entraînement est la persistance : l'état à long contexte de l'environnement et du modèle doit rester disponible.
Au cours d'un déploiement prolongé.
L'entraînement sur de longues périodes nécessite également un grand nombre de tâches difficiles.
Moonshot décrit un pipeline de génération de tâches organisé autour d'un graphe de connaissances hiérarchique.
Ce graphe couvre plusieurs domaines : informatique, intelligence artificielle, programmation, mathématiques, physique, chimie, biomédecine et sciences humaines.
Les concepts connexes peuvent être échantillonnés ensemble, les documents publics pertinents sont récupérés, puis de nouvelles tâches d'évaluation ou d'entraînement sont synthétisées à partir de ces documents.
L'objectif du graphe est de créer des tâches nécessitant une utilisation réelle d'outils et un raisonnement en plusieurs étapes, et non pas simplement de mémoriser des réponses.
Un modèle de 2,8T avec une fenêtre de contexte de million de jetons ne peut pas être entraîné et servi efficacement par la seule architecture du modèle.
Le rapport technique de Moonshot décrit des travaux système couvrant les noyaux KDA, le parallélisme de contexte, le parallélisme d'experts, la gestion de la mémoire, l'ordonnancement RL à long cycle, la mise en cache de préfixes, le décodage spéculatif et le contrôle d'admission de service.
Certaines parties sont déjà publiques.
MoonEP est une bibliothèque de communication pour le parallélisme d'experts open-sourcée par Moonshot.
Dans l'entraînement MoE, le routage peut être fortement déséquilibré.
Comme le routeur préfère certains experts, un rang peut recevoir beaucoup plus de jetons qu'un autre. Lorsque cela se produit, l'appareil le plus rapide doit attendre le plus lent.
MoonEP utilise des experts redondants dynamiques pour résoudre ce problème.
Il peut créer des copies temporaires d'experts en fonction du schéma de routage actuel, afin d'équilibrer la charge de travail des jetons sur chaque rang.
Le projet décrit son objectif comme faisant en sorte que chaque rang reste exactement à la charge de jeton de routage prévue, tout en réduisant la surcharge de communication.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
C'est crucial à l'échelle de K3, car répartir 896 experts dans un grand cluster pose d'énormes problèmes de synchronisation.
FlashKDA fournit des noyaux d'attention Kimi Delta haute performance basés sur CUTLASS.
Le dépôt public actuel liste les exigences suivantes :
SM90 ou version ultérieure
CUDA 12.9 ou version ultérieure
PyTorch 2.4 ou version ultérieure
Le dépôt contient des tests de correction et des données de référence pour le matériel pris en charge.
FlashKDA vise à accélérer le mécanisme d'attention qui rend pratique l'architecture à long contexte de K3.
Kimi K3 utilise un entraînement conscient de la quantification dès la phase de superviser fine.
La configuration officielle liste :
Poids MXFP4
Activations MXFP8
Cela diffère de l'entraînement d'un modèle entièrement haute précision, puis de la quantification après l'entraînement.
Le modèle est entraîné à fonctionner directement avec ces formats de précision inférieure dans le pipeline.
Cela aide à réduire la mémoire et la surcharge de communication.
exigence, mais cela ne transforme pas le modèle 2,8T en un modèle de bureau ordinaire.
Les poids sont publics, mais « téléchargeable » ne signifie pas « facile à exécuter sur un ordinateur portable ».
Kimi K3 a un total de 2,8 billions de paramètres.
Même avec une activation sparse et des formats de faible précision, l'exécution du modèle complet nécessite une grande quantité de mémoire d'accélérateur agrégée, des interconnexions de dispositifs à haute bande passante, un parallélisme d'experts, un moteur d'inférence compatible, et une prise en charge efficace de KDA, MLA et MoE.
Le dépôt officiel de Moonshot recommande :
L'écosystème évolue encore rapidement. La prise en charge peut dépendre de solutions, noyaux, schémas de quantification et matériel spécifiques.
Avant de construire un environnement auto-hébergé, veuillez confirmer la documentation de déploiement la plus récente de Kimi K3, et ne supposez pas que les configurations de service Transformer standard fonctionneront.
Pour la plupart des individus et des petites équipes, l'API hébergée peut être beaucoup plus facile que d'exécuter le modèle complet.
Moonshot propose également Kimi K3 via sa plateforme API officielle :
L'identifiant du modèle est :
kimi-k3
Kimi K3 utilise le raisonnement et renvoie le champ reasoning_content.
La fiche modèle officielle décrit trois niveaux d'effort de raisonnement :
low
high
max
Un détail d'implémentation important est l'historique de réflexion conservé.
Pour les workflows d'agents multi-tours, Moonshot indique que les développeurs doivent renvoyer l'intégralité des messages d'assistant précédents (y compris reasoning_content, content et tool_calls) dans la requête suivante.
En supprimer une partie peut nuire à la continuité, car K3 est entraîné à conserver l'historique de raisonnement.
Le rapport technique de Moonshot évalue Kimi K3 sur le raisonnement et les connaissances, le codage, les workflows d'agents et la vision.
Sa propre suite d'évaluation classe K3 comme l'un des modèles disponibles les plus puissants, et en tête dans des tâches spécifiques par rapport à de nombreux systèmes à poids ouverts et propriétaires.
En même temps, le rapport précise clairement que le modèle reste globalement derrière les systèmes propriétaires les plus puissants, en particulier Claude Fable 5 et GPT-5.6 Sol.
Cette nuance est importante.
L'affirmation n'est pas que K3 remporte tous les benchmarks.
La conclusion la plus défendable est que Kimi K3 amène les poids ouverts dans un domaine de performance qui, jusqu'à récemment, était principalement associé aux systèmes propriétaires de pointe.

Plusieurs comparaisons de benchmarks reposent également sur différents outils d'agents, notamment Kimi Code, Claude Code, Codex et les outils officiels de benchmark.
Par conséquent, les scores des benchmarks d'agents ne doivent pas être interprétés comme une pure capacité du modèle.
Résultats de mesure. Les outils environnants, les prompts, la gestion du contexte, les mécanismes de repli et les évaluateurs ont tous un impact substantiel sur les résultats.
Le rapport fournit plusieurs cas destinés à démontrer que K3 est capable d'effectuer un travail d'ingénierie complexe bien au-delà de la complétion de code courte.
Ces cas sont fournis par les développeurs du modèle et doivent être considérés comme des démonstrations, et non comme des garanties de performance générales.
Moonshot rapporte que Kimi K3 a développé MiniTriton, un système de programmation GPU compact de type Triton.
Ce projet inclut une représentation intermédiaire, un pipeline de compilation, la génération PTX, un langage frontal, des composants d'exécution, l'optimisation des noyaux GPU et des primitives d'entraînement distribué.
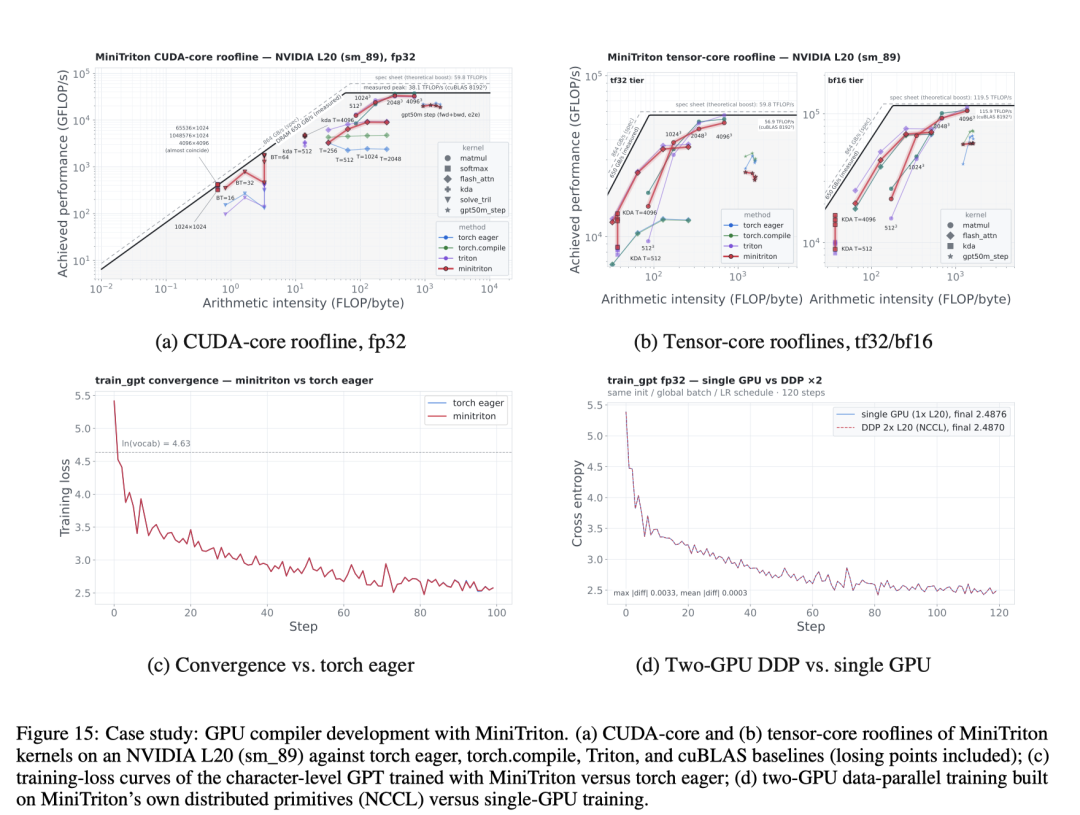
Moonshot indique que K3 optimise également les noyaux complexes liés à sa propre architecture et a obtenu des accélérations significatives sur certains noyaux sélectionnés.
Cela illustre le comportement attendu du modèle : examiner des bases de code complexes, effectuer des analyses de performance, écrire du code de bas niveau, comparer les résultats et itérer pour améliorer.
Mais cela ne signifie pas que chaque compilateur ou noyau généré par le modèle peut être entièrement fiable sans examen ni test humain.
Dans une autre étude de cas, Kimi K3 a été placé dans un environnement sandbox pendant 48 heures et invité à créer un prototype de puce d'inférence pour un petit modèle, dont la conception partage des similitudes avec l'architecture mentionnée ci-dessus.
Le modèle a utilisé des outils de conception électronique open source ainsi que la bibliothèque de cellules standard Nangate 45 nm.
Moonshot rapporte que la simulation finale a été réalisée dans un budget de surface d'analyse de 4 mm², avec une fermeture temporelle à une fréquence d'horloge de 100 MHz, comprenant environ 1,46 million de cellules standard, utilisant 0,277 Mio de SRAM, et atteignant un débit de décodage de plus de 8 700 tokens par seconde via la simulation RTL.
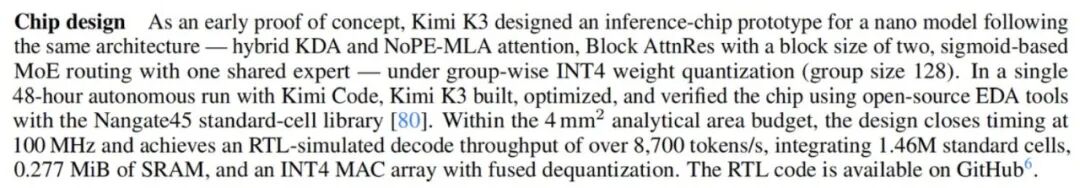
Il s'agit d'une preuve de concept basée sur la simulation, et non d'une puce destinée à la production.
K3 a également été évalué dans une tâche de reproduction en astrophysique computationnelle.
Moonshot indique que le modèle a lu et validé de manière croisée plus de 20 articles, implémenté un pipeline numérique complet, évalué plus de 300 équations d'état, identifié des incohérences dans des formules publiées, écrit plus de 3 000 lignes de code Python et généré un tableau de bord HTML interactif.
Selon le rapport, ce travail autonome a duré environ deux heures, alors qu'un chercheur expérimenté aurait besoin d'une à deux semaines.
Pour les travaux de recherche, la vérification indépendante reste cruciale. Le modèle peut générer un pipeline complet, mais peut encore commettre des erreurs subtiles dans les hypothèses, les unités, les méthodes numériques, les citations ou les interprétations.
Le rapport technique aborde également l'évaluation en cybersécurité.
Moonshot indique que Kimi K3 a découvert, lors de tests de sécurité contrôlés, des vulnérabilités jusqu'alors inconnues dans le noyau Linux, découvertes qui ont été examinées par des experts humains.
L'importance ne réside pas dans l'utilisation de K3 pour des opérations de sécurité offensive non supervisées.
Mais elle montre que les modèles de codage à long cycle sont de plus en plus capables de lire de grandes bases de code, de suivre des comportements de bas niveau, de formuler des hypothèses, de les valider, de corriger les méthodes et de continuer après des échecs.
Ces capacités peuvent soutenir l'audit défensif et la révision de code sécurisé, mais elles rendent également l'autorisation, l'isolation sandbox, le contrôle d'accès et la supervision humaine plus importants.
La valeur d'un modèle ne se mesure pas uniquement par ses scores de benchmark.
Les systèmes d'agents à long cycle peuvent générer des millions de tokens pour une seule tâche.
Par conséquent, le coût dépend de la longueur d'entrée, de la longueur de sortie, de la complexité d'inférence, du taux de hit du cache, du nombre d'appels d'outils, du nombre de tentatives, de la gestion du contexte et du fournisseur d'inférence.
Le rapport technique de Moonshot inclut des comparaisons de scores et de coûts sur plusieurs benchmarks d'agents.
Ces graphiques montrent que K3 présente un rapport coût-efficacité relatif sur certaines charges de travail de test.
Il ne faut pas interpréter cela comme une conclusion générale selon laquelle K3 serait moins cher que toutes les alternatives dans tous les cas.
Dans la planification de production, il convient de mesurer le coût total de réussite d'une tâche, et non seulement le prix par million de tokens.
La publication de Kimi K3 dépasse le simple classement d'un modèle.
Elle ouvre plusieurs domaines de recherche et d'ingénierie difficiles à étudier dans des systèmes uniquement accessibles par API.
Les chercheurs peuvent examiner ou modifier les poids du modèle, le comportement MoE, le mécanisme d'attention basé sur KDA, les mécanismes de contexte long, les composants visuels, le comportement de quantification, les systèmes de service et les stratégies de post-entraînement des agents.
Les équipes d'infrastructure peuvent tester différentes solutions de service.
Les entreprises peuvent évaluer un déploiement privé lorsque l'économie du matériel le justifie.
La communauté peut construire :
De nouvelles solutions d'inférence.
Des variantes quantifiées.
Des modèles dérivés affinés.
Des systèmes spécifiques à un domaine.
Des cadres d'évaluation
Des outils de routage de modèles
Des optimisations spécifiques au matériel
La capacité à construire un écosystème comparable à celui des premières publications importantes de modèles ouverts dépendra du coût d'inférence, du matériel accessible, des conditions de licence, des outils communautaires et de la qualité des petits modèles dérivés.
Confirmez que votre cas d'utilisation relève de : recherche interne, usage commercial, affinage, application embarquée, inférence publique ou modèle en tant que service.
Vérifiez l'architecture de l'accélérateur, la capacité HBM, l'interconnexion, la version CUDA, les besoins en noyaux, le support de quantification, le nombre de périphériques et la topologie de parallélisme des experts.
Utilisez les solutions spécifiques à K3 actuellement disponibles pour vLLM, SGLang ou d'autres voies de service officiellement supportées.
Mesurez la latence de préremplissage, la latence de décodage, le comportement du cache de préfixe, l'occupation mémoire, la capacité de concurrence, le débit et la reprise après panne.
Pour les workflows agent multi-tours, suivez les directives de Moonshot en renvoyant les messages complets de l'assistant (y compris l'état d'inférence et d'appel d'outils).
Effectuez des benchmarks sur vos propres dépôts, workflows de recherche, documents, tâches visuelles, utilisation d'outils et scénarios d'agents.
Se concentrer uniquement sur le prix des tokens peut être trompeur. Il faut calculer le nombre de tentatives, les appels d'outils, la longueur de sortie et le coût de l'intervention humaine.
Les poids complets, le code source, la documentation et le rapport technique de Kimi K3 sont publics. MoonShot le décrit comme un modèle à poids ouverts. Le modèle utilise une licence personnalisée Kimi K3, et non Apache 2.0.
et autres protocoles standard ; les utilisateurs professionnels doivent examiner attentivement les clauses spécifiques.
Les poids officiels sont disponibles sur Moonshot AI sur Hugging Face. Le dépôt source principal et le rapport technique sont consultables sur GitHub.
Kimi K3 compte environ 2,8 billions de paramètres au total. Grâce à son architecture de modèle à experts clairsemés, environ 104 milliards de paramètres sont activés par token.
Le modèle officiel prend en charge un contexte allant jusqu'à 1 048 576 tokens. Le déploiement en contexte long nécessite encore beaucoup de mémoire et d'infrastructure d'inférence, en particulier dans les scénarios concurrents.
Le modèle complet de 2,8T ne peut pas fonctionner sur un GPU grand public classique. Même avec une activation clairsemée et une quantification basse précision, les poids complets et la pile de services nécessitent une infrastructure multi-accélérateurs de grande envergure.
Le dépôt officiel de Moonshot recommande d'utiliser vLLM, SGLang et TokenSpeed via le guide de déploiement dédié à K3. Étant donné que ce modèle utilise les optimisations KDA, MLA, MoE et MXFP4, il est nécessaire de vérifier les versions actuellement prises en charge avant le déploiement.
MoonEP est une bibliothèque de communication parallèle pour experts open source de Moonshot, utilisée pour équilibrer la charge des tokens MoE entre les GPU. FlashKDA est un noyau d'attention Kimi Delta haute performance construit sur CUTLASS.
Pas dans tous les domaines. Le rapport technique de Moonshot indique que Kimi K3 a atteint des performances de pointe et est en tête sur certaines tâches spécifiques, mais reste globalement en retard par rapport aux systèmes propriétaires les plus puissants. Les résultats des benchmarks dépendent également du cadre d'agent, des outils, des réglages d'inférence et des méthodes d'évaluation.
kimi-k3.Moonshot AI a désormais publié les poids complets de Kimi K3, transformant ce modèle de pointe de 2,8 billions de paramètres en un système que les chercheurs et les équipes d'infrastructure peuvent inspecter, déployer, affiner et étendre sous la licence Kimi K3.
Le modèle combine 104 milliards de paramètres activés, une fenêtre contextuelle de 1 million de tokens, une multimodalité native, un mécanisme d'attention hybride KDA/Gated-MLA, une attention résiduelle, un MoE latent stable, un entraînement conscient de la quantification et un post-entraînement d'agent à long horizon.
Tout aussi important, cette publication révèle une partie de l'ingénierie système derrière le modèle à travers des projets comme MoonEP et FlashKDA. K3 reste un modèle extrêmement exigeant en auto-hébergement, et ses meilleurs résultats doivent être interprétés dans le contexte du choix du cadre et de l'exécution par les développeurs.
Évaluation.
Le véritable jalon n’est pas simplement l’existence d’un modèle de 2,8T – c’est qu’un modèle de cette ampleur soit désormais disponible pour que la communauté au sens large puisse l’examiner, l’exécuter et construire à partir de lui.
Partez d’une phrase et obtenez un site complet en quelques minutes.



