For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/matrix-game-4-0-rtx-5090-neural-rendering-59d3cc6b.md.
Matrix-Game 4.0 de Skywork AI sépare deux fonctions faciles à confondre dans un jeu généré par IA. Un moteur exécutable maintient les règles...
Matrix-Game 4.0 de Skywork AI sépare deux fonctions faciles à confondre dans un jeu généré par IA. Un moteur exécutable maintient les règles et l’état physique ; un modèle vidéo causal transforme les images low-poly du moteur en images plus détaillées.
Cette séparation constitue l’idée centrale du projet. Si un personnage ramasse un bouclier, subit des dégâts ou termine une mission, le moteur décide de ce qui s’est produit. Le moteur de rendu neuronal est responsable de l’apparence, au lieu de faire des pixels générés l’autorité finale sur le score ou la santé du joueur.
La publication comprend également un chemin d’inférence sur une seule RTX 5090. Les questions importantes sont de savoir ce que mesurent les démonstrations, quelles capacités sont réellement présentes dans le code publié et dans quelle mesure les modèles téléchargeables restent spécialisés.
Un modèle vidéo peut générer des mouvements convaincants sans fournir une représentation fiable de chaque règle de jeu. Une image visuellement plausible ne permet pas nécessairement d’établir où se trouve un ennemi, à qui appartient un objet ou si une collision doit mettre fin à la partie.
Matrix-Game 4.0 conserve ces faits dans le code. Le moteur traite les entrées, fait évoluer le monde et produit une vue RGB low-poly relativement peu coûteuse. Le modèle vidéo génère ensuite la présentation visuelle finale à partir de cette entrée structurée.
Le dépôt officiel appelle cette approche un gameplay ancré dans le moteur et un rendu neuronal en streaming. Il s’agit d’un système hybride, et non de l’affirmation selon laquelle le modèle aurait appris et exécuterait de manière fiable tous les aspects d’un moteur de jeu généraliste en interne.
Une erreur visuelle ne modifie donc pas directement l’état sous-jacent des collisions ou du gameplay. Elle peut néanmoins dérouter le joueur ; cette architecture sépare ainsi deux modes de défaillance au lieu d’éliminer toutes les erreurs.
La page du projet présente une architecture associant un agent de codage et un moteur de jeu. Les instructions de l’utilisateur peuvent être transformées en nouvelles règles ou en prompts, tandis que le moteur fournit l’état nécessaire pour préserver la cohérence du monde.
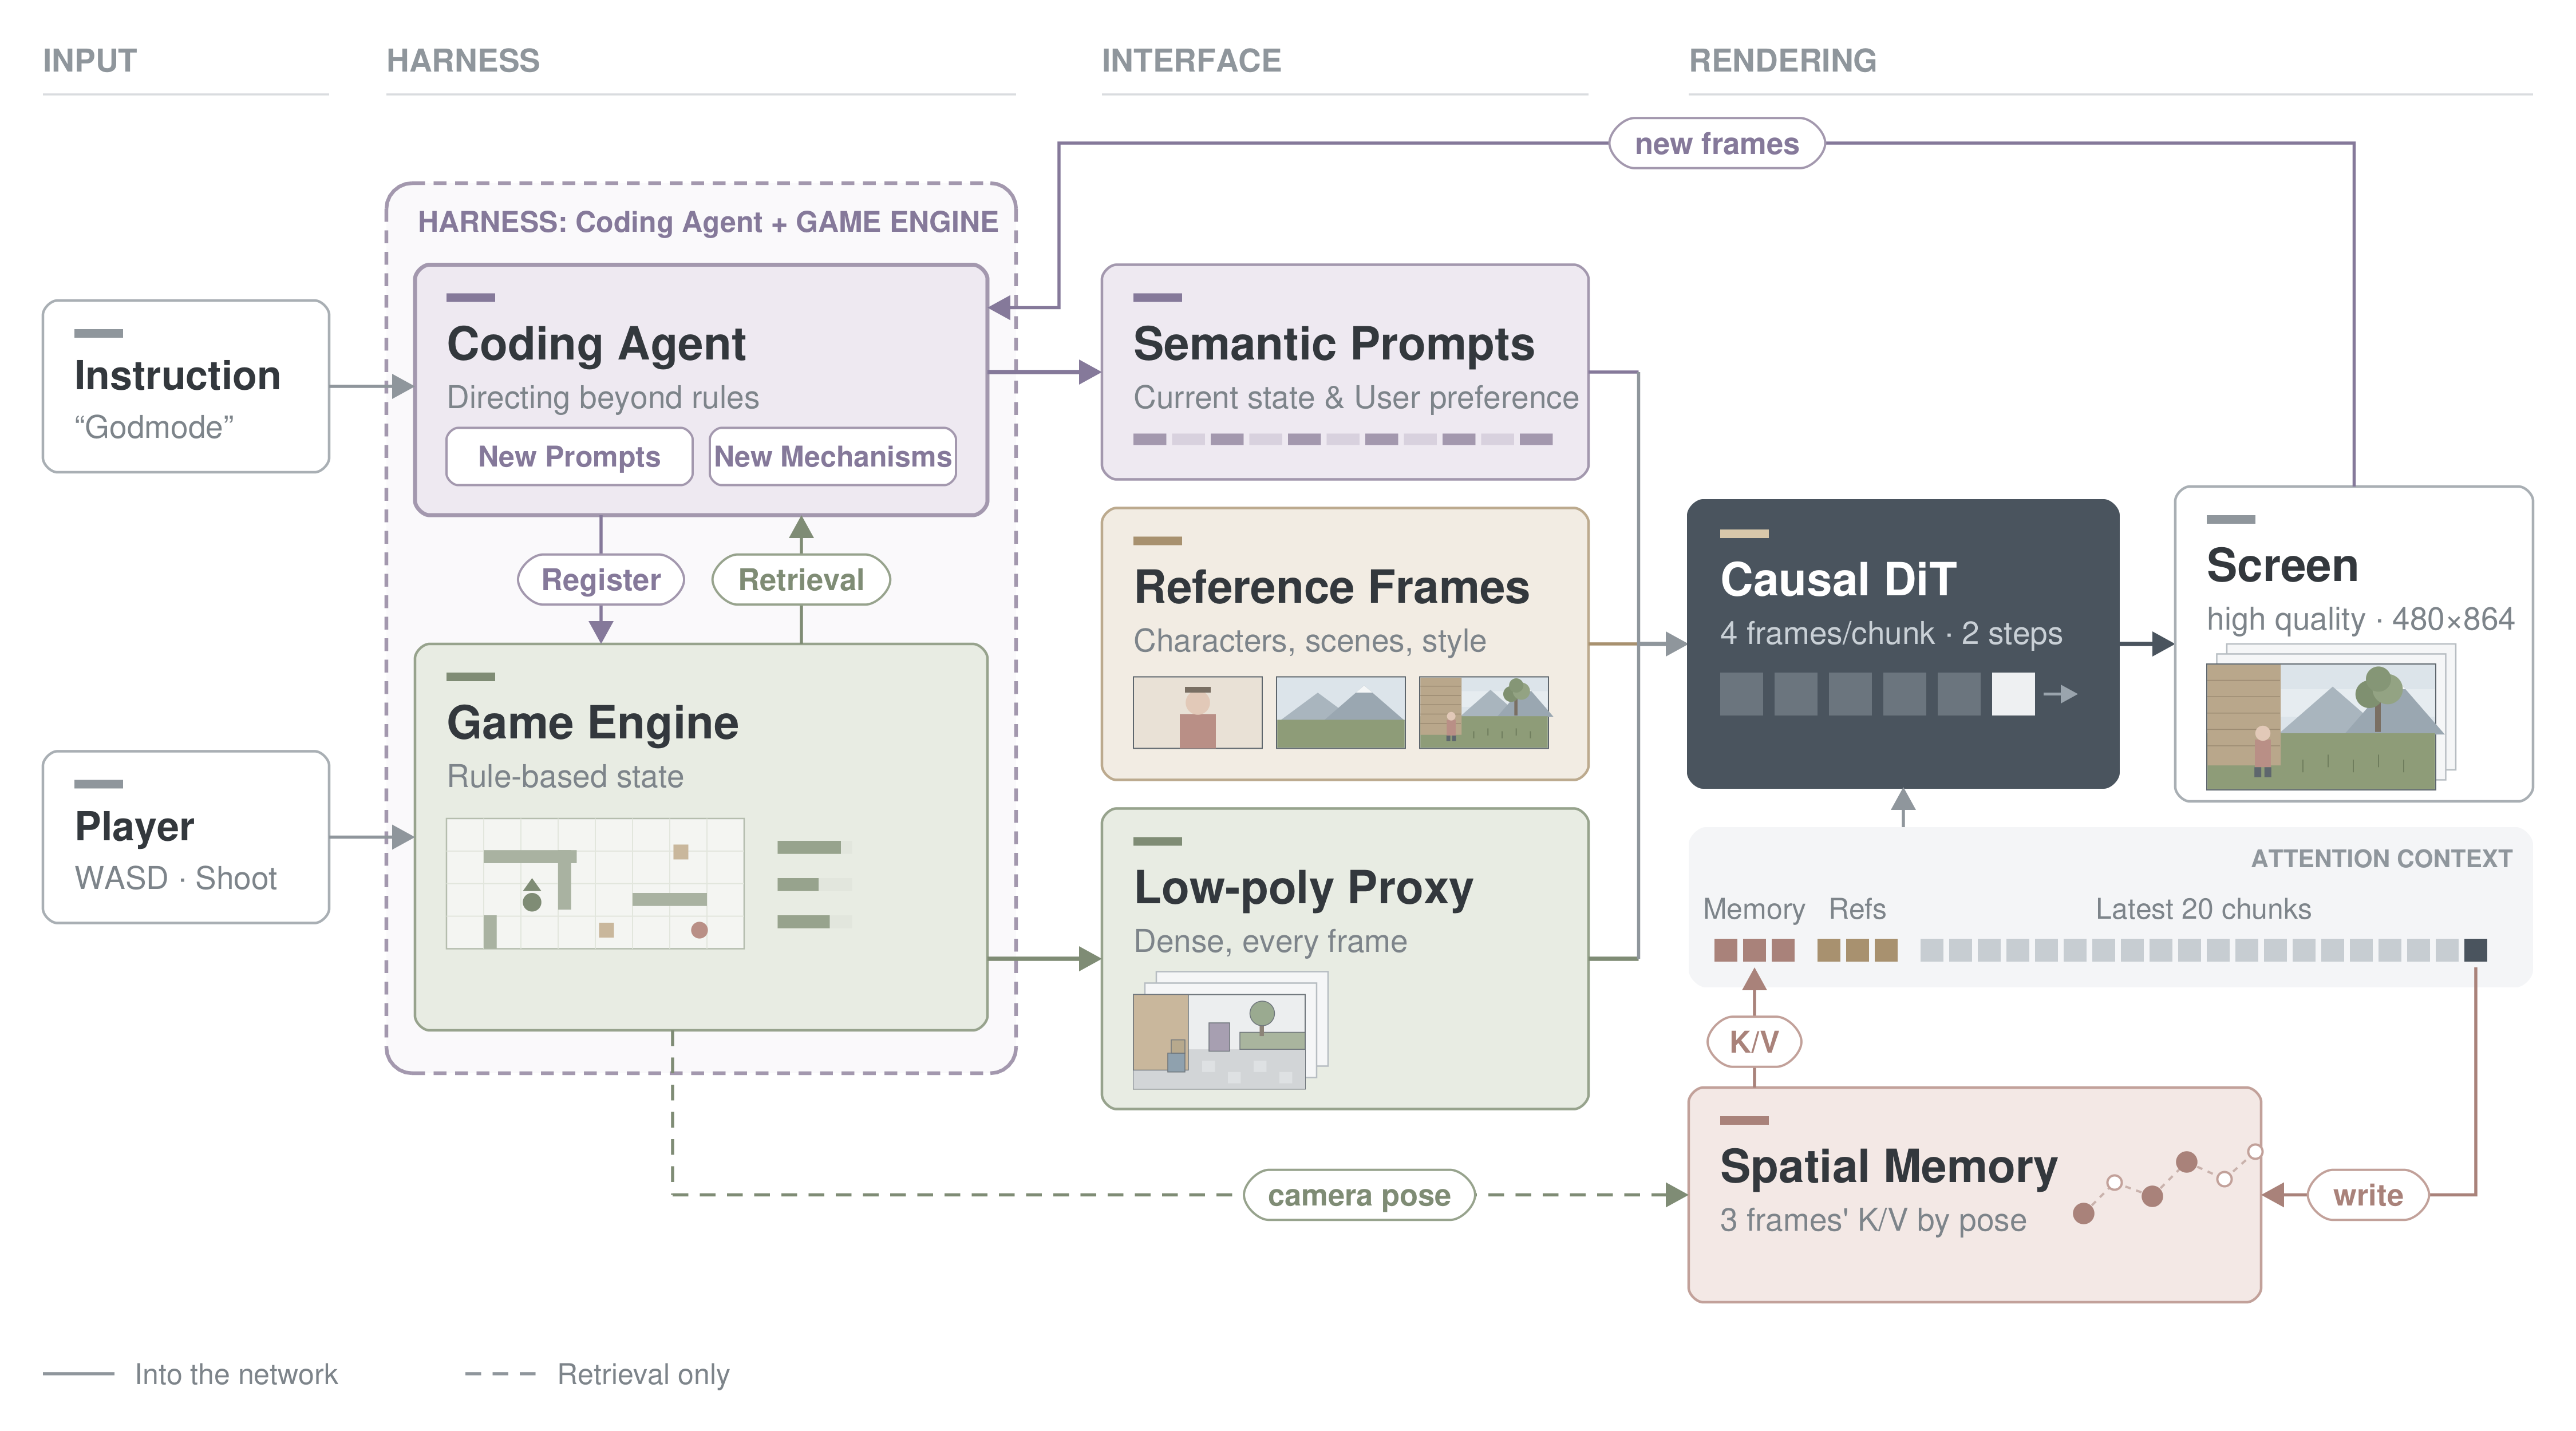
Source : page du projet Matrix-Game 4.0, Skywork AI. Cette figure conceptuelle inclut la récupération de mémoire spatiale ; le runtime du shooter publié présente un comportement plus restreint, décrit ci-dessous.
À haut niveau, le flux de travail est le suivant :
Les exemples de QbitAI incluent la durabilité d’un bouclier qui précède une perte de santé, ainsi qu’une course transformée d’un contre-la-montre en poursuite. Ils illustrent l’avantage de règles explicites : modifier le gameplay implique de changer et de tester le code, et non de simplement demander au modèle vidéo de représenter un résultat différent.
La fiche de modèle Hugging Face décrit trois renderers spécialisés par scène : Medieval Castle, Ancient Egypt et City Racing. Chaque checkpoint contient environ cinq milliards de paramètres BF16 et nécessite le code source d’inférence de Matrix-Game 4.0.
Ces poids ne sont pas des pipelines Diffusers prêts à l’emploi. La publication fournit le code d’inférence, une démonstration dans le navigateur, le code source du jeu natif, les modèles et les ressources de jeu, tandis que la fiche de modèle indique explicitement que le code d’entraînement et les données d’entraînement ne sont pas inclus.
La sortie est en RGB 480 par 864. Après le démarrage, un segment latent correspond à quatre images RGB ; le segment de démarrage contient une image. Les ressources partagées fournies et les politiques spécifiques aux scènes sont importantes ; des codecs arbitraires ou la configuration de référence d’une autre scène ne constituent donc pas des remplacements équivalents.
Les éléments HUD et l’audio restent des couches de présentation séparées, alignées sur les images. Le modèle ne génère pas tous ces composants simplement parce qu’ils apparaissent ensemble dans une démonstration finalisée.
L’illustration du projet inclut une mémoire spatiale récupérée par pose de caméra ainsi que des descriptions sémantiques dynamiques. Le contrat de runtime actuel est plus précis : la configuration shooter publiée utilise un prompt de scène fixe et un cache borné, et indique explicitement l’absence de mémoire récupérée ou de génération dynamique de prompts dans cette configuration.
City Racing prend en charge des légendes fixes ou dynamiques, alignées sur les segments et fournies par le moteur. Le conditionnement dynamique conserve l’encodeur de texte et met à jour les entrées du cache liées au texte lors des changements de légende, ce qui a un coût en débit.
Cette distinction évite de transformer un diagramme de recherche attrayant en une liste de fonctionnalités inexacte pour la démonstration téléchargeable. Vérifiez la scène et le préréglage utilisés avant de supposer qu’un mécanisme présenté fonctionne dans ce chemin d’exécution.
Le rapport source regroupe l’ingénierie autour de la réduction de ce que le modèle doit inférer, mémoriser et calculer. Les documents officiels confirment les principaux mécanismes : conditionnement visuel low-poly, informations de référence, cache borné d’historique récent et génération causale en peu d’étapes.
Au lieu de synthétiser une scène à partir du seul texte, le modèle reçoit une structure rendue par le moteur. Les objets et le mouvement de caméra arrivent ainsi sous forme de contraintes visuelles. Le conditionnement textuel ajoute une sémantique de scène, le mode publié variant selon la scène.
Pour l’inférence, le chemin temps réel utilise le codec TAEHV, une étape de débruitage, une exécution DiT optimisée et des graphes CUDA. Le préréglage qualité utilise l’encodage et le décodage Wan, deux étapes de débruitage et un DiT natif. La documentation avertit que ces modes présentent des coûts de qualité et de calcul différents.
Sur RTX 5090, les préréglages dédiés convertissent les poids linéaires des blocs DiT en FP8 au chargement et quantifient les activations durant l’inférence. Les embeddings et la tête de sortie restent en BF16. Le mode simple rtx5090 utilise PyTorch SDPA ; rtx5090-sage nécessite une version supplémentaire corrigée de SageAttention.
La page du projet présente une démonstration RTX 5090 en une étape avec les chiffres suivants. Ils décrivent la configuration présentée, et non une garantie de fréquence d’images pour chaque scène ou ordinateur.
| Chiffre de la page du projet | Ce qu’il mesure ou décrit |
|---|---|
| 83 FPS | Démonstration de débruitage en une étape sur RTX 5090. |
| 48 ms | Débruitage d’un segment, correspondant à quatre images RGB après le démarrage. |
| 112 ms | Temps entre une pression de touche et la première image réagissant dans la démonstration rapportée. |
| 480p | Catégorie de résolution de sortie du streaming. |
| Un GPU | Encodeur de texte, DiT et VAE résidents dans la configuration présentée. |
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
QbitAI rapporte en outre environ 57 FPS avec un débruitage en deux étapes, environ 18,5 Gio de mémoire GPU maximale et un gameplay présenté à 60 FPS. Ce sont des chiffres rapportés par la source ; ils ne doivent pas être combinés comme si chaque mode atteignait simultanément l’ensemble de ces résultats.
Les exemples de navigateur du README actuel utilisent --fps 40, mais le décrivent explicitement comme une cadence cible de capture du jeu, et non comme une garantie mesurée de débit de rendu ou de latence. Le démarrage et le préchauffage diffèrent également de l’inférence en régime stabilisé.
L’encodage vidéo, la mise en mémoire tampon, le transport et le décodage dans le navigateur ajoutent du travail au-delà du temps de débruitage du modèle. Pour cette raison, une valeur d’inférence par segment, le débit du pipeline serveur et la latence entre action et affichage sont des métriques différentes.
La source compare également le système à une autre configuration de recherche NVIDIA. Sans matériel, résolution, qualité et définitions de latence identiques, ces chiffres n’établissent pas un classement universel équitable.
Le README v4 documente Linux avec un GPU NVIDIA et Python 3.12 pour l’inférence, ainsi que l’environnement PyTorch, CUDA et pilote correspondant. Une démonstration dans le navigateur nécessite également le jeu natif et les dépendances média sur l’hôte. Le client navigateur n’a pas besoin de son propre GPU d’inférence.
Avant une première exécution :
Matrix-Game-4/, et non depuis le répertoire parent.Le téléchargeur mappe les dossiers de scènes du Hub vers des chemins d’exécution ; le nom d’un dossier sur Hugging Face ne suffit donc pas pour déduire la structure du répertoire local. Les manifestes officiels vérifient la taille des fichiers et le SHA256 avant d’installer une ressource.
La publication ne prévoit qu’une session active et un modèle de scène par processus serveur. Son README la décrit comme une démonstration mono-utilisateur de confiance, avec des valeurs par défaut en loopback, plutôt que comme un service public de cloud gaming authentifié. N’exposez pas directement ses services HTTP, RTSP et WebRTC sur Internet.
Le code source v4 est sous licence Apache-2.0. La fiche de modèle identifie également les poids de scènes du projet, les images de sink et les ressources de jeu comme étant sous licence Apache-2.0, tandis que les ressources partagées et le matériel tiers conservent leurs propres conditions. TAEHV possède une mention MIT, et l’audio de City Racing comprend des exigences d’attribution pour certaines ressources.
Il s’agit d’un ensemble conséquent de matériel téléchargeable, mais ce n’est pas une publication complète de l’entraînement. Respectez les licences applicables et les crédits audio lors de la redistribution de travaux fondés sur le projet.
Les modèles sont spécialisés pour les scènes et profils de caméra fournis. La fiche de modèle indique des dérives d’apparence et des erreurs de géométrie avec des géométries inédites, des mouvements rapides, des occultations et de longues sessions, et elle ne garantit explicitement ni fréquence d’images, ni compatibilité mémoire, ni reconstruction exacte de scène.
Matrix-Game 4.0 constitue donc une plateforme concrète pour tester le rendu neuronal ancré dans un moteur. Il ne doit pas être décrit comme un générateur de jeux universel, un service multijoueur éprouvé ou un système qui élimine le besoin de développement de jeux conventionnel.
La publication officielle inclut un chemin d’inférence optimisé pour RTX 5090 et présente des démonstrations sur un seul GPU. Les performances et la compatibilité mémoire dépendent de la configuration documentée, et la fiche de modèle ne les garantit pas pour chaque charge de travail.
Non, le moteur de jeu exécutable gère le gameplay et l’état physique. La sortie neuronale peut contenir des erreurs visuelles sans modifier directement les calculs de collision ou de règles du moteur.
La fiche de modèle indique explicitement que ce n’est pas le cas. Elle inclut des checkpoints de scènes et des ressources utilisées avec l’inférence publiée et le code source du jeu, ce qui constitue un périmètre différent de la reproduction de l’entraînement du modèle.
--fps 40 garantit-il 40 images affichées par seconde ?Non, le README le définit comme une cadence de capture cible. L’encodage, le transport, la mise en mémoire tampon, le décodage dans le navigateur et l’inférence peuvent affecter la présentation finale et la latence.
Le diagramme conceptuel du projet inclut ce mécanisme, mais le contrat de runtime actuel indique que la configuration shooter publiée n’utilise pas de mémoire récupérée. Le mode de légendes dynamiques de City Racing est également distinct du chemin à prompt fixe du shooter.
La publication documente une session active par processus serveur et décrit une démonstration mono-utilisateur de confiance. Ses services ne doivent pas être exposés directement sur Internet comme si l’authentification et les protections nécessaires à un service public étaient déjà fournies.
Matrix-Game 4.0 utilise un moteur exécutable pour maintenir le jeu, tandis qu’un modèle vidéo causal en rend l’apparence. La publication sur un seul GPU fournit un moyen pratique d’examiner cette séparation, avec des scènes, du code d’inférence et des ressources téléchargeables.
Ses démonstrations sont prometteuses, mais la configuration publiée, la spécialisation des scènes et les métriques de performance distinctes comptent autant que le chiffre FPS mis en avant.
Partez d’une phrase et obtenez un site complet en quelques minutes.
