For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/meta-muse-wonder-and-full-benchmarks-memo-741b367d.md.
Meta a présenté **Muse Wonder** et **Muse Wonder Full** le 12 octobre 2026. Cette sortie vise les agents personnels et professionnels : des ...
Meta a présenté Muse Wonder et Muse Wonder Full le 12 octobre 2026. Cette sortie vise les agents personnels et professionnels : des systèmes censés mémoriser un contexte utile, surmonter les obstacles et mener à bien des projets nécessitant davantage qu’une seule réponse.
L’annonce officielle confirme que Wonder est disponible via la Meta Model API et Muse Code, tandis que Full est accessible aux abonnés de Muse Code. Meta prévoit également d’intégrer Wonder à son assistant Muse, en commençant par les abonnés.
La fiche du modèle indique un contexte d’inférence d’un million de tokens ainsi que des entrées sous forme de texte, d’images, de vidéos et d’audio. La modalité de sortie indiquée est le texte. La compréhension multimodale ne doit donc pas être confondue avec la promesse que le modèle génère lui-même tous les médias fournis en entrée.
Meta indique que les modèles ont été entraînés dans son centre de données Prometheus à l’échelle du gigawatt, dans le cadre d’une reconstruction plus large de sa pile IA. L’infrastructure d’entraînement éclaire le contexte de cette sortie ; elle ne démontre pas que chaque application offrira les mêmes performances qu’une démonstration de benchmark.
Le rapport fourni indique que Wonder Full obtient 56 à l’Artificial Analysis Intelligence Index, contre 52 pour Wonder et 48 pour Muse Spark 1.3. L’évaluation d’Artificial Analysis confirme ces chiffres avec l’effort de raisonnement maximal. Ils correspondent à un instantané d’évaluation publié, et non à un classement permanent.
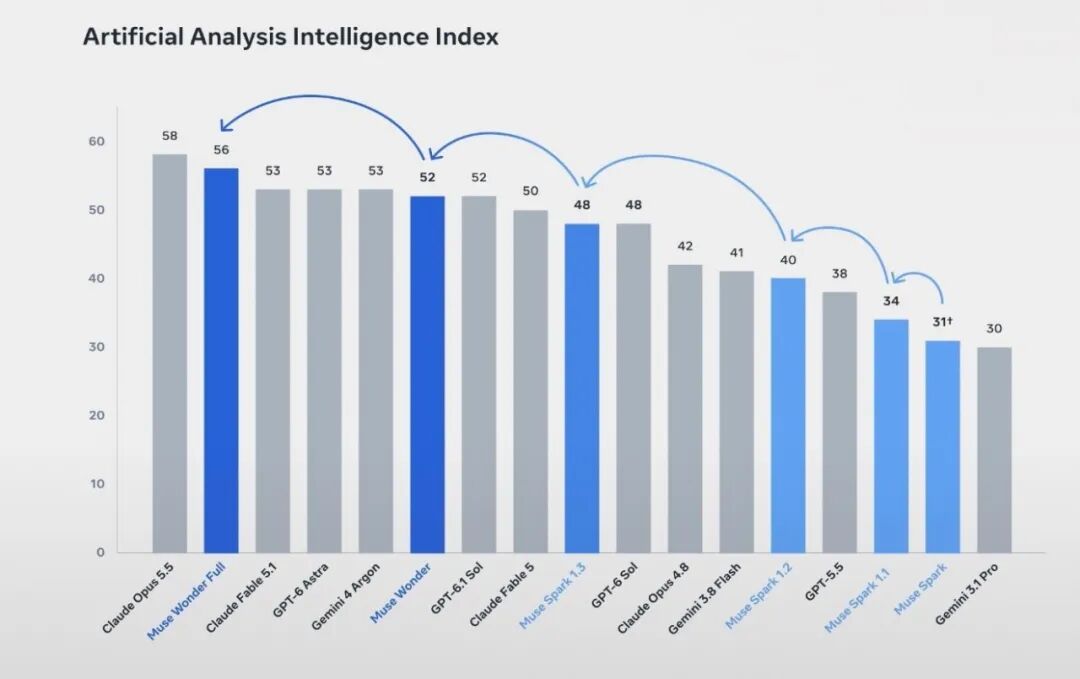
Graphique reproduit dans le rapport de Xinzhiyuan sur BAAI ; évaluation attribuée à Artificial Analysis.
Pour les travaux logiciels de longue durée, la source rapporte :
| Évaluation | Wonder Full | Wonder | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| SWE-Marathon | 57,5 % | 53,1 % | 46,3 % | 42,5 % |
| DeepSWE v1.1 | 79,0 % | 78,8 % | 74,2 % | 74,1 % |
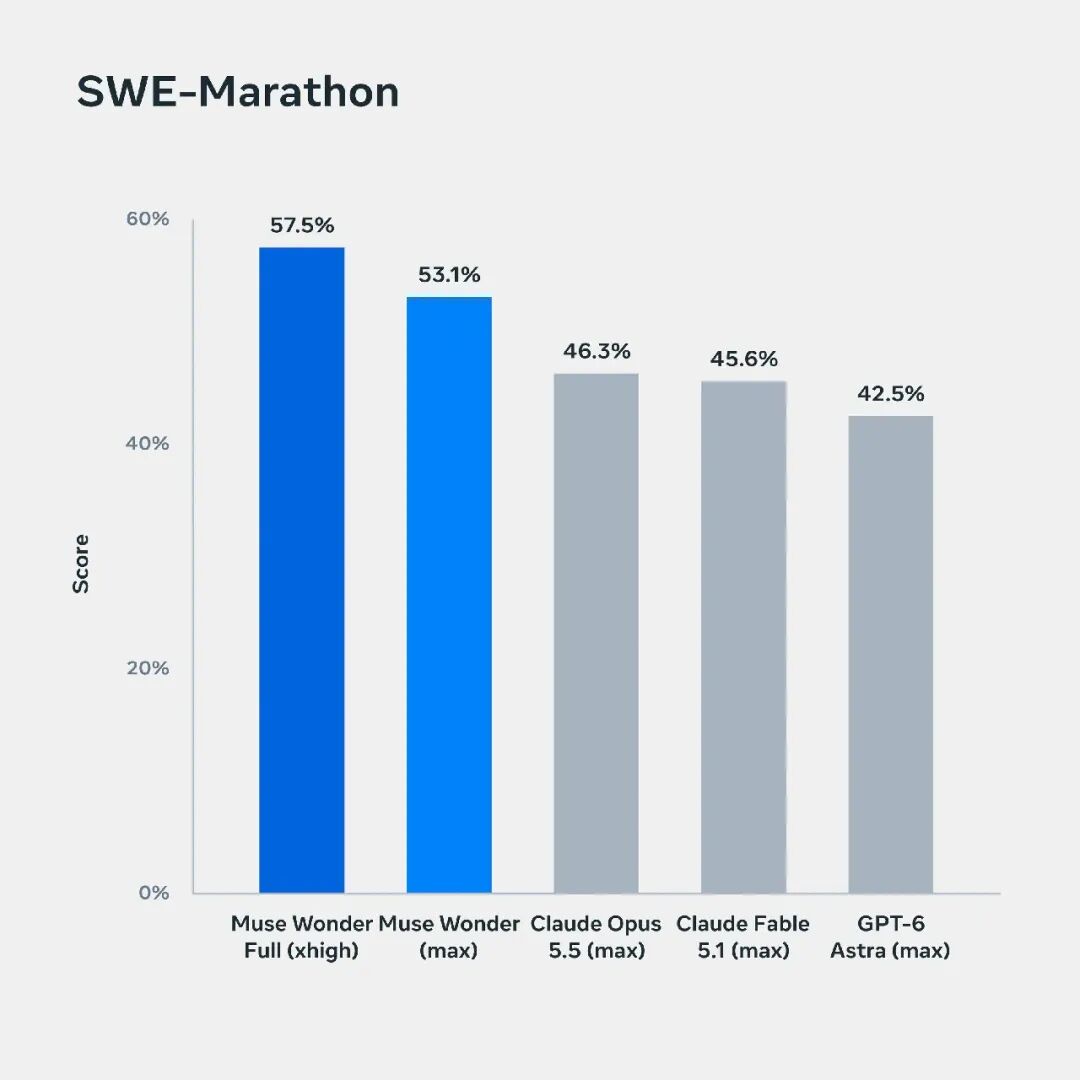
Graphique de benchmark de Meta, reproduit par la source.
La fiche du modèle apporte une précision utile : SWE-Marathon n’est pas une comparaison contrôlée réalisée avec un harnais commun unique. Certains résultats concurrents utilisent Codex ou Claude Code, tandis que le résultat publié de Wonder Full utilise un effort de raisonnement xhigh. DeepSWE combine également des résultats tiers spécifiés et des résultats communiqués par les fournisseurs ; les lecteurs devraient donc consulter la méthodologie de chaque benchmark.
Le tableau d’ensemble est contrasté, plutôt qu’une domination nette. L’article indique que Full devance GPT-6 Astra sur ProgramBench, mais reste derrière Opus 5.5, et derrière les deux dans la comparaison de code en terminal indiquée. Le choix d’un modèle dépend toujours du travail réel, de l’environnement d’outils, du budget et du taux d’échec acceptable.
Meta utilise Active Memory pour conserver un contexte important entre les conversations et récupérer les détails pertinents lorsque nécessaire. Meta utilise Active Focus pour le travail soutenu : essayer une autre approche, s’adapter à de nouvelles informations et poursuivre malgré les blocages.
Ces capacités répondent à des problèmes différents. Se souvenir d’une exigence ne garantit pas, à lui seul, qu’un agent puisse terminer une implémentation complexe ; la persistance ne sert à rien si l’agent a perdu une contrainte essentielle.
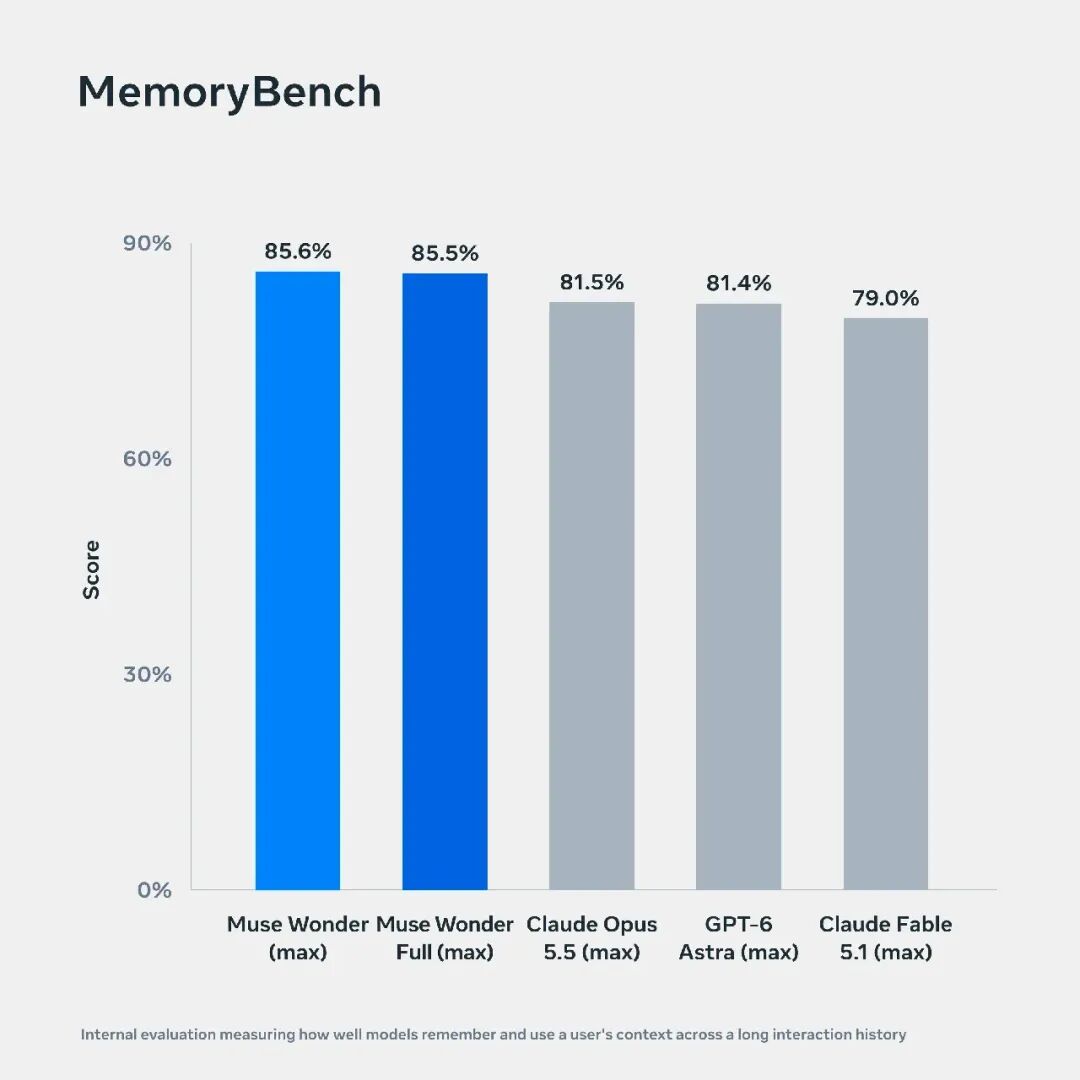
Graphique d’évaluation de Meta, reproduit via le rapport source.
La fiche du modèle décrit MemoryBench comme une évaluation interne utilisant des conversations de 64 000 à 100 000 tokens, comprenant des informations distrayantes ou contradictoires. FocusBench est également une évaluation interne. Ces éléments décrivent utilement ce qui a été testé, mais ils ne garantissent ni un rappel parfait ni une autonomie ininterrompue dans un service déployé.
Meta évalue les modèles sur des tâches liées au droit, à la finance, à la santé et aux documents professionnels, en plus du code. Ces tests concernent des livrables précis et des règles de notation données ; un score ne doit pas être considéré comme une qualification professionnelle.
Le rapport chinois souligne également une distinction entre répondre de manière sélective et disposer de davantage de connaissances. Il rapporte un indicateur d’hallucination plus faible pour Full, parallèlement à un indice de connaissance inférieur à ceux des modèles Opus et Astra comparés. Dans cette analyse, le pourcentage d’hallucination est conditionné aux éléments incorrects ou sans réponse d’un test de connaissances ; il ne représente pas le pourcentage de toutes les réponses réelles qui seraient fausses.
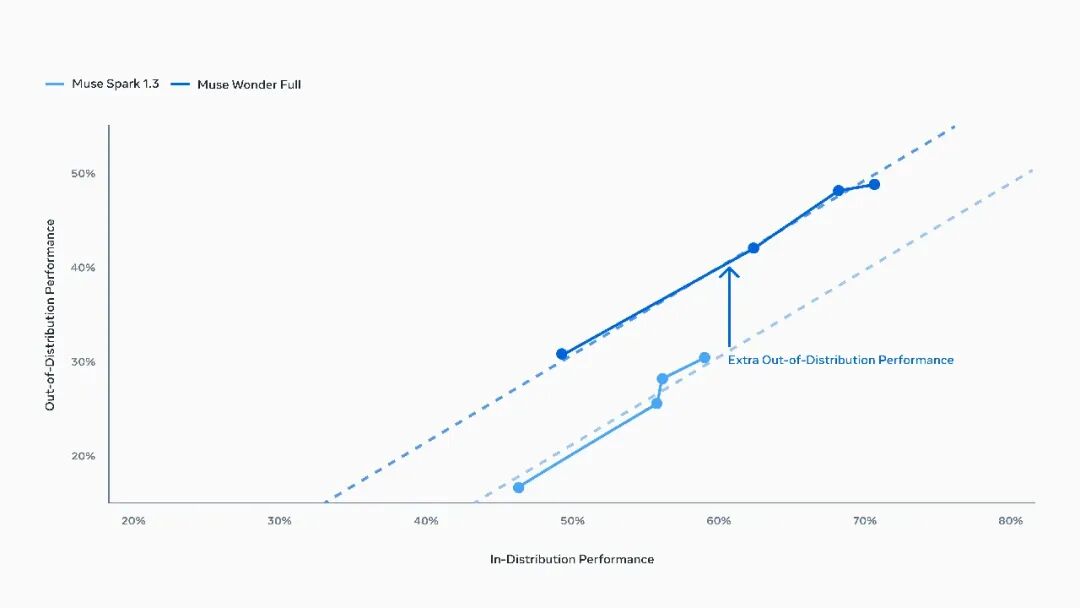
Pour les tâches inconnues, Meta présente des éléments indiquant que Full se généralise mieux que le précédent modèle Spark à performance comparable sur la distribution d’entraînement. Cette conclusion porte sur le cadre d’évaluation mesuré et ne constitue pas une preuve d’auto-amélioration sans restriction.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Graphique de généralisation de Meta, reproduit dans la source.
La source indique les tarifs suivants au moment de son rapport :
| Produit | Tarif rapporté | Accès rapporté |
|---|---|---|
| Entrée de l’API Wonder | 4 $ par million de tokens | API facturée à l’usage |
| Sortie de l’API Wonder | 20 $ par million de tokens | API facturée à l’usage |
| Entrée mise en cache de Wonder | 0,20 $ par million de tokens | Entrée mise en cache |
| Full : Power Usage | 50 $ par mois | Abonnement Muse Code |
| Full : Maximum Usage | 200 $ par mois | Abonnement Muse Code |
Le rapport décrit les deux abonnements Full comme proposant respectivement 20 et 80 fois l’usage de base. Ces multiplicateurs ne correspondent pas à un usage illimité, et la source n’établit pas un nombre universel de tâches par mois.
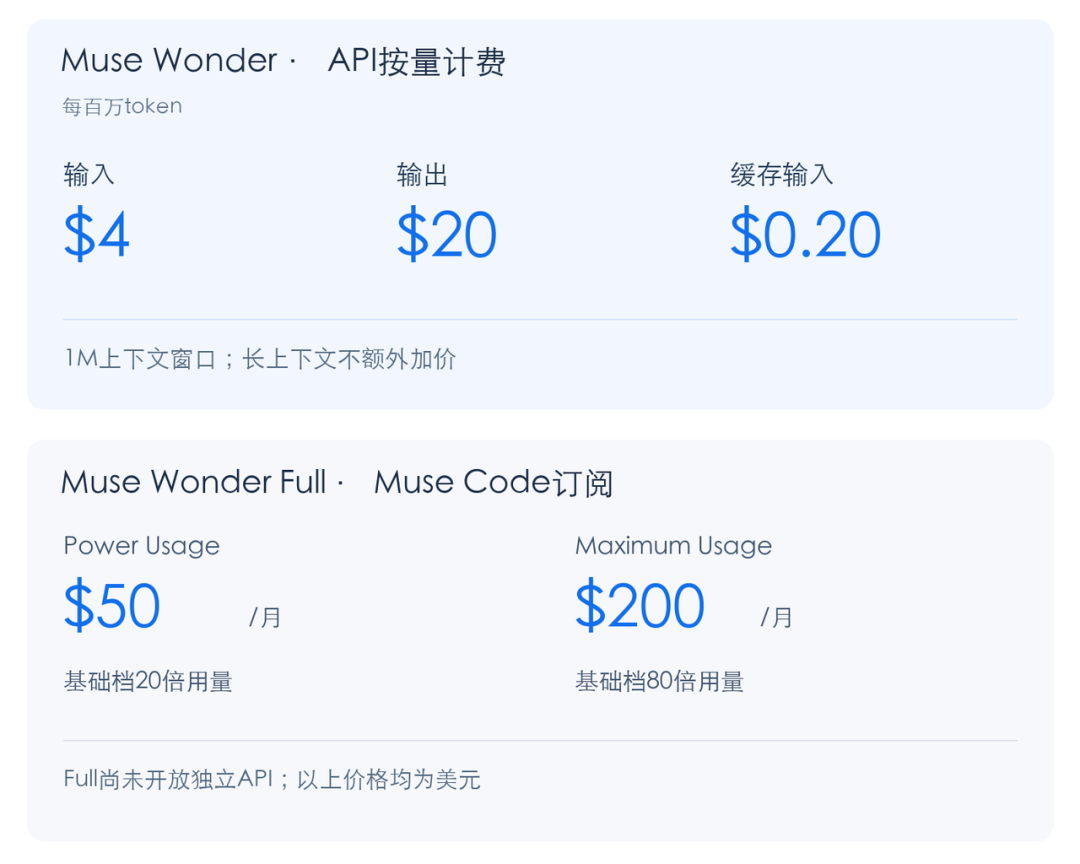
Graphique tarifaire crédité à l’article source ; les conditions de facturation actuelles n’étaient pas accessibles de manière indépendante.
Au moment de l’annonce, Full était proposé via des abonnements Muse Code plutôt que par une API publique distincte annoncée séparément. Les équipes qui envisagent l’un ou l’autre produit devraient vérifier l’accès et les tarifs actuellement proposés sur leur compte avant de s’engager sur une charge de travail.
Muse Wonder est un modèle de Meta lancé le 12 octobre 2026 pour des tâches d’agents personnels et professionnels. Meta met en avant ses capacités de mémoire, d’exécution soutenue de tâches, de programmation et de travail dans des domaines spécialisés.
Full est la variante la plus performante dans un grand nombre des évaluations rapportées. L’annonce officielle propose Wonder via l’API et Muse Code, tandis que Full est disponible pour les abonnés de Muse Code.
La fiche du modèle de Meta indique un million de tokens en inférence. La capacité de contexte est distincte de la fiabilité du rappel, des limites de sortie et du volume de contenu exploitable qu’une application donnée peut fournir.
La fiche du modèle répertorie le texte, l’image, la vidéo et l’audio comme entrées. Elle indique le texte comme sortie ; la prise en charge d’entrées multimodales ne doit donc pas être interprétée comme une génération native d’audio ou de vidéo.
Non. Les scores rapportés s’appliquent à des tâches, configurations d’agents et paramètres de raisonnement particuliers. Meta précise explicitement que les résultats de SWE-Marathon n’utilisent pas un harnais commun contrôlé pour tous les systèmes comparés.
Active Memory concerne la conservation et la récupération du contexte pertinent entre les conversations. Active Focus concerne la persistance face aux obstacles et l’adaptation pendant une tâche, avec clarification ou confirmation lorsque cela est approprié.
L’annonce du 12 octobre décrit Full comme disponible pour les abonnés de Muse Code. Elle n’annonce pas d’API publique Full distincte, et la disponibilité devrait être vérifiée dans les communications officielles ultérieures.
Muse Wonder et Full élargissent l’offre d’agents de Meta avec un contexte d’un million de tokens, des entrées multimodales, de la mémoire et des capacités de programmation soutenue. L’annonce confirme des modes d’accès distincts par API et abonnement, tandis que la source rapporte des améliorations importantes par rapport à Muse Spark 1.3.
La comparaison la plus utile combine les scores de benchmark avec leurs harnais d’évaluation, l’accès réel au compte et le coût nécessaire pour accomplir vos propres tâches.
Partez d’une phrase et obtenez un site complet en quelques minutes.



