Introduction
Microsoft rapporte que sa nouvelle configuration du système multi-modèles et multi-agents MDASH atteint un taux de réussite de 95,95 % sur CyberGym. Ce système est utilisé pour identifier, vérifier, prioriser et corriger les vulnérabilités logicielles.
Ce chiffre est remarquable. Le document de recherche original sur CyberGym indiquait que la combinaison la plus performante testée — OpenHands avec Claude 3.7 Sonnet — ne reproduisait que 11,9 % des vulnérabilités du benchmark dans l'évaluation initialement publiée.
Le dernier résultat de Microsoft est bien supérieur. Cependant, l'aspect le plus important de cette annonce n'est pas simplement que les nouveaux modèles sont plus performants.
Le score de 95,95 % est produit par un système de sécurité complet qui combine :
- Un petit modèle spécialisé en cybersécurité.
- Un grand modèle de pointe pour les cas difficiles.
- Plus de 100 agents spécialisés.
- Des outils d'analyse et de vérification de code.
- Des données de sécurité historiques.
- La génération de preuves.
- Des mécanismes de déduplication.
- Un environnement d'exécution en sandbox.
- Des flux de travail conçus manuellement.
Microsoft résume cette approche en trois mots :
Modèles
Données
Cadre
Les modèles apportent l'intelligence. Les données confèrent à l'intelligence un contexte de sécurité. Le cadre transforme les sorties des modèles en flux de travail reproductibles et vérifiables.
Cette distinction est importante car les équipes de sécurité d'entreprise n'achètent pas des réponses à des benchmarks. Elles ont besoin d'un système capable de fonctionner en continu, de contrôler les faux positifs, de prouver que les découvertes sont réelles et d'aider à transformer les résultats en correctifs de sécurité.
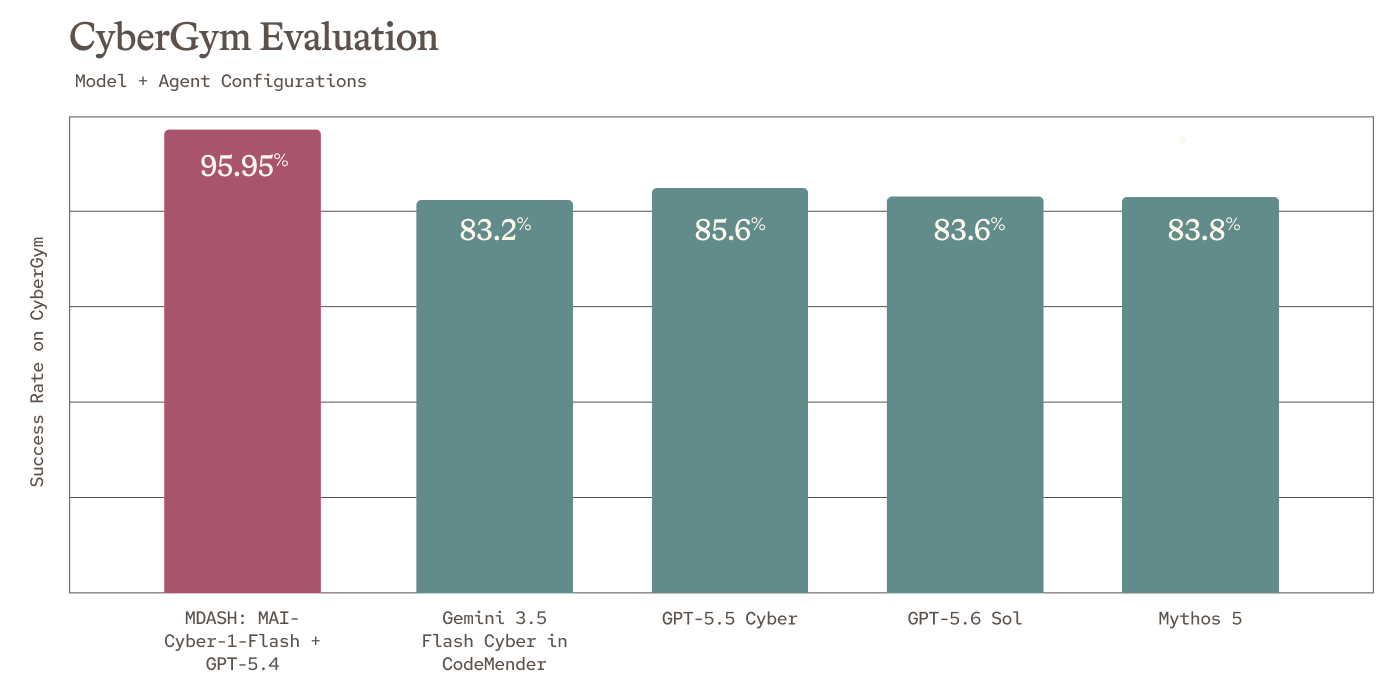
Le résultat de 95,95 % dans le rapport
Le graphique CyberGym publié par Microsoft compare cinq configurations de modèles et d'agents :
| Configuration système ou modèle | Taux de réussite CyberGym rapporté par Microsoft |
|---|---|
| MDASH : MAI-Cyber-1-Flash + GPT-5.4 | 95,95 % |
| GPT-5.5 Cyber | 85,6 % |
| Mythos 5 | 83,8 % |
| GPT-5.6 Sol | 83,6 % |
| Gemini 3.5 Flash Cyber dans CodeMender | 83,2 % |
La configuration MDASH devance la deuxième place du graphique de Microsoft de plus de dix points de pourcentage.
Microsoft indique également que cette configuration est environ 50 % moins coûteuse que la configuration MDASH la plus performante précédente (utilisant GPT-5.4, GPT-5.4 mini et GPT-5.3 Codex).
La comparaison porte donc sur deux dimensions :
- La performance en matière de sécurité.
- L'économie nécessaire pour maintenir cette performance en continu.
L'analyse de sécurité n'est pas un problème ponctuel. Les grandes organisations peuvent devoir examiner des millions de lignes de code, relancer des analyses après chaque modification, vérifier les vulnérabilités suspectées, retester les correctifs et surveiller un parc logiciel en constante évolution.
Une configuration extrêmement performante mais trop coûteuse à exécuter fréquemment peut apporter moins de protection réelle qu'un modèle plus petit intégré à un système d'acheminement et de vérification supérieur.
Le chiffre le plus important pourrait être
90 %
Microsoft indique que MAI-Cyber-1-Flash est conçu pour traiter jusqu'à 90 % des tâches du flux de travail MDASH.
Les 10 % de tâches les plus difficiles peuvent être acheminées vers un modèle plus grand, identifié par Microsoft dans la configuration publiée comme étant GPT-5.4.

Cette stratégie peut être formulée comme suit :
Tâches de sécurité courantes et fréquentes
→ MAI-Cyber-1-Flash

Tâches exceptionnellement difficiles
→ GPT-5.4
Cela ne signifie pas que MAI-Cyber-1-Flash corrige à lui seul 90 % des vulnérabilités.
Le chiffre de 90 % fait référence à la part des tâches que le petit modèle est conçu pour couvrir dans le flux de travail acheminé. Le résultat complet de MDASH repose toujours sur l'acheminement des tâches, les modèles plus grands, les agents spécialisés, la vérification, la génération de preuves, la déduplication, les outils de sécurité, l'environnement d'exécution et les contrôles au niveau du système.
Le petit modèle réduit le coût moyen du flux de travail, mais n'élimine pas le besoin d'un modèle plus puissant pour les cas les plus difficiles.
Spécifications du modèle MAI-Cyber-1-Flash
Microsoft décrit MAI-Cyber-1-Flash comme son premier modèle spécialisé en cybersécurité.
La fiche technique officielle du modèle indique :
| Spécification | MAI-Cyber-1-Flash |
|---|---|
| Architecture | Transformeur à mélange d'experts épars |
| Paramètres totaux | 137B |
| Paramètres activés | 5B |
| Longueur du contexte | 256K |
| Entrée | Texte |
| Sortie | Texte |
| Modèle de base | MAI-Code-1-Flash |
| Environnement principal | MDASH (nom de code Microsoft) |
| Date de publication | 27 juillet 2026 |
| Disponibilité | Aperçu privé Azure AI Foundry pour les clients MDASH approuvés |
Ce modèle est une version spécialisée en cybersécurité du MAI-Code-1-Flash.
Il est conçu pour des flux de travail tels que l'identification des vulnérabilités, la vérification, la priorisation, la classification, le support de correction et l'analyse de code à l'échelle de l'entreprise.
Il ne s'agit pas d'un modèle de cybersécurité généraliste destiné au public.
La fiche technique de Microsoft précise que l'accès est limité aux clients MDASH sélectionnés et nécessite un examen supplémentaire, les capacités avancées en cybersécurité relevant d'une technologie à double usage.
Le modèle est également spécifiquement conçu pour être intégré à MDASH, et non comme un modèle téléchargeable indépendant ou une API publique sans restriction.
Pourquoi un modèle à 5B de paramètres activés peut effectuer l'essentiel du travail
MAI-Cyber-1-Flash compte 137 milliards de paramètres au total, mais n'active qu'environ 5 milliards de paramètres par jeton.
Cette conception de mélange d'experts épars permet au modèle d'accéder à une plus grande capacité totale tout en maintenant des coûts d'inférence active relativement faibles.
L'optimisation la plus importante réside toutefois dans la spécialisation.
Un modèle de pointe généraliste doit prendre en charge l'écriture, les mathématiques, la recherche, le codage, la conversation, la planification, le travail multimodal et l'utilisation d'outils. Un modèle spécialisé peut concentrer davantage d'entraînement et de post-entraînement sur un seul domaine opérationnel.
Pour MAI-Cyber-1-Flash, ce domaine inclut les environnements de sécurité exécutables et la gestion des vulnérabilités.
Les flux de travail.
Lorsqu'un modèle rencontre à plusieurs reprises des tâches similaires à son environnement d'entraînement et d'évaluation, la spécialisation peut améliorer le rapport coût-efficacité.
Le système a toujours besoin d'un plan de secours, car les cas difficiles ou inhabituels peuvent dépasser les capacités du modèle spécialisé.
Cela donne naissance à une architecture multi-modèles pragmatique :
Modèle spécialisé à faible coût pour la couverture
+
Modèle de pointe pour les exceptions
+
Système de vérification pour la confiance
Le remplacement de 80 % des appels aux modèles par un modèle spécialisé améliore considérablement le score
La fiche technique du modèle fournit une comparaison particulièrement utile au niveau du système.
Microsoft indique que la configuration MDASH précédente obtenait 88,4 % sur CyberGym.
Après avoir remplacé 80 % des appels existants aux modèles du flux de travail par MAI-Cyber-1-Flash, le résultat est passé à 95,95 %.
Le coût a également diminué d'environ la moitié par rapport à la configuration la plus performante précédente.
Ce résultat remet en question une hypothèse courante :
Un modèle moins cher signifie nécessairement une qualité moindre.
Cela peut être vrai lorsque les modèles sont comparés seuls sur la même tâche. Mais au sein d'un système d'acheminement, ce n'est pas toujours le cas.
Un modèle spécialisé peut être plus stable sur les tâches courantes en raison de son entraînement ciblé. L'acheminement permet de réserver les modèles de pointe coûteux aux scénarios où ils créent le plus de valeur.
Le résultat final dépend de la capacité à répondre correctement à trois questions :
- Quelles tâches doivent utiliser le modèle spécialisé ?
- Quelles tâches nécessitent le modèle de pointe ?
- Comment chaque résultat doit-il être vérifié ?
L'acheminement des modèles devient une composante de la qualité du produit.
Le score de 95,95 % appartient à MDASH, pas au petit modèle lui-même
La fiche technique de Microsoft rapporte également que
MAI-Cyber-1-Flash, résultats autonomes dans d'autres évaluations de cybersécurité.
Ces résultats, limités au modèle seul, ne sont pas équivalents aux scores obtenus par MDASH sur CyberGym.
La fiche modèle liste ce qui suit :
| Benchmark | Résultat autonome de MAI-Cyber-1-Flash |
|---|---|
| CVEBench | 0,314 |
| CyberSecEval4 Renseignement sur les menaces | 0,553 |
| CyberSecEval4 Analyse de logiciels malveillants | 0,33 |
| CRSBench | 0,651 (POV=1200) |
| ExploitGym Noyau | 0 |
| ExploitGym Espace utilisateur | 0 |
| ExploitGym Navigateur | 0 |
Ces données illustrent l'importance de la distinction au niveau système.
Les petits modèles ne sont pas systématiquement en tête sur tous les benchmarks cybernétiques. Son résultat publié le plus fort est obtenu lorsqu'il opère en synergie au sein de MDASH avec d'autres modèles, agents, outils, données et phases de validation.
Cela confirme le message central de Microsoft :
Les modèles sont des composants.
Les systèmes sont les produits.
Fonctionnalités de MDASH
MDASH est le framework multi-modèles et multi-agents de Microsoft pour l'identification et la correction de vulnérabilités.
Microsoft indique que ses experts en sécurité ont créé plus de 100 agents spécialisés au sein du système.
Différents agents sont responsables de différentes étapes du flux de travail, notamment la localisation du code, la découverte de candidats, le raisonnement sur les vulnérabilités, la validation, la construction de preuves, la classification, la déduplication, la correction, les travaux liés aux correctifs et la comparaison entre les résultats.
Le flux système simplifié est approximativement le suivant :
Contexte du code et de la sécurité
        ↓
Agent de découverte de candidats
        ↓
Agent de validation
        ↓
Débat et comparaison
        ↓
Déduplication
        ↓
Génération de preuve de concept
        ↓
Support de correctif ou de réparation
Examen humain et exploitation contrôlée
Les détails d'implémentation interne relèvent d'informations propriétaires, mais Microsoft a exposé plusieurs principes de conception importants.
Le framework est conçu pour être indépendant du modèle
Microsoft indique que MDASH sépare les différentes parties du pipeline (comme le ciblage, la validation, la déduplication et la preuve) de tout modèle unique.
Cela facilite le remplacement ou la comparaison des modèles.
Lorsqu'un nouveau modèle est disponible, le système peut le soumettre à des tests A/B par rapport à l'ensemble de modèles actuel.
Les investissements antérieurs de l'organisation restent valables :
- Fichiers de périmètre.
- Plugins.
- Configurations.
- Calibration.
- Règles de validation.
- Flux de travail de sécurité.
Cela réduit la dépendance à un fournisseur ou à un point de contrôle de modèle unique.
Cela permet également une amélioration continue. Le meilleur modèle pour une étape donnée n'est pas nécessairement le meilleur pour une autre.
Les outils spécialisés étendent le raisonnement du modèle
La découverte de certaines vulnérabilités ne nécessite pas seulement la lecture du code source.
Le système peut avoir besoin de construire le projet, de créer des entrées déclencheuses, d'exécuter la version vulnérable, d'exécuter la version corrigée, de vérifier les plantages, d'interroger les bases de données d'analyse de code, de comparer les flux de contrôle et de vérifier que le comportement est reproductible.
Microsoft indique que MDASH peut utiliser des plugins de domaine spécialisés et des systèmes d'analyse de code.
Son annonce de mai discutait d'un plugin de validation pour les vulnérabilités du système de fichiers journalisé générique (CLFS) et notait que les bases de données CodeQL pouvaient également être utilisées.
Le modèle n'a pas besoin d'effectuer toutes les opérations par texte libre.
Pour les tâches mieux adaptées à un traitement logiciel, les outils peuvent fournir des capacités déterministes.
La validation est la véritable frontière du produit
Les modèles de sécurité peuvent produire des descriptions de vulnérabilités plausibles mais en réalité erronées.
Si le système transmettait chaque résultat spéculatif aux développeurs, cela créerait une fatigue liée aux alertes.
La valeur opérationnelle réside dans la preuve que les découvertes sont réelles.
Les preuves utiles peuvent inclure :
- Plantages reproductibles.
- Entrées de preuve de概念.
- Tests échoués.
- Exécution réussie avant correctif.
- Échec d'exécution après correctif.
- Chemins de code précis.
- Versions affectées vérifiées.
- Rapports dédupliqués.
- Correctifs ayant passé les tests.
C'est pourquoi un benchmark comme CyberGym est pertinent.
Il ne se contente pas de noter le pouvoir de persuasion des explications écrites.
Il vérifie si la preuve générée reproduit effectivement le comportement cible.
Ce que CyberGym évalue
CyberGym est un benchmark à grande échelle créé par des chercheurs associés à l'Université de Californie à Berkeley.
Le projet public actuel contient 1 507 instances de vulnérabilités réelles réparties sur 188 projets logiciels.
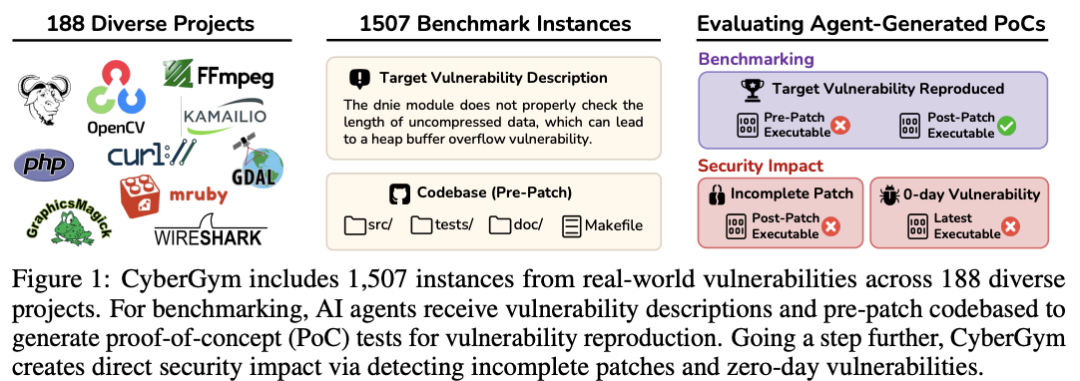
Dans son principal environnement de génération de preuves de concept (PoC), l'agent reçoit :
- La description de la vulnérabilité.
- Le code source correspondant avant le correctif.
- L'environnement d'exécution.
L'agent doit générer une preuve de concept capable de déclencher la vulnérabilité.
Le benchmark évalue ensuite le comportement
par rapport à la version vulnérable et à la version corrigée.
Une reproduction réussie devrait généralement satisfaire la comparaison attendue :
Version avant correctif :
La PoC déclenche la vulnérabilité ciblée.

Version après correctif :
La même PoC ne déclenche plus la vulnérabilité.
CyberGym utilise des vulnérabilités réelles issues de projets open source majeurs, y compris ceux de l'écosystème OSS-Fuzz.
Son architecture basée sur l'exécution le rend plus rigoureux que les benchmarks qui exigent uniquement du modèle qu'il classe le code ou rédige des explications.
Ce que CyberGym ne mesure pas
Le chiffre de 95,95 % doit être interprété avec soin.
Le paramètre principal de CyberGym fournit à l'agent la description de la vulnérabilité.
L'agent ne part pas nécessairement d'une base de code totalement inconnue, sans aucun indice de l'existence de la vulnérabilité.
Par conséquent, le benchmark mesure une forme de reproduction de vulnérabilités connues.
Cela ne signifie pas directement :
- Que 95,95 % des vulnérabilités inconnues sont découvertes.
- Que 95,95 % de toutes les vulnérabilités logicielles sont corrigées.
- Que le modèle peut protéger de manière autonome une base de code quelconque.
- Que le système a un taux de précision de 95,95 % pour la découverte de vulnérabilités zero-day.
- Que le système ne génère pas de faux positifs en environnement de production.
Le benchmark exige néanmoins un travail considérable. L'agent doit naviguer dans de véritables bases de code, localiser le comportement pertinent, construire des déclencheurs valides, compiler ou exécuter le logiciel et valider les résultats.
La description correcte est :
Le score rapporté est le taux de réussite de reproduction des vulnérabilités dans la configuration d'évaluation CyberGym utilisée par Microsoft.
De 11,9 % à 95,95 %
La première version de l'article original de CyberGym rapportait que la combinaison de test la plus performante — OpenHands avec Claude 3.7 Sonnet — atteignait un taux de reproduction de 11,9 %.
Les révisions ultérieures du benchmark, les frameworks d'agents, les générations de modèles et les conceptions système ont considérablement amélioré les résultats.
Le taux de 95,95 % rapporté par Microsoft démontre la rapidité des progrès combinés entre les modèles et les frameworks d'outils.
Cependant, cette comparaison ne doit pas être interprétée comme une simple amélioration de modèle à modèle.
Ces systèmes diffèrent par la génération de modèles, le framework d'agents, les invites, les outils, la validation, le budget de calcul, les coûts, le routage des tâches, la version du benchmark, l'infrastructure et les stratégies de nouvelle tentative.
Les progrès sont réels, mais ce sont des progrès au niveau du système.
Classement public et résultats rapportés par l'entreprise
L'article source indique qu'au moment de la publication, le résultat de 95,95 % de Microsoft n'était pas encore reflété dans le classement public de CyberGym.
La configuration de mai de Microsoft rapportait environ 88,4 %–88,45 %, précédemment publiée comme leader du benchmark.
Le nouveau chiffre de 95,95 % a été publié par Microsoft dans l'annonce de MAI-Cyber-1-Flash, la fiche modèle et l'annonce du projet Perception de Microsoft.
Jusqu'à ce qu'une entrée sur un classement externe ou une reproduction indépendante soit disponible, il doit être décrit comme un résultat rapporté par Microsoft.
Cela ne rend pas le résultat dénué de sens. Cela signifie que les lecteurs doivent faire la distinction entre :
Les évaluations rapportées par le fournisseur
et
Les résultats publics reproduits de manière indépendante
Cette distinction est particulièrement importante dans les comparaisons de benchmarks en évolution rapide.
Les données sont la couche la plus difficile à reproduire
Microsoft
considère ses données historiques de sécurité comme son avantage le plus profond.
L'entreprise indique traiter plus de 100 000 milliards de signaux de sécurité par jour et disposer d'informations opérationnelles provenant de 1,6 million de clients.
Sa visibilité en matière de sécurité couvre l'identité, les points de terminaison, le cloud, le réseau, les données, les navigateurs et les applications.
La valeur ne réside pas uniquement dans le volume d'événements.
L'entreprise est capable de relier les actions de sécurité aux résultats :
- Quelles vulnérabilités sont exploitables.
- Quelles attaques ont été contenues.
- Quelles détections sont des faux positifs.
- Quelles mesures d'atténuation sont efficaces.
Quels correctifs ont résolu le problème.
- Quelles configurations ont réduit le risque.
Cela forme une boucle de rétroaction.
Incident de sécurité
→ Enquête
→ Vérification
→ Correction
→ Résultats observés
→ Meilleures données et retours
→ Modèles et agents améliorés
Les concurrents peuvent obtenir des modèles de base similaires.
Mais ils ne peuvent pas reproduire du jour au lendemain des décennies d'historique opérationnel validé.
La quantité de données en elle-même ne suffit pas
Les données n'ont de valeur que lorsqu'elles sont transformées en contexte d'entraînement, d'évaluation et d'exploitation.
Les signaux de sécurité bruts peuvent être redondants, bruités, incomplets, spécifiques à un client, sensibles, mal étiquetés, biaisés en faveur des attaques visibles, ou dépourvus de résultats finaux.
Les pipelines de données doivent relier les événements à des étiquettes et des résultats fiables.
Par exemple :
Déclenchement d'une alerte
→ Enquête de l'analyste
→ Confirmation de la vulnérabilité
→ Déploiement du correctif
→ L'exploitation de la vulnérabilité ne fonctionne plus
Cette séquence a plus de valeur que l'alerte seule.
La barrière protectrice provient des données, ainsi que de leur traitement, des retours, de l'évaluation et de l'accès aux opérations de sécurité.
Modèles, données et cadre d'outillage
Le cadre en trois parties de Microsoft offre une méthode utile pour évaluer tout système de sécurité IA d'entreprise.
Modèles
Les questions incluent :
- Quels modèles sont utilisés ?
- Comment sont-ils spécialisés ?
- Quelle est la latence ?
- Quel est le coût en tokens ?
- Quelles tâches nécessitent des modèles plus grands ?
- Quelles sont les limites de sécurité ?
Données
Les questions incluent :
- Quel contexte de sécurité est disponible ?
- Quelle est sa fraîcheur ?
- Comment est-il étiqueté ?
- Inclut-il des résultats validés ?
- Est-il spécifique à un client ?
- Comment la confidentialité et les autorisations sont-elles gérées ?
- Comment la qualité des données est-elle mesurée ?
Cadre d'outillage
Les questions incluent :
- Comment les tâches sont-elles décomposées ?
- Comment les modèles sont-ils routés ?
- Comment les outils sont-ils appelés ?
- Comment les découvertes sont-elles vérifiées ?
- Comment les doublons sont-ils éliminés ?
- Quand l'intervention humaine est-elle nécessaire ?
- Comment les échecs sont-ils audités ?
- Les modèles peuvent-ils être remplacés sans reconstruire le système ?
Creez un site vitrine et genere des leads en quelques minutes
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Un système avec un modèle puissant mais des données faibles et sans validation peut générer des rapports impressionnants mais peu fiables.
Un système bien conçu peut rendre un modèle plus petit bien plus utile en lui assignant les bonnes tâches et en vérifiant son travail.
L'économie des opérations de sécurité continues
Microsoft estime que lorsque les analyses de sécurité s'exécutent en continu, le coût en tokens devient une contrainte centrale.
Considérons une charge de travail simplifiée :
10 millions de tâches d'analyse de code par mois
Si chaque tâche utilisait le modèle de pointe le plus coûteux, le système pourrait avoir du mal à maintenir une couverture complète.
Une conception de routage modifie le coût moyen :
90 % de modèles spécialisés à faible coût
+
10 % de modèles de pointe coûteux
L'économie réelle dépend également de la longueur des entrées et sorties, des appels d'outils, des nouvelles tentatives, de l'exécution en sandbox, de l'indexation du code, de la validation, de la revue humaine, de l'infrastructure et du stockage des données.
Les frais de tokens des modèles ne sont qu'un élément parmi d'autres.
Cela dit, le mécanisme de routage crée une puissante opportunité d'optimisation, car les modèles coûteux sont utilisés de manière sélective.
Pourquoi le meilleur modèle ne donne pas nécessairement le meilleur système
Les benchmarks permettent de comparer des modèles individuels dans un cadre de test unifié.
Un produit doit optimiser le flux de travail complet.
Le meilleur système peut utiliser un modèle qui ne se classe pas premier dans des classements individuels, s'il offre une meilleure vitesse, un coût réduit, une spécialisation, une prévisibilité, une utilisation d'outils, une efficacité contextuelle, un calibrage de sécurité et une compatibilité avec le cadre de test.
Cela vaut pour d'autres systèmes de production.
Une base de données ne choisit pas le même algorithme pour chaque requête. Un planificateur cloud ne place pas chaque charge de travail sur la plus grande machine. Un système de sécurité ne devrait pas envoyer chaque tâche au modèle le plus coûteux.
Sécurité et disponibilité restreinte
Les modèles de cybersécurité présentent des risques de sécurité particuliers.
La même capacité qui aide les défenseurs à valider des vulnérabilités peut aussi aider les attaquants à les exploiter.
En conséquence, Microsoft a restreint l'accès à MAI-Cyber-1-Flash.
La fiche modèle indique :
- Il est disponible en avant-première privée via Azure AI Foundry.
- Il est réservé à MDASH.
- L'accès est limité à des clients spécifiques.
- Une approbation supplémentaire est requise.
- Les flux de travail défensifs sont dans le champ d'application.
- Les opérations de sécurité défensives en dehors de MDASH ne sont pas couvertes.
Microsoft indique que le modèle a été calibré avec une approche priorisant la sécurité, évalué par l'équipe rouge IA de Microsoft, testé via des exercices adverses automatisés, testé par des experts en sécurité, et évalué par un tiers indépendant.
Selon Microsoft, l'évaluation indépendante n'a révélé aucun problème de niveau critique.
Cela ne prouve pas que le modèle est sans risque. Cela explique pourquoi l'entreprise commence par un déploiement restreint plutôt qu'une publication publique illimitée.
Limitations connues du modèle
La fiche modèle de Microsoft répertorie plusieurs limitations.
Performance linguistique
Le modèle est principalement entraîné et évalué en anglais. Dans d'autres langues, les performances peuvent être inférieures.
Sorties erronées
Comme d'autres modèles de langage, il peut générer du code et du texte inexacts, incomplets ou incorrects. Les sorties nécessitent une revue et une validation.
Garde-fous de sécurité prudents
Le modèle est volontairement calibré pour agir avec prudence. Lorsqu'une demande défensive légitime est ambiguë ou ressemble à une activité nuisible, les garde-fous peuvent se déclencher.
Dépendance au système
Le modèle est conçu pour MDASH. Les résultats isolés ne représentent pas les capacités du système complet.
Champ d'application limité
L'utilisation en dehors des opérations de sécurité défensives approuvées n'est pas prise en charge.
MDASH est plus qu'un système de benchmark
L'annonce de MDASH par Microsoft en mai incluait des exemples issus de recherches de sécurité réelles.
L'entreprise a indiqué avoir testé le cadre sur un échantillon de pilotes non publiés contenant 21 vulnérabilités intentionnellement intégrées. Elle affirme que, dans des tests contrôlés, MDASH a identifié les 21 vulnérabilités avec zéro faux positif.
Microsoft a également indiqué que MDASH avait aidé à identifier 16 CVE publiés en mai.
Dans le cadre du Patch Tuesday de Windows 2026.
Ce sont des affirmations sur les produits et recherches de Microsoft lui-même.
Elles sont plus pertinentes pour le déploiement que les scores de benchmark, car elles impliquent du code privé, de véritables flux de travail d'ingénierie, la validation de vulnérabilités, les processus de correctifs et la revue par les équipes de sécurité.
En parallèle, des études de cas sélectionnées ne permettent pas d'établir des taux de faux positifs ou de réussite généraux sur tous les référentiels de code.
De Security Copilot aux systèmes d'action de sécurité
Microsoft a lancé Project Perception en tant que système de sécurité par agents à plus grande échelle.
Son objectif est de passer d'une IA qui assiste les défenseurs à une IA capable de prendre en charge davantage de flux de travail de sécurité, tout en maintenant le jugement critique sous contrôle humain.
Project Perception coordonne trois catégories d'agents :
| Catégorie d'agent | Responsabilité principale |
|---|---|
| Agent rouge | Simule la pensée d'un attaquant, identifie les chemins d'intrusion possibles |
| Agent bleu | Mène des enquêtes, raisonne à partir du contexte, détecte et trie les risques significatifs |
| Agent vert | Corrige, renforce les systèmes et réduit la surface d'exposition |
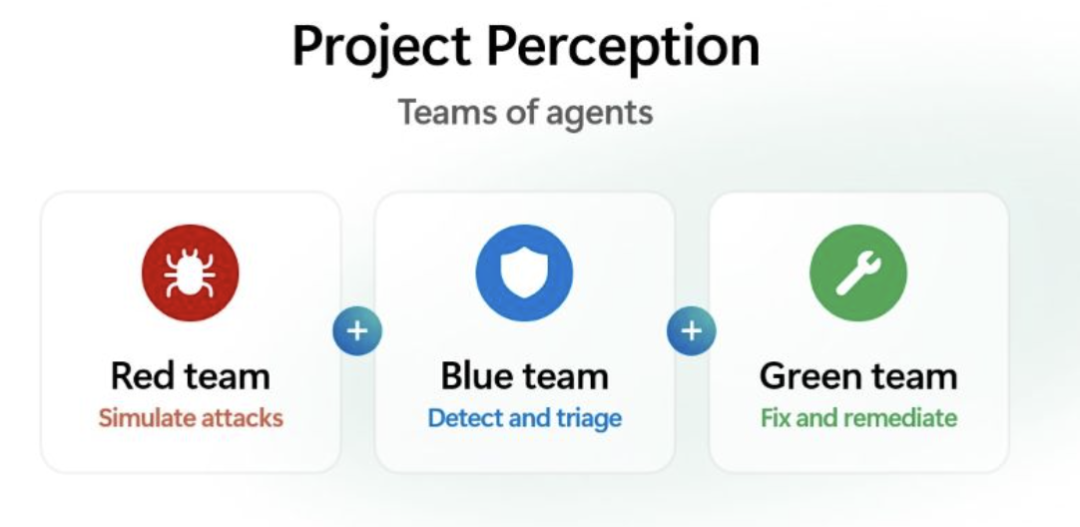
Ces trois rôles forment une boucle :
L'agent rouge découvre des chemins
→ L'agent bleu valide et priorise
→ L'agent vert effectue les corrections
→ Le système observe les résultats
→ Les défenses futures sont améliorées
Microsoft indique que Project Perception est entré en avant-première publique le 3 août 2026.
La pile technologique de Project Perception
Microsoft décrit le système comme composé de plusieurs couches interconnectées.
Signaux et capteurs
Le système observe les points de terminaison, les identités, le cloud, les applications et d'autres parties des actifs numériques.
Contexte de sécurité
Les signaux bruts sont convertis en une représentation corrélée des actifs, identités, relations, politiques, risques, activités et événements historiques.
Modèles
La plateforme adopte une stratégie multi-modèles, incluant des modèles réseau spécialisés comme MAI-Cyber-1-Flash.
Cadre d'orchestration (Harness)
Le cadre d'orchestration coordonne les modèles, agents, outils, flux de travail, tests, autorisations et mesures de contrôle.
Agents
Les agents rouge, bleu et vert exécutent des tâches de sécurité spécialisées.
Exécuteurs
Les exécuteurs transforment les décisions en actions concrètes dans les produits de sécurité intégrés.
Cette architecture va bien au-delà d'un simple chatbot. Elle vise à former un système d'exploitation de sécurité fonctionnant en continu.
Les humains restent responsables des décisions critiques
Microsoft indique clairement que les humains conservent le contrôle des opérations à fort impact.
Sa page dédiée au projet Perception décrit cette répartition des rôles :
Les agents accomplissent le travail.
Les humains exercent le jugement.
Les défenseurs définissent les objectifs, les stratégies, les limites de protection, les exigences d'approbation, le périmètre et les priorités de réponse.
Les opérations à fort impact nécessitent toujours une approbation humaine.
C'est nécessaire, car une correction de sécurité peut elle-même causer des dommages.
Un système automatisé pourrait désactiver des comptes légitimes, bloquer du trafic de production, supprimer des fichiers critiques,
isoler un système métier, déployer un correctif défectueux ou interrompre les opérations.
Le coût d'une action erronée peut dépasser celui d'une non-détection.
Project Perception diffère de Security Copilot
Microsoft décrit Security Copilot comme une interface conversationnelle assistée par intelligence artificielle.
Project Perception est quant à lui positionné comme un système d'agents plus large.
| Concept produit | Rôle |
|---|---|
| Security Copilot | IA d'assistance via une interface générative |
| Project Perception | Agents IA qui raisonnent et agissent en continu dans les flux de travail de sécurité |
Ces deux produits sont conçus pour fonctionner ensemble.
Les humains peuvent utiliser Copilot pour comprendre et orienter le travail, tandis que les agents Perception prennent en charge une plus grande partie des processus opérationnels continus.
Tarification basée sur la consommation
Microsoft indique que Project Perception utilise une tarification basée sur la consommation, mesurée en unités de calcul de sécurité (SCU).
Différents agents consomment des ressources variables selon l'intensité des tâches.
L'efficacité des modèles et des flux de travail devient ainsi économiquement cruciale.
La simulation d'équipes rouges, les tâches de tri rapide et les flux de remédiation à long terme peuvent consommer des ressources différentes.
La stratégie de routage multi-modèles utilisée dans MDASH s'inscrit dans ce modèle de tarification plus large.
Si les tâches courantes peuvent être confiées à des modèles spécialisés plus petits, le même budget peut couvrir davantage de protections de sécurité.
La validation pourrait devenir le plus grand rempart
L'accès aux modèles de pointe devient de moins en moins rare.
Les organisations peuvent de plus en plus appeler de puissants modèles publics via des API.
Ce qui devient rare, c'est peut-être le système capable de déterminer si les affirmations de sécurité d'un modèle sont vraies.
Ce système nécessite des environnements d'exécution, des infrastructures de construction, le contrôle de version, la génération de preuves, la comparaison de correctifs, des connaissances en sécurité, des environnements sandbox, la déduplication, une revue humaine et le suivi des preuves.
Dans le domaine de la sécurité, de belles explications sans preuves ne suffisent souvent pas.
Le fossé concurrentiel passe de :
L'accès à des modèles puissants
à :
Un processus fiable pour valider et concrétiser le travail des modèles
Ce que les équipes de sécurité devraient tirer de MDASH
1. Répartir les tâches selon leur difficulté
N'utilisez pas automatiquement le modèle le plus coûteux pour chaque opération.
Établissez des ensembles d'évaluation pour déterminer quelles tâches peuvent être traitées de manière fiable par des modèles spécialisés plus petits.
2. Séparer la découverte de la validation
Un agent ou un modèle peut générer des résultats candidats. Un autre agent, un outil ou un test déterministe doit les valider.
3. Exiger des preuves exploitables
Dans la mesure du possible, exigez des tests reproductibles plutôt que d'accepter des déclarations textuelles.
4. Conserver l'approbation humaine pour les actions majeures
Automatisez en priorité la collecte, l'analyse et la validation. Réservez les opérations destructrices ou affectant la production derrière des portes d'approbation.
5. Mesurer le coût par découverte validée
Le prix du jeton seul n'est pas la bonne mesure.
Un modèle bon marché qui génère de nombreux faux positifs peut s'avérer plus coûteux sur le plan opérationnel.
Les indicateurs utiles incluent le coût par vulnérabilité confirmée, le temps de validation, le taux de faux positifs, le temps de revue humaine, le taux d'acceptation des correctifs et le taux de régression.
6. Construire une plateforme de test indépendante des modèles
Les générations de modèles évoluent rapidement.
Veillez à ce que les définitions de tâches, les outils, la validation et les contrôles de sécurité restent réutilisables lors du remplacement du modèle sous-jacent.
7. Traiter les données de sécurité comme un système de rétroaction
Enregistrez les résultats, pas seulement les alertes.
Le système doit apprendre quelles découvertes sont réelles et quelles mesures de correction sont efficaces.
8. Tester dans des environnements isolés
Le dépôt de CyberGym avertit de ne pas exposer ses services à l'Internet public.
Microsoft décrit également des environnements sandboxés et isolés du réseau pour les tests.
La reproduction des vulnérabilités doit s'effectuer dans une infrastructure contrôlée.
Comment évaluer un système de vulnérabilités IA
Une évaluation sérieuse ne doit pas se résumer à un seul score principal.
Détection et reproduction
- Le système peut-il identifier le code concerné ?
- Le système peut-il générer une preuve de validation exploitable ?
- Cette preuve distingue-t-elle le comportement avant et après le correctif ?
Faux positifs
- Combien de découvertes ne passent pas la validation ?
- Combien de temps la revue humaine de ces découvertes prend-elle ?
Couverture
- Quels langages sont pris en charge ?
- Quels types de projets sont pris en charge ?
- Quelles catégories de vulnérabilités sont traitées ?
Coût
- Quel est le coût par dépôt ?
- Quel est le coût par million de lignes de code ?
- Quel est le coût par vulnérabilité confirmée ?
Latence
- Combien de temps prend l'analyse ?
- Combien de temps prend la validation ?
- Le système peut-il s'intégrer aux flux CI ?
Remédiation
- Le système peut-il proposer des correctifs ?
- Les correctifs compilent-ils ?
- Les tests passent-ils ?
- Les correctifs introduisent-ils des régressions ?
Sécurité
- Le code est-il isolé ?
- L'environnement d'exécution limite-t-il l'accès réseau ?
- Les informations sensibles sont-elles protégées ?
- Les opérations sont-elles auditées ?
Contrôle humain
- Quelles opérations nécessitent une approbation ?
- Le processus de raisonnement complet et les preuves peuvent-ils être rejoués ?
- Les réviseurs peuvent-ils rejeter ou modifier les suggestions ?
Limites importantes du résultat principal
Le score de 95,95 % est significatif, mais il ne doit pas être généralisé au-delà de son cadre de preuves.
C'est un résultat au niveau du système
Ce résultat provient de MDASH, de plusieurs agents, de deux niveaux de modèles, d'outils et de données.
C'est un résultat publié par le fournisseur
Ce résultat a été publié par Microsoft. Une reproduction indépendante reste précieuse.
C'est spécifique à un benchmark donné
CyberGym mesure une tâche bien définie de reproduction de vulnérabilités.
Cela n'élimine pas les faux positifs
Le comportement en matière de faux positifs en environnement de production doit être mesuré séparément.
Cela ne représente pas une autonomie totale
Microsoft conserve une validation humaine pour les opérations critiques.
Cela n'implique pas que le modèle est public
MAI-Cyber-1-Flash est réservé aux clients MDASH approuvés dans le cadre d'un aperçu privé.
Cela ne prouve pas une supériorité universelle
Les résultats peuvent varier selon les langages, les catégories de vulnérabilités, les bases de code, les outils et les frameworks de benchmark.
Questions fréquentes
Qu'est-ce que Microsoft MDASH ?
MDASH est le système multi-modèles et multi-agents de Microsoft permettant d'identifier, valider, prioriser et corriger les vulnérabilités logicielles. Il combine des agents spécialisés, plusieurs modèles, des outils d'analyse de code, la génération de preuves de validation, la vérification et des contrôles de sécurité d'entreprise.
Qu'est-ce que MAI-Cyber-1-Flash ?
MAI-Cyber-1-Flash est le modèle MoE épars spécialisé en cybersécurité de Microsoft. La fiche officielle du modèle indique un total de 137 milliards de paramètres, 500 millions de paramètres actifs, une fenêtre de contexte de 256K et un accès contrôlé.
Il est disponible via MDASH dans l'aperçu privé d'Azure AI Foundry.
MAI-Cyber-1-Flash a-t-il obtenu seul le score de 95,95 % ?
Non. Le résultat de 95,95 % appartient à la configuration complète de MDASH, utilisant MAI-Cyber-1-Flash, GPT-5.4, des agents, des outils, des données et des processus de validation. Les résultats indépendants de la fiche modèle de Microsoft diffèrent et sont inférieurs sur d'autres benchmarks réseau.
Que signifie le chiffre de 90 % ?
Microsoft indique que MAI-Cyber-1-Flash est conçu pour traiter jusqu'à 90 % des tâches dans les flux de travail MDASH routés. Cela ne signifie pas que le modèle découvre ou corrige seul 90 % de toutes les vulnérabilités.
Que mesure CyberGym ?
CyberGym évalue principalement si un agent peut générer une preuve de concept (PoC) reproductible d'une vulnérabilité réelle connue à partir d'une description de vulnérabilité et d'une base de code avant correctif. Cette PoC est testée contre la version vulnérable et la version corrigée.
Le résultat de 95,95 % a-t-il été validé indépendamment ?
Ce score a été publié par Microsoft dans son annonce et sa fiche modèle. Au moment décrit dans l'article source, ce résultat n'apparaissait pas encore comme un résultat mis à jour sur les classements publics de benchmarks, il doit donc être considéré comme une donnée autodéclarée par Microsoft.
Les développeurs peuvent-ils télécharger MAI-Cyber-1-Flash ?
Aucun téléchargement public du modèle n'est documenté. Microsoft indique que le modèle est uniquement disponible via l'aperçu privé d'Azure AI Foundry pour des clients MDASH sélectionnés.
Fourni par le client, et soumis à examen et approbation.
Qu'est-ce que Project Perception ?
Project Perception est le système de sécurité agentique plus large de Microsoft. Il coordonne des agents rouges, des agents bleus et des agents verts, couvrant les flux de travail de détection, d'investigation, de remédiation et de durcissement, tout en laissant les décisions critiques entre des mains humaines.
Outils associés
- CyberGym : outil de référence open source officiel pour évaluer les agents IA sur des tâches de reproduction de vulnérabilités réelles.
- Microsoft CodeQL : moteur d'analyse sémantique de code permettant d'interroger les bases de code pour y détecter des modèles et structures de données liés à la sécurité.
- PyRIT : boîte à outils open source de Microsoft pour l'identification des risques Python, utilisée pour les tests d'intrusion (red teaming) des systèmes d'IA générative.
- Microsoft Foundry : plateforme d'entreprise de Microsoft pour la création, l'évaluation et la gestion de modèles et d'agents IA.
- OpenHands : agent de développement logiciel open source utilisé pour les évaluations de recherche originales de CyberGym.
- OSS-Fuzz : infrastructure de fuzzing continue de Google pour les logiciels open source, également l'une des sources de données de vulnérabilités utilisées par CyberGym.
Liens associés
- Présentation de MAI-Cyber-1-Flash dans MDASH : annonce officielle de Microsoft, couvrant la stratégie de routage des modèles, le résultat de 95,95 %, la réduction des coûts et le cadre « modèle-données-architecture ».
- Fiche modèle MAI-Cyber-1-Flash : spécifications officielles, conditions d'accès, limites, approche de sécurité et détails des benchmarks.
com/en-us/security/blog/2026/05/12/defense-at-ai-speed-microsofts-new-multi-model-agentic-security-system-tops-leading-industry-benchmark/ : aperçu technique de Microsoft sur le cadre, l'architecture de vérification, la recherche en sécurité et les premiers résultats CyberGym.
- Annonce de Project Perception : explication par Microsoft du système d'agents rouges, bleus et verts et de la nouvelle pile réseau.
- Page produit Project Perception : capacités officielles, modèle de gouvernance, approche tarifaire et relation avec Security Copilot.
- Article de recherche CyberGym : article de recherche décrivant le benchmark, les tâches, les données et les résultats d'évaluation originaux.
- Dépôt GitHub CyberGym : guides d'installation, jeux de données, évaluation, soumission, pare-feu et déploiement local.
Résumé
Microsoft indique avoir atteint un taux de réussite de 95,95 % sur CyberGym après l'intégration de MAI-Cyber-1-Flash et le routage des cas les plus difficiles vers GPT-5.4. L'entreprise rapporte également une réduction des coûts de 50 % par rapport à la configuration de modèle la plus performante précédente.
Ce résultat n'appartient pas à un modèle unique. Il provient d'un système de sécurité multi-modèles comprenant plus de 100 agents, des données de sécurité historiques, des outils spécialisés, la génération de preuves, la vérification, la déduplication, des bacs à sable et une orchestration conçue par des humains.
CyberGym teste principalement la capacité à reproduire des vulnérabilités connues à partir de descriptions et de code antérieur au correctif. Par conséquent, ce score démontre de solides performances en reproduction de vulnérabilités sur ce benchmark, et non une découverte générique de failles zero-day ou un taux de correction autonome.
Project Perception étend la même philosophie système au-delà de l'analyse de code : les agents rouges exposent les risques, les agents bleus les investiguent, les agents verts les corrigent, tandis que les décisions critiques demeurent sous contrôle humain.
L'enseignement essentiel est que l'avantage en cybersécurité de pointe passe désormais moins par l'obtention d'un modèle unique et puissant que par la capacité à router, vérifier et exploiter plusieurs modèles au sein d'un système de sécurité fiable.