For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/minicpm-v-4-7-35b-moe-on-iphone-les-and-l-9db57311.md.
MiniCPM-V 4.7 apporte un modèle de mélange d’experts de 35 milliards de paramètres aux appareils locaux, y compris aux téléphones. ModelBest...

MiniCPM-V 4.7 apporte un modèle de mélange d’experts de 35 milliards de paramètres aux appareils locaux, y compris aux téléphones. ModelBest et OpenBMB rapportent plus de 13 jetons générés par seconde avec environ 3 Go de mémoire sur un iPhone 17 Pro Max, grâce à une pile de déploiement optimisée.
Ce chiffre exige toutefois d’être contextualisé. Il ne signifie pas que l’ensemble du modèle 35B tient dans un téléchargement de 3 Go, ni qu’un téléphone disposant de 3 Go de RAM peut exécuter le modèle à la vitesse annoncée. Le modèle diffuse les poids des experts depuis le stockage et utilise des mécanismes d’ordonnancement, de quantification et d’optimisation de l’inférence afin de conserver un faible ensemble de travail actif.
La version comporte deux principales variantes :
| Variante | Conception | Usage prévu |
|---|---|---|
| MiniCPM-V 4.7 35B-A3B | MoE avec 35B de paramètres au total et environ 3B actifs par jeton | Compréhension locale plus avancée des images, documents, ensembles multi-images et vidéos |
| MiniCPM-V 4.7 1B | Petit modèle dense ; QbitAI décrit environ 1,3B de paramètres | Tâches visuelles à ressources limitées, OCR et extraction de documents |
Le modèle 35B-A3B est le premier MoE de la série MiniCPM-V. Le projet a annoncé la version 4.7 le 12 octobre 2026, puis des têtes de décodage spéculatif DSpark pour les deux variantes le 15 octobre.
Le dépôt indique une prise en charge du déploiement sous iOS, Android et HarmonyOS. Il décrit également une prise en charge des plateformes Intel, AMD, Arm, Rockchip et Houmo. Les performances réelles dépendent de l’appareil, du format de modèle, du moteur d’inférence et des réglages ; cette compatibilité ne doit donc pas être interprétée comme une vitesse identique sur tous les matériels.
Le tableau d’évaluation officiel du modèle 35B-A3B présente les résultats suivants en mode Instruct :
| Benchmark | Compression visuelle 4× | Compression visuelle 16× |
|---|---|---|
| MMBench | 91,72 | 90,87 |
| MMStar | 80,67 | 80,13 |
| MMMU | 80,22 | 80,00 |
| MathVista | 88,00 | 87,30 |
| OCRBench | 91,20 | 90,40 |
| OmniDocBench v1.6 | 94,24 | 93,25 |
| Video-MME, sans sous-titres | 76,40 | 74,70 |
| LongVideoBench | 68,90 | 67,60 |

Source : OpenBMB, dépôt MiniCPM-V. Son tableau combine des rapports publics et les évaluations locales de l’équipe à l’aide de points de contrôle officiels en mode Instruct.
Le tableau montre des baisses relativement faibles sur plusieurs tâches lors du passage à une compression visuelle plus forte. MMBench baisse par exemple de 0,85 point, tandis qu’OCRBench baisse de 0,80 point. D’autres tâches perdent davantage ; les développeurs doivent donc toujours vérifier si les petits caractères, les graphiques ou les détails visuels ont une importance pour leur propre charge de travail.
Il s’agit de résultats d’évaluation du modèle, et non d’une preuve que la configuration mobile reproduit tous les scores ou que chaque image utilisateur sera interprétée correctement. Ils constituent des points de référence utiles pour choisir les tests à effectuer.
Les MoE réduisent les calculs en n’activant que les experts sélectionnés pour un jeton. Ils ne suppriment pas la nécessité de stocker les autres experts, car les jetons et couches suivants peuvent en sélectionner d’autres.
Sur un téléphone aux capacités mémoire limitées, stocker ces poids en mémoire flash rend le modèle disponible, mais attendre le stockage de manière répétée peut ralentir le décodage. Restreindre le routage à un sous-ensemble fixe d’experts limite les chargements, mais modifie les experts auxquels le modèle peut recourir. MiniCPM-V 4.7 cherche plutôt à faire chevaucher le chargement et le calcul tout en préservant les décisions réelles du routeur.
Le Lookahead Expert Scheduling, ou LES, prédit les experts dont la couche suivante aura probablement besoin et précharge leurs poids. Lorsque le routeur réel sélectionne les experts, le moteur calcule d’abord les experts sélectionnés déjà disponibles tout en chargeant les autres experts nécessaires.
La prédiction modifie l’ordre de préparation et d’exécution. Elle ne remplace pas la décision de routage du modèle : les experts non anticipés sont tout de même chargés et évalués. Cette distinction explique pourquoi cette technique peut améliorer la vitesse sans s’appuyer sur un pool d’experts réduit de façon permanente.
Le guide officiel associe le LES à une quantification fine, couche par couche. Des poids d’experts plus petits réduisent les transferts entre le stockage et la mémoire, tandis qu’une disposition optimisée rend le chargement plus efficace. L’équipe rapporte une amélioration par cinq du décodage sur des appareils réels grâce à son travail d’optimisation embarquée ; il s’agit d’un résultat pour sa configuration testée, et non d’un multiplicateur universel.
DSpark ajoute un modèle brouillon qui propose des jetons que le modèle principal vérifie. La version fournit des têtes de brouillon dédiées pour les deux tailles. Il s’agit d’un autre composant de la pile optimisée ; il ne faut donc pas supposer qu’un point de contrôle standard exécuté dans un backend générique atteindra la même vitesse.
Côté vision, le modèle utilise une compression précoce au sein de l’encodeur visuel, fondée sur LLaVA-UHD v4. La fusion précoce des jetons visuels réduit le travail des couches ultérieures de l’encodeur. Les réglages sélectionnables 4× et 16× exposent un compromis entre le niveau de détail visuel et le coût d’inférence.
La documentation officielle de l’application mobile donne une vision beaucoup plus claire du déploiement complet :
| Élément du déploiement mobile | Exigence ou taille documentée |
|---|---|
| Téléphone validé pour 35B-A3B | iPhone 17 Pro Max avec 12 Go de RAM |
| RAM d’appareil recommandée pour la démo 35B-A3B | Au moins 12 Go |
| Téléchargement total du modèle 35B-A3B | Environ 16,6 Go |
| Espace de stockage libre recommandé | Environ 17 Go pour les fichiers du modèle |
| Stockage des experts | Répertoire experts/ distinct contenant 40 fragments et un manifeste |
| Fenêtre de contexte par défaut de la démo | 4K jetons |
Le package mobile fractionné diffère d’un GGUF standard représentant le modèle entier. Son fichier principal -les s’appuie sur le répertoire d’experts correspondant, et l’application vérifie que les fichiers sont cohérents. Des fenêtres de contexte plus grandes augmentent la mémoire du cache KV, tandis qu’un cache d’experts plus petit sur des appareils à faible RAM peut ralentir considérablement la génération.
Un faible chiffre de mémoire de travail n’élimine pas le besoin d’un stockage local rapide et conséquent.
L’article de QbitAI présente des exemples locaux sur téléphone et tablette, puis des tests API distincts. Cette distinction est importante : un résultat d’API ne prouve pas que la même tâche a été exécutée hors ligne sur le téléphone.
Dans la démonstration d’ouverture sur iPhone, le modèle examine le graphique de Minard relatif à la campagne de Russie de Napoléon. Interrogé sur la température la plus basse et sa date, il identifie −30° Réaumur le 6 décembre 1812 et la convertit en −37,5 °C avec °C = °Ré × 1.25.
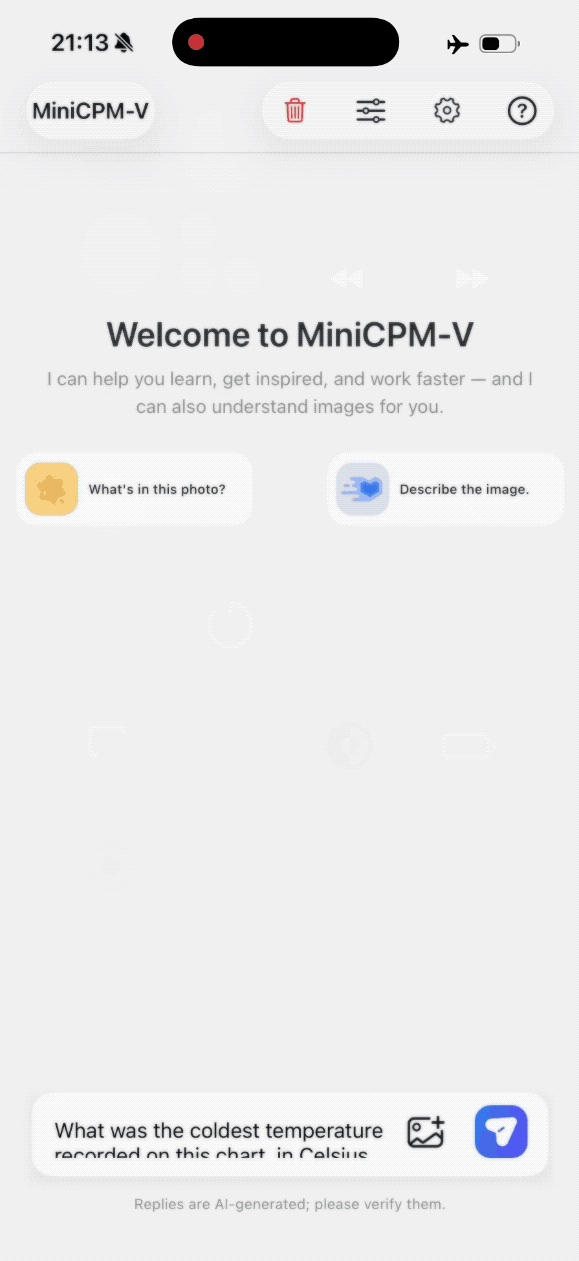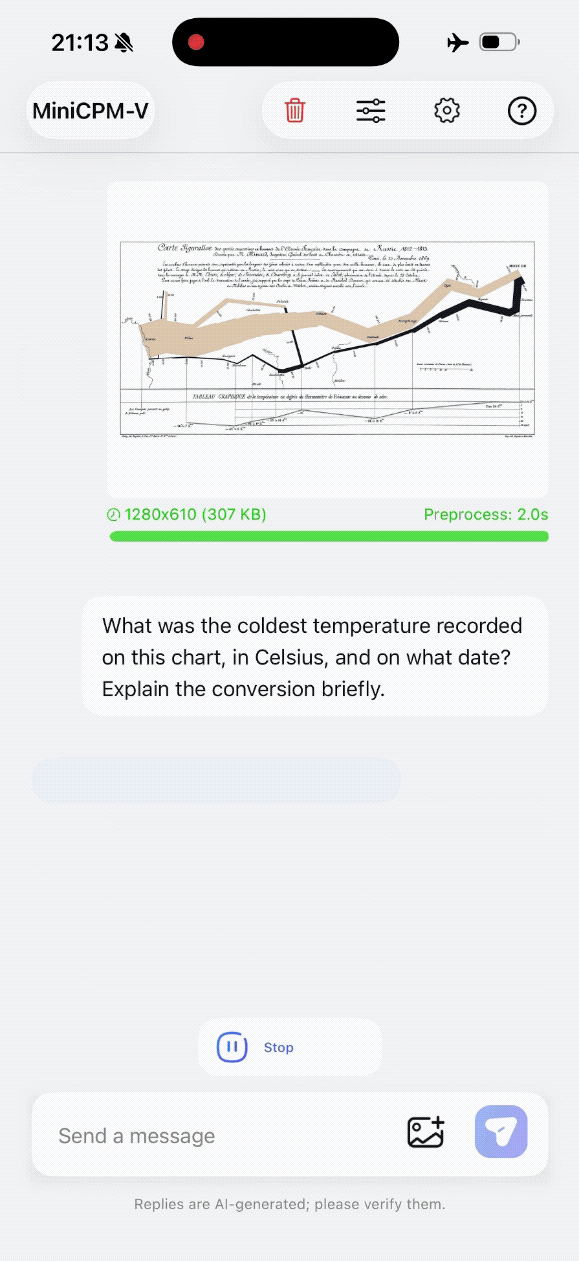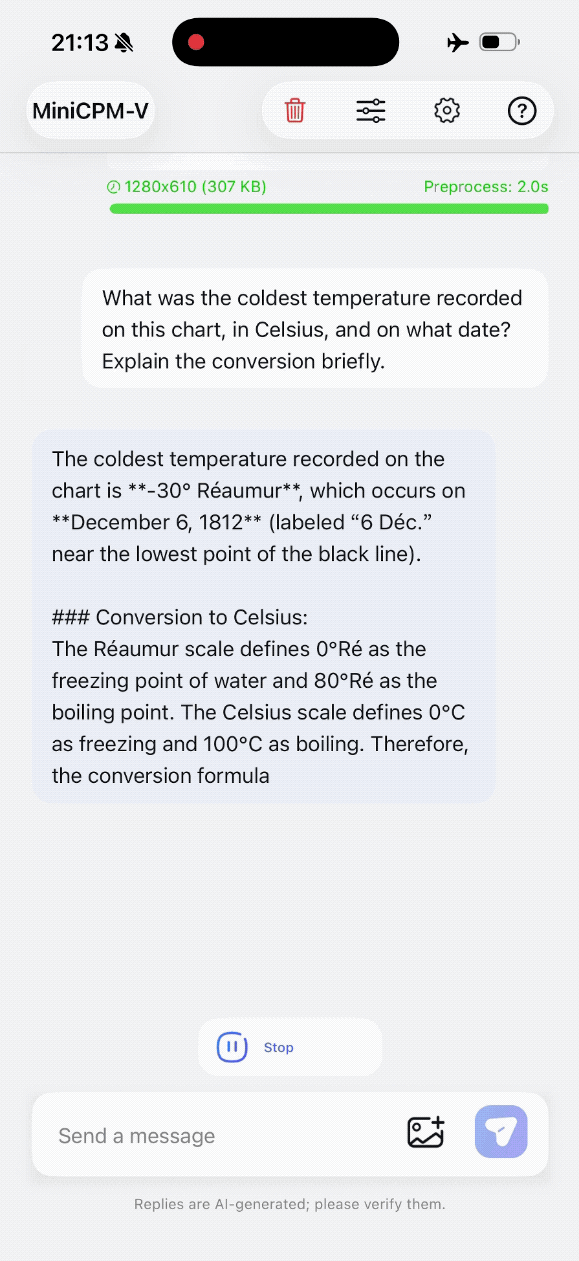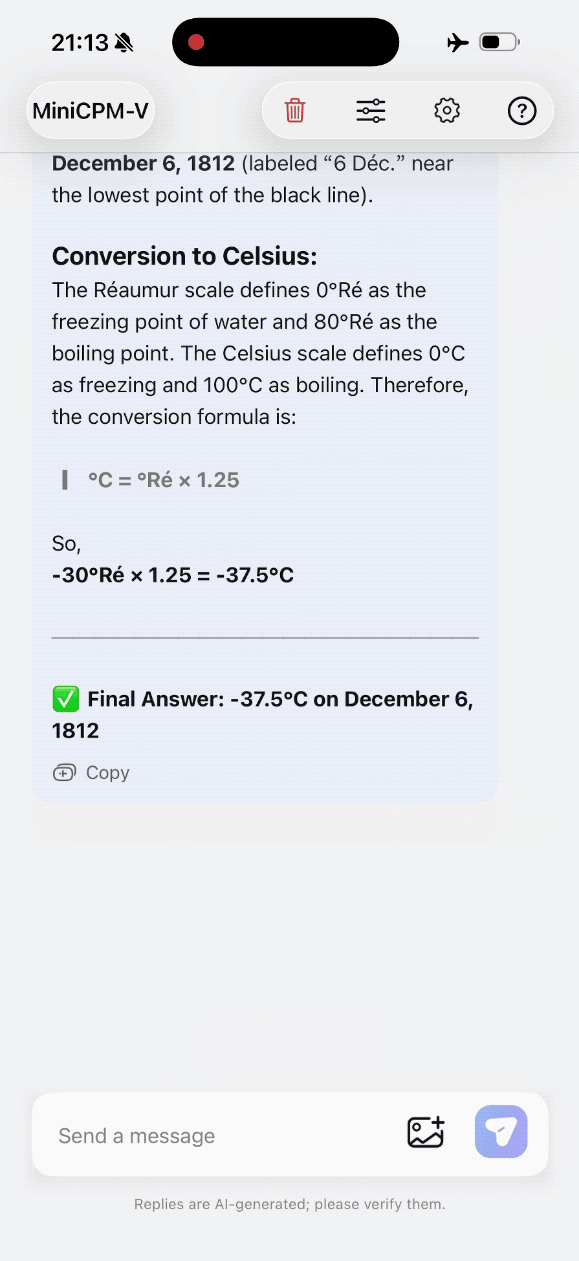
Source : QbitAI via BAAI ; enregistrement animé de l’écran du téléphone. La source rapporte également la même réponse sur un iPad M4.
Cet exemple teste davantage que la reconnaissance de texte. Le modèle doit lire le graphique, associer une date au point pertinent, reconnaître l’échelle de température et appliquer une conversion.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Un autre exemple combine les puissances et les temps d’utilisation d’appareils avec une facture mensuelle de 420 kWh pour un coût de ¥126. La réponse rapportée estime 213,63 kWh pour les appareils listés, soit environ 50,9 % de la facture, et identifie la réduction de l’utilisation de la climatisation comme le meilleur des trois plans d’économies proposés.
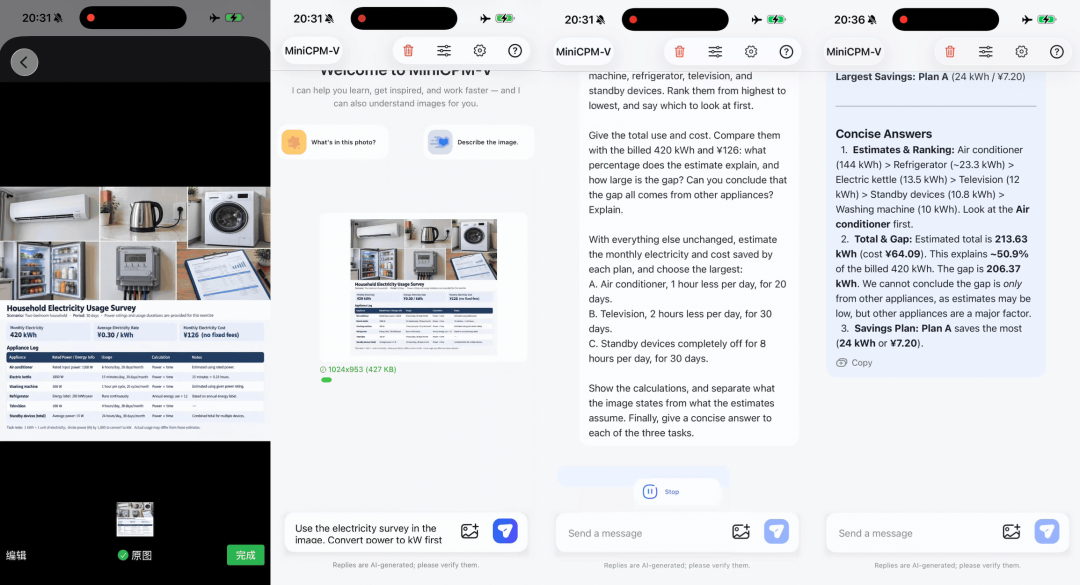
Source : QbitAI via BAAI. La réponse affichée traite la consommation inexpliquée comme incertaine au lieu de l’attribuer automatiquement à d’autres appareils.
Cette réserve est utile : les heures estimées, la consommation électrique réelle et les appareils omis peuvent tous influer sur la comparaison avec une facture. Un total arithmétique correct ne permet pas, à lui seul, d’établir l’origine de la consommation restante.
Le plus petit modèle est présenté en train de convertir une page d’article scientifique en Markdown, y compris les titres, un tableau et des notations mathématiques. QbitAI indique que la démonstration a pris moins d’une demi-minute.
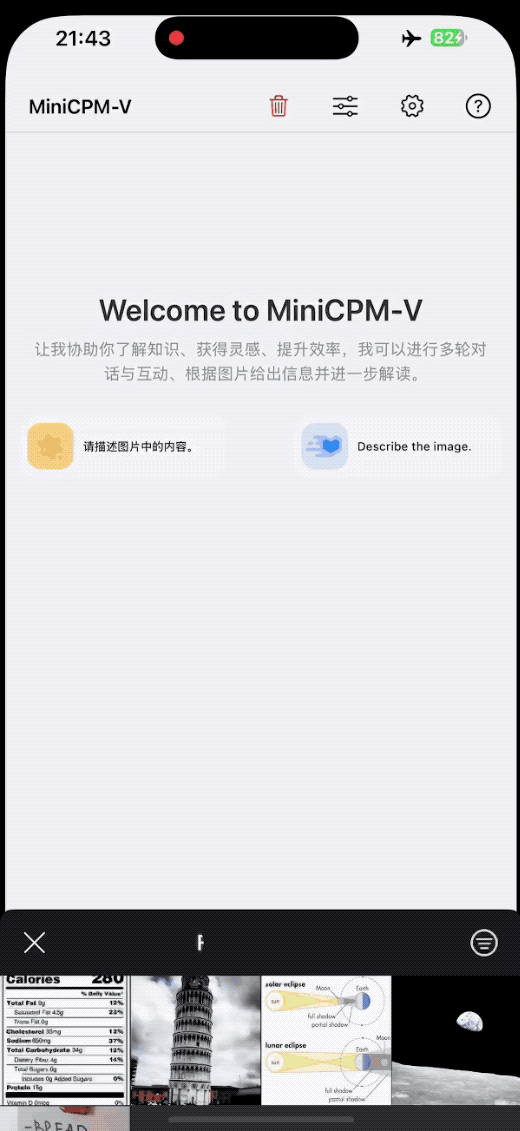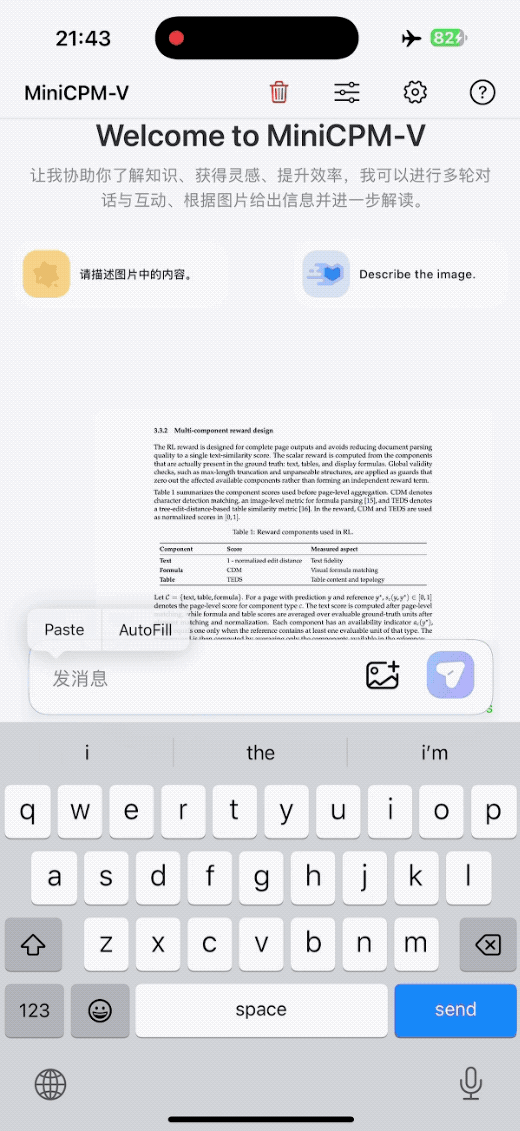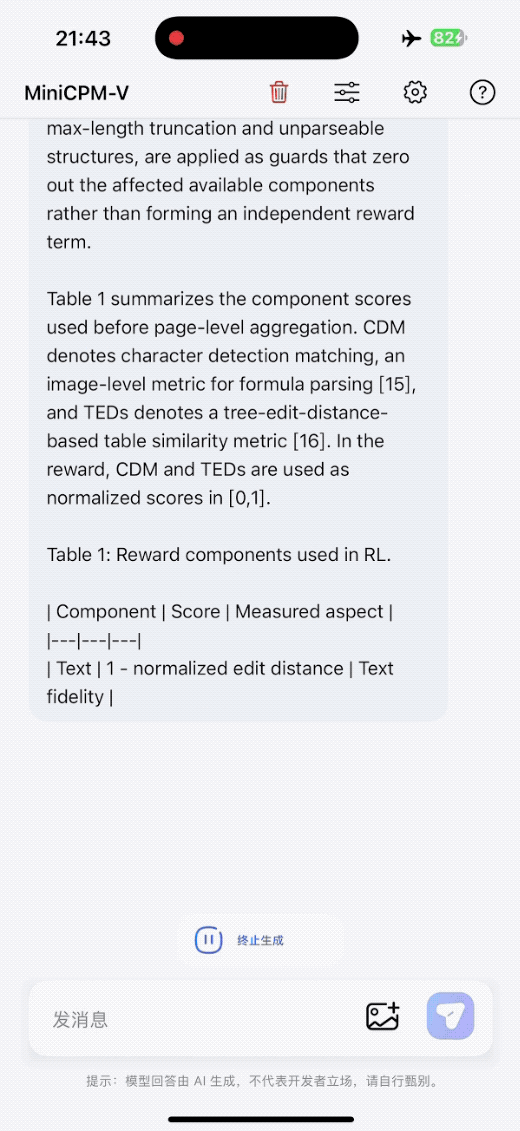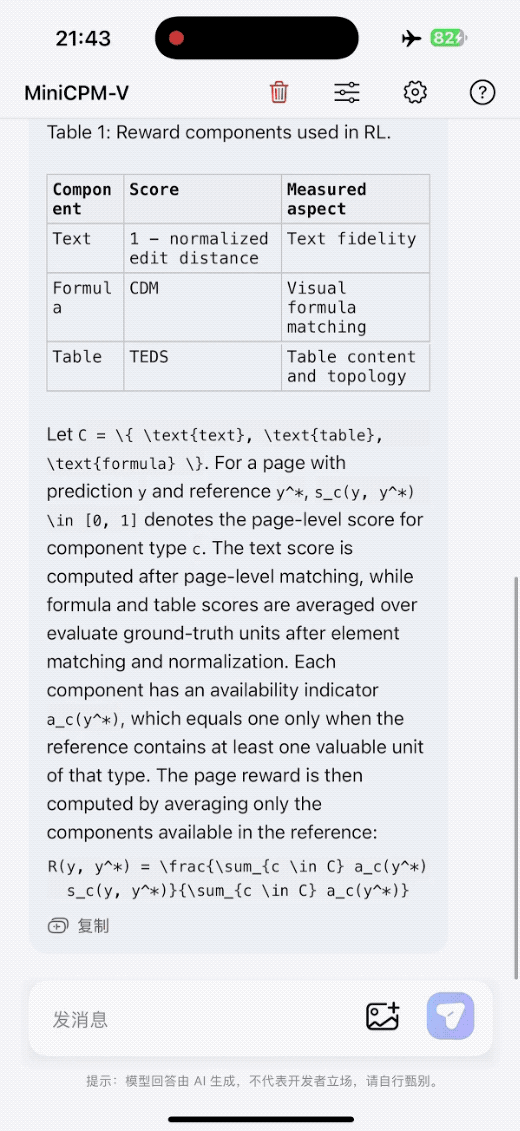
Source : QbitAI via BAAI ; démonstration locale animée sur document.
Dans ses tests API distincts, l’article rapporte un calcul de ticket de caisse de ¥86,40 moins ¥8 de remises, correspondant à un paiement de ¥78,40. Il décrit aussi une tâche relative aux règles de stationnement qui vérifie un séjour de 90 minutes au regard de restrictions de nettoyage, d’une limite de deux heures, d’exemptions pour les résidents et de conditions de réentrée. Il s’agit de tests illustratifs, et non d’une étude systématique de précision.
Une version associée traite le problème de l’oubli durant la personnalisation. Le Self-Replay Fine-Tuning génère des réponses de domaine général à partir du modèle d’origine, les filtre pour leur qualité, puis mélange les exemples conservés avec les nouvelles données de tâche durant le fine-tuning supervisé standard.
La méthode modifie les données d’entraînement plutôt que l’architecture du modèle ou la fonction de perte. Les exemples de replay peuvent être générés avant l’entraînement et réutilisés, ce qui réduit le besoin de nouveaux déploiements en ligne pendant chaque exécution.
La publication d’OpenBMB rapporte des résultats encourageants de rétention sur des expériences de comptage et d’OCR de documents, notamment avec des modèles MiniCPM antérieurs et d’autres familles de modèles. Ces résultats ne doivent pas être présentés comme une garantie générale pour chaque fine-tuning de la version 4.7. La couverture des prompts, la qualité du filtrage et le ratio entre données de tâche et données de replay restent des choix expérimentaux.
Le dépôt de l’application mobile fournit des démonstrations pour iOS, Android et HarmonyOS. Pour le chemin MoE sur téléphone, son gestionnaire de modèles intégré télécharge le fichier principal correspondant, le projecteur visuel et les fragments d’experts ; le dépôt avertit que les fichiers GGUF de bureau ordinaires et non fractionnés ne sont pas interchangeables avec ce package mobile.
Pour d’autres déploiements, le guide 4.7 répertorie SGLang, vLLM, llama.cpp et Ollama, ainsi que SWIFT et LLaMA-Factory pour le fine-tuning. Il renvoie vers des options de quantification incluant GGUF, BNB, AWQ, GPTQ et FP8. Il convient de choisir l’artefact adapté au runtime visé, au lieu de considérer chaque format pris en charge comme un modèle mobile directement interchangeable.
L’inférence hors ligne commence une fois que l’application nécessaire et les fichiers du modèle sont présents localement. Cela évite d’envoyer chaque requête d’inférence à un modèle cloud, tout en laissant les autorisations de l’application, la gestion locale des données, le stockage et les performances matérielles comme préoccupations pratiques de déploiement.
Il s’agit d’une version de modèle multimodal de ModelBest et OpenBMB, avec les variantes MoE 35B-A3B et 1B. Elle prend en charge des tâches portant sur les images, les documents, les images multiples et la vidéo.
Le projet démontre un déploiement optimisé de 35B-A3B sur un iPhone 17 Pro Max. Il conserve un ensemble de travail plus réduit en mémoire tout en diffusant les experts depuis le stockage local, au lieu de charger les 35B de paramètres en RAM en une seule fois.
Non. La démonstration mobile officielle indique un téléchargement total d’environ 16,6 Go pour le package 35B-A3B et recommande environ 17 Go de stockage libre. L’iPhone validé dispose de 12 Go de RAM.
Non. Le LES prédit les experts à précharger et ordonne en premier ceux qui sont déjà disponibles. Le routeur réel du modèle continue de sélectionner les experts à calculer, y compris ceux que la prédiction n’avait pas anticipés.
Oui. Les démonstrations locales effectuent l’inférence sur l’appareil une fois les fichiers requis téléchargés ou installés. Les exemples API de la source sont des tests distincts et ne doivent pas être confondus avec le fonctionnement hors ligne.
Non. La démonstration exige un package fractionné correspondant, avec son fichier principal -les, un projecteur visuel et des fragments d’experts. La documentation de l’application explique pourquoi les fichiers GGUF standard représentant le modèle entier ne produisent pas le même comportement de déploiement sur téléphone.
MiniCPM-V 4.7 associe calcul parcimonieux, diffusion des experts, ordonnancement prédictif, quantification et compression visuelle afin de rendre un modèle multimodal plus important utilisable sur certains appareils locaux. Les démonstrations couvrent l’interprétation de graphiques, la conversion de documents et des calculs du quotidien, tandis que les benchmarks publiés offrent des points de départ pour l’évaluation.
La principale contrainte de déploiement réside dans la différence entre la mémoire de travail, la RAM totale de l’appareil et les poids stockés. Le résultat sur téléphone est crédible en tant que configuration optimisée spécifique, et non comme la promesse qu’un modèle 35B complet tient dans 3 Go ou fonctionne aussi bien sur tous les appareils.
Partez d’une phrase et obtenez un site complet en quelques minutes.