For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/minimax-m3-1-flash-api-pricing-benchmarks-c8e3fe1c.md.
MiniMax a lancé M3.1 Flash avec une tarification des tokens réduite et de meilleurs résultats annoncés en raisonnement et sur les tâches d’a...
MiniMax a lancé M3.1 Flash avec une tarification des tokens réduite et de meilleurs résultats annoncés en raisonnement et sur les tâches d’agent. La couverture publiée par THE DECODER le 19 octobre lui attribue 42 points sur l’Artificial Analysis Intelligence Index, contre 29 pour M3.
La distinction importante concerne le prix d’un token et le coût nécessaire pour accomplir une tâche. Un modèle peut être moins cher sur ces deux critères, mais le coût par tâche dépend également de la quantité de contenu générée, de la fréquence des nouvelles tentatives et de l’utilisabilité du résultat.
La comparaison réalisée au moment du lancement place M3.1 Flash aux côtés de GLM-5.3-Flash sur l’indice composite, juste devant Gemini 3.8 Flash et derrière DeepSeek V4.1 Flash 1017.
| Évaluation rapportée | M3.1 Flash | Comparaison mise en avant dans le rapport |
|---|---|---|
| Artificial Analysis Intelligence Index | 42 | M3 : 29 ; GLM-5.3-Flash : 42 ; Gemini 3.8 Flash : 41 ; DeepSeek : 45. |
| Humanity’s Last Exam | 48 % | DeepSeek : 43 %. |
| CritPt | 22 % | GLM : 15 % ; Gemini : 18 % ; DeepSeek : 24 %. |
| Précision AA-Omniscience | 56 % | GLM : 28 % ; DeepSeek : 43 %. |
| Coût moyen d’évaluation par tâche | Environ 0,22 $ | DeepSeek : environ 0,26 $. |
Ces chiffres sont ceux rapportés au moment de la publication. Les configurations des benchmarks, les versions évaluées et les révisions des modèles sont importantes ; ce tableau ne constitue pas un classement universel pour toutes les charges de travail.

Crédit du graphique : Artificial Analysis, reproduit par THE DECODER.
Le rapport attribue en partie la baisse du coût par tâche à la réduction de la consommation de tokens de sortie. La comparaison d’environ 189 millions contre 224 millions de tokens de sortie concerne les totaux des benchmarks, et non la quantité générée par une requête ordinaire.
MiniMax affirme séparément que l’inférence en ligne est presque trois fois plus rapide et que les coûts globaux d’utilisation des tâches d’agent sont réduits de 70 % par rapport à son prédécesseur. Ces mesures communiquées par l’entreprise ne correspondent pas à la comparaison des coûts réalisée par Artificial Analysis. Elles ne doivent pas être combinées pour constituer un unique résultat d’efficacité vérifié indépendamment.
Le rapport cite également un taux d’hallucination AA-Omniscience de 93 %. Cela ne signifie pas que 93 % de toutes les réponses étaient incorrectes, et ce chiffre ne prédit pas le taux d’erreur d’un assistant déployé sur des tâches arbitraires.
Artificial Analysis définit ce taux sur les réponses non correctes : les réponses incorrectes divisées par l’ensemble constitué des réponses incorrectes, partielles et non tentées. Il mesure la tendance à fournir une mauvaise réponse lorsqu’il serait préférable de reconnaître l’incertitude. La précision, en revanche, compte les réponses correctes sur l’ensemble des questions.
Cette distinction permet à un modèle d’avoir simultanément une précision factuelle relativement élevée et une mauvaise gestion de l’incertitude. Pour les travaux sensibles aux connaissances, il faut vérifier les éléments de preuve et la capacité du modèle à s’abstenir, plutôt que de s’appuyer uniquement sur un score composite.
THE DECODER rapporte une fenêtre de contexte pouvant atteindre un million de tokens ainsi que la prise en charge des entrées textuelles et des images. La prise en charge des images ne doit pas être confondue avec la génération d’images : accepter une image n’implique pas la capacité à en produire une.
L’annonce officielle de MiniMax confirme une tarification forfaitaire par million de tokens :
| Catégorie de tokens | Prix par million de tokens |
|---|---|
| Entrée | 0,15 $ |
| Sortie | 0,60 $ |
| Entrée mise en cache | 0,015 $ |
La tarification mise en cache s’applique aux accès éligibles au cache, et non à tous les tokens d’entrée. Par exemple, un million de tokens d’entrée non mis en cache plus un million de tokens de sortie coûteraient 0,75 $ aux tarifs indiqués, avant toute autre facturation applicable. Il s’agit d’une illustration du coût des tokens, et non d’une estimation typique du coût d’une tâche.
L’API, M Plan et MiniMax Code sont les voies d’accès mentionnées dans l’annonce officielle. THE DECODER indique le 23 octobre comme date prévue de publication des poids ouverts ; l’article de l’entreprise consulté indique que les poids arriveront ultérieurement, sans préciser cette date. Au moment de la préparation de cet article, le 20 octobre, une publication future ne doit pas être présentée comme des poids déjà disponibles au téléchargement.
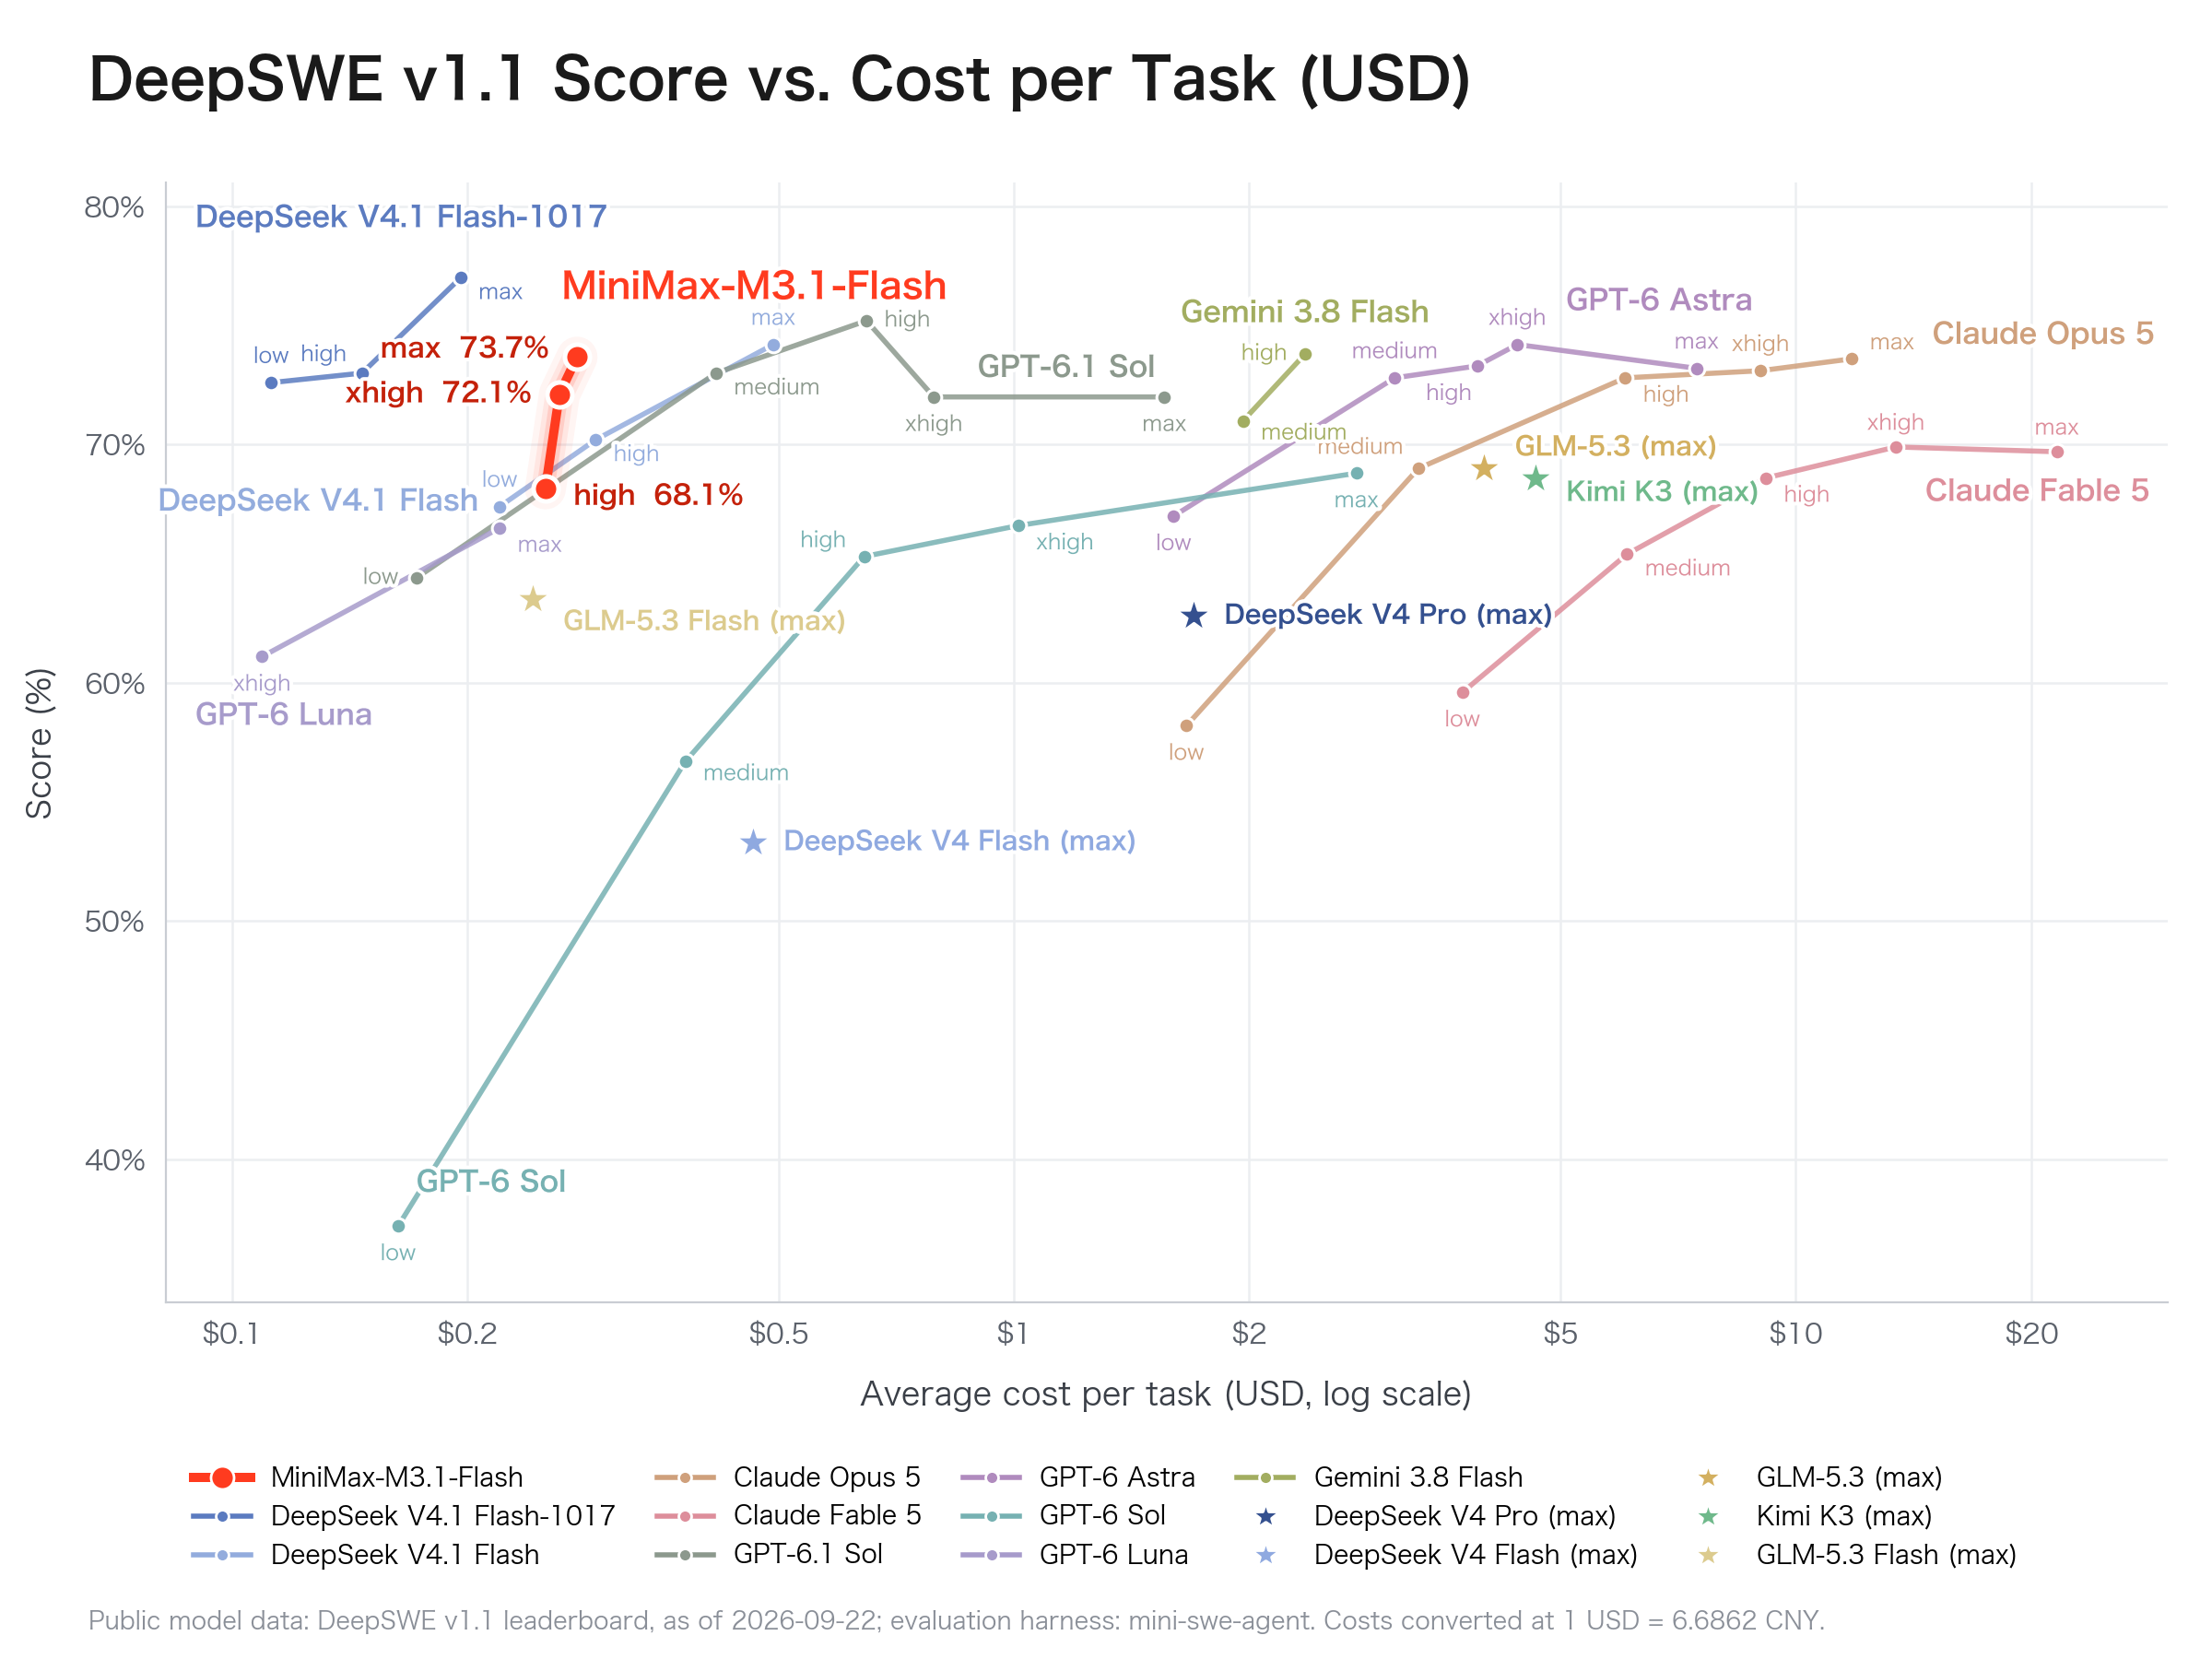
MiniMax annonce jusqu’à 73,7 % sur DeepSWE v1.1 pour un coût par tâche inférieur à 0,30 $ dans son graphique. Les configurations avec un niveau d’effort inférieur présentées dans la même figure échangent une partie du score contre un coût plus faible.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Graphique publié par l’entreprise ; la figure indique mini-swe-agent comme environnement d’évaluation et précise la date des données de comparaison.
Un score de programmation reflète conjointement le modèle, les outils, le niveau d’effort et l’environnement de test. Il ne signifie pas que 73,7 % des tickets d’une organisation seront résolus sans vérification, ni que chaque tâche coûtera la moyenne représentée sur le graphique.
La comparaison finale de la source ne désigne pas un vainqueur unique. DeepSeek est en tête sur l’indice composite et sur le score de physique cité, tandis que MiniMax obtient le meilleur résultat rapporté sur Humanity’s Last Exam et en précision AA-Omniscience.
Le coût moyen par tâche plus faible de MiniMax dans cette évaluation constitue un élément utile pour les tests, mais ne permet pas de supposer que le modèle sera le moins cher avec tous les prompts. Une charge de travail générant des sorties plus longues, des appels d’outils échoués ou davantage de nouvelles tentatives peut modifier le classement.
Le rapport distingue également l’état de disponibilité des modèles : il renvoie vers un dépôt de poids DeepSeek déjà existant, tout en décrivant les poids de MiniMax comme à venir. Les poids ouverts, un abonnement à une API et une application de programmation de bureau sont des modes de distribution distincts, avec des exigences opérationnelles différentes.
Il s’agit du nouveau modèle Flash de MiniMax, disponible via ses produits hébergés et son API. Le lancement met l’accent sur le raisonnement, les tâches d’agent, la programmation et l’efficacité de l’inférence.
L’annonce officielle indique 0,15 $ pour l’entrée, 0,60 $ pour la sortie et 0,015 $ pour l’entrée mise en cache par million de tokens. Vérifiez les tarifs actuels de votre compte et les règles du cache avant d’estimer une facture de production.
Non : il s’agit d’une moyenne rapportée pour un benchmark. Les coûts réels dépendent de la taille du prompt, du volume généré, du comportement du cache, des boucles d’utilisation des outils et des nouvelles tentatives.
Non : le dénominateur de cette mesure contient les réponses non correctes, et non l’ensemble des réponses. Elle concerne, dans cette évaluation, les suppositions incorrectes par rapport aux réponses partielles ou à l’abstention.
Les sources examinées les décrivent comme à venir. THE DECODER cite le 23 octobre, tandis que l’annonce de MiniMax ne donne aucune date exacte ; vérifiez le dépôt et la licence effectivement publiés au moment de leur disponibilité.
Les résultats rapportés varient selon les benchmarks. Le choix doit dépendre des tâches spécifiques, des exigences de fiabilité et du coût total mesuré lors de votre propre évaluation.
M3.1 Flash combine des prix de tokens affichés bas avec des résultats annoncés compétitifs en raisonnement et en programmation. Son avantage de coût est surtout significatif lorsqu’il est mesuré par tâche réussie, dans des conditions comparables.
Lisez les définitions des benchmarks, distinguez les affirmations de l’entreprise des mesures externes et vérifiez la disponibilité effective des poids avant de planifier un déploiement.
Partez d’une phrase et obtenez un site complet en quelques minutes.



