
MiniMax a lancé M3.1 Flash le 19 octobre, peu après DeepSeek V4.1 Flash-1017. L’article fourni compare les deux modèles à l’aide de graphiques mettant en regard les scores et les coûts pour des tâches de programmation et d’agent, où des modèles relativement peu coûteux se rapprochent de systèmes plus chers dans certaines évaluations.
La formulation « DeepSeek d’abord, MiniMax ensuite » concerne une comparaison particulière entre le coût et les performances en programmation. Elle ne doit pas être interprétée comme un classement valable pour toutes les tâches, toutes les versions de modèles ou tous les paramètres de déploiement. La question la plus utile est de déterminer quelle configuration réalise le travail de manière fiable pour un coût total acceptable.
Résultats en programmation et workflows d’agents d’entreprise
Les supports de lancement de MiniMax indiquent 73,7 % sur DeepSWE v1.1, une évaluation qui porte sur la compréhension de dépôts, le développement, les corrections et les tests. Le tableau de la source attribue à DeepSeek V4.1 Flash-1017 un score de 77,0, à GPT-5.6 Sol un score de 73,0 et à Opus 5 un score de 74,0 dans cette comparaison.
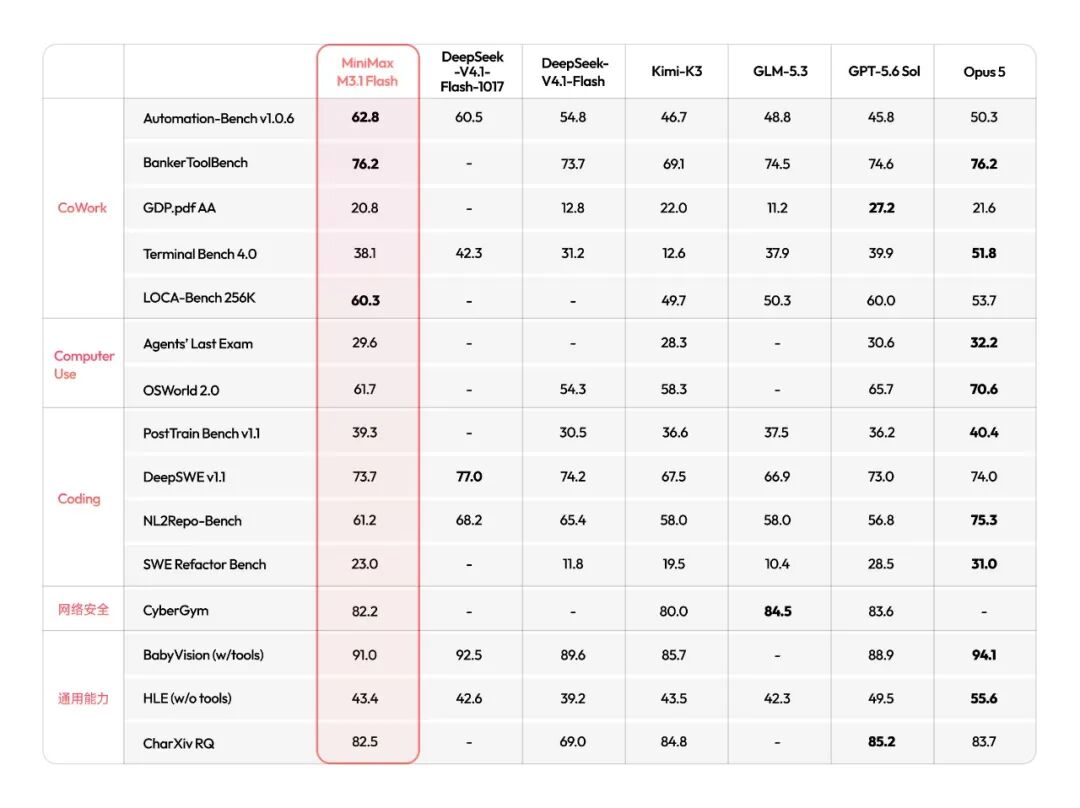
Comparaison des entreprises reproduite par Xinzhiyuan ; les versions des modèles et les conditions d’évaluation sont importantes.
Le graphique des coûts place M3.1 Flash près de l’extrémité la moins coûteuse pour son score indiqué, tandis que DeepSeek Flash-1017 est en avance dans cette comparaison représentée. Différents niveaux d’effort apparaissent sous forme de points distincts ; le choix d’une configuration peut donc modifier à la fois le coût et le résultat.
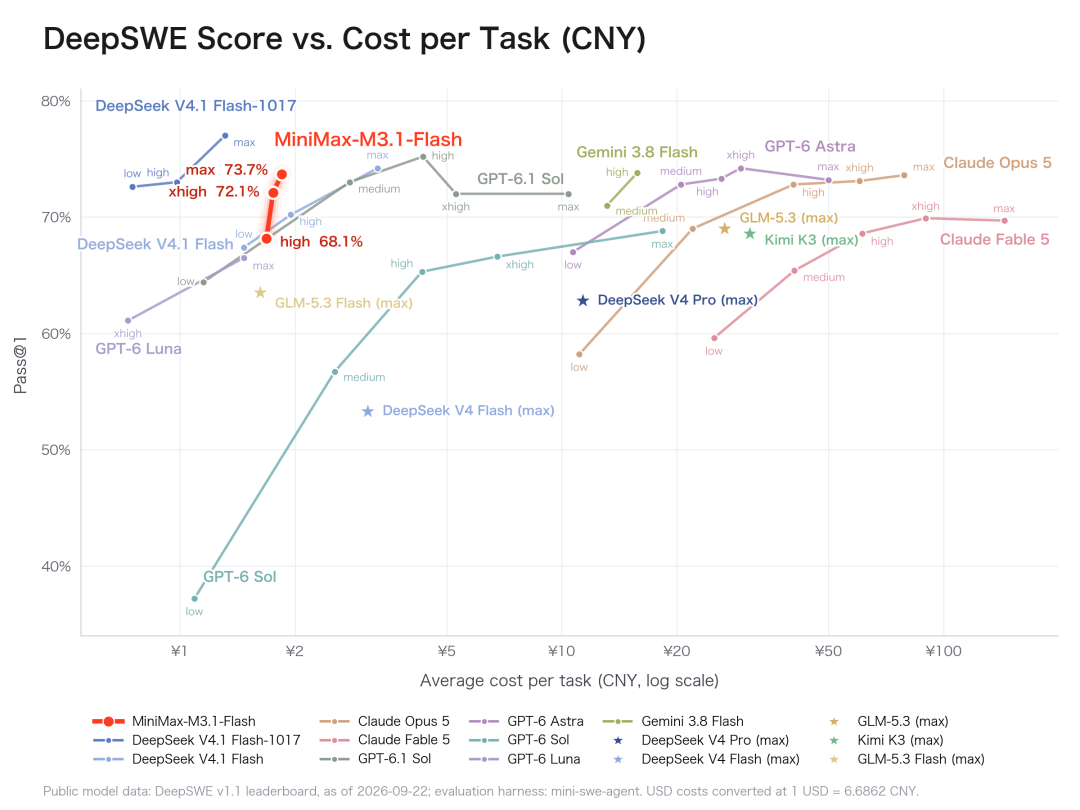
Une moyenne inférieure à 2 CNY dans cette évaluation ne constitue pas un tarif fixe pour chaque correction de bug. La consommation de tokens, les tentatives échouées, la taille du dépôt et l’utilisation d’outils peuvent modifier le coût réel d’une tâche.
Automatisation et utilisation d’outils
Sur Automation-Bench, le graphique fourni indique 62,8 % au niveau d’effort maximal. Il place M3.1 Flash au-dessus des autres configurations présentées, y compris un point MiniMax à effort inférieur qui échange une partie du score contre un coût plus bas.
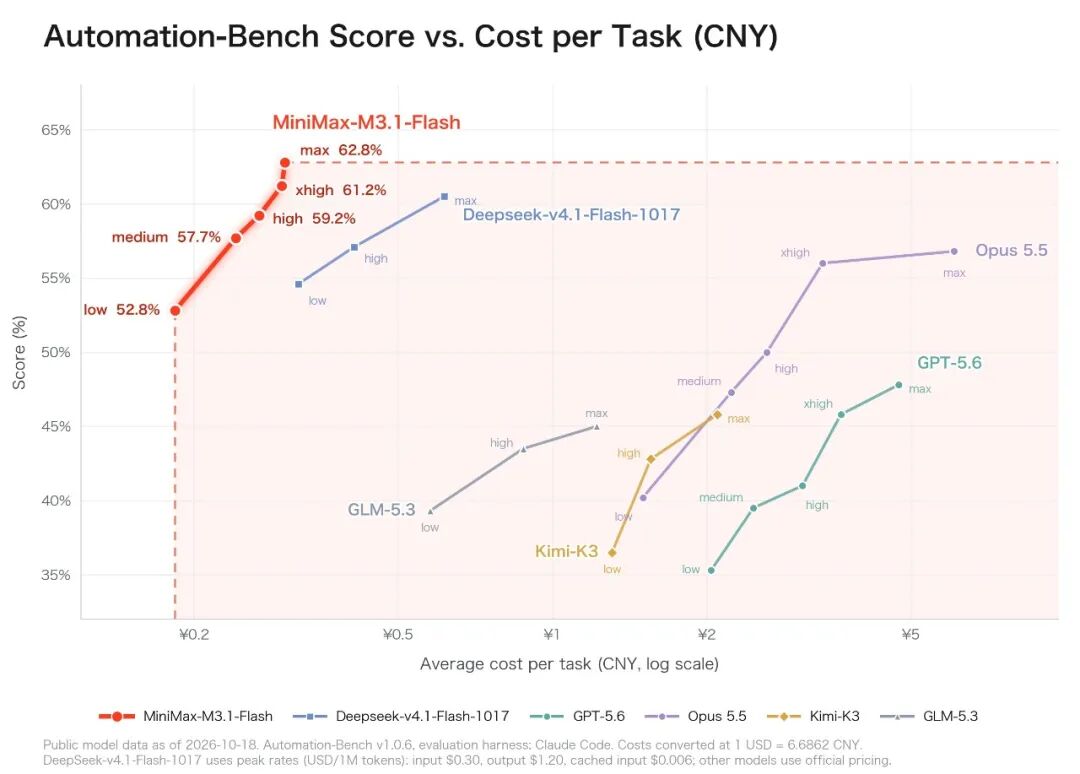
La source décrit des workflows d’entreprise couvrant des outils SaaS et des fonctions métier. Un benchmark n’en approxime que certains aspects ; il ne permet pas d’établir qu’un modèle réussira dans chaque processus réel de vente, de finance ou de support client.
Les autres scores attribués à MiniMax et rapportés dans la source comprennent :
| Évaluation | Score de M3.1 Flash dans la source | Limite de comparaison |
|---|---|---|
| LOCA-Bench 256K | 60,3. | Légèrement supérieur au score de 60,0 attribué à GPT-5.6 Sol. |
| BankerToolBench | 76,2. | À égalité avec le score d’Opus 5 dans ce tableau. |
| CyberGym | 82,2. | Inférieur aux scores affichés de GLM-5.3 et GPT-5.6 Sol ; reste toutefois compétitif dans cet instantané. |
| OSWorld 2.0 | 61,7. | Supérieur au score affiché de 54,3 pour DeepSeek V4.1 Flash ; ce n’est pas le score le plus élevé parmi tous les modèles listés. |
| Agents' Last Exam | 29,6. | Inférieur aux scores de 30,6 pour GPT-5.6 Sol et de 32,2 pour Opus 5. |
Il s’agit de tests distincts, et non de valeurs pouvant être moyennées pour obtenir un taux de réussite universel significatif sans méthodologie explicite.
Utilisation d’un ordinateur et estimation ALE de 739 CNY
L’annonce officielle de MiniMax confirme les scores rapportés de 61,7 sur OSWorld V2 et de 29,6 sur Agents' Last Exam. Son affirmation de dominer les modèles chinois dans ces tests est limitée à la comparaison et aux conditions de test utilisées pour le lancement.
Le graphique ALE de la source estime à 739 CNY le coût de l’exécution de l’ensemble des 152 tâches, avec un taux de réussite de 29,6 %. Il n’indique pas que chaque tâche a été réussie ni que le coût correspond à une tâche réussie.
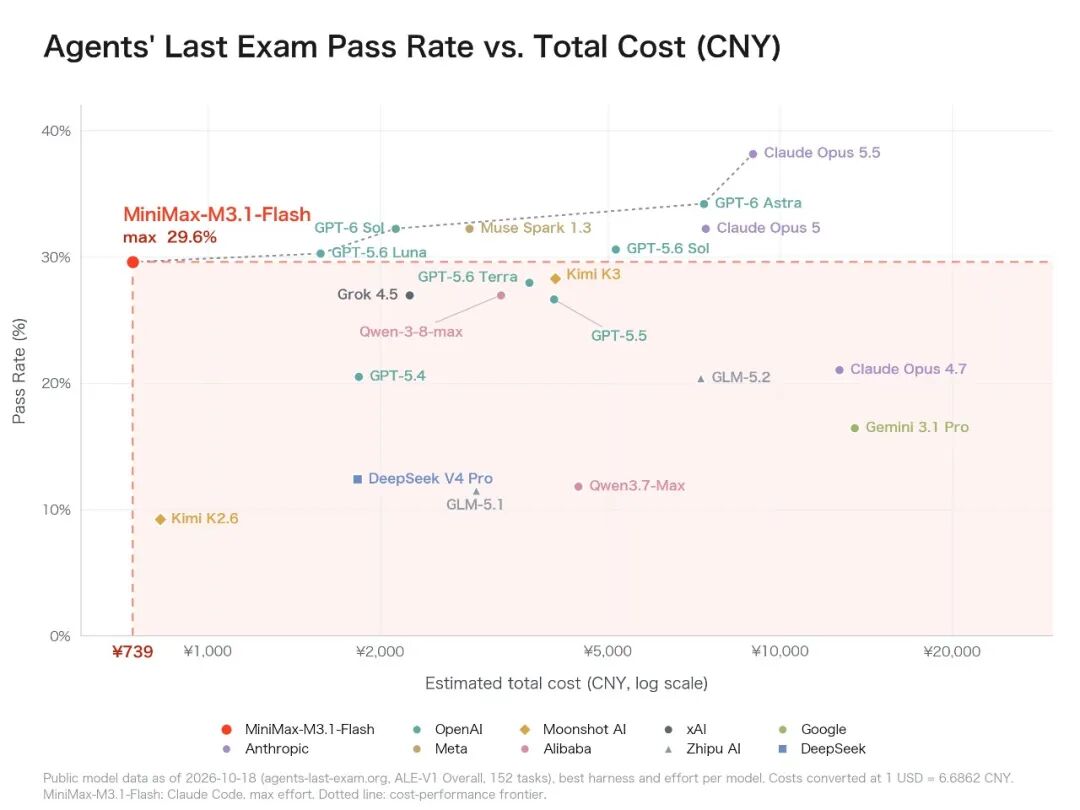
Diviser 739 CNY par 152 donne environ 4,86 CNY par tâche tentée. Ce calcul explique l’échelle du graphique ; il n’inclut pas les coûts d’intégration, d’infrastructure ou de revue humaine d’une organisation.
La frontière en pointillés relie certaines configurations présentant des résultats favorables au regard de leurs coûts représentés. Sa forme dépend des modèles inclus, de la date d’évaluation et des hypothèses de coût. Un point situé sur cette frontière constitue un élément de comparaison utile, et non la preuve que la même configuration est la moins chère pour toutes les charges de travail.
Tarification des tokens et calcul du cache
L’annonce officielle en anglais de MiniMax indique des tarifs fixes par million de tokens de 0,15 $ pour les entrées, 0,60 $ pour les sorties et 0,015 $ pour les entrées mises en cache. L’article chinois fourni présente un tarif en CNY de 1 CNY pour les entrées, 4 CNY pour les sorties et 0,10 CNY pour les lectures du cache.
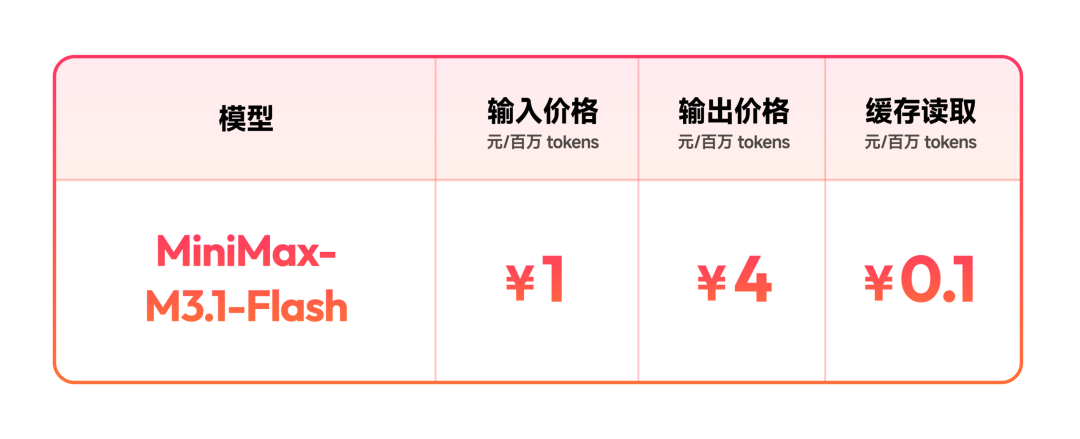
Les deux grilles tarifaires exprimées dans des devises différentes ne doivent pas être considérées comme des équivalents exacts au taux de change actuel. Utilisez le tarif de la plateforme de facturation et du compte concernés.
La source compare la grille tarifaire de MiniMax en CNY aux tarifs de pointe et aux tarifs hors pointe publiés pour DeepSeek. Ses exemples portant sur un milliard de tokens d’entrée peuvent être vérifiés selon les hypothèses indiquées :
| Taux de succès du cache | Coût des entrées MiniMax | Coût des entrées DeepSeek au tarif de pointe dans la source | Montant inférieur dans cet exemple |
|---|---|---|---|
| 90 % | 190 CNY. | 236 CNY. | MiniMax de 46 CNY. |
| 95 % | 145 CNY. | 138 CNY. | DeepSeek de 7 CNY. |
| 99 % | 109 CNY. | 59,60 CNY. | DeepSeek de 49,40 CNY. |
Pour MiniMax avec 90 % de succès du cache, un milliard de tokens d’entrée représente 1 000 unités d’un million de tokens : 100 × 1 + 900 × 0,10 = 190. Les tokens de sortie sont exclus de ces exemples limités aux entrées, tout comme les éventuels frais non représentés par les tarifs cités.
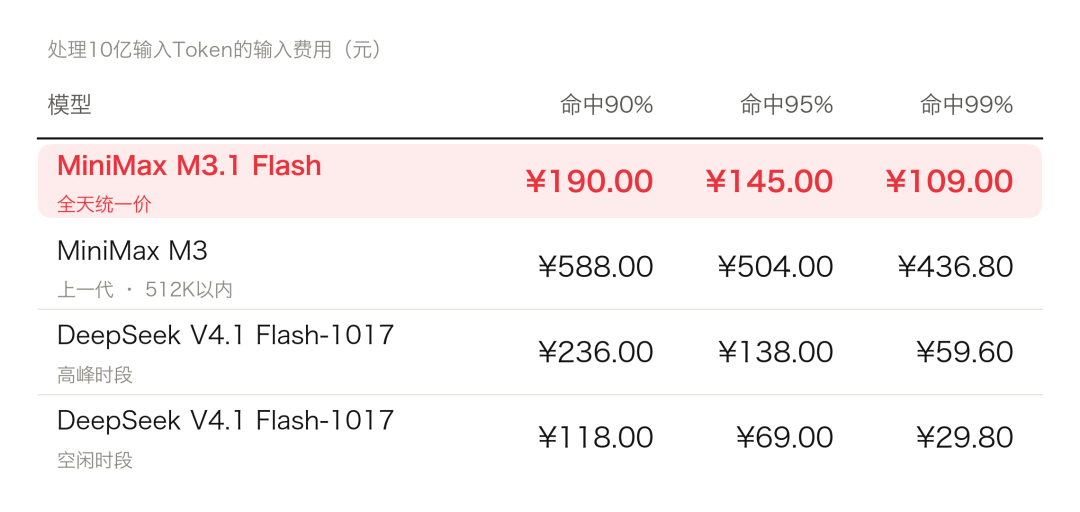
Cela montre également pourquoi un prix inférieur pour les entrées non mises en cache ne garantit pas la facture la moins élevée lorsque le cache domine les coûts. L’extrapolation de l’article, qui passe d’une moyenne de benchmark à 1 000 tâches métier, constitue une illustration budgétaire et non un devis pour l’exécution de ces tâches en production.
MiniMax affirme séparément une réduction de 70 % du coût global d’utilisation pour les tâches d’agent par rapport à son prédécesseur. Cette affirmation concernant la charge de travail diffère d’une simple réduction du prix par token.
Vitesse d’inférence, Space Bunny et paramètres de l’API
Creez un site vitrine et genere des leads en quelques minutes
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
L’entreprise identifie Space Bunny, testé de manière anonyme, comme une version préliminaire de M3.1 Flash et indique qu’il a traité plus de 200 000 milliards de tokens. Elle rapporte une vitesse de sortie pouvant atteindre plus de 200 tokens par seconde, avec des vitesses médianes supérieures à 170 tokens par seconde, ainsi qu’une inférence en ligne presque trois fois plus rapide.
Il s’agit de mesures réalisées par l’entreprise. Le nombre de tokens par seconde mesure le débit de sortie, tandis que le temps nécessaire pour terminer une tâche d’agent comprend également le raisonnement, les appels d’outils, les temps d’attente, les nouvelles tentatives et les tests.
Le guide d’invocation des modèles de MiniMax confirme une fenêtre de contexte d’un million de tokens ainsi que la prise en charge des entrées texte, image et vidéo. La prise en charge de ces entrées ne signifie pas que le modèle génère des images ou des vidéos.
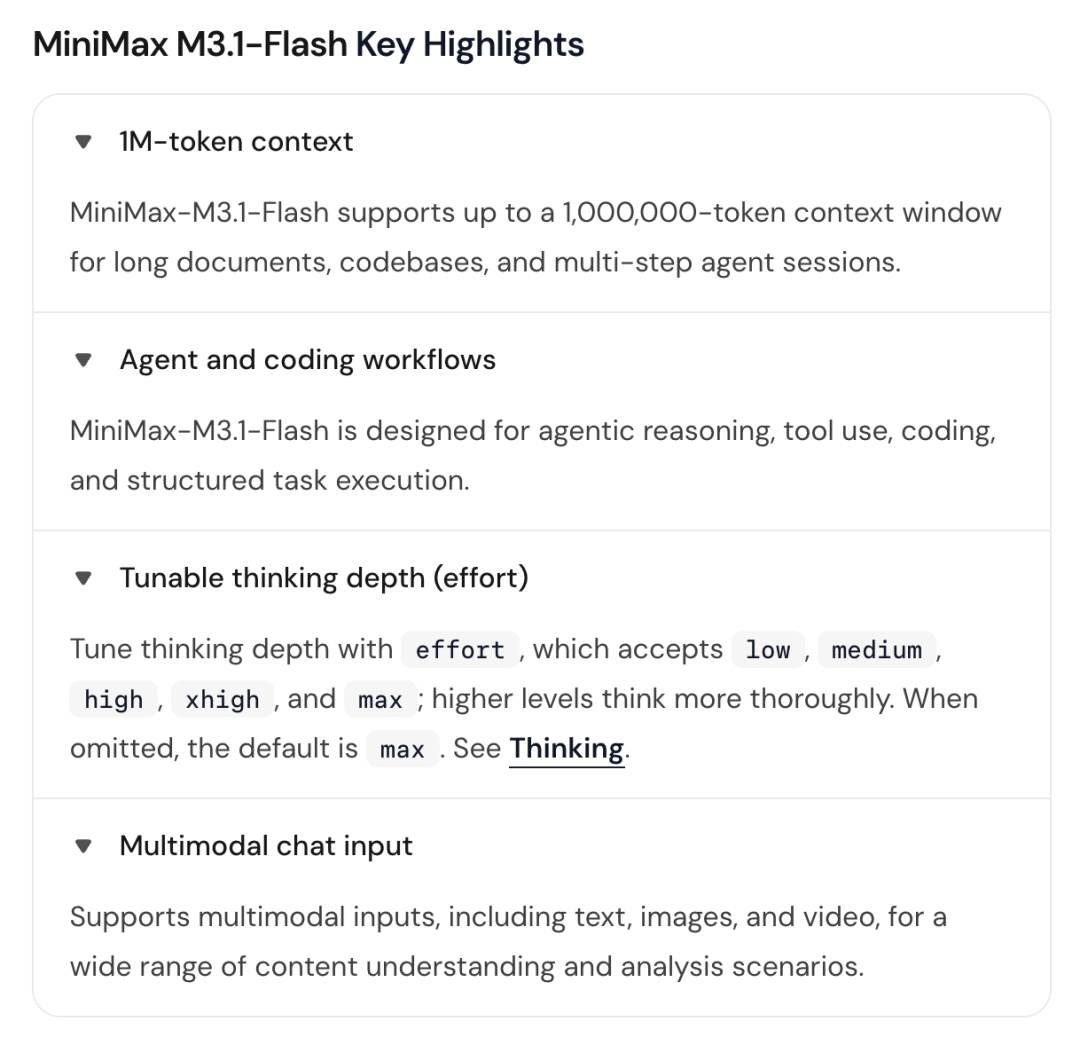
Le guide confirme cinq niveaux de réflexion : low, medium, high, xhigh et max. Si le paramètre est omis, la valeur par défaut est max ; la réflexion ne peut pas être désactivée. Le champ de requête dépend du protocole :
| Protocole | Champ de profondeur de réflexion |
|---|---|
| Compatible Anthropic | output_config.effort. |
| Chat Completions compatible OpenAI | reasoning_effort. |
| OpenAI Responses | reasoning.effort. |
Ces noms de champs ne doivent pas être regroupés dans un unique paramètre de premier niveau effort. Le guide officiel indique que les niveaux supérieurs génèrent généralement davantage de tokens de réflexion et augmentent la latence ; réduire l’effort diminue ce travail, sans le désactiver.
L’accès au lancement comprend l’API MiniMax, M Plan et MiniMax Code. L’annonce indique que les poids du modèle seront publiés ultérieurement ; cet article ne laisse donc pas entendre qu’une version auto-hébergeable ou sa licence définitive était déjà disponible au lancement.
Les exemples de ville pliable et de pagode de la source
Xinzhiyuan décrit la connexion du modèle à Codex et la demande de création d’une ville pliable interactive. Son récit comprend un curseur de pliage, un éclairage nocturne et une vue pouvant être pivotée pour inspecter la scène.
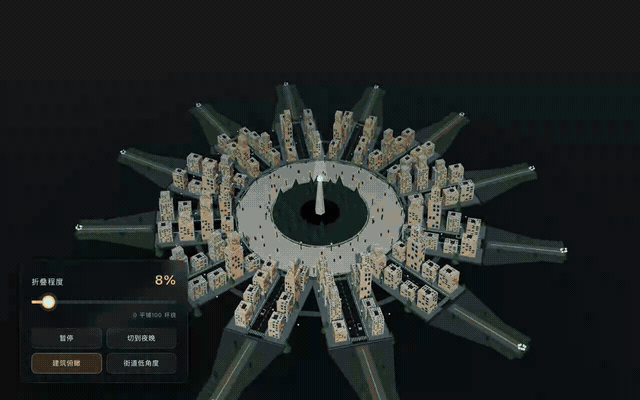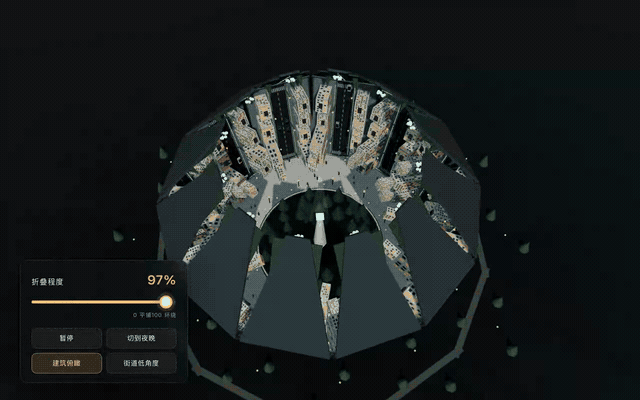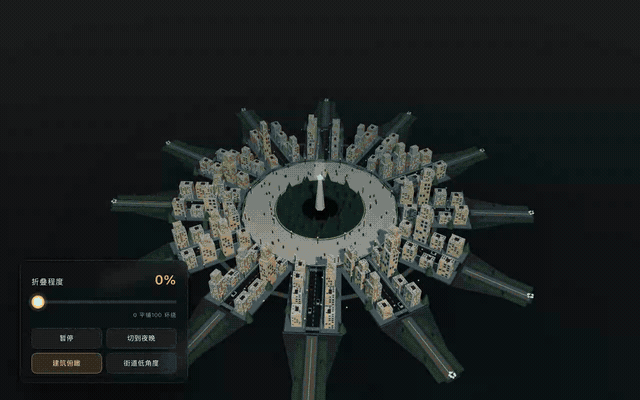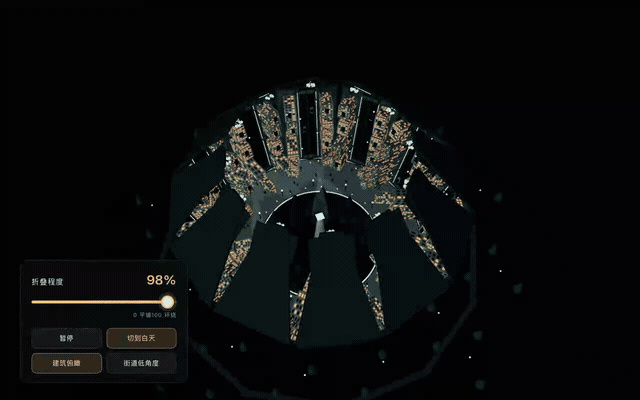
Il s’agit de la démonstration de l’éditeur, et non d’un nouveau test réalisé pour ce document. L’image illustre une sortie donnée, sans établir le nombre d’images par seconde, la qualité du code ou le comportement dans différents navigateurs.
L’article reproduit également l’exemple de pagode du développeur AJ, qui aurait été généré en un seul appel d’API avec une réflexion maximale et environ 50 000 tokens. L’affirmation selon laquelle l’impact visuel serait plus marqué relève du jugement de ce développeur et non d’une comparaison standardisée avec DeepSeek.
Adapter un modèle Flash au travail à accomplir
La comparaison de la source suggère des points forts différents : la position de DeepSeek dans le graphique de programmation logicielle représenté et les solides résultats de MiniMax dans les workflows d’entreprise. Ces différences justifient de tester les deux modèles sur des tâches représentatives plutôt que de s’appuyer sur un unique classement mis en avant.
Suivez le taux de réussite après revue, le temps écoulé, les nouvelles tentatives et les dépenses totales. Un tarif inférieur par token est surtout pertinent lorsque le modèle peut accomplir la tâche requise sans ajouter suffisamment de retouches pour annuler l’économie réalisée.
MiniMax indique également qu’une variante Pro arrivera ultérieurement. Ce futur produit doit rester distinct du comportement documenté de M3.1 Flash au lancement.
FAQ
MiniMax M3.1 Flash est-il globalement le deuxième meilleur modèle ?
Le classement de la source se rapporte à une comparaison particulière entre score et coût en programmation. D’autres évaluations de l’article présentent des classements et des égalités différents.
Quels sont les tarifs officiels des tokens en dollars américains ?
L’annonce de MiniMax indique 0,15 $ pour les entrées, 0,60 $ pour les sorties et 0,015 $ pour les entrées mises en cache par million de tokens. Vérifiez la plateforme de facturation applicable avant d’établir un budget à partir d’une grille tarifaire exprimée dans une autre devise.
Le montant de 739 CNY pour ALE signifie-t-il que toutes les tâches ont été réussies ?
Non : il s’agit du coût estimé d’une exécution complète pour 152 tâches tentées. Le taux de réussite rapporté est de 29,6 %, et le montant exclut les coûts qui ne figurent pas dans les hypothèses du graphique.
Quels formats d’entrée et quelle longueur de contexte le guide prend-il en charge ?
Le guide officiel indique la prise en charge des entrées texte, image et vidéo, ainsi que d’un contexte pouvant atteindre un million de tokens. La compréhension des entrées n’implique pas la génération d’images ou de vidéos.
Que se passe-t-il si le paramètre de réflexion est omis ?
La documentation indique que la valeur par défaut est max. Utilisez le champ spécifique au protocole concerné pour sélectionner un niveau inférieur ; la réflexion ne peut pas être désactivée.
Les poids du modèle étaient-ils déjà disponibles au lancement ?
L’annonce de lancement indique qu’ils seront publiés ultérieurement. L’accès à l’API hébergée et la promesse d’une publication des poids sont deux affirmations distinctes concernant la disponibilité.
Outils associés
- Plateforme API MiniMax : accès hébergé aux modèles MiniMax et aux services pour développeurs.
- MiniMax Code : application de programmation de bureau proposée dans l’annonce de lancement.
- M Plan : formule d’abonnement mentionnée pour l’accès à MiniMax.
- Dépôt DeepSeek Flash-1017 : dépôt publié du modèle utilisé pour la comparaison.
Liens associés
- Article fourni sur BAAI Hub : source des comparaisons en CNY et des exemples illustrés.
- Annonce de M3.1 Flash par MiniMax : tarification officielle du lancement, modes d’accès et affirmations de l’entreprise concernant les benchmarks.
- Guide d’invocation des modèles MiniMax : contexte vérifié, formats d’entrée et contrôles de réflexion spécifiques aux protocoles.
- Plateforme API MiniMax : point d’entrée officiel pour les développeurs.
- Téléchargement de MiniMax Code : produit de bureau associé dans l’annonce officielle.
- DeepSeek V4.1 Flash-1017 : dépôt du modèle concerné par la comparaison.
Résumé
M3.1 Flash associe une tarification des tokens peu élevée à des résultats compétitifs, rapportés par l’entreprise, en programmation, en automatisation et en utilisation d’ordinateurs. Sa valeur dépend des paramètres d’effort, du comportement du cache et de sa capacité à terminer le workflow réel avec un niveau de retouche acceptable.
Utilisez les graphiques de benchmark pour choisir les tests à effectuer, puis laissez les résultats obtenus, le temps écoulé et la facture complète déterminer le modèle.


