For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/muse-wonder-benchmarks-coding-results-lim-2cf7d1eb.md.
Le lancement de Muse Wonder par Meta a produit deux types de preuves très différents : de solides résultats aux benchmarks et des démonstrat...
Le lancement de Muse Wonder par Meta a produit deux types de preuves très différents : de solides résultats aux benchmarks et des démonstrations de développeurs parfois bien moins convaincantes. Un rapport chinois de Xinzhiyuan, republié sur BAAI Hub, transforme cet écart en une critique virulente de l’optimisation centrée sur les benchmarks.
Ce désaccord mérite un examen attentif, mais une démonstration médiocre ne permet pas d’établir une tricherie. Une lecture équitable exige de connaître la variante exacte du modèle, la tâche testée, le logiciel agent utilisé autour du modèle et la source de chaque résultat.
La source décrit des développeurs comparant des résultats de jeux dans le navigateur ou en 3D et jugeant Wonder décevant face à des modèles concurrents. Ces démonstrations sont faciles à examiner : les spectateurs peuvent voir si les mouvements fonctionnent, si la caméra se comporte de façon cohérente et si la scène ressemble au résultat demandé.
La source cite également Alexandr Wang de Meta, qui aurait déclaré que l’équipe n’avait pas entraîné explicitement le modèle pour les démonstrations de jeux 3D et qui aurait encouragé les développeurs à essayer un véritable travail de programmation. Cette réponse est rapportée par Xinzhiyuan ; elle ne doit pas devenir une explication générale de chaque tâche de codage échouée.
Les démonstrations de jeux restent des éléments de preuve pertinents. Elles testent une combinaison réelle de génération de code, de jugement visuel, d’interaction et de débogage. Leur limite concerne leur portée : une invite et une seule exécution ne permettent pas d’établir les performances pour la maintenance de dépôts, le travail en terminal ou de longs projets logiciels.
L’annonce principale de Meta présente Muse Wonder et Muse Wonder Full comme des modèles destinés aux agents personnels et professionnels. Wonder est proposé via la Meta Model API et Muse Code ; Full est proposé aux abonnés de Muse Code.
L’annonce définit Active Memory comme la capacité de conserver un contexte important entre les conversations et de le récupérer lorsqu’il est pertinent. Active Focus décrit la progression soutenue vers un objectif, notamment l’essai d’alternatives, l’adaptation à de nouvelles informations, la demande de clarification et la vérification avant des actions importantes.
Ces descriptions aident à comprendre ce que Meta cherche à améliorer. Il s’agit d’affirmations sur le produit et l’évaluation, et non de garanties qu’un agent accomplira chaque tâche qui lui est confiée.
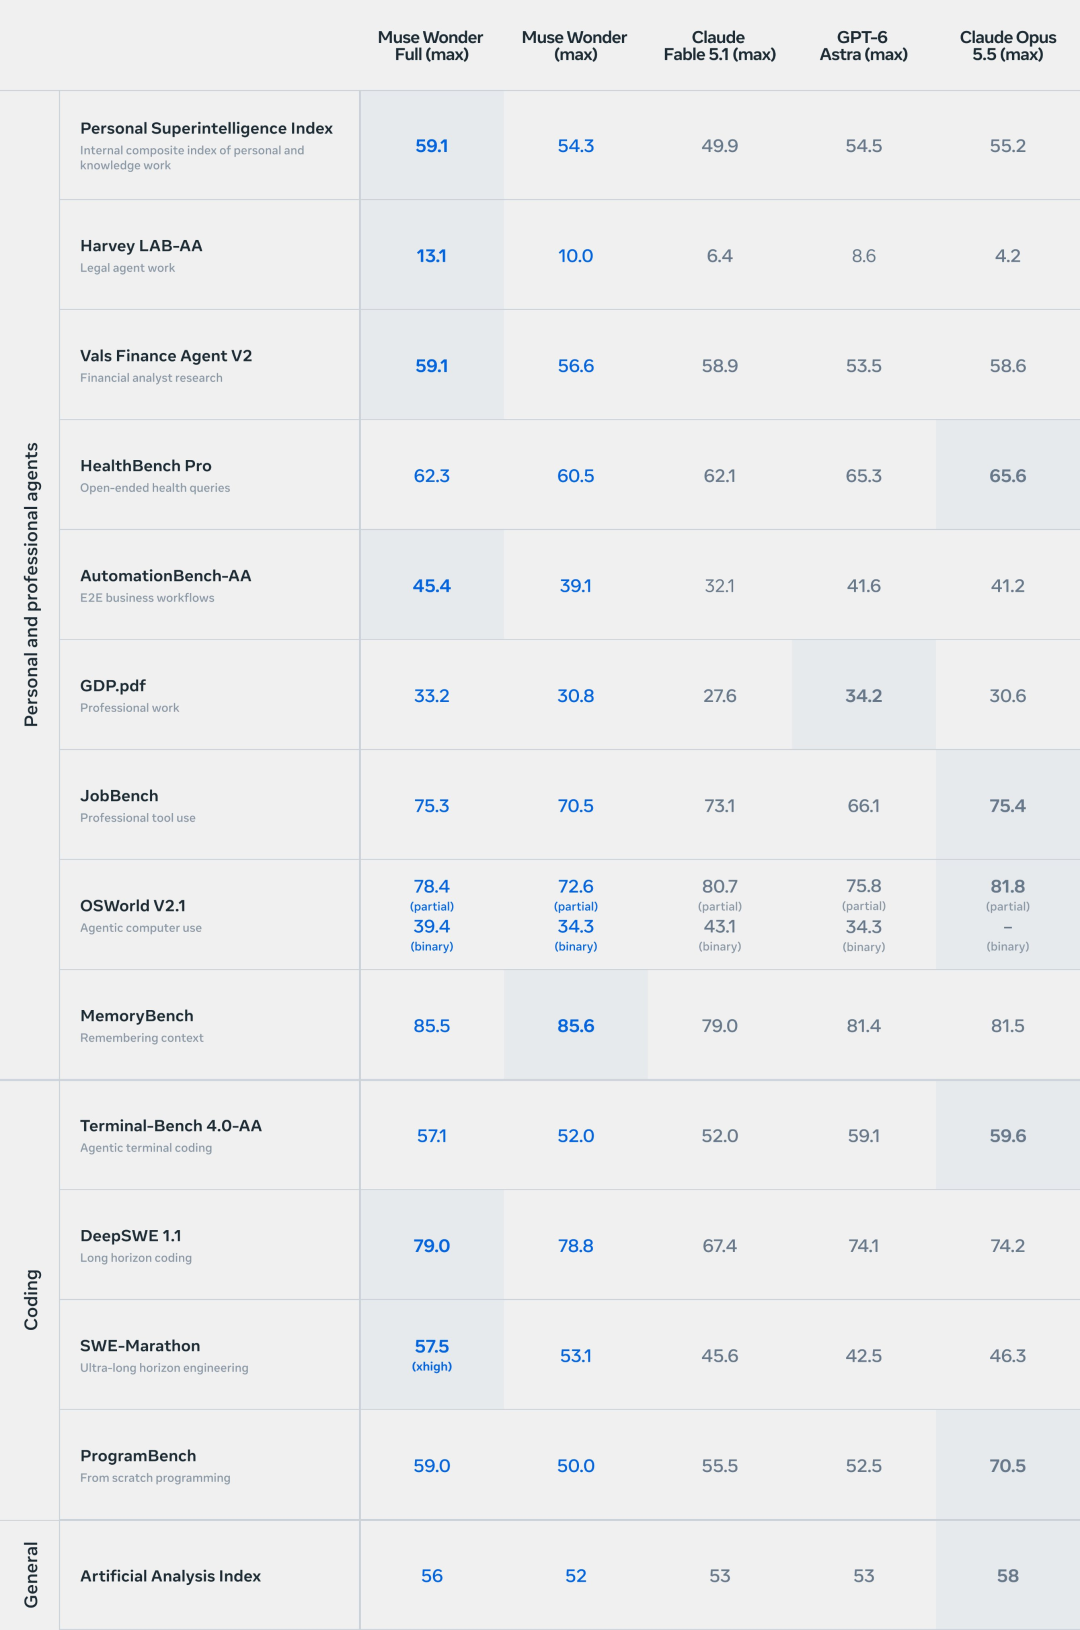
Tableau comparatif publié par Meta, reproduit par Xinzhiyuan sur BAAI Hub. Les valeurs correspondent aux configurations et aux conditions d’évaluation présentées dans les documents de lancement.
Le tableau ne désigne pas un vainqueur universel. Ses résultats de codage varient sensiblement selon la tâche :
| Évaluation | Muse Wonder Full | Claude Opus 5.5 | Sens de la comparaison |
|---|---|---|---|
| DeepSWE 1.1 | 79.0 | 74.2 | Full obtient un score supérieur |
| SWE-Marathon | 57.5 | 46.3 | Full obtient un score supérieur dans la configuration rapportée |
| Terminal-Bench 4.0-AA | 57.1 | 59.6 | Opus obtient un score supérieur |
| ProgramBench | 59.0 | 70.5 | Opus obtient un score supérieur |
Les documents complémentaires de Meta signalent aussi des points forts en matière de mémoire et de flux de travail agentiques, ainsi que des domaines dans lesquels d’autres modèles sont en tête. L’existence d’un bon résultat sur un travail logiciel de longue durée n’implique pas les meilleures performances pour générer une application à partir de zéro.
Les conditions d’évaluation sont particulièrement importantes pour SWE-Marathon. La fiche modèle de Meta décrit les concurrents comme étant exécutés via Codex et Claude Code, tandis que le résultat mis en avant pour Wonder Full utilise une configuration xhigh. Il s’agit de résultats significatifs au niveau du produit, mais pas d’une expérience unique et contrôlée employant un même environnement agentique pour tous les modèles.
Le billet de lancement de Meta traite explicitement de l’écart entre les benchmarks connus et les tâches non familières. Son analyse compare les performances en distribution et hors distribution à mesure que le calcul au moment de l’inférence augmente, en affirmant que le modèle de base plus robuste de Wonder Full améliore le transfert des gains de post-entraînement vers d’autres tâches.
C’est un élément technique pertinent en faveur de la position de Meta. Il s’agit toutefois d’une évaluation choisie et présentée par le développeur du modèle, et elle ne règle pas toutes les plaintes concernant le résultat d’un développeur.
De même, les signalements d’une démonstration de jeu décevante ne prouvent ni contamination des benchmarks ni fabrication de résultats. Établir de telles affirmations exigerait des preuves plus directes sur les données, les méthodes ou des résultats manipulés que celles fournies par l’article source.
Une couverture indépendante d’Artificial Analysis rapporte des scores Intelligence Index v4.3 de 56 pour Wonder Full et de 52 pour Wonder, avec un effort de raisonnement maximal. Un utilisateur d’API testant Wonder standard évalue donc une offre de lancement différente du modèle Full mis en avant dans plusieurs graphiques.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Artificial Analysis indique une fenêtre de contexte d’un million de tokens pour chaque variante. Pour Wonder, le site rapporte 4 $ par million de tokens d’entrée, 0,20 $ pour les entrées mises en cache et 20 $ pour les sorties. Son estimation de 4,52 $ par tâche Intelligence Index est un coût propre à cette évaluation, et non un prix fixe pour toute demande utilisateur.
La source critique également l’absence de publication publique de poids ouverts. Ni l’annonce de lancement consultée ni la description des modalités d’accès ne prévoient un téléchargement des poids de Wonder ; les développeurs ne doivent donc pas supposer que l’auto-hébergement local est disponible.
Meta indique que Wonder a été entraîné dans son centre de données Prometheus à l’échelle du gigawatt. L’article de BAAI relie le lancement à des déclarations de Mark Zuckerberg et de Wang sur l’ampleur des investissements en infrastructure IA et sur le rôle des agents personnels dans le commerce.
Ces déclarations décrivent une stratégie plus large. Elles ne doivent pas être converties en une estimation vérifiée du coût d’entraînement de ce modèle particulier. De même, un exemple d’agents négociant ou achetant des services relève d’une vision du comportement du produit, et non d’une preuve que tous ces flux de travail ont été déployés.
La prochaine étape utile consiste à mener des tests reproductibles : maintenir les exigences constantes, identifier la variante et le paramètre de raisonnement, documenter l’environnement et mesurer le travail achevé. Cette méthode peut révéler les forces comme les faiblesses de manière plus fiable qu’un seul score spectaculaire ou qu’un seul échec marquant.
Non. Ils peuvent montrer de mauvaises performances sur les tâches démontrées, mais prouver une tricherie aux benchmarks exige des éléments distincts sur les méthodes d’évaluation, les données ou des résultats manipulés.
Ce sont deux offres distinctes de la famille de modèles, avec des parcours d’accès différents au lancement. Artificial Analysis rapporte un score de 52 pour Wonder et de 56 pour Full, avec un effort de raisonnement maximal, sur son Intelligence Index v4.3.
Le tableau cité fournit des réponses différentes selon les évaluations de codage. Full est en tête sur DeepSWE 1.1 et dans la configuration SWE-Marathon rapportée, tandis qu’Opus est en tête sur Terminal-Bench 4.0-AA et ProgramBench.
Uniquement en précisant la configuration. La fiche modèle de Meta décrit les concurrents comme utilisant leurs produits de codage ; les différences de comportement des agents et d’outils peuvent donc influencer le résultat, en plus des modèles sous-jacents.
La couverture du lancement par Artificial Analysis rapporte 4 $ par million de tokens d’entrée, 0,20 $ par million de tokens d’entrée mis en cache et 20 $ par million de tokens de sortie. Vérifiez les conditions de facturation actuelles du fournisseur avant de vous engager pour un usage en production.
Aucun téléchargement public de poids n’a été établi à partir des documents de lancement consultés. Les voies d’accès documentées sont l’API et Muse Code pour Wonder, ainsi que l’accès par abonnement à Muse Code pour Full.
Les résultats de lancement de Muse Wonder montrent une famille de modèles affichant de solides scores pour les agents et l’ingénierie logicielle, des résultats inégaux selon les catégories de codage, ainsi que des voies d’accès différentes pour les variantes standard et Full.
La conclusion utile est spécifique à la tâche : vérifiez le modèle exact et testez le travail achevé avant d’accepter aussi bien une affirmation de victoire universelle qu’une accusation de tricherie.
Partez d’une phrase et obtenez un site complet en quelques minutes.