For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/muse-wonder-full-vs-gemini-4-argon-benchm-70ca5d3f.md.
Le lancement de Muse Wonder par Meta introduit deux modèles aux noms très proches dans un environnement concurrentiel. La première question ...
Le lancement de Muse Wonder par Meta introduit deux modèles aux noms très proches dans un environnement concurrentiel. La première question est donc particulièrement pratique : examinez-vous Muse Wonder ou Muse Wonder Full ?
Artificial Analysis rapporte des scores de 52 pour Wonder et de 56 pour Wonder Full dans l’Intelligence Index v4.3, tous deux avec un effort de raisonnement maximal. L’article chinois republié sur BAAI Hub se concentre sur le fait que Full dépasse le résultat rapporté de 53 points de Gemini 4 Argon. Il s’agit d’une comparaison de benchmarks entre des configurations de modèles particulières, et non d’une preuve que l’une ou l’autre variante de Wonder gagne toutes les tâches réelles.
La communication officielle de Meta indique que Muse Wonder est disponible via la Meta Model API et Muse Code. Muse Wonder Full est disponible pour les abonnés à Muse Code. L’entreprise précise que Wonder alimentera ultérieurement des expériences dans son assistant Muse, en commençant par les abonnés.
| Modèle | Intelligence Index v4.3, effort maximal | Accès au lancement décrit par Meta |
|---|---|---|
| Muse Wonder | 52 | Meta Model API et Muse Code |
| Muse Wonder Full | 56 | Abonnement à Muse Code |
Ces distinctions comptent lorsqu’on cherche à reproduire un résultat publié. Accéder à Wonder via l’API n’est pas la même chose qu’évaluer Full via le produit de programmation.
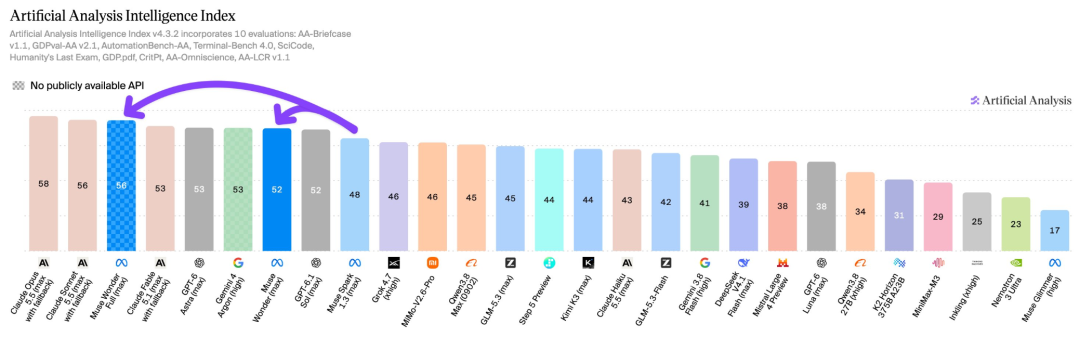
Graphique : Artificial Analysis, reproduit et annoté dans le rapport de QbitAI sur BAAI Hub. Il reflète la comparaison de la source au moment de sa publication.
Artificial Analysis rapporte également des fenêtres de contexte d’un million de tokens pour les deux variantes. Son analyse de lancement liste des prix d’API Wonder de 4 $ par million de tokens d’entrée, 0,20 $ par million de tokens d’entrée mis en cache et 20 $ par million de tokens de sortie. Full n’est pas tarifé au token dans cette analyse, car son accès au lancement s’effectue via un produit sur abonnement.
L’article de BAAI souligne l’accès plus restreint de Gemini 4 Argon au moment du reportage. La disponibilité peut évoluer rapidement ; ce contraste historique ne doit donc pas être interprété comme une promesse concernant les règles d’accès actuelles de l’un ou l’autre fournisseur.
Meta présente Wonder comme une famille de modèles destinée aux agents personnels et professionnels. Son annonce attribue des noms distincts à deux capacités récurrentes.
La mémoire active concerne la conservation d’informations importantes entre les conversations et la récupération des détails utiles pour une nouvelle tâche. Pour un assistant personnel, cela peut signifier utiliser une préférence déjà établie sans demander à l’utilisateur de la répéter à chaque fois.
La concentration active concerne la poursuite d’un objectif lorsque la première tentative échoue. Meta décrit le recours à des approches alternatives, l’adaptation aux nouvelles informations, la demande de précisions lorsque nécessaire et la vérification avant les actions importantes.
La programmation requiert ces deux types de comportement. Un agent peut devoir préserver une contrainte initiale tout au long de plusieurs cycles de modifications, d’échecs de tests et de révisions. Meta indique que les modèles Wonder ont été entraînés sur diverses tâches exigeant un travail prolongé, en s’appuyant sur l’approche de mise à l’échelle utilisée pour Muse Spark.
La source oppose de solides benchmarks d’ingénierie logicielle à des réactions mitigées face à des démonstrations de jeux 3D. Il s’agit de charges de travail différentes, même lorsque les deux nécessitent que le modèle écrive du code.
DeepSWE 1.1 teste le travail sur des logiciels existants, tandis que ProgramBench concerne la création de programmes à partir de zéro. Le tableau comparatif du matériel de lancement de Meta rapporte 59,0 pour Wonder Full et 70,5 pour Claude Opus 5.5 sur ProgramBench. Un modèle peut donc dominer un type de tâche d’ingénierie tout en étant moins performant sur un autre.
Le rapport original décrit également des développeurs ayant préféré Opus pour une démonstration Unity, ainsi qu’un autre développeur ayant signalé une exécution réussie avec Wonder Full. Ce sont des observations individuelles reposant sur des prompts, des environnements et des critères de réussite différents. Leur divergence est une raison d’examiner la configuration de la tâche plutôt que de transformer la moyenne de ces anecdotes en classement universel.
Une autre précision importe pour les tests logiciels de longue durée : la fiche modèle de Meta indique que sa comparaison SWE-Marathon utilise les agents de programmation des fournisseurs concurrents, y compris Codex et Claude Code. Le résultat est donc pertinent pour une comparaison de produits de bout en bout, mais il ne s’agit pas d’une comparaison contrôlée dans laquelle chaque modèle utilise le même environnement d’agent.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Cela donne au benchmark mis en avant un équivalent pratique. Un modèle qui produit une démonstration de jeu moins impressionnante peut néanmoins être utile pour une tâche de maintenance, et un score d’indice élevé n’excuse pas une sortie défaillante.
Il s’agit de la variante complète de la famille de modèles Muse Wonder de Meta. L’annonce de lancement de Meta la rend disponible pour les abonnés à Muse Code, tandis que la variante Wonder standard dispose également d’un accès par API.
La comparaison de l’Intelligence Index au moment du lancement dans la source place Wonder Full à 56 et Gemini 4 Argon à 53. Cela décrit l’indice particulier et les configurations présentées, et non un résultat couvrant toutes les tâches ou évaluations.
L’annonce de Meta distingue les deux voies d’accès. Elle liste Wonder pour l’API et Muse Code, et Full pour les abonnés à Muse Code.
La couverture du lancement par Artificial Analysis indique 4 $ par million de tokens d’entrée, 0,20 $ pour les entrées mises en cache et 20 $ pour la sortie. Il s’agit des prix rapportés au moment de la publication ; vérifiez donc les conditions de facturation du fournisseur avant le déploiement.
La mémoire active concerne la récupération d’informations utiles provenant de conversations antérieures. La concentration active concerne l’exécution soutenue, y compris l’essai d’une autre approche lorsqu’une tâche rencontre un obstacle.
Elles révèlent une faiblesse sur ces tâches et réglages particuliers. Les performances globales en programmation incluent aussi la maintenance de dépôts, le débogage, l’utilisation d’outils et le respect des exigences dans des flux de travail plus longs.
Les solides scores de lancement de Wonder Full en font une option pertinente pour les travaux d’agents exigeants. Le modèle Wonder standard a un score et une voie d’accès différents ; le nom de la variante doit donc accompagner toute affirmation sur les performances.
Utilisez les classements de benchmarks pour sélectionner un candidat à l’essai, puis comparez le modèle exact sur le travail que vous avez besoin qu’il termine.
Partez d’une phrase et obtenez un site complet en quelques minutes.



