
Une nouvelle vague de sorties de modèles pourrait se préparer, selon un article de QbitAI publié le 21 octobre. Celui-ci évoque un modèle Claude non publié, un modèle de Google appelé Carbon et un identifiant GPT-6.1 Terra qui aurait été trouvé dans une configuration d’évaluation de Microsoft.
Il s’agit de types de preuves différents. Les impressions de testeurs privés, un nom présent dans du code et des résultats d’évaluation publiés ne doivent pas être considérés comme des preuves interchangeables du lancement d’un produit. L’évolution la plus clairement confirmée dans cette sélection concerne les travaux publiés séparément par OpenAI sur des langages de programmation moins couramment pris en charge.
Un modèle Claude non publié aurait dépassé le simple traitement des bugs individuels
QbitAI attribue ses informations sur Claude à The Information. Dans ce récit, un utilisateur précoce décrit un meilleur raisonnement et une capacité accrue à déduire l’objectif sous-jacent à une demande.
L’exemple de programmation concerne le diagnostic de la cause racine : au lieu de traiter uniquement un bug signalé, le modèle reconnaîtrait une source plus large de défaillances similaires et demanderait si l’utilisateur souhaite que cette catégorie de problèmes soit également corrigée. Le fait de demander confirmation avant d’élargir une modification constitue un élément important de cet exemple, notamment dans un dépôt où une correction plus large pourrait affecter un comportement sans rapport.
Le récit décrit également des réponses moins conventionnelles à des questions ouvertes. L’exemple de sélection d’actions est une anecdote sur la génération d’une nouvelle approche, et non une preuve de performance d’investissement. Aucun rendement validé, indice financier de référence ou algorithme de trading déployable n’est fourni.
L’identité du modèle reste indéterminée dans la source. Des noms tels que Fable et Opus sont présentés comme des possibilités, et non comme une identité de lancement confirmée. Il n’existe pas non plus de benchmark reproductible établissant l’ampleur de l’amélioration revendiquée.
Gemini Carbon et les limites des retours internes
La partie suivante concerne le modèle Carbon interne attribué à Google. Le récit fourni indique qu’il améliorerait les performances d’Argon en programmation tout en restant performant dans des tâches visuelles telles que l’analyse de vidéos ou l’examen du comportement d’interfaces front-end.
Il rapporte également que des employés ont essayé Carbon via une plateforme interne de programmation appelée Jetski et ont jugé l’expérience favorablement par rapport à Opus 5.5. Il s’agit d’impressions informelles issues d’un environnement interne. Les différences de prompts, d’accès aux outils et de conditions de test empêchent d’en déduire un classement général des modèles.
QbitAI décrit Argon, Barium et Carbon comme des noms de développement internes et affirme qu’une version Barium-B serait finalement devenue le modèle public nommé Argon. Cet historique des noms est rapporté ici comme faisant partie du récit de la source ; un libellé interne ne permet pas à lui seul d’établir la lignée exacte d’entraînement d’un modèle public.
L’article évoque ensuite une publication sur les réseaux sociaux mentionnant l’auto-amélioration récursive, ou RSI. Il interprète le moment de cette publication comme un indice possible concernant Carbon. Une remarque publiée sur les réseaux sociaux ne prouve pas que Carbon a été entraîné au moyen de la RSI, et la source ne fournit pas non plus de description technique d’un tel système. Son explication concernant l’utilisation de données d’entraînement provenant de YouTube n’est pas davantage étayée par une déclaration vérifiée sur l’entraînement dans les documents examinés pour cet article.
Le nom GPT-6.1 Terra apparaît dans une capture d’écran d’évaluation
L’article fourni montre une publication de Lumina décrivant une pull request de Microsoft qui remplacerait les paramètres d’évaluation de GPT-5.6 Terra par ceux de GPT-6.1 Terra. La capture d’écran associée affiche gpt-6.1-terra comme modèle juge par défaut.
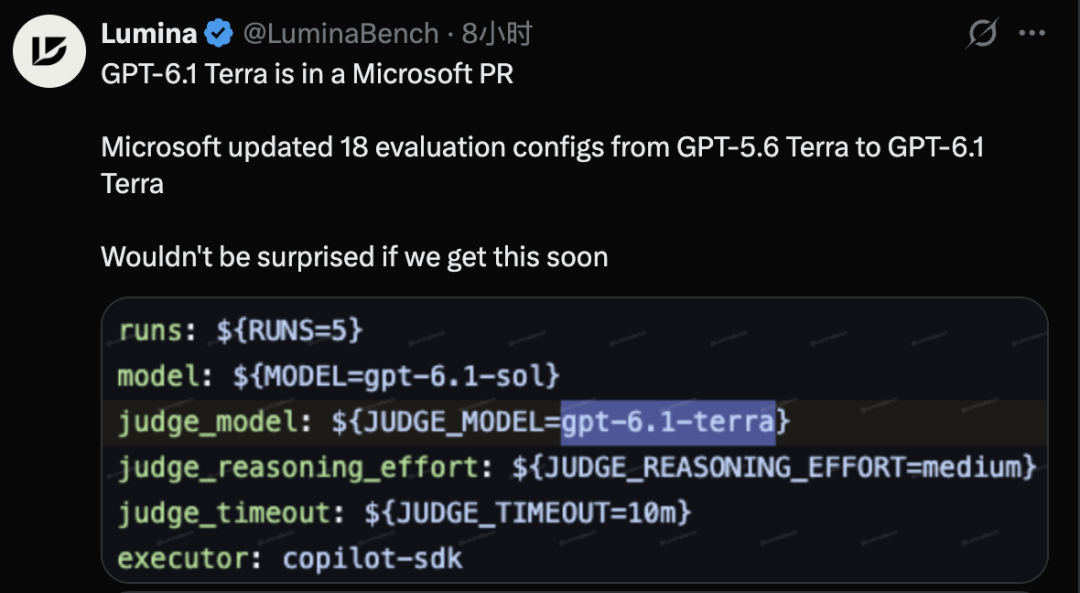
Capture d’écran source : publication de Lumina reproduite par QbitAI et BAAI Hub.
Une chaîne de configuration constitue un indice utile montrant qu’un nom est référencé. Elle ne permet pas d’établir l’existence d’un endpoint généralement accessible, d’un prix, d’une date de sortie ou d’un niveau de capacités. Le catalogue public de modèles d’OpenAI consulté pour cet article ne fournissait pas d’entrée confirmée pour une sortie GPT-6.1 Terra.
La source utilise cette découverte pour remettre en question la théorie selon laquelle GPT-6.1 Sol ne serait que Terra sous un autre nom. Ni une capture d’écran ni des spéculations sur la nomenclature ne suffisent à reconstituer l’entraînement des modèles ou les décisions produit.
Certaines réactions citées dans l’article sont sceptiques ; d’autres suggèrent qu’un modèle moins coûteux pourrait favoriser une intégration plus large de ChatGPT et des flux de travail de programmation. Cette stratégie produit reste une interprétation présentée dans ce récit, et non un plan de déploiement confirmé ou un accès garanti dans une offre gratuite.
Des progrès confirmés pour COBOL et d’autres langages à faibles ressources
L’annonce de recherche d’OpenAI du 19 octobre décrit deux évaluations : créer des logiciels compatibles avec SQLite dans 20 langages et migrer du COBOL tout en préservant le comportement du programme. Ici, l’expression « à faibles ressources » fait référence à la rareté relative du code et de la documentation disponibles pour l’entraînement, et non à l’importance d’un langage ou à ses besoins en puissance de calcul.
Creez un site vitrine et genere des leads en quelques minutes
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Dans l’évaluation de migration COBOL, GPT-6.1 Sol atteint 86,6 % avec un faible niveau d’effort de raisonnement, contre 5,4 % pour GPT-5.6 Sol avec le même réglage. OpenAI annonce 97,9 % avec un niveau d’effort de raisonnement plus élevé. Ces résultats correspondent à son évaluation et ne constituent pas des taux de réussite promis pour des migrations bancaires arbitraires.
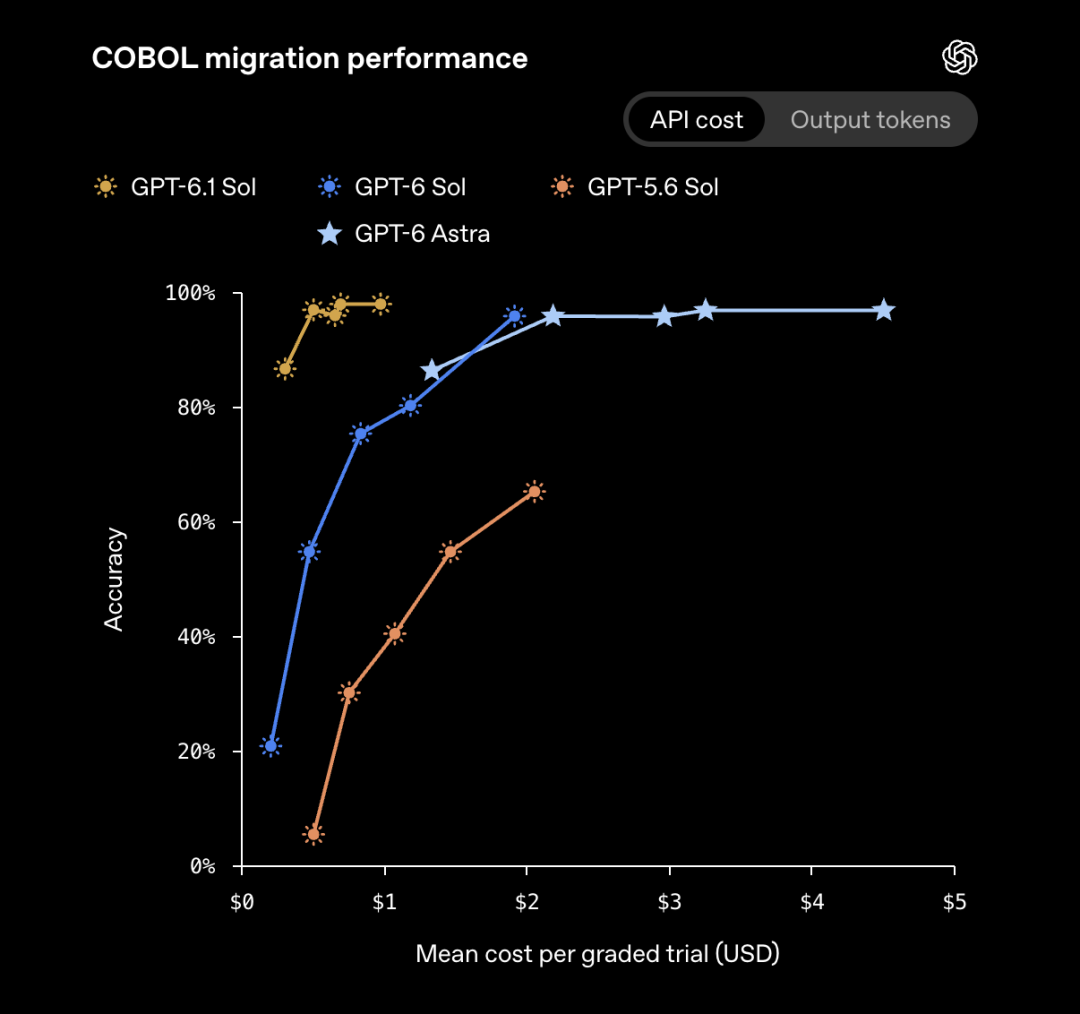
Crédit du graphique : OpenAI, reproduit dans l’article fourni.
La préservation du comportement est importante, car un programme peut être compilé tout en modifiant les arrondis, la gestion des enregistrements ou les sorties observables. Une revue par des experts et des tests représentatifs restent nécessaires lorsqu’une migration est appliquée à un système réel.
La source conclut en anticipant de prochaines sorties de modèles chinois, notamment Kimi, GLM et MiniMax, après la reprise d’activité de DeepSeek. Elle ne fournit pas de calendrier complet et confirmé des sorties ; ces attentes doivent donc rester ouvertes et ne pas être présentées comme des lancements programmés.
FAQ
Le nouveau modèle Claude a-t-il été officiellement identifié ?
L’article fourni n’établit pas son nom public définitif. Les descriptions de ses capacités proviennent d’un test privé rapporté, et non d’une fiche technique de lancement vérifiée.
Gemini Carbon est-il une sortie publique confirmée ?
La source décrit un modèle interne et des retours d’employés. Elle ne fournit pas de date de lancement public vérifiée ni d’endpoint Carbon accessible.
La publication sur la RSI prouve-t-elle que Carbon peut s’améliorer lui-même ?
Non. Aucun élément technique du récit fourni n’établit cette affirmation. L’article associe une remarque publiée sur les réseaux sociaux aux informations concernant le modèle, ce qui reste une déduction.
GPT-6.1 Terra est-il disponible via l’API d’OpenAI ?
La découverte du code ne permet pas d’établir sa disponibilité dans l’API. Le catalogue officiel consulté pour cet article ne confirmait pas la sortie publique de GPT-6.1 Terra.
Quel score GPT-6.1 Sol a-t-il obtenu lors de la migration COBOL ?
OpenAI annonce 86,6 % avec un faible niveau d’effort de raisonnement et 97,9 % avec un niveau plus élevé. Ces chiffres décrivent les conditions de son évaluation et ne constituent pas une garantie universelle de réussite pour les migrations.
Les migrations de code historique générées par l’IA peuvent-elles être déployées immédiatement ?
Une génération ou une compilation réussie ne suffit pas à établir l’équivalence du comportement. Les équipes doivent encore effectuer des tests couvrant les règles métier, les formats de données et les dépendances du système, ainsi qu’une revue par des experts.
Outils associés
- Claude : plateforme d’assistant d’Anthropic, distincte de l’identité non confirmée du modèle évoqué dans ce rapport.
- Gemini : service public d’assistant de Google, distinct des tests internes rapportés.
- Catalogue des modèles OpenAI : documentation officielle permettant de vérifier les identifiants de modèles publiés.
Liens associés
- Article QbitAI fourni sur BAAI Hub : source de la sélection de rapports sur les modèles et des captures d’écran.
- Recherche d’OpenAI sur les langages à faibles ressources : source principale des chiffres de l’évaluation COBOL.
- Catalogue publié des modèles OpenAI : référence permettant de vérifier les listes de modèles plutôt que d’inférer leur disponibilité à partir de fuites.
- Première référence publiée sur les réseaux sociaux citée par QbitAI : référence originale listée par l’article fourni ; les affirmations sous-jacentes n’ont pas été authentifiées indépendamment ici.
- Deuxième référence publiée sur les réseaux sociaux citée par QbitAI : autre référence fournie par l’article, et non une annonce officielle de sortie.
Résumé
Cette sélection pointe vers de possibles nouveaux modèles Claude et Gemini ainsi que vers un identifiant Terra présent dans du code d’évaluation. Leur nom définitif, leur disponibilité et leurs performances comparées restent incertains au vu des éléments disponibles.
Le résultat confirmé est plus limité : OpenAI a publié de meilleurs scores d’évaluation pour des langages historiques, tandis que les autres affirmations concernant les sorties de modèles nécessitent encore une confirmation officielle.


