For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/nvidia-rtx-spark-laptop-debuts-at.md.
La superpuce RTX Spark de NVIDIA est passée d'une annonce en conférence à un ordinateur portable fonctionnel pour les consommateurs. Au Bili...
Le superchip NVIDIA RTX Spark est passé d'une annonce en conférence à un ordinateur portable fonctionnel pour le grand public.
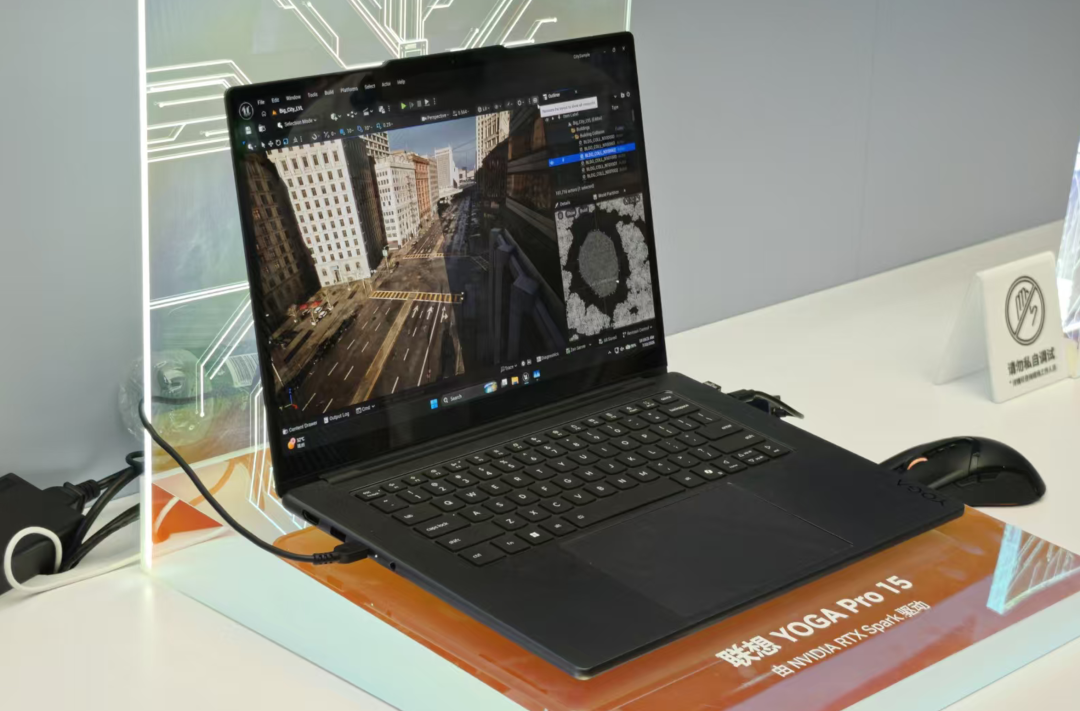
Lors du Bilibili World à Shanghai, NVIDIA a présenté publiquement un Lenovo Yoga Pro 15 équipé du RTX Spark, exécutant des charges de travail exigeantes d'IA locale, de création et de jeux. La plateforme combine un GPU Blackwell RTX et un CPU Grace à 20 cœurs via l'interconnexion NVLink-C2C de NVIDIA, avec jusqu'à 128 Go de mémoire unifiée partagée par les deux processeurs.
La conception vise une nouvelle catégorie de PC Windows : un ordinateur portable fin ou un bureau compact capable d'exécuter localement des agents IA personnels, de gérer de grands projets créatifs et d'offrir les fonctionnalités modernes des jeux RTX.
NVIDIA a également présenté DGX Spark, son superordinateur IA de bureau basé sur Linux destiné aux développeurs. Bien que les deux systèmes partagent une base similaire Grace Blackwell, leurs logiciels, leur mise en réseau, leurs utilisateurs cibles et leurs rôles de développement de modèles diffèrent.
Note terminologique : La source décrit le CPU et le GPU comme étant "soudés ensemble". Ils ne le sont pas littéralement. NVIDIA connecte les deux puces via l'interconnexion haute bande passante NVLink-C2C.
RTX Spark est construit autour de trois charges de travail qui nécessitaient généralement différents types d'ordinateurs :
Les ordinateurs portables de jeu traditionnels mettent l'accent sur les performances du GPU discret. Les machines de développement IA privilégient la capacité mémoire et les outils logiciels. Les postes de travail mobiles se concentrent sur les applications professionnelles, souvent au détriment du poids et de l'autonomie de la batterie.
RTX Spark tente de combiner les trois en utilisant un seul ensemble de processeurs étroitement intégré et un vaste pool de mémoire unifiée.
| Composant | Spécification RTX Spark |
|---|---|
| GPU | GPU Blackwell RTX |
| Cœurs CUDA | Jusqu'à 6 144 |
| CPU | Jusqu'à 20 cœurs CPU NVIDIA Grace |
| Architecture CPU | Arm |
| Interconnexion | NVIDIA NVLink-C2C |
| Performances IA | Jusqu'à 1 pétaFLOP en FP4 |
| Mémoire unifiée | Jusqu'à 128 Go |
| Systèmes cibles | Ordinateurs portables Windows fins et bureaux compacts |
| Charges de travail principales | Agents locaux, développement IA, création et jeux |
MediaTek a collaboré avec NVIDIA sur la conception personnalisée du CPU Grace, apportant son expertise en systèmes Arm en matière d'efficacité énergétique, de connectivité et d'implémentation CPU.
Dans les ordinateurs portables classiques équipés de GPU discrets, le CPU et le GPU maintiennent généralement des pools de mémoire séparés. Les données doivent se déplacer entre la RAM système et la mémoire GPU via une interconnexion telle que PCI Express.
Cette approche fonctionne bien pour les jeux et les tâches de productivité ordinaires, mais elle crée des limitations pour les très grands modèles d'IA et les ensembles de données créatifs :
Le RTX Spark, quant à lui, donne au CPU et au GPU accès à un pool partagé allant jusqu'à 128 Go de mémoire unifiée. NVLink-C2C fournit la connexion à haute bande passante entre le CPU Grace et le GPU Blackwell.
L'avantage pratique n'est pas que la copie disparaît dans chaque charge de travail — les logiciels doivent toujours gérer les données correctement. L'avantage est plutôt que les applications peuvent travailler avec un espace mémoire cohérent beaucoup plus grand sans dépendre d'un petit pool de mémoire GPU isolé.
Pour les LLM locaux, les scènes 3D, les timelines vidéo et les contextes d'agents, la capacité mémoire peut être aussi importante que la puissance de calcul brute.
NVIDIA déclare que les systèmes RTX Spark peuvent exécuter des modèles de langage volumineux avec jusqu'à 120 milliards de paramètres et prendre en charge des flux de travail d'agents avec des longueurs de contexte allant jusqu'à un million de jetons.
Cela ne signifie pas que chaque modèle 120B fonctionnera en pleine précision ou à une vitesse identique. La faisabilité réelle dépend :
Même avec ces réserves, un ordinateur portable avec 128 Go de mémoire partagée change ce qui peut être testé localement.
Les grands documents, les bases de code, les historiques de conversation et les résultats de recherche peuvent rester sur la machine plutôt que d'être divisés en multiples requêtes cloud. L'exécution locale peut également réduire la latence réseau et garder les informations sensibles sous le contrôle de l'utilisateur.
Les documents officiels du RTX Spark de NVIDIA listent plusieurs capacités locales phares :
Ce sont des revendications maximales de la plateforme.
plutôt que des garanties pour chaque configuration d'ordinateur portable ou projet logiciel.
Un agent d'IA fonctionnant localement peut lire des fichiers, ouvrir des applications, exécuter des commandes, chercher sur le web, envoyer des requêtes et modifier des données.
Ce niveau d'accès crée un problème de sécurité. Un modèle performant ne devrait pas automatiquement recevoir un contrôle illimité sur l'ordinateur de l'utilisateur.
NVIDIA et Microsoft abordent cette question via de nouvelles primitives de sécurité pour Windows et NVIDIA OpenShell.
OpenShell est conçu pour offrir :
Un utilisateur ou un administrateur peut définir quelles opérations un agent peut effectuer. Les requêtes peuvent également être routées
en fonction des exigences de confidentialité—par exemple, en conservant les informations sensibles avec un modèle local tout en envoyant des tâches anonymisées à un modèle cloud.
NVIDIA indique qu'OpenClaw et Hermes de Nous Research intégreront OpenShell et les primitives de sécurité des agents de Microsoft dans leurs applications Windows.
Cela crée un modèle hybride :
La couche de sécurité est cruciale. L'IA locale n'améliore la confidentialité que si l'exécution de l'agent, les permissions de fichiers, le comportement réseau et le routage des modèles sont également contrôlés.
La conception de mémoire unifiée de 128 Go est également destinée aux créateurs travaillant sur des projets trop volumineux pour les GPU d'ordinateurs portables ordinaires.
Au stand Bilibili World, NVIDIA a présenté un projet Unreal Engine 5 contenant un environnement 3D détaillé de Manhattan. Les fichiers du projet dépasseraient 90 Go.

La source rapporte que l'utilisateur pouvait se déplacer dans la scène de manière fluide, que l'ordinateur portable soit branché ou fonctionne sur batterie.
NVIDIA positionne officiellement RTX Spark pour les projets 3D de plus de 90 Go, bien que la réactivité réelle de l'éditeur dépende de la complexité de la scène, du streaming d'actifs, de la vitesse de stockage, du refroidissement, de l'optimisation de l'application et des paramètres d'alimentation de l'ordinateur portable.
Le moteur média Blackwell du RTX Spark prend en charge matériellement le codage et décodage 4:2:2. NVIDIA affirme que la plateforme peut gérer des flux de travail vidéo 12K en 4:2:2.
Adobe reconstruit certaines parties de Photoshop et Premiere pour exploiter la mémoire unifiée, l'accélération TensorRT, la composition GPU et le pipeline multimédia de RTX Spark.
Les avantages escomptés sont les suivants :
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Les optimisations RTX Spark d'Adobe devraient être déployées parallèlement au matériel, les performances dépendront donc en partie de la prise en charge des applications.
RTX Spark est basé sur Arm plutôt que sur l'architecture x86 utilisée par la plupart des PC de jeu Windows.
Cela soulève une question évidente de compatibilité : les jeux PC existants et les systèmes anti-triche fonctionneront-ils correctement ?
La réponse de NVIDIA combine des versions natives Arm, un travail de compatibilité Windows et le soutien des principaux éditeurs.
Les entreprises soutenant publiquement RTX Spark sont les suivantes :
À la Bilibili World, NVIDIA a présenté une version Arm-native de NARAKA: BLADEPOINT de NetEase sur un ordinateur portable NVIDIA RTX Spark.
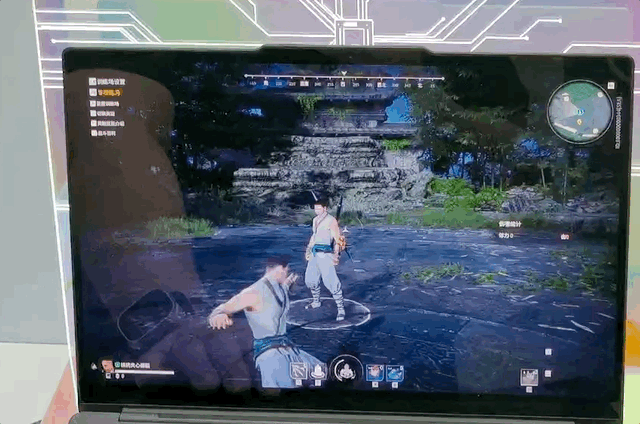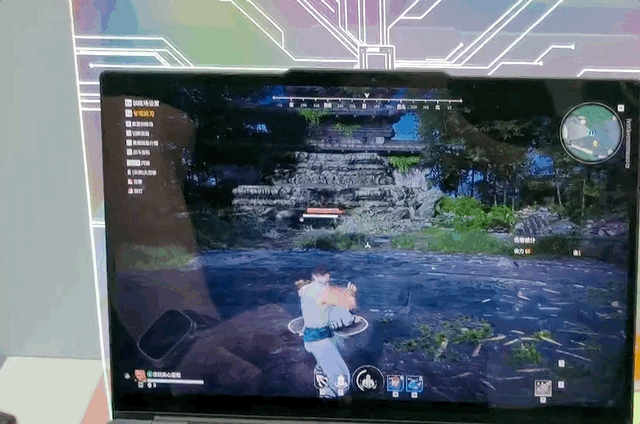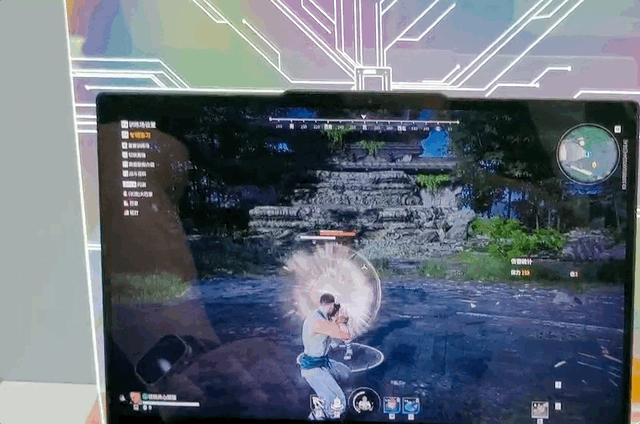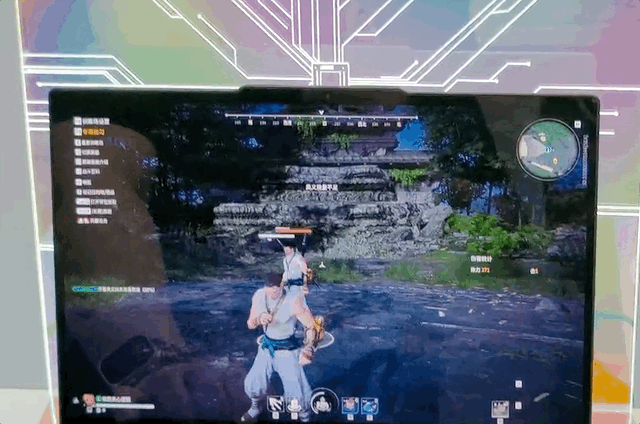
Selon les rapports, la démonstration utilisait des paramètres visuels élevés, le ray tracing, la génération multi-images DLSS et d'autres fonctionnalités RTX, tout en maintenant un gameplay fluide.
L'objectif plus large de la plateforme NVIDIA est le jeu AAA en 1440p à plus de 100 images par seconde. Les résultats varieront considérablement selon le jeu, le refroidissement de l'ordinateur portable, la limite de puissance, la résolution d'affichage, le mode DLSS, la génération d'images, et si le titre est natif ou traduit.
RTX Spark prend en charge la pile technologique RTX moderne standard :
L'expérience de jeu à long terme dépendra de la rapidité avec laquelle les développeurs publieront des versions Arm natives et de la manière dont Windows gérera les jeux x86 hérités.
RTX Spark est principalement une plateforme grand public et prosumer. DGX Spark est conçu comme un système de développement.
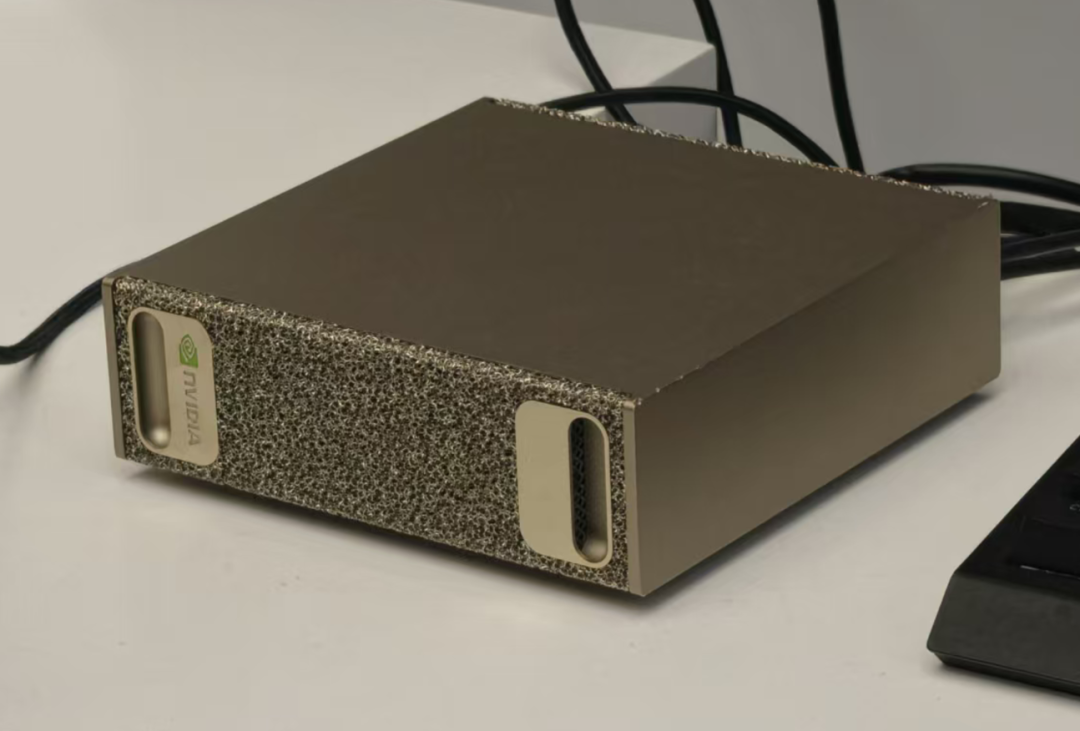
Le DGX Spark utilise le superchip NVIDIA GB10 Grace Blackwell, avec un CPU Arm à 20 cœurs, jusqu'à 1 pétaFLOP de performance IA FP4 et 128 Go de mémoire système unifiée cohérente.
Il est livré avec la pile logicielle IA de NVIDIA.
exécute DGX OS, une plateforme basée sur Linux conçue pour le développement de l'IA.
| Charge de travail | Capacité du DGX Spark |
|---|---|
| Inférence locale | Modèles jusqu'à 200 milliards de paramètres |
| Réglage fin | Modèles jusqu'à 70 milliards de paramètres |
| Inférence double système | Modèles jusqu'à 405 milliards de paramètres |
| Performance IA | Jusqu'à 1 pétaFLOP FP4 |
| Mémoire | 128 Go de mémoire système unifiée |
| Réseau | ConnectX-7, jusqu'à 200 Gbit/s |
| Plateforme d'exploitation | DGX OS / Linux |
| Public principal | Développeurs IA, chercheurs, data scientists |
Deux systèmes DGX Spark peuvent être connectés via le réseau ConnectX pour prendre en charge des modèles plus grands. Il s'agit d'une distinction importante par rapport à la plateforme RTX Spark destinée aux consommateurs.
Les développeurs peuvent prototyper, affiner, valider et exécuter des modèles localement avant de transférer les charges de travail vers NVIDIA DGX Cloud ou l'infrastructure du centre de données.
Les systèmes se chevauchent en termes d'architecture et de capacité mémoire, mais ils ne sont pas interchangeables.
| Catégorie | RTX Spark | DGX Spark |
|---|---|---|
| Formats principaux | Ordinateurs portables fins et PC compacts | Superordinateur IA de bureau compact |
| Système d'exploitation | Windows | DGX OS / Linux |
| Utilisateurs ciblés | Consommateurs, créateurs, joueurs, utilisateurs d'agents | Développeurs, chercheurs, data scientists |
| Modèle IA cible | Modèles locaux jusqu'à 120B dans le workflow phare de NVIDIA | Inférence jusqu'à 200B |
| Réglage fin | Axé sur le développement et le prototypage ; dépendant de la configuration | Prend officiellement en charge le réglage fin jusqu'à 70B |
| Jeux | Plein ciblage jeux RTX | Non positionné comme système de jeu |
| Applications créatives | Flux de travail créatifs Adobe, 3D, médias et Windows | Pile logicielle de développement IA |
| Réseau extensible | Les systèmes grand public ne sont pas centrés sur l'extensibilité ConnectX | ConnectX-7 peut lier deux systèmes |
| Sécurité des agents | Primitives de sécurité Windows et OpenShell | OpenShell, Agent Toolkit et NemoClaw |
| Portabilité | Options d'ordinateur portable et de petit bureau | Système de bureau |
La distinction la plus simple est la suivante :
DGX Spark inclut l'écosystème logiciel NVIDIA pour l'IA et est positionné comme une plateforme locale pour le développement d'agents autonomes.
Le NVIDIA Agent Toolkit aide les développeurs à connecter les systèmes d'agents aux outils, sources de données, modèles et composants d'observabilité.
OpenShell fournit l'isolation, l'application des politiques et les contrôles d'inférence. NemoClaw s'appuie sur cette base pour simplifier le déploiement plus sûr d'agents toujours actifs.
Cette division des responsabilités est utile :
NemoClaw peut être utilisé avec OpenClaw, Hermes, LangChain Deep Agents, des modèles ouverts locaux, des modèles frontière cloud, ou une inférence.
routeur.
Lors de la démonstration Bilibili World, NVIDIA a exécuté un agent personnel sur DGX Spark à l'aide d'un modèle multimodal Qwen 35B.
Le présentateur a dessiné un diagramme simplifié du « gâteau IA à cinq couches » sur du papier et l'a montré à une caméra. L'agent a interprété le croquis et produit une page web locale complète en quelques secondes.
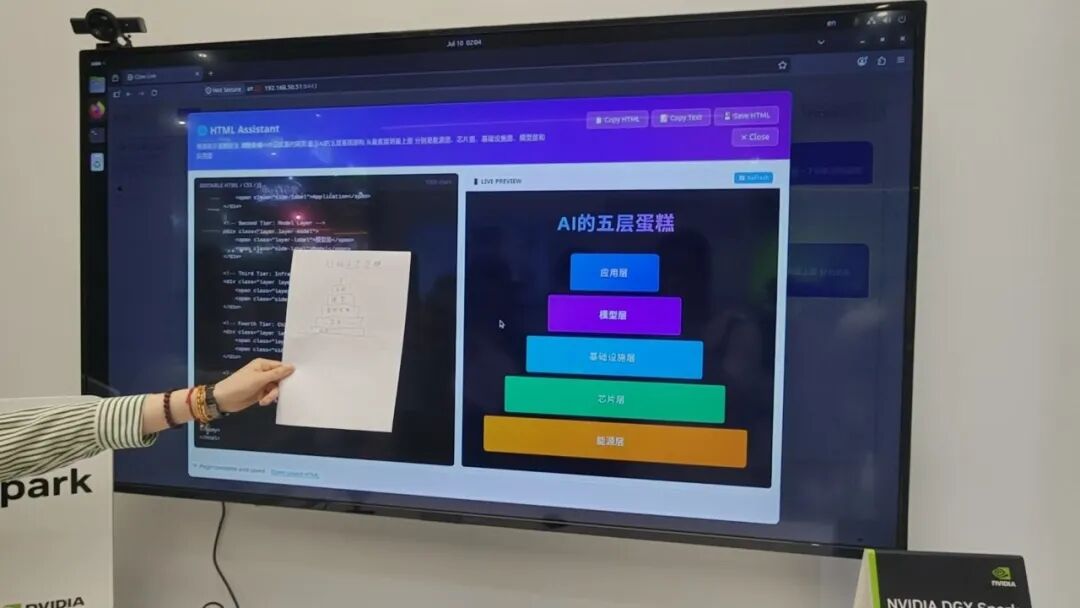
Le résultat pouvait ensuite être affiné via des instructions de suivi.
Cette démonstration combine plusieurs capacités :
Comme le modèle et l'agent étaient exécutés localement, le flux de travail ne dépendait pas de la facturation par jeton dans le cloud lors de la démonstration.
Cela ne signifie pas pour autant que l'exécution locale est gratuite. L'acquisition du matériel, l'électricité, la maintenance, le stockage et le temps d'ingénierie restent des coûts réels. Cela modifie le modèle de coût, passant d'une inférence distante facturée à l'utilisation à une capacité locale détenue en propre.
NVIDIA a adapté NemoClaw à DGX Spark et à sa gamme plus large d'IA locale.
NemoClaw est une pile de référence open source pour exécuter des agents toujours actifs dans des sandbox OpenShell. Il ajoute :
Pour les utilisateurs de DGX Spark, l'attrait principal réside dans la capacité de maintenir un agent en cours d'exécution localement pendant de longues périodes, tout en réduisant le besoin de télécharger des données sensibles vers un service cloud.
Les options d'installation officielles incluent actuellement OpenClaw, Hermes et LangChain Deep Agents.
Partez d’une phrase et obtenez un site complet en quelques minutes.



