For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/nvidia-vera-rubin-at-ocp-2026-mgx-1-2-dsx-6b3d7f12.md.
Alors que les usines d’IA passent de capacités de quelques mégawatts à des infrastructures à l’échelle du gigawatt, le défi ne se limite plu...
Alors que les usines d’IA passent de capacités de quelques mégawatts à des infrastructures à l’échelle du gigawatt, le défi ne se limite plus à installer des accélérateurs plus rapides dans un centre de données. La distribution électrique, le refroidissement liquide, la mise en réseau, la maintenabilité, le comportement vis-à-vis du réseau électrique et des conceptions de racks interopérables doivent tous évoluer de concert.
Lors du Open Compute Project Global Summit 2026 à San José, NVIDIA a annoncé un ensemble de partenariats, de spécifications ouvertes et de contributions logicielles destinés à créer une base plus commune pour l’infrastructure d’IA de nouvelle génération.
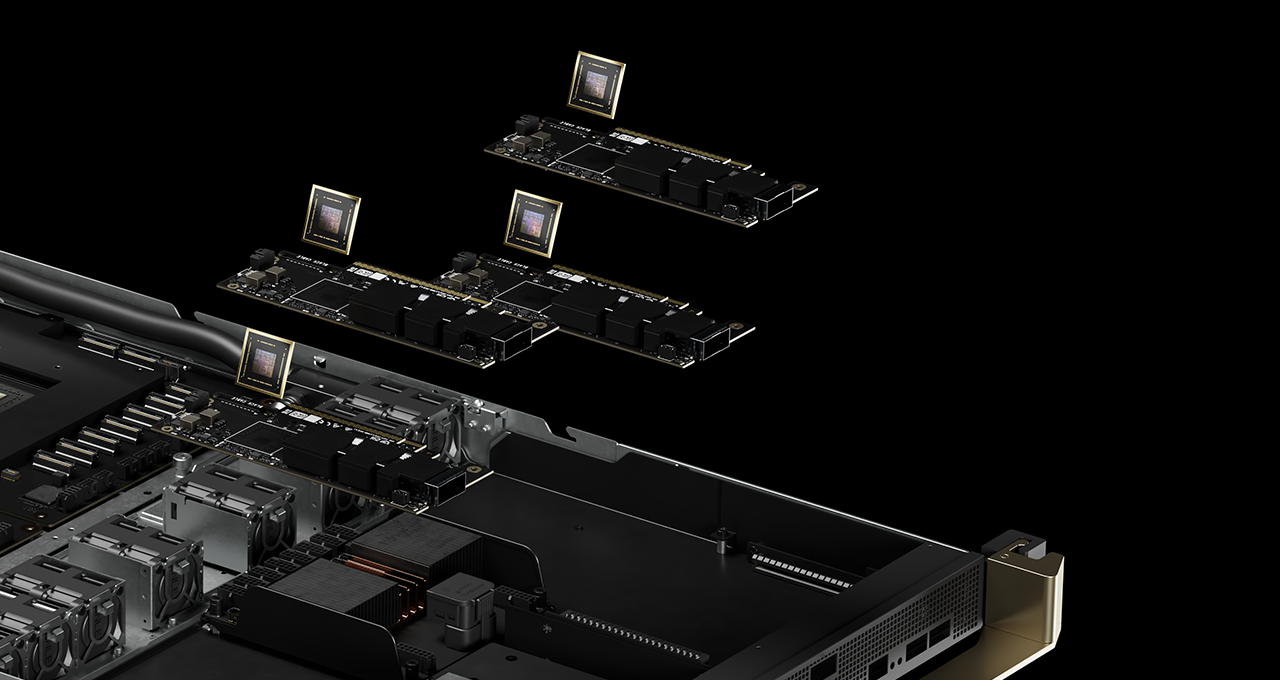
L’élément central est NVIDIA Vera Rubin. NVIDIA a contribué à l’OCP des conceptions clés de racks et de plateaux de calcul Vera Rubin via l’architecture ouverte NVIDIA MGX, afin de permettre aux constructeurs de systèmes et aux partenaires d’infrastructure de s’appuyer sur une conception de référence partagée plutôt que de développer chaque couche indépendamment.
Les annonces couvrent trois couches connectées de l’usine d’IA :
Le résultat est une impulsion plus large en faveur d’une infrastructure ouverte et reproductible, que les partenaires peuvent fabriquer, déployer et maintenir à l’échelle mondiale.
Lors de l’OCP Global Summit 2026, NVIDIA et ses partenaires de l’écosystème ont annoncé plusieurs initiatives d’infrastructure autour de Vera Rubin.
Les principales annonces comprennent :
Lors de l’événement, Ian Buck, vice-président de NVIDIA chargé de l’hyperscale et du calcul haute performance, a présenté l’infrastructure ouverte comme une composante de plus en plus importante de la montée en puissance des usines d’IA dans le monde.
Le fil conducteur de ces annonces est la co-conception. Le calcul, la mise en réseau, l’alimentation, le refroidissement et les logiciels sont considérés comme les éléments d’un seul système, et non comme des couches isolées.
NVIDIA a rejoint d’autres acteurs du secteur pour contribuer à la troisième génération de conception de référence pour centre de données d’IA MGX via l’Open DC Initiative de l’OCP.
La spécification actualisée MGX 1.2 étend l’architecture aux usines d’IA à puissance élevée et refroidies par liquide.
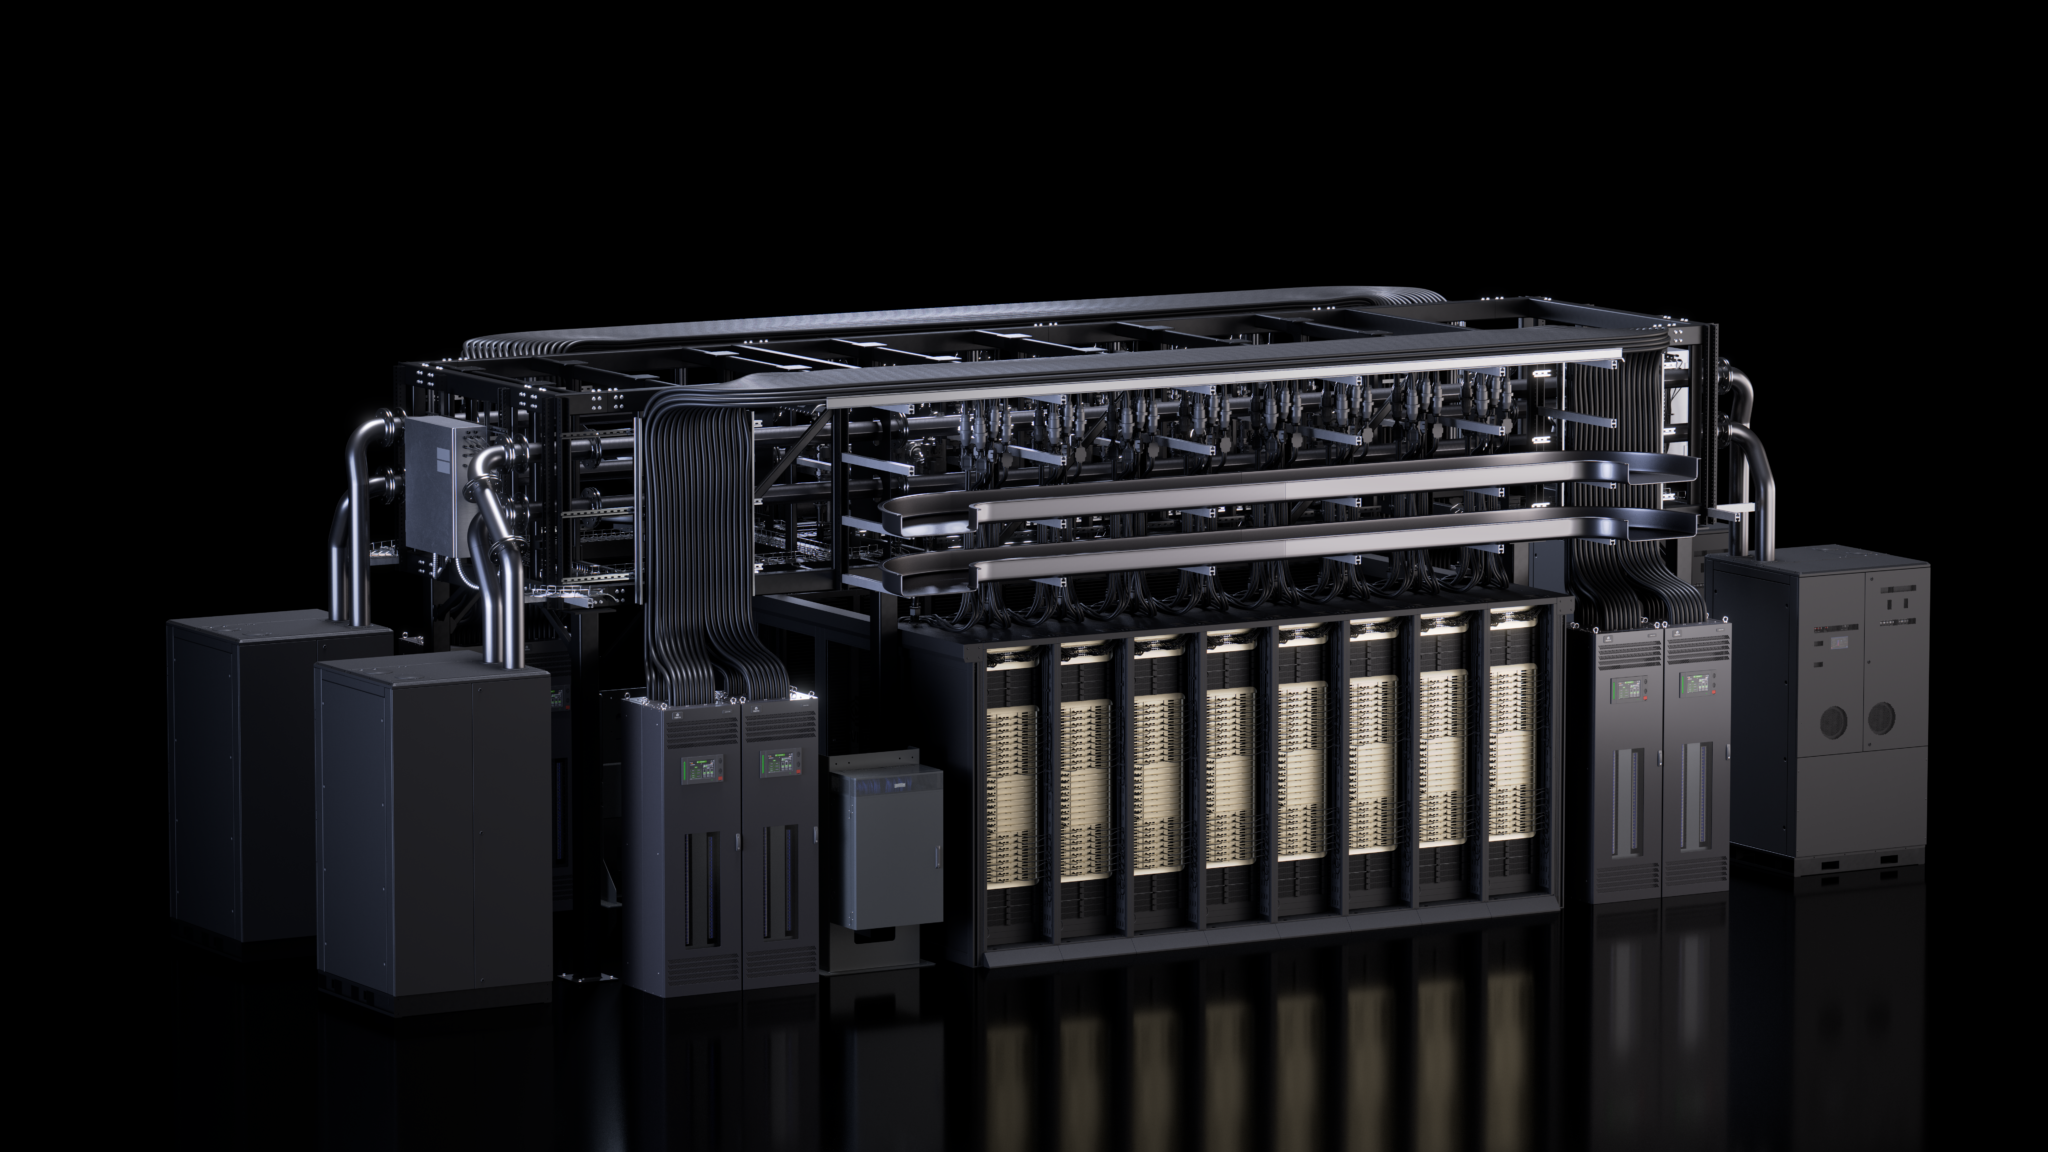
Parmi les principaux ajouts figurent :
NVIDIA indique que l’architecture peut prendre en charge des déploiements en rack jusqu’à 250 kW, tout en améliorant la maintenabilité et la réutilisation de l’infrastructure.
MGX est une architecture de référence modulaire, plutôt qu’une conception de serveur unique et figée.
Elle fournit aux OEM, ODM et partenaires d’infrastructure une base mécanique, électrique et de refroidissement commune, tout en autorisant différentes combinaisons de CPU, GPU, réseau et stockage.
Pour Vera Rubin, cela signifie que les partenaires peuvent bâtir sur une conception connue à l’échelle du rack, au lieu de partir à chaque fois d’une plateforme propriétaire.
La plateforme Vera Rubin NVL72 combine :
Elle peut ensuite évoluer horizontalement via NVIDIA Quantum-X800 InfiniBand ou Spectrum-X Ethernet.
NVIDIA étend également les mêmes principes de conception MGX à un rack Vera CPU dédié.
Alors que Vera Rubin NVL72 est conçu pour l’entraînement et l’inférence à très grande échelle, le rack Vera CPU cible les charges de travail agentiques intensives en CPU, telles que :
L’idée plus large consiste à maintenir une infrastructure physique cohérente, même lorsque différentes parties d’une charge de travail d’IA nécessitent des ressources de calcul différentes.
La plateforme DSX AI Factory de NVIDIA est conçue pour coordonner le calcul, la mise en réseau, l’alimentation, le refroidissement, les installations et les logiciels comme un seul système optimisé.
Au centre de la couche logicielle se trouve DSX OS, que NVIDIA décrit comme une couche d’exploitation ouverte permettant des opérations d’usine d’IA reproductibles.
À l’OCP, NVIDIA a enrichi DSX OS de quatre composants open source.
NVIDIA Config Manager automatise la configuration des commutateurs à grande échelle.
Son objectif est d’aider les opérateurs à déployer, valider et maintenir des fabrics réseau cohérents avec un minimum de configuration manuelle.
NVIDIA Cluster Readiness Engine soumet les clusters de GPU à des tests de charge à l’aide de simulations de charges de travail avant le début de l’entraînement en production.
L’objectif est de détecter suffisamment tôt les problèmes matériels ou d’infrastructure afin d’éviter des échecs coûteux des tâches d’entraînement.
NVIDIA Rack Management Service fournit une couche d’abstraction matérielle et d’exploitation au niveau du rack.
Au lieu de traiter chaque serveur indépendamment, le logiciel considère les racks comme des unités opérationnelles de premier ordre pour la gestion des micrologiciels et le contrôle de l’infrastructure à grande échelle.
Cluster API Provider for NVIDIA Infrastructure Controller est conçu pour accélérer le provisionnement bare metal et l’intégration des locataires.
NVIDIA indique que le but est de transformer du matériel d’IA brut en clusters prêts pour la production en quelques heures plutôt qu’en plusieurs jours.
Ces composants ont été développés à partir de l’expérience de NVIDIA dans l’exploitation de DGX Cloud et visent à faciliter l’intégration des capacités d’usine d’IA dans des plateformes cloud multi-locataires.
Les grandes installations d’IA ont besoin de davantage qu’une conception de rack commune. Les installations, les systèmes de refroidissement, l’architecture électrique et le comportement vis-à-vis du réseau public nécessitent également des attentes communes.
À l’OCP, NVIDIA s’est associé à AMD, Google et Meta pour publier une spécification ouverte actualisée de centre de données destinée à l’infrastructure d’IA de nouvelle génération.
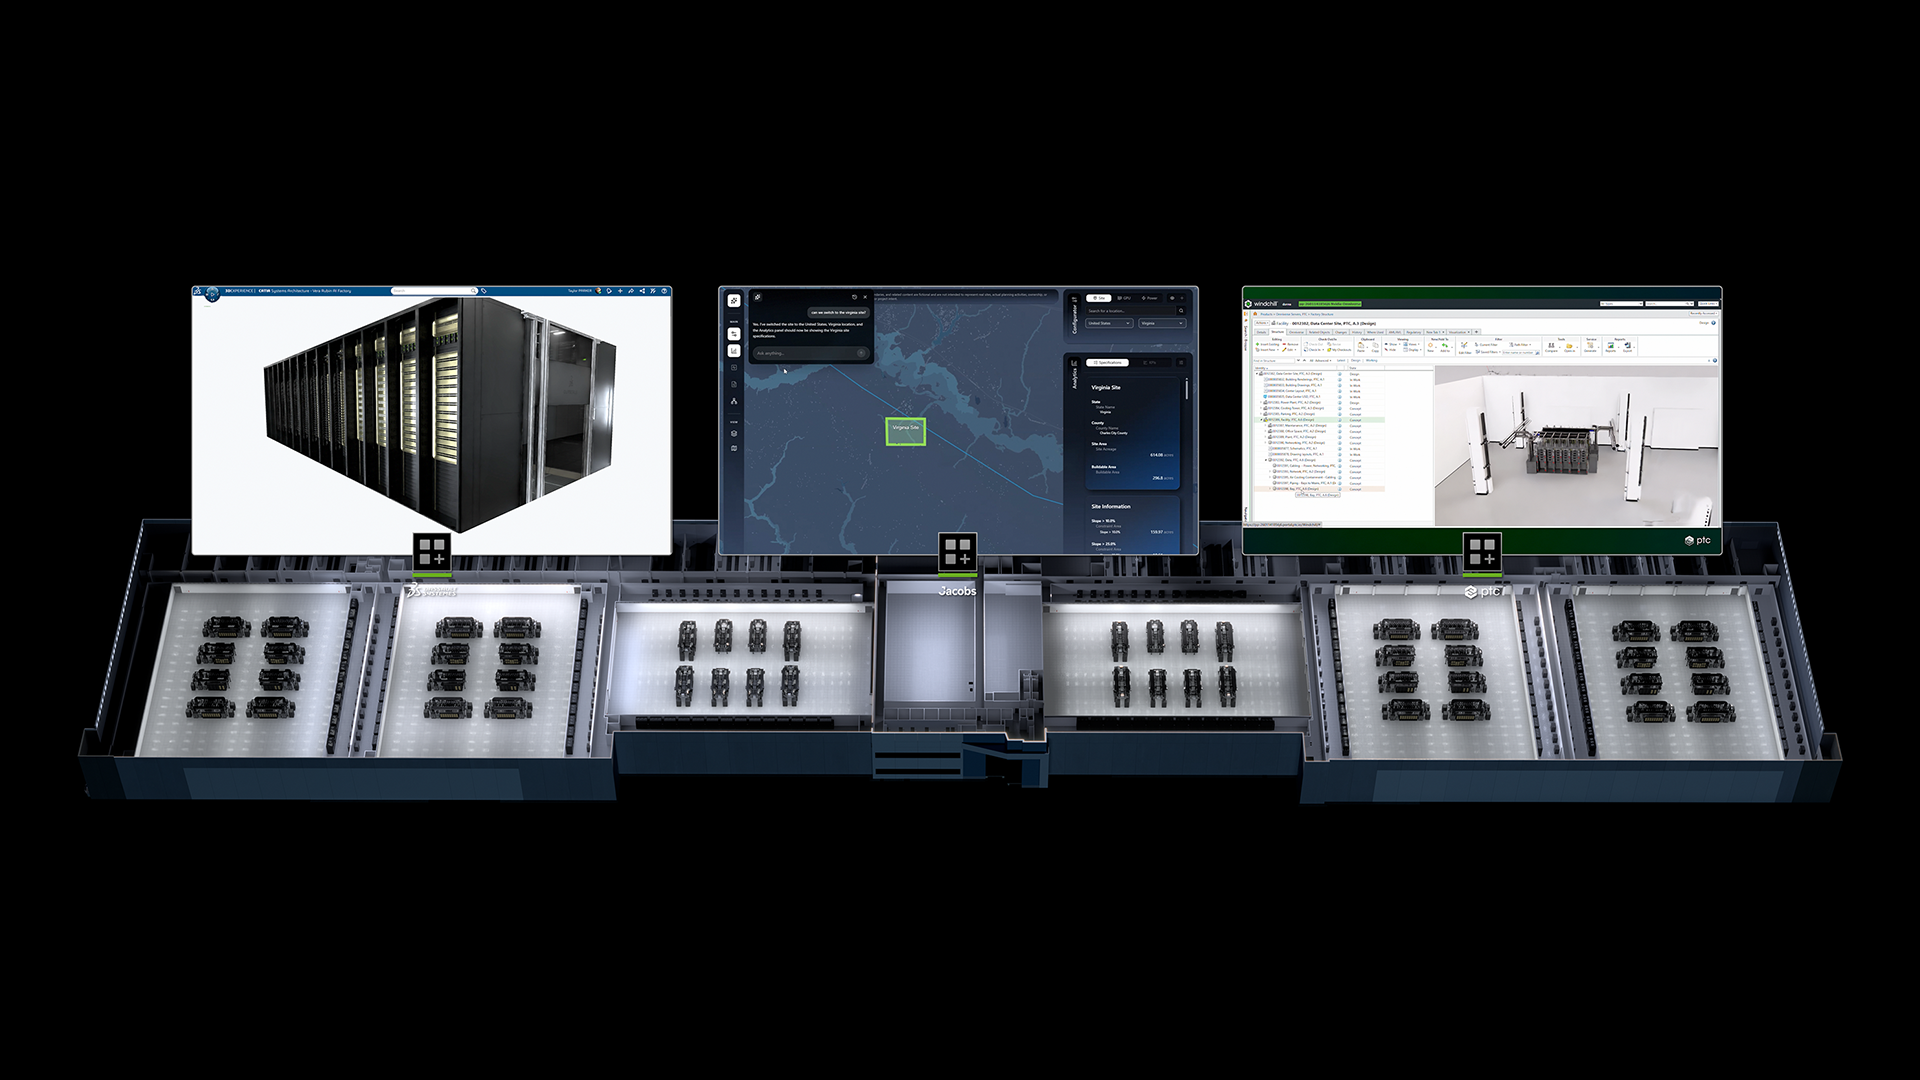
La Open Data Center Specification v0.7 définit un plan directeur commun pour la conception des installations d’usines d’IA.
Elle couvre notamment :
L’objectif est de donner aux fabricants, fournisseurs de colocation et opérateurs une cible commune, au lieu de les obliger à attendre une spécification propriétaire distincte de chaque client.
Google, Meta, Microsoft et NVIDIA ont également publié une OCP Grid Resilience Specification.
Cette spécification définit la manière dont les très grandes infrastructures d’IA doivent se comporter lors de perturbations du réseau électrique public.
L’objectif de conception est que les installations d’IA puissent :
Cet aspect devient de plus en plus important à mesure que les installations d’IA atteignent une taille telle que des changements soudains de consommation électrique peuvent affecter le réseau environnant.
NVIDIA indique que ses conceptions de référence DSX proposent un chemin de mise en œuvre déployable, depuis ces standards ouverts jusqu’à une infrastructure d’usine d’IA réelle.
La densité de puissance devient l’une des plus grandes contraintes de conception des usines d’IA.
À mesure que les clusters d’entraînement, d’inférence et de raisonnement grandissent, la distribution traditionnelle à plus basse tension exige des quantités croissantes de cuivre, de câblage et de matériel de conversion.
À l’OCP, Visionbay.ai a dévoilé des plans pour K-1, une plateforme d’usine d’IA fondée sur une architecture 800 VDC et conçue en tenant compte de futurs déploiements Vera Rubin.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
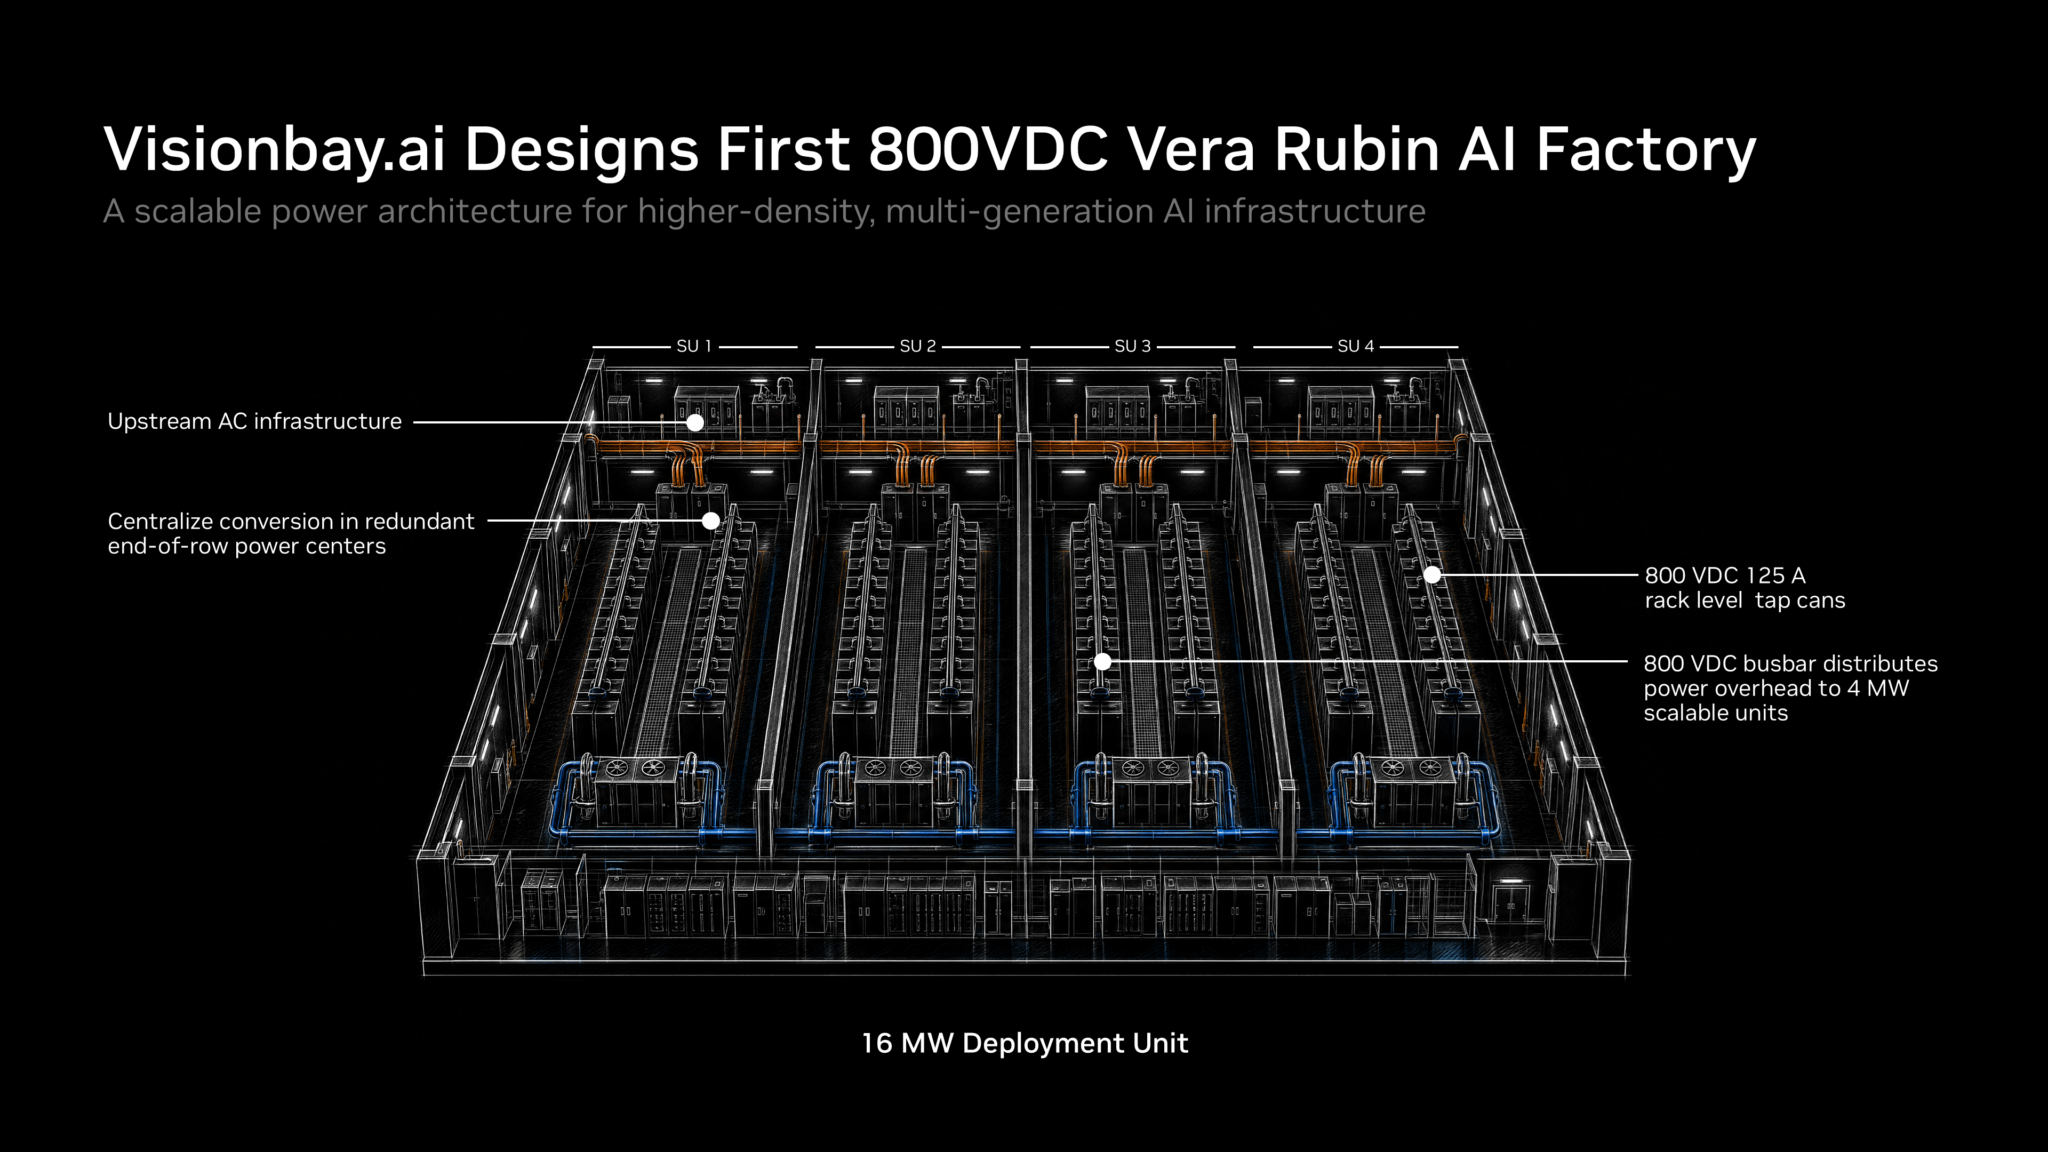
La conception associe l’architecture de référence 800 VDC de NVIDIA à des technologies d’alimentation et thermiques de Vertiv.
L’architecture vise à rapprocher la distribution DC haute tension de la couche de calcul.
Au lieu de convertir à plusieurs reprises et de distribuer une alimentation de plus basse tension à travers une grande quantité de cuivre, K-1 utilise des centres d’alimentation au niveau du cluster qui centralisent la conversion AC-DC, puis distribuent du 800 VDC plus près des racks.
Selon NVIDIA, cette approche peut :
La plateforme est également conçue pour une adoption progressive, plutôt que pour imposer à une installation entière de passer immédiatement au 800 VDC.
Elle offre ainsi aux opérateurs une voie pour introduire le courant continu haute tension là où il apporte le plus de valeur, tout en préservant la compatibilité avec l’infrastructure existante.
À l’OCP, Meta et NVIDIA ont annoncé une nouvelle étape de leur collaboration dans le domaine des réseaux.
Meta adopte les commutateurs Ethernet NVIDIA Spectrum-6 de 102,4 Tb/s pour des usines d’IA Vera Rubin plus grandes, fonctionnant sur une infrastructure de réseau ouverte.
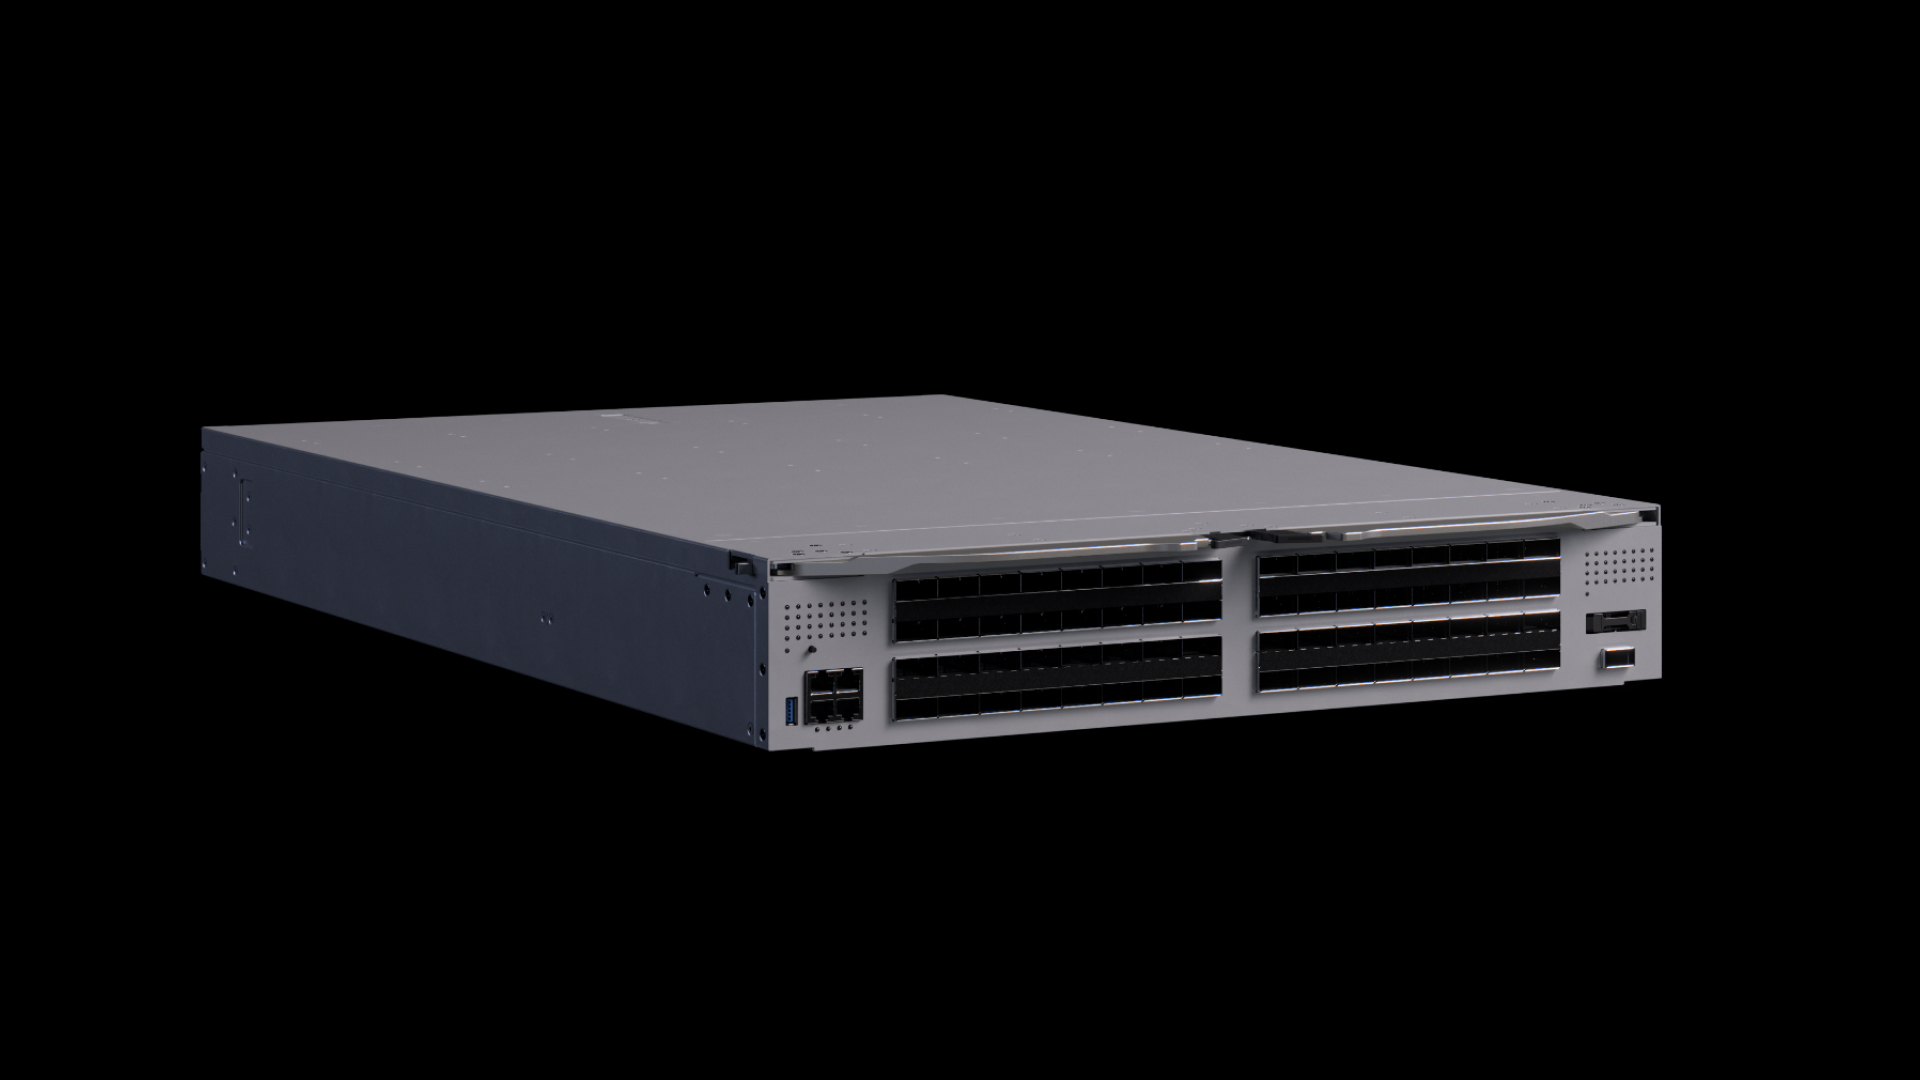
Spectrum-6 offre :
Le commutateur de Meta basé sur Spectrum-6 s’appelle N-IceCube.
Il est conçu pour s’intégrer à IcePack, le rack réseau refroidi par liquide de 100T de Meta.
N-IceCube exécute FBOSS, le système d’exploitation réseau open source de Meta.
FBOSS utilise la Switch Abstraction Interface (SAI), un standard OCP qui fournit une interface indépendante des fournisseurs pour contrôler le matériel des commutateurs.
Cela permet à Meta d’utiliser un plan de contrôle logiciel familier tout en adoptant les circuits de commutation Spectrum-6.
La technologie Spectrum-X Multiplane constitue une part majeure de cette collaboration.
À l’aide de commutateurs Spectrum-6 et de SuperNIC ConnectX-9, Multiplane distribue matériellement le trafic GPU sur jusqu’à huit plans réseau indépendants.
Cette conception est destinée à prendre en charge des usines d’IA de plus de 100 000 GPU, tout en réduisant le nombre de niveaux de commutateurs requis.
Les chemins multiples renforcent également la résilience.
Si un composant réseau échoue, le trafic peut basculer vers les plans restants. La charge de travail peut continuer avec une bande passante réduite, au lieu de perdre l’ensemble du fabric.
Le résultat est une architecture réseau conçue pour être à la fois très évolutive et plus facile à exploiter dans des conditions de production réelles.
À mesure que les clusters d’IA prennent de l’ampleur, la connexion optique physique elle-même devient une limitation.
NVIDIA et Cisco ont annoncé des plans pour Ultra-Dense Small Form Factor Pluggable (USFP), un nouveau module émetteur-récepteur optique enfichable conçu pour les réseaux d’IA de nouvelle génération.
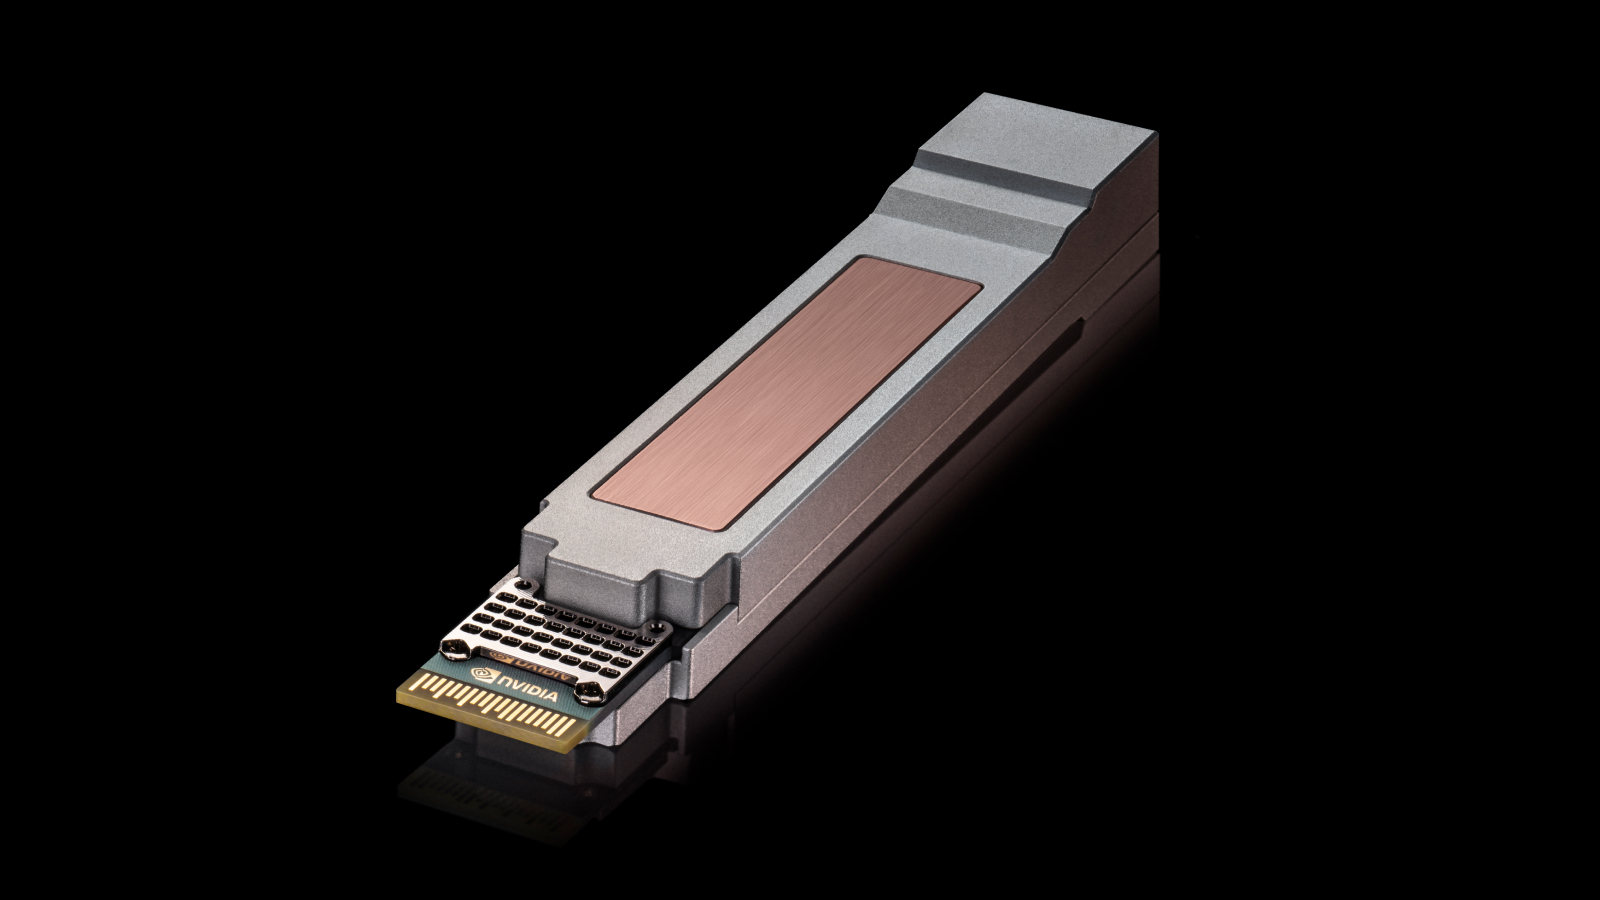
USFP est conçu pour ouvrir la voie à une mise en réseau de 400 Gb/s par voie, tout en conservant une empreinte approximativement identique à celle du format OSFP largement utilisé à 200 Gb/s par voie.
La conception prévue comprend :
L’objectif consiste à connecter davantage de ressources de calcul sans ajouter de niveaux réseau supplémentaires qui augmentent la latence, la consommation électrique et la complexité opérationnelle.
NVIDIA et Cisco collaborent avec TE Connectivity et Amphenol sur les cages, connecteurs et modules, et prévoient de faire progresser USFP par une initiative communautaire multi-source.
Cette approche maintient l’alignement de la conception avec le thème plus large de l’OCP, l’interopérabilité, plutôt qu’avec un écosystème optique à fournisseur unique.
NVIDIA et Google ont également annoncé que Falcon Transport sera pris en charge par les futurs SuperNIC NVIDIA ConnectX-10 et DPU BlueField.
Falcon est un protocole de transport conçu pour des communications fiables et performantes sur des réseaux Ethernet, notamment en situation de congestion.
Il prend notamment en charge :
Cette collaboration associe l’accélération matérielle de NVIDIA au logiciel DOCA afin de mettre en œuvre Falcon, tout en préservant pour les applications les interfaces de programmation RDMA standard.
Cela est important car il fournit au matériel réseau NVIDIA et Google une couche de transport commune, tout en permettant aux logiciels de continuer à utiliser des API RDMA familières.
Dans les grands fabrics d’IA, Falcon peut distribuer le trafic entre différents chemins, s’adapter à la congestion et récupérer les pertes de paquets, sans obliger les applications à gérer directement ces détails.
NVIDIA a contribué à l’OCP des conceptions clés de racks et de plateaux de calcul Vera Rubin via l’architecture ouverte MGX et a participé à de nouveaux standards relatifs aux installations, au réseau électrique et aux réseaux. L’entreprise a également publié quatre nouveaux composants d’infrastructure DSX OS en open source.
MGX 1.2 est une architecture de référence actualisée à l’échelle du rack pour le calcul accéléré à haute densité. Elle ajoute le refroidissement liquide blind-mate, un jeu de barres 5 000 A, la prise en charge native du 19 pouces, des baies d’E/S configurables et la prise en charge de racks jusqu’à 250 kW.
Les composants nouvellement mis en avant sont NVIDIA Config Manager, Cluster Readiness Engine, Rack Management Service et Cluster API Provider for NVIDIA Infrastructure Controller. Ils couvrent la configuration réseau, les tests d’intégrité des clusters, les opérations au niveau du rack et le provisionnement bare metal.
La distribution en courant continu à plus haute tension peut réduire la quantité de cuivre, de câblage et d’équipements de conversion nécessaires à mesure que la puissance des racks augmente. La conception de NVIDIA vise à prendre en charge de futurs racks d’IA de classe mégawatt tout en permettant une adoption progressive dans les installations existantes.
Spectrum-6 est la plateforme de commutateurs Ethernet 102,4 Tb/s de NVIDIA pour les usines d’IA. Elle fournit une mise en réseau à 200 Gb/s par voie et est adoptée par Meta dans le cadre de son architecture N-IceCube et Spectrum-X Multiplane.
USFP est un nouveau format de module optique enfichable développé par NVIDIA et Cisco pour les réseaux à 400 Gb/s par voie. Il est conçu pour augmenter la densité de bande passante et l’efficacité énergétique tout en préservant la maintenabilité des optiques enfichables.
Falcon est le protocole de transport Ethernet haute performance de Google. Les futurs SuperNIC ConnectX-10 et DPU BlueField devraient le prendre en charge grâce à l’accélération matérielle de NVIDIA et au logiciel DOCA, tout en préservant les interfaces de programmation RDMA.
Oui. NVIDIA a annoncé en mai 2026 que Vera Rubin montait en cadence vers une production à grande échelle, avec des partenaires mondiaux de systèmes et de chaîne d’approvisionnement fabriquant les systèmes à l’échelle industrielle.
Lors de l’OCP Global Summit 2026, NVIDIA a étendu Vera Rubin d’une plateforme de calcul à un plan directeur d’infrastructure plus ouvert. MGX 1.2 standardise une part plus importante de la conception des racks, du refroidissement et de l’alimentation, tandis que DSX OS ajoute des outils open source pour configurer, valider et exploiter de grands clusters d’IA.
L’écosystème environnant évolue dans la même direction. De nouvelles spécifications OCP pour les installations et le réseau électrique définissent comment les grandes usines d’IA doivent être construites et comment elles doivent se comporter lors de perturbations électriques. La conception 800 VDC de Visionbay répond à la hausse de densité des racks, tandis que Meta, Cisco et Google étendent la pile réseau via Spectrum-6, USFP et Falcon Transport.
Le thème central est l’interopérabilité : Vera Rubin devient non seulement une plateforme GPU, mais également une architecture de référence partagée couvrant le calcul, la mise en réseau, l’alimentation, le refroidissement et les opérations.
Partez d’une phrase et obtenez un site complet en quelques minutes.



