For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/openai-28-day-sprint-day-1-gpt-6-speed-bo-37dfc44c.md.
OpenAI a commencé le mois d’octobre par un engagement public inhabituel de Thibault « Tibo » Sottiaux, qui dirige des travaux couvrant les p...
OpenAI a commencé le mois d’octobre par un engagement public inhabituel de Thibault « Tibo » Sottiaux, qui dirige des travaux couvrant les produits Codex et ChatGPT.
Pendant 28 jours, l’équipe a déclaré qu’elle ferait chaque jour l’une des deux choses suivantes : livrer une amélioration claire qui compte pour la plupart des utilisateurs de Codex ou de ChatGPT Work, ou accorder une réinitialisation complète de l’usage.
La première livraison est arrivée le 5 octobre 2026. OpenAI a indiqué avoir optimisé d’environ 50 % la vitesse de réponse par défaut de GPT-6 Astra et de GPT-6.1 Sol pour les utilisateurs abonnés, dans l’ensemble des produits OpenAI et chez les partenaires pris en charge qui utilisent Sign in with ChatGPT.
Cela semble être une victoire facile. Pourtant, la réaction a été plus complexe.
L’annonce concernant la vitesse est arrivée en même temps que trois autres changements importants pour les utilisateurs avancés : OpenAI a introduit un nouveau format de publicité visuelle pour ChatGPT, publié son plan européen de filigranage de texte et modifié l’économie de ses abonnements Pro haut de gamme. Un nouveau rapport de SemiAnalysis a ensuite avancé que les abonnements Anthropic fournissent actuellement une valeur équivalente à l’API nettement supérieure pour certains niveaux de modèles courants.
Le résultat fut une première journée qui ressemblait moins à un tour d’honneur net qu’à un instantané des compromis qu’OpenAI tente de gérer : des modèles plus rapides, des coûts d’infrastructure plus élevés, de nouvelles sources de monétisation, la conformité réglementaire et des utilisateurs qui comparent de plus en plus chaque limite et chaque jeton à ceux des offres concurrentes.
Le sprint de 28 jours a commencé par une règle simple.
Tibo a déclaré qu’au cours des 28 jours suivants, OpenAI livrerait soit une amélioration clairement pertinente pour la plupart des utilisateurs de Codex et de Work, soit une réinitialisation complète.
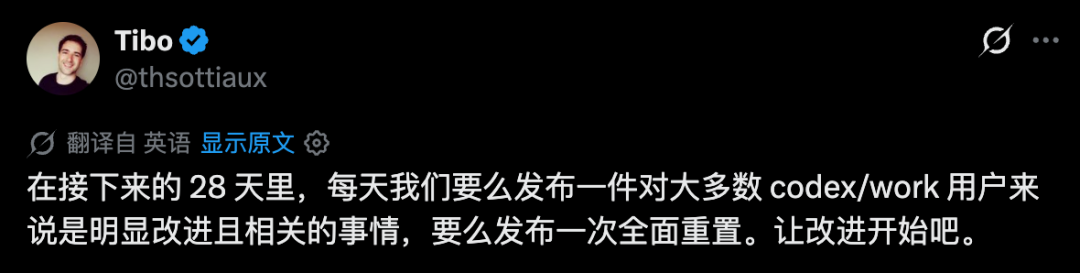
L’équipe a également concentré ses priorités à court terme sur quelques domaines :
Cet engagement est intervenu après une période de frustration particulièrement visible concernant la vitesse des modèles, les interruptions de service et l’évolution des quotas d’usage.
Pour le jour 1, OpenAI a choisi les performances d’inférence.
La première livraison était une optimisation de la vitesse par défaut pour GPT-6 Astra et GPT-6.1 Sol.
Le Centre d’aide actuel d’OpenAI décrit cette amélioration comme une hausse d’environ 50 % de la vitesse de génération de texte avec le réglage de vitesse par défaut.
Cette modification s’applique lorsque les modèles sont utilisés via un abonnement ChatGPT dans les produits OpenAI ou dans des applications partenaires prises en charge qui s’authentifient avec Sign in with ChatGPT, y compris, par exemple, OpenCode, Pi, Amp et Devin.
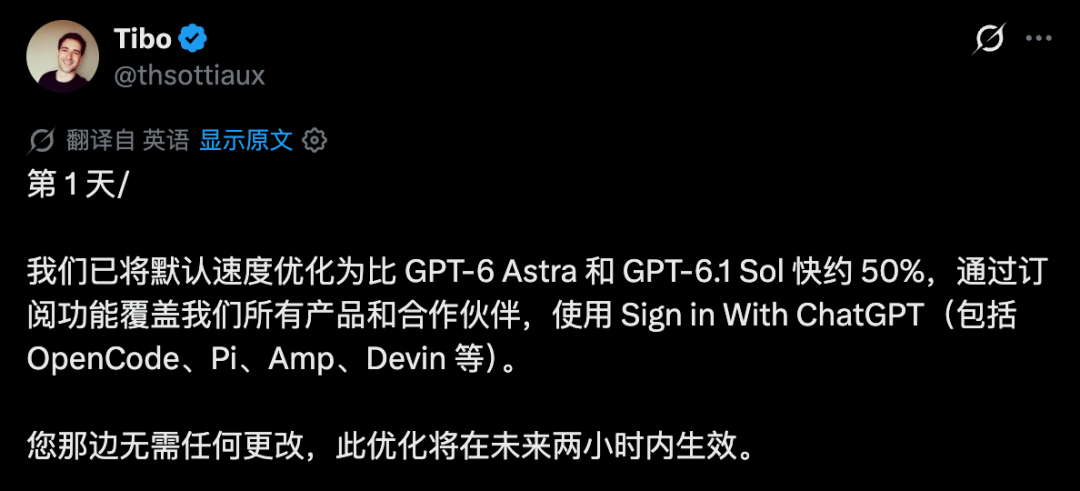
L’utilisateur n’a pas besoin d’activer Fast ou Ultrafast pour bénéficier de cette optimisation de la vitesse par défaut.
Le suivi communautaire d’OpenAI a décrit ce changement comme le passage d’un débit de sortie par défaut d’environ 30 jetons par seconde à près de 50 jetons par seconde.
Ce chiffre nécessite une précision importante : une génération de jetons plus rapide ne signifie pas qu’une tâche Codex ou Work complète se termine 50 % plus vite.
Les tâches agentiques consacrent souvent du temps à des activités telles que :
Si la génération de texte par le modèle ne représente qu’une partie de la tâche totale, la latence de bout en bout peut s’améliorer bien moins que ne le suggère le pourcentage mis en avant.
GPT-6.1 Sol avait déjà suscité des plaintes concernant sa latence peu après son déploiement du 29 septembre.
La source BAAI indique que certains utilisateurs jugeaient même les réponses en mode Fast plus lentes que prévu lors de périodes de forte charge. Tibo a publiquement reconnu une charge inhabituellement élevée et déclaré que les performances du service étaient en cours de rétablissement, des réinitialisations d’usage étant proposées aux utilisateurs payants affectés.
Cela aide à comprendre pourquoi l’optimisation de l’inférence est devenue le premier élément du programme de 28 jours.
OpenAI n’ajoutait pas un nouveau modèle au jour 1. L’entreprise rendait les modèles déjà utilisés par les utilisateurs plus rapides en pratique.
L’annonce sur la vitesse n’était pas la seule actualité OpenAI de cette semaine-là.
Le 5 octobre, OpenAI a annoncé un nouveau format de publicité visuelle pour ChatGPT.
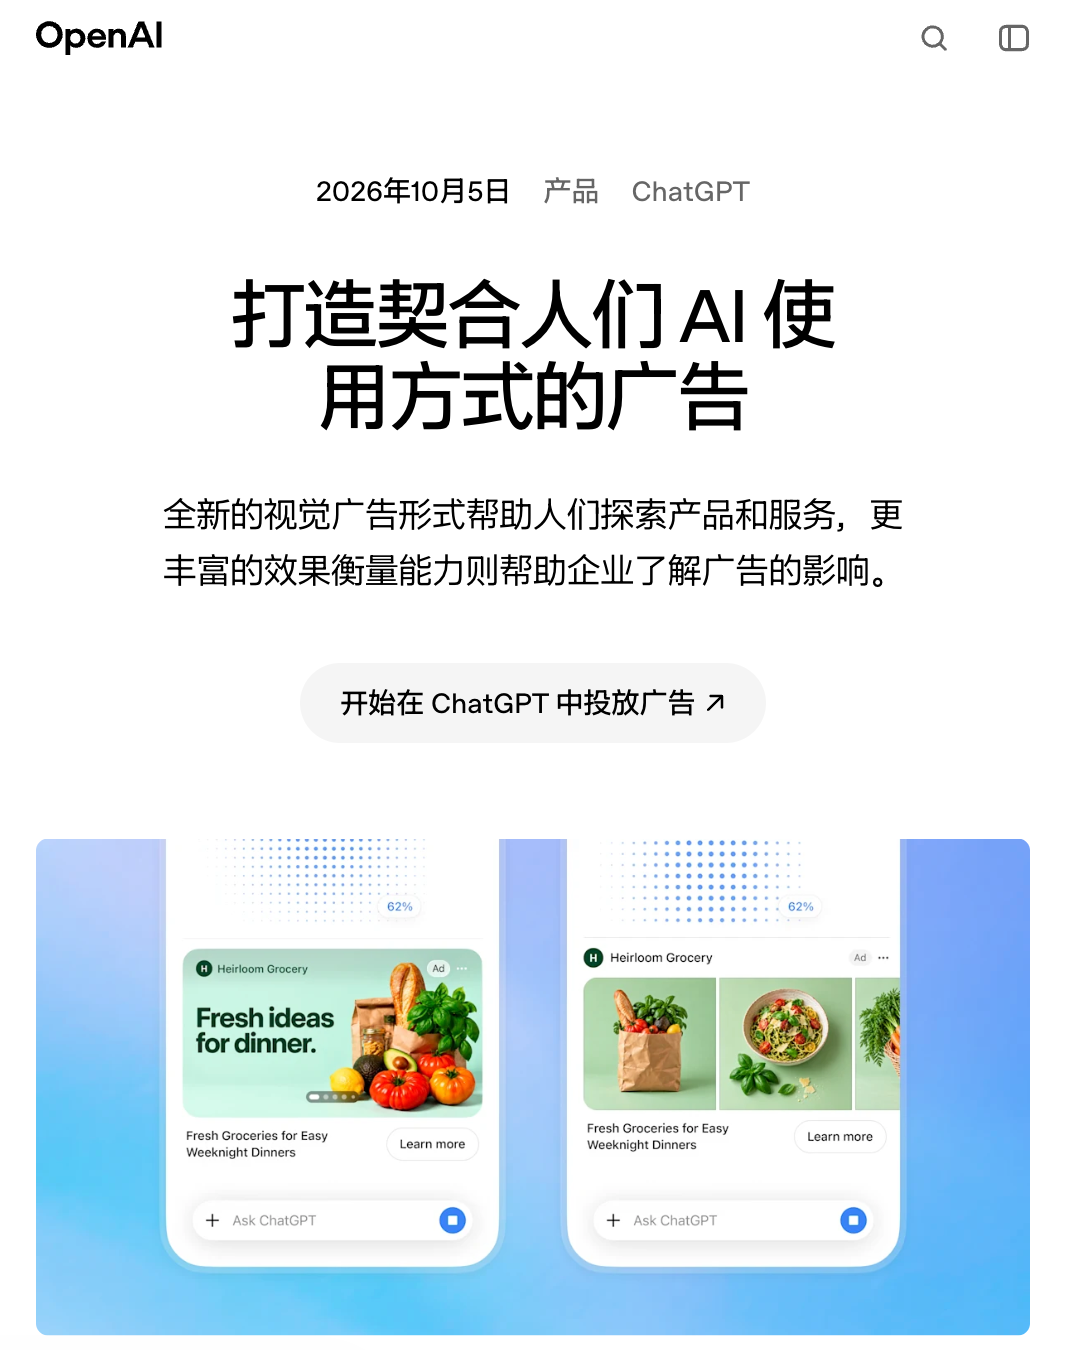
Ce format vise à présenter de l’inspiration produit, des usages de produits ou d’autres visuels de marque pendant que les utilisateurs explorent des produits et services dans ChatGPT.
Le premier test est plus limité que certains titres ne le suggèrent.
OpenAI indique que le déploiement initial va :
L’entreprise précise également que les publicités seront clairement identifiées et resteront séparées de l’image générée.
Selon OpenAI, la publicité n’influence pas les réponses de ChatGPT.
L’annonce va au-delà d’un nouveau format visuel.
OpenAI construit une infrastructure plus large de mesure publicitaire avec des partenaires d’attribution, de données de conversion, d’incrémentalité et d’adéquation à la marque.
Les partenaires cités par OpenAI incluent des services tels que :
OpenAI indique que ChatGPT touche désormais 1,2 milliard de personnes chaque semaine, ce qui fait de la publicité un modèle économique additionnel important, au côté des abonnements.
Les principes affichés par l’entreprise restent les suivants : les réponses doivent demeurer indépendantes, les conversations des utilisateurs doivent rester privées vis-à-vis des annonceurs et les utilisateurs doivent conserver le contrôle de leur expérience publicitaire.
Une seconde annonce portait sur la provenance plutôt que sur la monétisation.
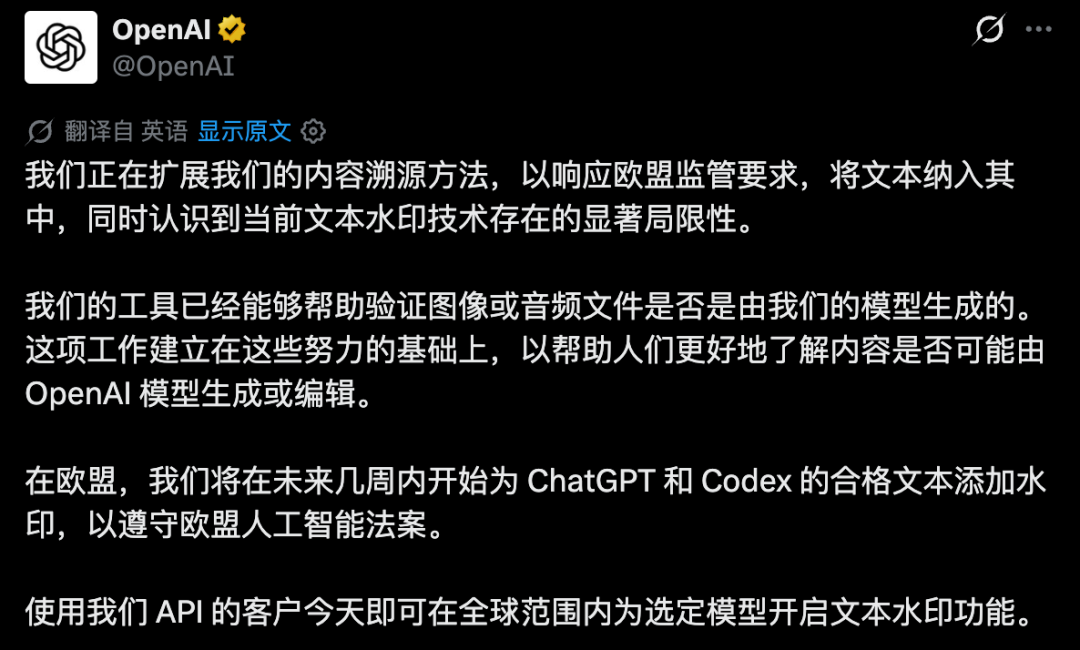
OpenAI a publié son plan de conformité aux exigences de transparence de l’AI Act européen en introduisant un filigrane statistique de texte appelé textGrain.
Le filigrane n’est ni un caractère Unicode caché, ni une espace invisible, ni une balise de métadonnées.
À la place, textGrain influence subtilement la manière dont le modèle choisit entre des mots ou fragments de mots possibles. Dans un passage suffisamment long, ces choix créent un signal statistique qu’un détecteur peut rechercher.
Le déploiement d’OpenAI suit deux trajectoires distinctes :
| Parcours produit | Statut du filigrane |
|---|---|
| ChatGPT et Codex dans l’UE | Déploiement au cours des prochaines semaines pour les sorties de texte éligibles |
| API OpenAI dans le monde | Option disponible pour certains modèles ; désactivée par défaut |
| Détecteur public | Pas généralement public au lancement |
| Accès pour chercheurs / experts | Disponible sur demande, au cas par cas |
L’article source établit à juste titre un lien entre cette initiative et l’AI Act européen, mais il est important de ne pas décrire ce filigrane comme un paramètre par défaut mondial de ChatGPT dès son lancement.
OpenAI indique explicitement que le déploiement initial dans ChatGPT et Codex est limité à l’UE.
OpenAI est particulièrement directe sur ce que le filigrane ne peut pas prouver.
Un filigrane détecté n’établit pas :
L’absence de filigrane détecté ne prouve pas non plus une rédaction humaine.
La propre évaluation d’OpenAI montre pourquoi. Avec un taux cible de faux positifs de 1 %, la détection devient plus robuste pour des passages longs et non contraints, tandis que les textes courts, très contraints, traduits ou modifiés peuvent être beaucoup plus difficiles à classifier.
L’entreprise indique que le remplacement d’une fraction même modeste des mots par des synonymes peut affaiblir sensiblement le signal.
textGrain est donc un signal de provenance, et non un détecteur infaillible de paternité du texte.
Si les publicités et le filigranage ont irrité certains utilisateurs, l’économie des abonnements était plus directement pertinente pour les développeurs qui utilisent intensivement Codex et les flux de travail agentiques.
Le 5 octobre, la société indépendante de recherche sur les semi-conducteurs et l’infrastructure IA SemiAnalysis a publié un rapport mesurant les limites pratiques des principaux abonnements IA.
Le rapport cherche à estimer la valeur équivalente à l’API, plutôt que de comparer uniquement les prix mensuels.
SemiAnalysis mesure la vitesse à laquelle les compteurs d’usage des abonnements évoluent sous des charges de travail contrôlées, estime le nombre de jetons inclus dans les fenêtres d’utilisation d’une offre, puis convertit ces limites en valeur à partir des prix API correspondants.
Cette méthodologie est utile, mais elle reste un cadre analytique créé par SemiAnalysis, et non une évaluation officielle des offres d’OpenAI ou d’Anthropic.
SemiAnalysis avance que les abonnements grand public sont fortement subventionnés par rapport à l’utilisation directe de l’API.
Pour Anthropic, son modèle approximatif estime que les abonnements représentent environ 10 % du chiffre d’affaires tout en consommant plus de 40 % de la capacité de calcul d’inférence.
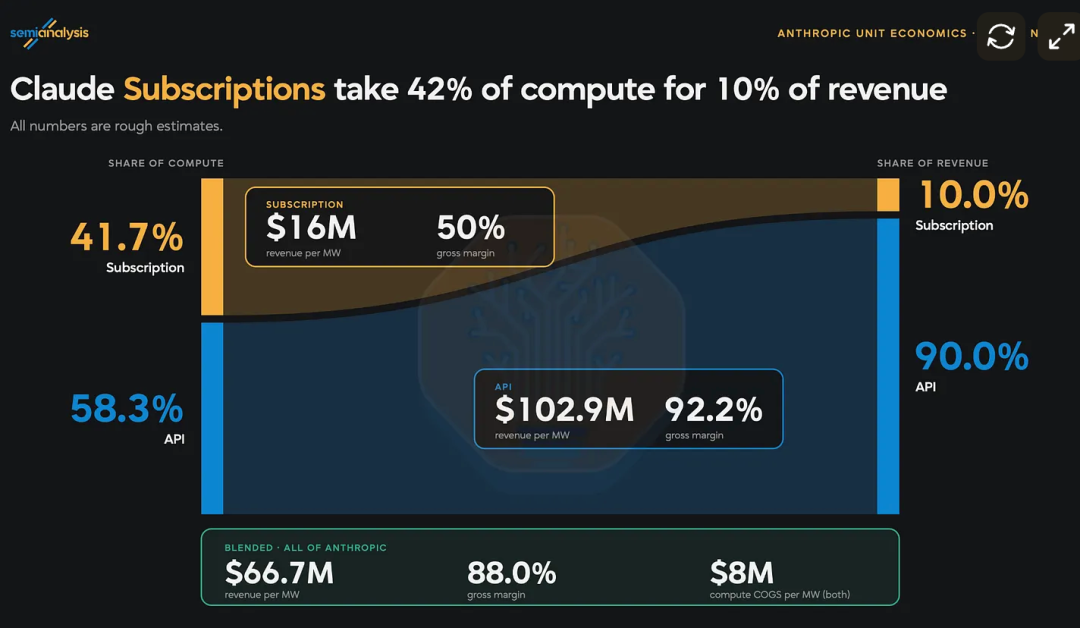
La société estime que cela réduit le revenu combiné par mégawatt d’environ 36 millions de dollars par rapport à une répartition de charge davantage orientée vers l’API.
L’économie exacte repose sur des estimations, et non sur des informations financières publiées par les entreprises.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Mais la pression globale est facile à comprendre : les abonnements mensuels fixes encouragent un usage intensif, tandis que l’inférence des modèles de pointe demeure coûteuse.
Il en résulte une tension permanente entre des limites d’usage généreuses et des marges soutenables.
OpenAI propose désormais trois niveaux Pro mensuels :
| Offre | Prix mensuel | Astra Ultrafast |
|---|---|---|
| Pro 100 | 100 $ | Non |
| Pro 200 | 200 $ | Non |
| Pro 500 | 500 $ | Oui |
Pro 500 a été lancé le 29 septembre et inclut le plus haut volume d’usage inclus parmi les trois offres Pro, ainsi qu’un accès à Astra Ultrafast dans ChatGPT Work et Codex.
OpenAI a également réduit l’allocation incluse pour les nouveaux abonnements Pro 200. Les clients éligibles au maintien des droits antérieurs peuvent conserver l’allocation précédente jusqu’au 29 octobre 2026.
Ce changement est réel et documenté par OpenAI.
Ce que SemiAnalysis ajoute est une mesure du volume d’usage pratique des modèles que ces niveaux semblent contenir.
Selon la société, l’offre Pro 200 mise à jour fournit environ la moitié de la valeur équivalente à l’API précédemment offerte, selon sa méthodologie de test.
Le rapport indique également que le nouveau niveau à 500 $ n’offre qu’environ 21 % d’usage supplémentaire de GPT-6 Astra par rapport à l’ancienne offre à 200 $ bénéficiant des droits antérieurs, bien que Pro 500 ajoute l’avantage distinct d’Astra Ultrafast.
Il est donc difficile d’évaluer la nouvelle offre à 500 $ à l’aide d’un chiffre unique : sa valeur dépend notamment de l’importance qu’un utilisateur accorde au débit maximal, et pas seulement au volume de jetons.
Le graphique le plus commenté compare GPT-6.1 Sol à Claude Opus 5.5 dans le cadre d’une charge de travail agentique.
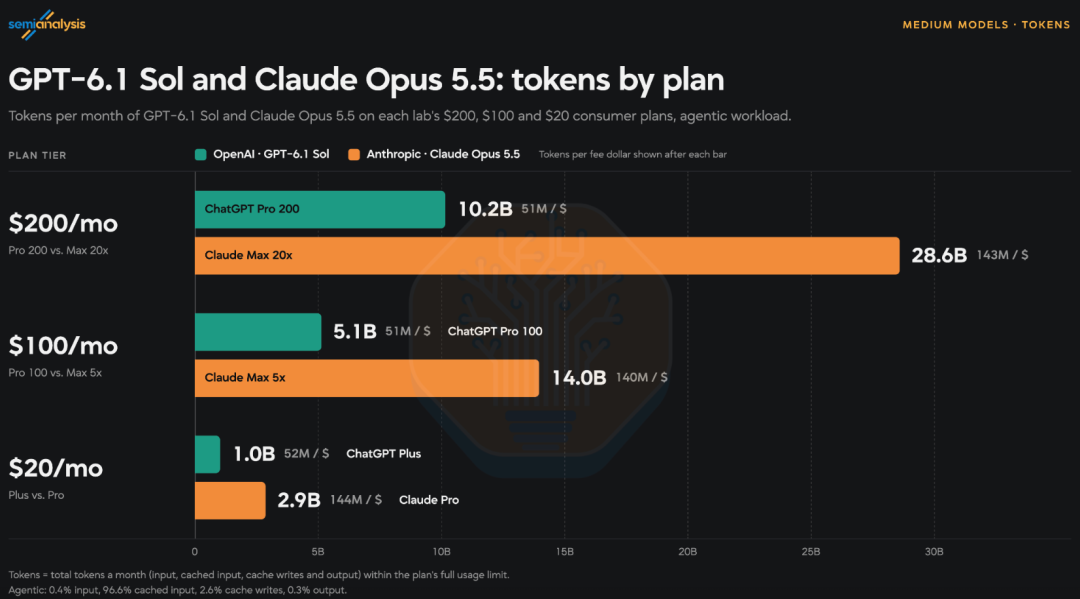
SemiAnalysis conclut qu’Anthropic offre environ 5× la valeur équivalente à l’API dans cette comparaison de milieu de gamme.
Cela ne signifie pas que chaque abonnement Claude est cinq fois meilleur pour chaque utilisateur.
Le résultat dépend :
SemiAnalysis note elle-même que l’efficacité des jetons est difficile à mesurer de manière fiable et que la valeur équivalente à l’API peut être trompeuse si le prix API ne correspond pas clairement à l’utilité concrète.
Le rapport donne néanmoins aux développeurs une raison concrète de comparer les abonnements selon la charge de travail réelle plutôt que selon les seuls intitulés marketing.
Après l’annonce de vitesse du jour 1, certains utilisateurs ont commencé à mesurer eux-mêmes le nouveau débit par défaut.
Un résultat largement partagé montrait que GPT-6.1 Sol Standard atteignait une moyenne d’environ 31,7 jetons par seconde sur une période de mesure, avec une fenêtre courte plus récente plus proche de la tranche des 30 jetons par seconde.
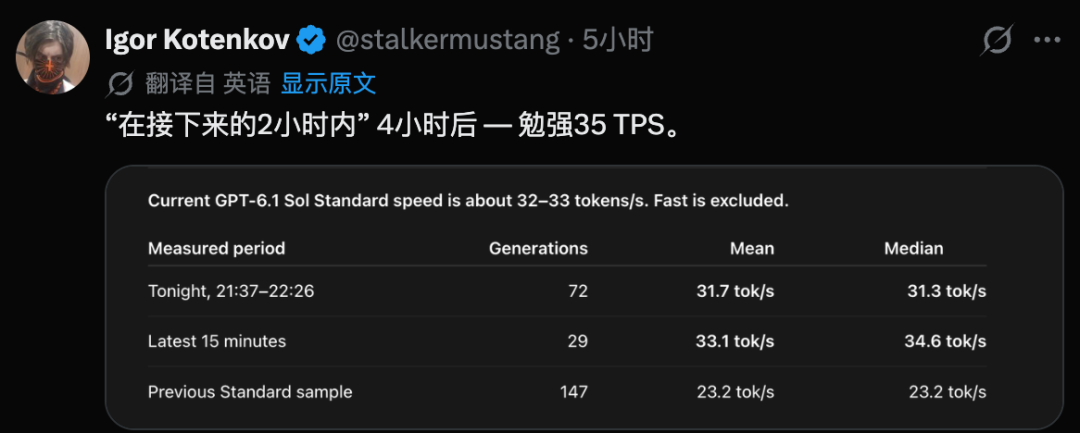
Ce résultat était inférieur au chiffre d’environ 50 jetons par seconde associé à l’annonce de déploiement.
Cela ne signifie pas nécessairement que l’optimisation a échoué.
La vitesse observée peut varier selon :
Le Centre d’aide d’OpenAI indique lui-même que le support ne peut pas actuellement vérifier l’amélioration de vitesse pour un compte individuel.
L’affirmation officielle doit donc être comprise comme une optimisation à l’échelle de la plateforme, et non comme un débit fixe garanti pour chaque requête.
Une autre réaction présentée dans l’article source était plus sceptique : certains utilisateurs ont fait valoir que GPT-6.1 Sol avait déjà considérablement ralenti après son lancement, de sorte que l’augmentation de vitesse du jour 1 ressemblait davantage à un rétablissement de performances perdues qu’à une capacité réellement nouvelle.
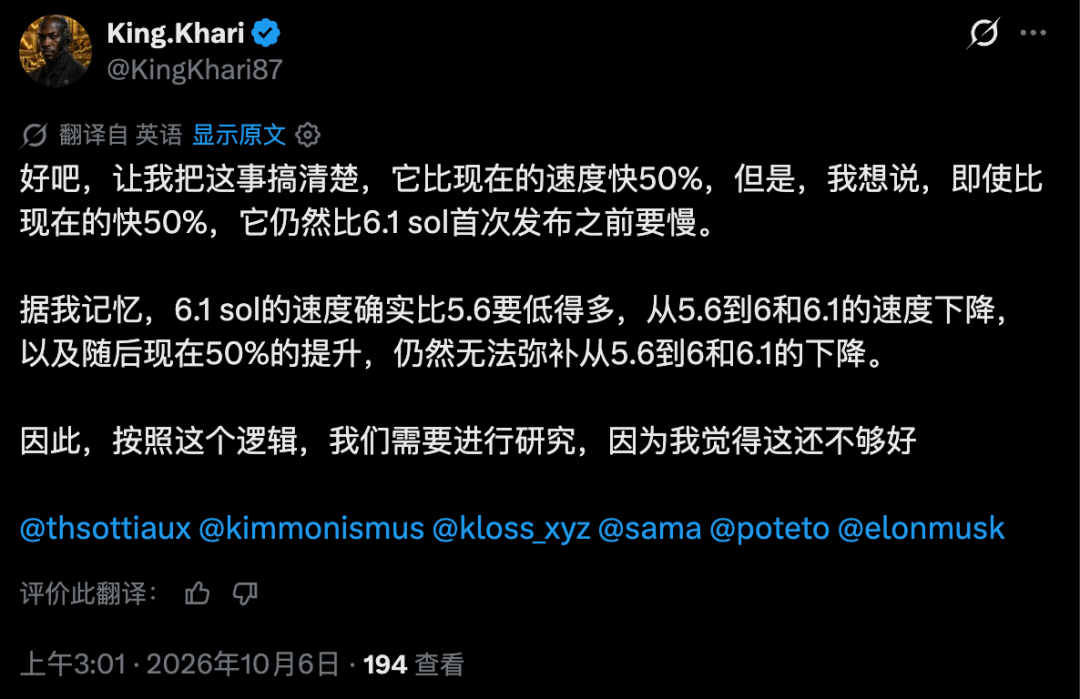
Il est difficile de prouver cet argument à partir de données publiques, car il n’existe pas un graphique historique officiel unique du débit d’inférence par utilisateur avant et après chaque événement de charge.
Ce qui est confirmé, c’est qu’OpenAI a reconnu une charge inhabituellement élevée autour de GPT-6.1 Sol et a ensuite livré une optimisation d’inférence destinée à améliorer la vitesse de génération de texte par défaut.
La réaction des utilisateurs reste importante, car elle explique pourquoi une amélioration technique significative des performances n’a pas automatiquement suscité une réponse positive.
Les utilisateurs évaluent une mise à jour en fonction de leur expérience précédente, et non seulement du benchmark actuel de l’entreprise.
Prise isolément, une vitesse de réponse par défaut plus élevée constitue une amélioration simple de la qualité d’utilisation.
Mais le jour 1 est arrivé au milieu de plusieurs changements qui se chevauchaient :
La réaction portait donc moins sur une optimisation d’inférence que sur ce que les utilisateurs pensent qu’OpenAI priorise.
Pour les développeurs, la question centrale est concrète :
Les modèles deviennent-ils plus rapides et plus utiles suffisamment vite pour compenser des limites plus restrictives, des niveaux tarifaires plus élevés et une expérience produit davantage commercialisée ?
Il n’existe pas de réponse unique.
Un utilisateur qui valorise Astra Ultrafast, Codex Cloud ou l’écosystème plus large d’outils d’OpenAI peut parvenir à un calcul très différent de celui d’un développeur qui optimise uniquement le nombre de jetons de modèle par dollar d’abonnement.
Le programme de 28 jours crée une boucle de retour inhabituellement publique.
Au lieu d’annoncer une grande feuille de route et de demander aux utilisateurs d’attendre, OpenAI s’oblige à produire des améliorations visibles à un rythme quotidien ou à compenser les utilisateurs par une réinitialisation.
Le premier jour était centré sur la vitesse d’inférence.
Au 8 octobre, le défi avait déjà dépassé le jour 1, avec des mises à jour ultérieures comprenant notamment Auto Review gratuit, la simplification des limites de débit API, un plugin de réunions, la bêta publique de Decisions API, des réinitialisations et GPT-6 avec Intelligent UI.
Cet article reste centré sur l’instantané du jour 1, car il s’agit du sujet du rapport BAAI d’origine.
Le test le plus important concerne ce que les 28 jours complets apporteront au total.
Si le programme livre des améliorations que les utilisateurs ressentent réellement dans leurs activités quotidiennes de développement et de travail intellectuel, l’optimisation de vitesse apparaîtra comme une première étape raisonnable.
Si les mises à jour ultérieures paraissent cosmétiques tandis que les limites et la tarification restent le principal sujet d’attention, le scepticisme observé au jour 1 sera plus difficile à inverser.
Pendant 28 jours, Tibo Sottiaux d’OpenAI a indiqué que l’équipe livrerait chaque jour soit une amélioration claire pertinente pour la plupart des utilisateurs de Codex et de ChatGPT Work, soit une réinitialisation complète. Le programme a commencé début octobre 2026.
OpenAI décrit l’optimisation du jour 1 comme une hausse d’environ 50 % de la vitesse de génération de texte par défaut. Cela ne signifie pas que chaque tâche Work ou Codex complète sera terminée 50 % plus vite, car l’utilisation d’outils, la navigation, le raisonnement et les services externes consomment également du temps.
Non. OpenAI indique que l’amélioration s’applique au réglage de vitesse par défaut. Fast et Ultrafast sont des niveaux de service et options de produit distincts.
OpenAI indique que le test initial de publicité visuelle commencera plus tard en octobre 2026 aux États-Unis, pendant la génération d’images pour les utilisateurs Free et Go. Les publicités seront identifiées et séparées de l’image générée.
Non. OpenAI prévoit d’ajouter le filigranage textGrain aux textes éligibles de ChatGPT et Codex dans l’Union européenne au cours des prochaines semaines. Les clients API du monde entier peuvent l’activer pour certains modèles, mais le filigranage est désactivé par défaut dans l’API.
Pro 500 est le niveau Pro d’OpenAI à 500 $ par mois. Il inclut le volume d’usage inclus le plus élevé parmi les offres Pro et l’accès à Astra Ultrafast dans ChatGPT Work et Codex.
Oui. OpenAI documente une allocation incluse plus faible pour les nouveaux abonnements Pro 200, tandis que les utilisateurs éligibles au maintien des droits antérieurs peuvent conserver l’allocation précédente jusqu’au 29 octobre 2026.
Il s’agit d’une conclusion de SemiAnalysis pour des comparaisons précises de modèles et de charges de travail, utilisant sa méthodologie de valeur équivalente à l’API. Elle ne doit pas être considérée comme une mesure universelle de la qualité ou de l’utilité d’un modèle pour chaque utilisateur.
OpenAI a lancé son sprint de livraisons de 28 jours pour Codex et ChatGPT Work par une réelle amélioration d’infrastructure : GPT-6 Astra et GPT-6.1 Sol génèrent désormais du texte environ 50 % plus vite avec le réglage de vitesse par défaut dans les produits sur abonnement et chez les partenaires pris en charge par Sign in with ChatGPT.
La réaction modérée est plus compréhensible lorsqu’on la replace dans le contexte de tout ce qui se produisait simultanément. OpenAI teste des publicités visuelles, déploie le filigranage de texte européen, restructure les allocations d’usage Pro et vend une nouvelle offre à 500 $ avec Astra Ultrafast, tandis que SemiAnalysis avance qu’Anthropic fournit actuellement beaucoup plus de valeur équivalente à l’API dans plusieurs comparaisons courantes d’abonnements.
Le débat du premier jour ne concerne donc pas réellement les jetons par seconde. Il porte sur l’ensemble de la proposition de valeur que les utilisateurs évaluent désormais : qualité du modèle, vitesse, limites, tarification, outils, confidentialité, publicité et fiabilité.
Le jour 1 a rendu les modèles plus rapides ; les 27 jours restants détermineront si OpenAI peut améliorer de façon significative l’expérience globale de Codex et Work.
Partez d’une phrase et obtenez un site complet en quelques minutes.



