Un week-end d'août 2026 a produit l'un des signes les plus nets à ce jour que l'IA de pointe dépasse les mathématiques de référence pour ent...
Un week-end d'août 2026 a produit l'un des signes les plus nets à ce jour que l'IA de pointe dépasse les mathématiques de référence pour entrer dans le domaine de la recherche active.
Le 1er août, OpenAI a publié « Dix avancées en mathématiques et en informatique théorique ». Ces résultats ont été générés par une version interne d'Astra, qu'OpenAI décrit comme son prochain modèle majeur.
Le pack de résultats comprend :
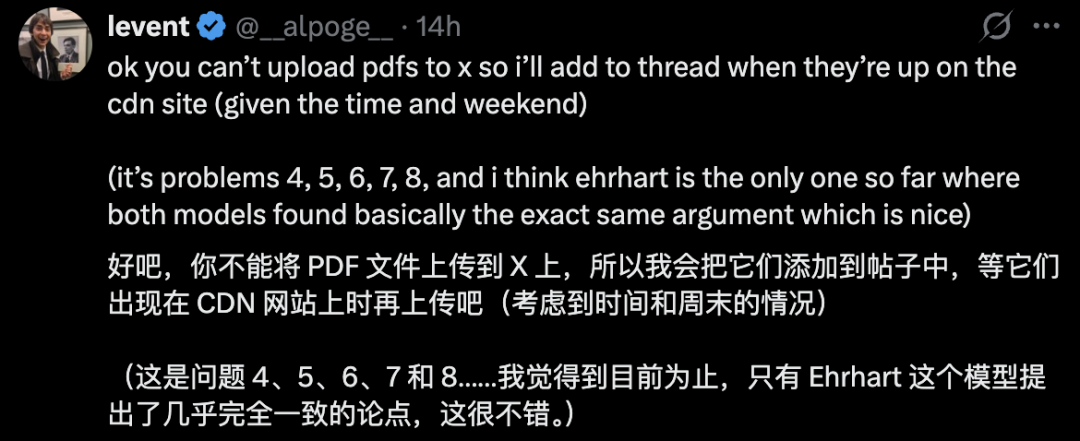
Moins de 24 heures plus tard, le chercheur d'Anthropic Levent Alpöge a déclaré que le modèle public Claude Fable 5 avait reproduit cinq des dix résultats.
Il a confirmé qu'il s'agissait des problèmes 4 à 8 :
Alpöge a précisé que ces exécutions étaient autonomes, utilisant des invites génériques, sans accès à Internet, et avec des précautions visant à empêcher que les solutions d'OpenAI ne fuient dans le contexte.
Si ces cinq preuves résistent à un examen public complet, cet événement indiquerait que des résultats de recherche produits par un modèle de pointe peuvent parfois être redécouverts de manière indépendante par un autre modèle presque immédiatement.
Cependant, les preuves ne sont pas symétriques. OpenAI a publié des manuscrits, des détails de processus et des certificats vérifiables par machine. La déclaration de Fable, quant à elle, repose principalement sur des affirmations publiques plutôt que sur un ensemble complet de preuves.
Par conséquent, la conclusion utile n'est pas simplement qu'un modèle a gagné.
L'IA est désormais capable de générer des mathématiques de niveau recherche à une vitesse telle que la vérification, l'explication, l'attribution et l'examen pourraient devenir plus difficiles à mettre à l'échelle que la production de preuves elle-même.
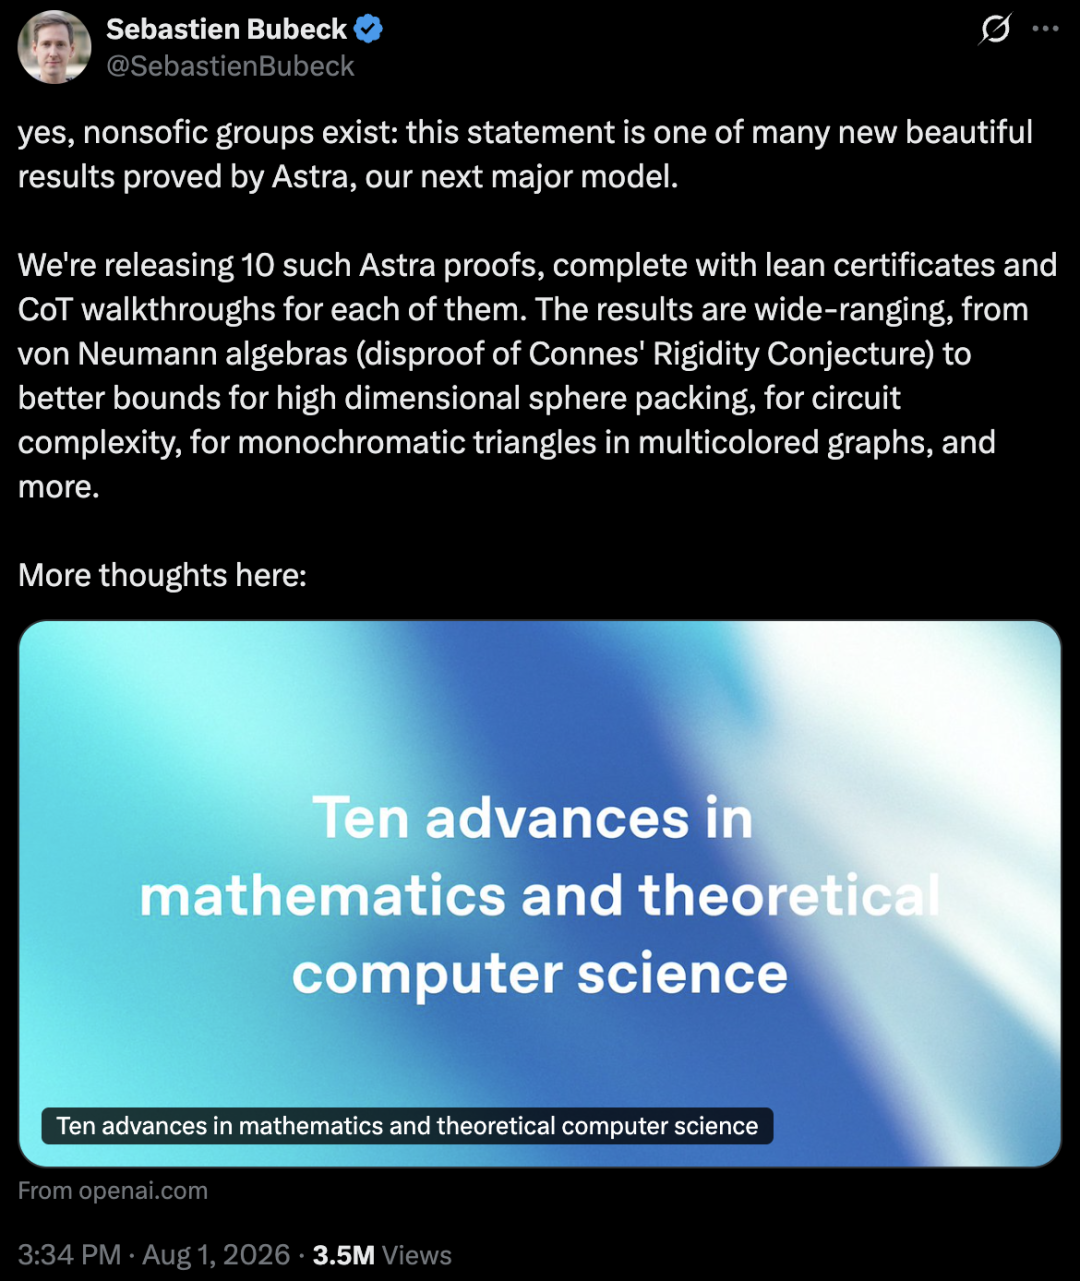
OpenAI décrit ces travaux comme dix résultats qui résolvent ou progressent de manière significative sur des problèmes ouverts de longue date.
Ces sujets couvrent la géométrie en haute dimension, la théorie des codes, la théorie des groupes, les algèbres d'opérateurs, la complexité des circuits arithmétiques, la complexité quantique, les problèmes de réseaux, la géométrie convexe, la théorie de Ramsey et la théorie extrémale des graphes.
OpenAI indique que ces arguments mathématiques ont été générés par le modèle interne Astra. Ensuite, des humains, assistés par le même modèle, ont organisé ces arguments en manuscrits, avant que le modèle ne formalise chaque résultat dans Lean.
Le flux de travail plus précis est le suivant :
Astra recherche des arguments mathématiques
→ Sélection des arguments réussis
→ Les humains et le modèle préparent un manuscrit lisible
→ Le modèle formalise

Résultat dans Lean
→ Certificats formels et code source publiés
→ Des mathématiciens externes vérifient l'exactitude, la nouveauté et l'importance
La contribution du modèle est centrale, mais le résultat final de la recherche comprend également la préparation humaine, l'infrastructure formelle, les bibliothèques logicielles et l'examen par des experts.
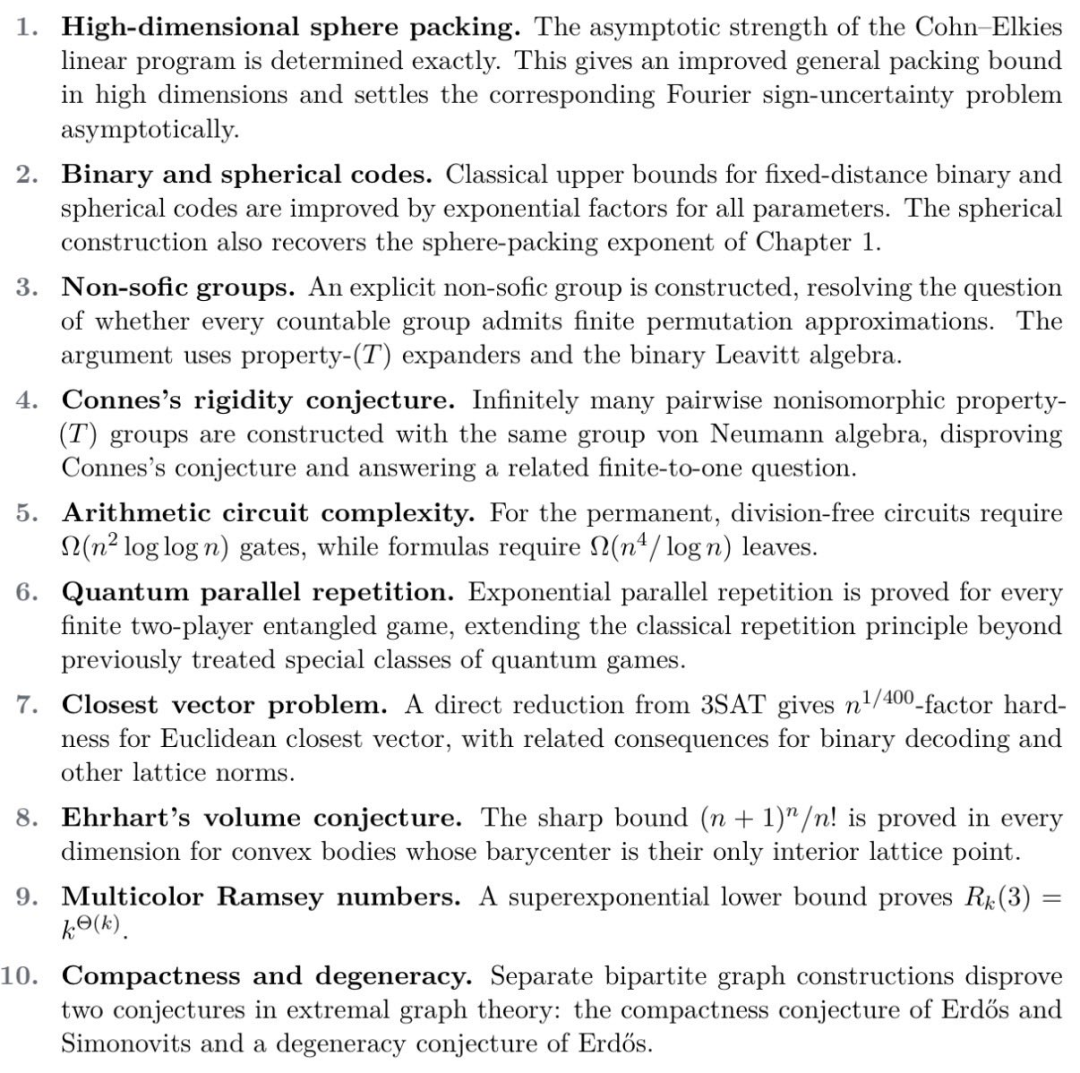
| N° | Domaine | Résultat publié par OpenAI |
|---|---|---|
| 1 | Empilement de sphères en haute dimension | Détermination de la force asymptotique de la programmation linéaire de Cohn–Elkies et amélioration des bornes générales d'empilement en haute dimension |
| 2 | Codes binaires et codes sphériques | Amélioration des bornes classiques des codes à distance fixe par un facteur exponentiel |
| 3 | Groupes non-sofiques | Construction d'un groupe non-sofique explicite, résolvant la question de savoir si tout groupe dénombrable admet une approximation par permutations finies |
| 4 | Conjecture de rigidité de Connes | Construction de groupes de type (T) ayant la même algèbre de von Neumann de groupe mais non isomorphes, infirmant ainsi la conjecture |
| 5 | Complexité des circuits arithmétiques | Établissement de nouvelles bornes inférieures pour le calcul du permanent, y compris des bornes inférieures de formule arithmétique de l'ordre de (n^4/\log n) |
| 6 | Répétition parallèle quantique | Preuve de la propriété de répétition parallèle exponentielle pour les jeux quantiques à deux joueurs finis généraux |
| 7 | Problème du vecteur le plus proche | Dureté d'approximation par facteur polynomial pour le CVP euclidien et les problèmes de réseaux associés |
| 8 | Conjecture du volume d'Ehrhart | Preuve de la borne de volume maximale optimale pour une classe spécifiée de corps convexes dans chaque dimension |
| 9 | Nombres de Ramsey multicolores | Preuve de bornes inférieures hyperexponentielles pour les nombres de Ramsey triangulaires multicolores, résolvant le problème 183 d'Erdős |
| 10 | Théorie extrémale des graphes | Construction d'exemples infirmant les conjectures de compacité et de dégénérescence liées aux problèmes 146 et 180 d'Erdős |
Ce ne sont pas des problèmes olympiades ordinaires. Plusieurs d'entre eux concernent des problèmes restés ouverts pendant des années et nécessitent une expertise approfondie pour être évalués.
OpenAI a également publié un document de 62 pages intitulé « Comment les idées se forment : notes sur la découverte mathématique ».
Les preuves répondent à la question :
Pourquoi ce théorème est-il vrai ?
Les notes de découverte tentent de répondre à la question :
Comment le système a-t-il trouvé cet argument ?
Ce sont deux questions distinctes.
L'analyse pas à pas peut aider les chercheurs à déterminer si le modèle a recombiné des idées connues, identifié une analogie, effectué une recherche approfondie, trouvé une nouvelle construction, ou utilisé un théorème connu d'une manière inattendue.
Ces documents doivent néanmoins être lus avec prudence. Les récits générés par le modèle ne constituent pas nécessairement un enregistrement causal parfait de chaque calcul interne.
Le dépôt officiel openai/ten-proofs contient un module Lean pour chaque résultat.
Le projet utilise :
Lean 4.32.0
mathlib
Lake
Après installation d'elan, le README officiel indique aux utilisateurs de construire l'ensemble des dix preuves formelles via la commande suivante :
lake exe cache get
lake build All
Il est également possible de construire un module individuellement :
lake build SpherePacking
Le dépôt contient :
SpherePacking.lean
MetricCodes.lean
NonSoficGroup.lean
ConnesRigidity.lean
Permanent.lean
QuantumParallelRepetition.lean
lean
GapCVP.lean
EhrhartVolumeInequality.lean
MulticolorTriangleRamsey.lean
CompactnessAndDegeneracy.lean
Le code est publié sous licence Apache 2.0 et comprend des ressources de vérification indépendantes.
Lean est un démonstrateur de théorèmes interactif basé sur la théorie des types dépendants.
Les preuves vérifiées par le noyau Lean établissent qu'un théorème formalisé découle des définitions, hypothèses, axiomes et bibliothèques importés, ainsi que du terme de preuve formalisé.
Cela exclut de nombreuses erreurs possibles dans les raisonnements informels :
Un certificat peut être vérifié mécaniquement, plutôt que d'être accepté parce que l'auteur semble convaincant.
La vérification formelle n'élimine pas toutes les questions d'examen.
Le démonstrateur de théorèmes vérifie l'énoncé encodé. Les humains doivent encore juger s'il capture fidèlement le problème mathématique.
Lean vérifie les conséquences des définitions formalisées. Il ne peut pas décider si ces définitions reflètent des concepts reconnus, ni s'il existe des hypothèses cachées qui affaiblissent le résultat annoncé.
La correction formelle ne vaut pas nouveauté. Une revue de littérature et une expertise humaine restent nécessaires.
Une machine peut vérifier qu'un théorème est vrai. Mais elle ne peut pas juger si le résultat transforme le domaine ou introduit des idées précieuses.
Deux preuves formellement correctes peuvent différer considérablement en valeur explicative. L'une peut révéler des principes réutilisables ; l'autre peut être difficile à intérioriser par les humains.
La vérification formelle traite du problème de la correction. La compréhension mathématique reste une tâche distincte.
Moins d'un jour après l'annonce d'OpenAI, Alpöge a écrit qu'il « en avait terminé la moitié avec Fable ».
Il a décrit la configuration comme suit :

Alpöge a ensuite confirmé que ces cinq résultats étaient les numéros 4 à 8.
| Projet OpenAI | Sujet | Statut public des revendications de Fable |
|---|---|---|
| 4 | Conjecture de rigidité de Connes | Reproduction revendiquée |
| 5 | Complexité des circuits arithmétiques | Reproduction revendiquée |
| 6 | Répétition parallèle quantique | Reproduction revendiquée |
| 7 | Problème du plus proche vecteur | Reproduction revendiquée |
| 8 | Conjecture du volume d'Ehrhart | Reproduction revendiquée |
Alpöge indique que le résultat d'Ehrhart est le seul pour lequel Astra et Fable semblent avoir utilisé essentiellement le même argument.
Si cela est exact, les quatre autres pourraient être des preuves alternatives, et non des reconstructions du cheminement d'OpenAI.
Pour les dix résultats d'OpenAI, le paquet public contient les énoncés des théorèmes, les manuscrits complets, le processus de raisonnement, le code source Lean, les instructions de compilation et les ressources de vérification indépendantes.
Pour les cinq résultats de Fable, je peux vérifier les déclarations d'Alpöge, les numéros de problèmes mentionnés, les conditions expérimentales décrites, ainsi que son observation sur l'argument d'Ehrhart.
Je ne peux pas vérifier un paquet public contenant :
Une description rigoureuse serait :
Un chercheur d'Anthropic rapporte publiquement que Fable 5 a réalisé de manière indépendante cinq des dix problèmes dans des conditions contrôlées, mais qu'au moment de la vérification, les preuves détaillées nécessaires à une évaluation indépendante complète n'avaient pas encore été rendues publiques.
Cela ne prouve pas que l'affirmation est fausse. Cela signifie qu'elle n'a pas encore atteint le même stade de preuve que le paquet publié par OpenAI.
Même avec les réserves ci-dessus, le calendrier mérite d'être noté.
En mathématiques traditionnelles, un résultat nouveau majeur peut prendre des mois, voire des années, pour être reconstruit de manière indépendante.
Les chercheurs doivent d'abord apprendre le contexte, lire le manuscrit, examiner les détails techniques, reconstruire l'argument, explorer des alternatives, discuter des problèmes et publier une revue ou un article de suivi.
Un modèle capable peut compresser certaines parties de ce processus.
Si le résultat d'un modèle peut être atteint indépendamment par un autre modèle en un jour, la fenêtre de priorité pour les découvertes générées par IA pourrait être considérablement réduite.
La première équipe mérite toujours des éloges pour avoir choisi les problèmes, proposé un premier argument public, préparé le manuscrit, formalisé le résultat et créé un enregistrement consultable par d'autres.
Cependant, lorsque d'autres chercheurs peuvent immédiatement confier des problèmes similaires à des systèmes de pointe, l'avantage du premier arrivé ne dure peut-être que quelques jours, et non des années.
La plupart des références de modèles comparent des systèmes sur des problèmes dont les réponses sont connues.
La référence demande :
Étant donné le même ensemble de test, quel modèle obtient un score plus élevé ?
Cet ensemble pose une question différente :
Deux systèmes peuvent-ils parvenir indépendamment au même résultat nouveau de pointe ?
Cela s'apparente à une reproduction scientifique.
Une reproduction indépendante peut révéler si un résultat dépend d'une erreur d'un seul modèle, d'un prompt fragile, d'une fuite d'informations ou d'un chemin de preuve inhabituel.
Deux arguments indépendants peuvent renforcer la confiance, surtout lorsqu'ils empruntent des voies différentes.
Mais ils doivent encore être examinés.
Deux modèles peuvent partager des sources d'entraînement similaires, des malentendus mathématiques, des biais d'optimisation ou des hypothèses implicites.
L'indépendance des modèles n'implique pas automatiquement l'indépendance cognitive.
Un paquet de reproduction crédible devrait divulguer suffisamment d'informations pour permettre à d'autres de répéter l'expérience.
Accès réseau et accès à la recherche.
Documents sources inclus dans le contexte.
Horodatage de la capture du modèle.
Méthode utilisée pour détecter un langage ou une structure copiés.
Sans ces informations, une « reproduction indépendante » reste difficile à distinguer d’un rapport préliminaire prometteur.
Anthropic a publié Claude Fable 5 en juin 2026.
Anthropic le décrit comme un modèle de niveau Mythos destiné au grand public, avec des garanties de sécurité.
Selon l’entreprise, ce modèle excelle particulièrement dans le travail autonome de longue durée, le génie logiciel, le travail du savoir, la vision, la recherche scientifique et les tâches à long contexte.
L’identifiant officiel du modèle dans l’API est :
claude-fable-5
Les tarifs annoncés par Anthropic sont les suivants :
10 dollars par million de jetons en entrée
50 dollars par million de jetons en sortie
La publication publique de Fable est étroitement liée à l’histoire des mathématiques.
Astra reste un modèle interne d’OpenAI non publié.
Fable est accessible aux chercheurs et aux développeurs via les produits et l’API pris en charge par Anthropic.
Cela permet aux équipes externes de tester plus facilement leurs propres questions de recherche, même si l’accès au modèle ne garantit pas l’expertise nécessaire pour bien choisir les problèmes ni valider les résultats.
OpenAI indique que le nombre total de jetons nécessaires pour trouver ces dix solutions, aux tarifs de l’API Sol, s’élève à environ 2 000 dollars.

Ce chiffre est frappant, mais il nécessite une étiquette précise.
Il faut le comprendre comme une estimation du coût en jetons des solutions trouvées avec succès.
Il ne s’agit pas du coût économique total du projet de recherche.
La pile de coûts plus large peut comprendre :
OpenAI indique avoir tenté d’autres grands problèmes sans succès, et n’avoir résolu aucun problème du prix du millénaire.
Par conséquent, cette estimation de 2 000 dollars répond à la question :
Quel est le coût en jetons d’une recherche réussie, aux tarifs publics de l’API ?
Elle ne répond pas à la question :
Quel est le coût de création du modèle et de génération, validation et publication des résultats de recherche ?
Ces deux chiffres sont utiles, mais ils mesurent des choses différentes.
Même en tenant compte des coûts indirects, le faible coût marginal d’une nouvelle tentative sérieuse peut modifier la manière dont la recherche est menée.
Un mathématicien humain peut passer des semaines à décider si une voie mérite d’être explorée.
Un système d’IA peut être invité à explorer de nombreuses voies en parallèle.
Les chercheurs pourraient utiliser le modèle pour :
Cet effet pourrait ressembler aux expériences à haut débit dans d’autres sciences.
Lorsque le coût de test d’une hypothèse supplémentaire diminue, le nombre d’hypothèses testées augmente.
La ressource rare devient alors la sélection de problèmes prometteurs et l’évaluation du flot de candidats qui en découle.
Une comptabilité ne portant que sur les réussites peut donner une image trompeuse.
Supposons qu’un système se voie attribuer 100 problèmes ouverts et en résolve 10.
Si l’objectif est de mesurer l’économie d’un projet de recherche complet, le coût de chaque solution réussie devrait inclure les ressources consacrées aux 90 échecs.
Une comptabilité complète devrait rapporter :
Coût total d’inférence
÷
Nombre de résultats validés
Elle devrait distinguer les exécutions finales réussies, les exécutions complètes échouées, les progrès partiels, les redémarrages guidés par l’humain, les candidats parallèles et les coûts de validation.
Sans ce dénominateur, un chiffre faible peut décrire uniquement les succès sélectionnés, et non l’économie du processus de découverte dans son ensemble.
Une critique directe du travail de reproduction est la suivante :
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Pourquoi faire refaire à Fable les résultats d’Astra, plutôt que lui confier de nouveaux problèmes ouverts ?
La reproduction et la découverte servent des objectifs différents.
La reproduction teste la fiabilité.
La résolution de nouveaux problèmes teste les capacités de pointe.
Fable a également été associé
à un nouveau résultat mathématique.
En juillet 2026, Alpöge a rapporté un contre-exemple à la conjecture de Jacobi en dimension trois, en attribuant à Fable un rôle dans le processus de découverte.
Ce contre-exemple a été vérifié formellement, discuté par les mathématiciens, puis suivi de travaux ultérieurs. Un article publié sur arXiv fin juillet présente une exposition complète et cohérente et généralise le mécanisme à des dimensions supérieures.
Cet événement révèle un schéma récurrent :
C’est peut-être dans cette dernière étape que réside l’essentiel de la valeur mathématique durable.
Un contre-exemple explicite peut parfois être vérifié rapidement.
Si une conjecture prétend qu’aucun objet possédant certaines propriétés n’existe, alors un objet valide suffit à la réfuter.
Le relecteur peut vérifier :
Un long théorème général peut en revanche exiger des centaines de lemmes interconnectés et une large compréhension de la littérature.
Cette différence explique en partie pourquoi les contre-exemples générés par IA peuvent se diffuser rapidement.
L’exemple jacobien est suffisamment compact pour que les chercheurs puissent le vérifier et le formaliser rapidement.
Certains des dix résultats d’Astra impliquent des chaînes théoriques plus longues, qui pourraient demander plus de temps à la communauté pour être digérées.
La question centrale est la suivante :
Si l’IA peut générer rapidement des preuves de pointe, la communauté mathématique peut-elle les vérifier assez rapidement ?
Une production de recherche doit obtenir plusieurs formes de reconnaissance.
La preuve découle-t-elle effectivement des hypothèses ?
Lean peut aider ici.
La formulation formelle correspond-elle au sens que l’auteur prétend ?
Des experts doivent examiner cette traduction.
Le problème était-il effectivement non résolu et le résultat est-il nouveau ?
Cela exige une connaissance de la littérature.
La preuve révèle-t-elle une idée nouvelle, ou confirme-t-elle seulement un fait ?
Cela exige un jugement mathématique.
Le travail a-t-il été relu, discuté, corrigé et replacé dans un contexte approprié ?
Cela exige du temps et des processus institutionnels.
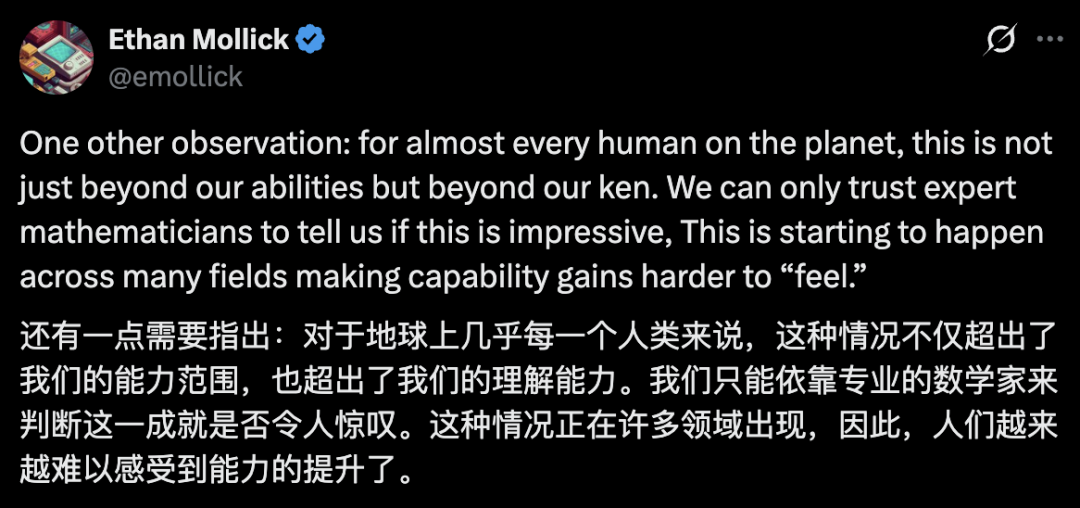
L’IA accélère la génération de preuves beaucoup plus vite que les universités et les revues n’augmentent le nombre d’experts capables de relire des travaux hautement spécialisés.
Un modèle de programmation puissant peut être testé en lui demandant de construire une application.
Un modèle d’image puissant peut être jugé visuellement.
Les mathématiques de pointe sont différentes.
La plupart des lecteurs ne peuvent pas évaluer personnellement l’existence de groupes non sofiques, un contre-exemple à la conjecture de rigidité de Connes, le théorème de répétition parallèle pour les jeux d’intrication ou la difficulté sur les réseaux.
Ils dépendent d’une chaîne de confiance :
Sortie du modèle
→ Certificat formel
→ Assistant de preuve et ses bibliothèques
→ Experts du domaine
→ Relecteurs indépendants
→ Revues et communauté de recherche
Cela rend la transparence plus importante, et non moins.
Lorsque le public ne peut pas vérifier directement une capacité, la confiance
doit venir de preuves et d’institutions.
Décrire cet événement comme une substitution isolée des mathématiques par l'IA serait trompeur.
Ces modèles dépendent de :
Le certificat Lean d'Astra est possible parce qu'une immense communauté a consacré des années à formaliser les fondements des mathématiques et à construire des bibliothèques réutilisables.
Les réalisations du modèle sont réelles.
L'infrastructure humaine qui les soutient est tout aussi réelle.
Une description plus honnête serait :
Les modèles de pointe deviennent des acteurs puissants au sein d'un système de connaissances mathématiques construit et maintenu par l'humain.
Une preuve peut être correcte sans être éclairante.
Les mathématiciens valorisent souvent un résultat parce qu'il introduit de nouveaux invariants, des constructions, des méthodes réutilisables, des liens entre domaines, des explications plus élégantes ou de meilleures questions.
Lorsqu'une IA génère une preuve longue, l'examinateur peut se demander :
C'est là que réside la différence entre vérifier un théorème et l'intégrer aux mathématiques humaines.
Le nombre de résultats corrects importe.
La capacité à transformer ces résultats en compréhension est peut-être encore plus importante.
Si la recherche de preuves devient moins coûteuse, le choix des problèmes pourrait devenir une part plus importante de l'avantage en recherche.
Les décisions les plus difficiles pourraient être :
Ce sont des questions de goût mathématique.
Les modèles peuvent aider à générer des problèmes, mais l'écosystème de recherche actuel repose encore largement sur des experts pour juger quels problèmes sont significatifs.
L'évaluation par les pairs traditionnelle suppose un nombre relativement limité de soumissions.
L'IA pourrait produire bien plus de résultats candidats que ce que les revues existantes peuvent traiter.
Le processus d'évaluation pourrait nécessiter de nouvelles couches.
Chaque résultat susceptible d'être formalisé devrait être accompagné d'un certificat vérifiable par machine.
Les invites, versions de modèles, accès aux outils et conditions d'exécution devraient être archivés.
Les systèmes devraient comparer les nouvelles affirmations avec les bases de données d'articles et de théorèmes.
Différents modèles ou équipes de recherche pourraient tenter de résoudre le même problème sans consulter la preuve proposée.
Les experts identifient les résultats qui méritent un examen approfondi.
Les preuves correctes sont converties en formes que les humains peuvent apprendre.
Des dépôts ouverts permettent d'enregistrer en continu les erreurs, simplifications et arguments alternatifs.
Cela ne remplace ni les revues ni les experts, mais leur fournit de meilleurs outils pour traiter des charges de travail à plus grande échelle.
La Déclaration de Leyde sur l'IA et les mathématiques appelle à une utilisation responsable de l'IA dans la recherche mathématique.
Ses préoccupations incluent :
La publication d'OpenAI répond à certains de ces points avec une franchise inhabituelle.
Elle attribue les arguments mathématiques au modèle, précise le rôle humain dans la préparation du manuscrit, publie des certificats formels et invite la communauté à l'évaluation.
Les questions qui demeurent :
Ces questions ne sont plus des sujets de politique hypothétiques.
Elles s'appliquent désormais à de véritables résultats de recherche.
Distinguer :
Rechercher les hypothèses cachées, les raisonnements circulaires, les transitions non expliquées, les citations erronées, les changements de portée et les notations ambiguës.
Confirmer que le théorème Lean exprime fidèlement le contenu mathématique prévu.
Pour le dépôt d'OpenAI :
git clone https://github.com/openai/ten-proofs.git
cd ten-proofs
lake exe cache get
lake build All
Examiner les modules importés, les axiomes, les espaces réservés, les déclarations non sûres, les définitions personnalisées et le code externe de confiance.
La preuve formelle peut établir le théorème par une voie différente de celle du manuscrit.
Confier l'énoncé du théorème — sans la preuve proposée — à un autre modèle ou à une autre équipe de recherche.
Confirmer la nouveauté et identifier les travaux se chevauchant.
Un résultat correct devrait être suivi de questions conceptuelles :
Si Alpöge ou Anthropic publiait ce qui suit, cette affirmation serait considérablement renforcée :
Le résultat le plus intéressant ne consiste pas nécessairement en cinq preuves identiques.
Quatre arguments véritablement différents pourraient être plus précieux, car ils pourraient révéler des structures alternatives sous-jacentes aux mêmes résultats.
OpenAI a rendu public :
Cela ne remplace pas l'évaluation par les pairs.
Mais cela crée un dossier de recherche sérieux et vérifiable.
La responsabilité est passée de « montrez-nous les preuves » à « évaluez un corpus important de preuves ».
Les réponses rapportées dans la fable indiquent que les capacités de recherche de pointe pourraient se diffuser plus rapidement que la publication des modèles.
Une entreprise peut garder un modèle privé.
Mais elle ne peut pas supposer que les résultats mathématiques produits par ce modèle resteront exclusifs longtemps après leur publication.
Dès que l'énoncé d'un théorème est public, d'autres systèmes compétents peuvent immédiatement s'y attaquer.
Par conséquent, les organisations pourraient choisir de publier rapidement des preuves complètes, de formaliser avant l'annonce, d'inviter à des reproductions indépendantes et de coordonner avec des experts du domaine avant la divulgation publique.
La priorité reste importante.
Le dossier de preuves entourant une revendication de priorité peut être tout aussi important.
OpenAI a publié dix résultats en mathématiques et en informatique théorique, couvrant l'empilement de sphères, la théorie des codes, les groupes non sofiques, la conjecture de rigidité de Connes, les circuits arithmétiques, la répétition parallèle quantique, la difficulté des réseaux euclidiens, la conjecture du volume d'Ehrhart, les nombres de Ramsey et la théorie des graphes extrémale. OpenAI les présente comme des résultats qui résolvent ou font progresser considérablement des problèmes ouverts de longue date.
Non. OpenAI décrit Astra comme une version interne de son prochain modèle majeur. Les articles, les décompositions pas à pas du raisonnement et les certificats Lean sont publics, mais le modèle Astra utilisé pour générer les démonstrations n'a pas été publié.
Le chercheur d'Anthropic, Levent Alpöge, a déclaré publiquement que Fable avait résolu les problèmes 4 à 8 en 24 heures dans des conditions autonomes et hors ligne. Lors du processus de vérification, les manuscrits complets, journaux, invites et certificats Lean de ces cinq exécutions n'ont pas été trouvés publiquement ; cette affirmation doit donc être considérée comme préliminaire tant que ces preuves plus complètes n'ont pas été publiées.
Alpöge a confirmé la conjecture de rigidité de Connes, la complexité des circuits arithmétiques, la répétition parallèle quantique, le problème du vecteur le plus proche et la conjecture du volume d'Ehrhart. Il a indiqué que le résultat d'Ehrhart semblait utiliser essentiellement les mêmes arguments qu'Astra, tandis que les quatre autres résultats pourraient différer.
OpenAI a publié des preuves formelles Lean 4 pour les dix résultats, accompagnées d'instructions de compilation et de ressources de vérification indépendante. Les certificats Lean compilés permettent de vérifier les théorèmes formalisés, mais les experts doivent encore confirmer que les énoncés encodés correspondent fidèlement aux affirmations mathématiques attendues.
OpenAI indique qu'au tarif de l'API Sol, les jetons nécessaires pour trouver des solutions réussies ont coûté environ 2 000 dollars. Cette estimation n'inclut pas l'entraînement du modèle, les tentatives de recherche infructueuses, le travail de rédaction humaine, les infrastructures, la vérification formelle ni l'examen mathématique externe.
Les certificats Lean permettent à un petit noyau de confiance de vérifier mécaniquement qu'un théorème formalisé découle bien de ses hypothèses et dépendances. Ils réduisent le risque de lacunes logiques cachées, mais ne confirment ni la nouveauté, ni l'importance, ni la fidélité de la traduction mathématique informelle.
Les preuves actuelles suggèrent une transformation de la pratique des mathématiques plutôt qu'un simple remplacement. Les modèles peuvent accélérer la recherche, la génération de preuves, la découverte de contre-exemples et la formalisation, tandis que les humains restent indispensables pour le choix des problèmes, l'interprétation, le contexte bibliographique, l'examen critique et la transformation des preuves en compréhension.
OpenAI a publié un ensemble de recherche exceptionnellement complet couvrant dix avancées générées par Astra : un manuscrit de 249 pages, des explications détaillées du processus de découverte, et dix preuves formelles Lean reconstruisibles par des chercheurs externes.
Claude Fable 5 aurait résolu cinq de ces problèmes en 24 heures, ce qui pourrait représenter un nouveau type de réplication assistée par modèle. Cette affirmation est significative, mais ses preuves publiques sont actuellement moins complètes que les manuscrits et certificats formels fournis par OpenAI, et doit donc être clairement marquée comme une conclusion en attente de vérification.
L'estimation de 2 000 dollars doit être comprise au mieux comme le coût en jetons d'une recherche réussie de solutions au tarif de l'API Sol, et non comme le coût total de l'ensemble du projet de recherche. L'entraînement, les tentatives infructueuses, la préparation humaine, la formalisation, les infrastructures et l'examen critique restent des coûts économiques réels.
Le changement majeur réside dans le passage d'une « rareté des preuves » à une « rareté de l'examen critique ». Les modèles pourraient bientôt générer des affirmations mathématiques plus rapidement que les experts ne peuvent les vérifier, les expliquer et les replacer dans leur contexte.
Lorsque les preuves deviennent abondantes et peu coûteuses, le travail le plus précieux consiste peut-être à déterminer lesquelles sont correctes, significatives, nouvelles et dignes d'être comprises.
Partez d’une phrase et obtenez un site complet en quelques minutes.



