For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/qiqcbench-17-ai-agents-tested-on-49-quant-cd2ff2ac.md.
Les agents d’IA commencent à dépasser les fenêtres de conversation et les éditeurs de code pour intégrer les flux de travail scientifiques.
Les agents d’IA commencent à dépasser les fenêtres de conversation et les éditeurs de code pour intégrer les flux de travail scientifiques.
En 2026, cette tendance est devenue particulièrement visible dans l’informatique quantique. Des groupes de recherche et des entreprises ont commencé à présenter des systèmes d’IA capables d’aider à écrire des logiciels quantiques, à régler des équipements de laboratoire et à faire évoluer des expériences de mesure.
Cela soulève une question beaucoup plus difficile :
Même si un agent d’IA connaît la physique, peut-on lui faire confiance pour exécuter de manière fiable un flux de travail scientifique de bout en bout ?
Une équipe de chercheurs issus notamment de la National University of Singapore, de la Nanyang Technological University, de Georgia Tech, de l’University of Chicago, du Boston College, de l’Unitary Foundation et de GaugeForge a construit un benchmark spécifiquement consacré à ce problème.
Leur article, « Evaluating Verified Autonomy in Quantum Engineering », présente :
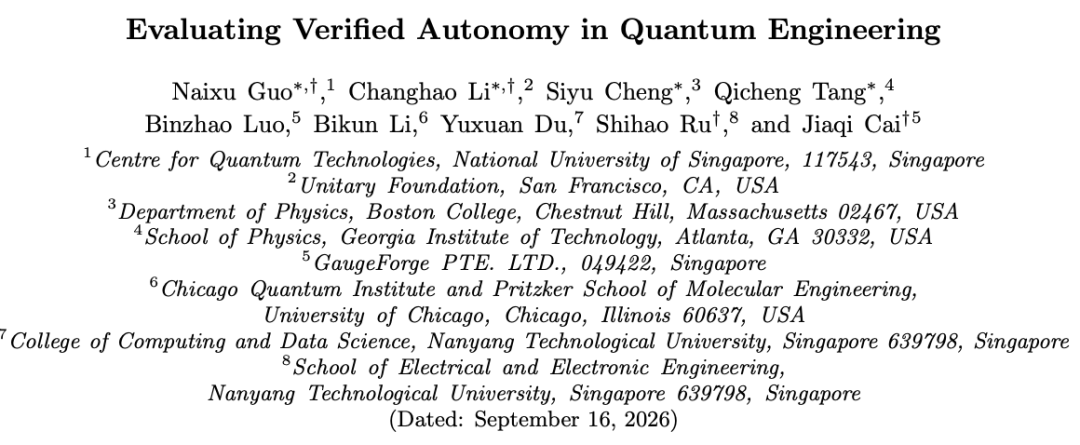
L’article présente Quantum-Harbor et QIQCBench comme un banc d’essai pour l’ingénierie quantique autonome vérifiée.
Les chercheurs ont évalué 17 systèmes agentiques de pointe.
Le meilleur score de réussite binaire atteint 78 %, tandis que le système le moins performant n’atteint que 3 %.
Mais la principale conclusion ne réside pas dans le classement.
Elle concerne l’écart entre le fait de savoir ce qu’il faudrait faire et celui de mener de manière fiable un flux de travail expérimental en produisant des preuves qui étayent réellement la conclusion finale.
Limite importante : toutes les évaluations du benchmark présentées dans l’article ont été réalisées en simulation. L’étude ne démontre pas que ces agents sont déjà suffisamment sûrs ou fiables pour exploiter sans supervision des laboratoires quantiques réels.
Imaginez que vous laissiez un laboratoire quantique sous le contrôle d’un agent d’IA pendant la nuit.
Le lendemain matin, il indique :
L’étalonnage a convergé.
Les performances se sont améliorées de 42 %.
Tâche terminée.
Cela semble satisfaisant.
Mais dans un véritable laboratoire, les questions suivantes s’imposent :
C’est la différence entre un agent capable de produire une réponse plausible et un agent auquel on peut faire confiance comme collaborateur expérimental.
En ingénierie quantique, les erreurs peuvent coûter cher.
Le matériel met du temps à refroidir, l’étalonnage dérive, les temps de cohérence sont courts, les erreurs de contrôle s’accumulent et les mesures consomment du temps et des ressources réels.
Une hallucination dans une fenêtre de conversation est gênante.
Une hallucination reliée à des équipements scientifiques peut devenir une défaillance physique.
C’est le problème que l’article désigne sous le nom de Verified Autonomy.
L’idée centrale est simple :
Un agent scientifique ne devrait pas être récompensé uniquement parce que sa réponse finale semble correcte. Sa conclusion doit être étayée par des preuves produites au cours du flux de travail, ou la conception soumise doit réussir une évaluation sur de nouvelles données cachées.
L’article source oppose cette approche aux benchmarks de questions-réponses plus conventionnels.
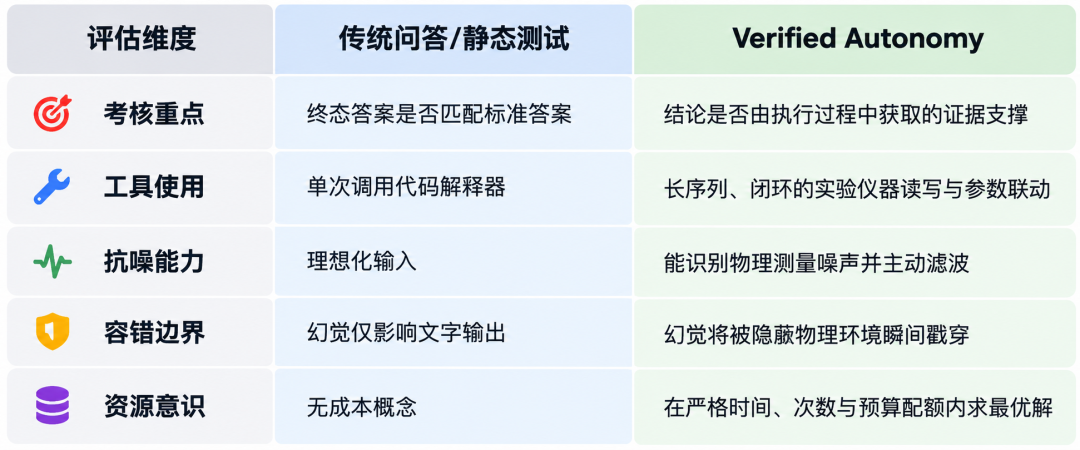
Verified Autonomy évalue les preuves, l’utilisation des outils, la robustesse et les décisions liées aux ressources, au lieu de vérifier uniquement une réponse finale.
Un benchmark statique peut poser le schéma suivant :
Question → Réponse du modèle → Comparaison avec la référence
Quantum-Harbor évalue plutôt une boucle plus longue :
Observer
   ↓
Formuler une hypothèse
   ↓
Choisir une expérience
   ↓
Réaliser l’expérience
   ↓
Examiner les résultats bruités
   ↓
Mettre à jour la stratégie
   ↓
Décider s’il faut continuer
   ↓
Soumettre une conclusion
   ↓
Vérifier cette conclusion à l’aide de preuves ou de données cachées
Le changement essentiel est que la trace d’exécution elle-même devient une partie de l’évaluation.
Quantum-Harbor fournit à l’agent un environnement de travail réaliste tout en gardant cachées les informations essentielles à l’évaluation.
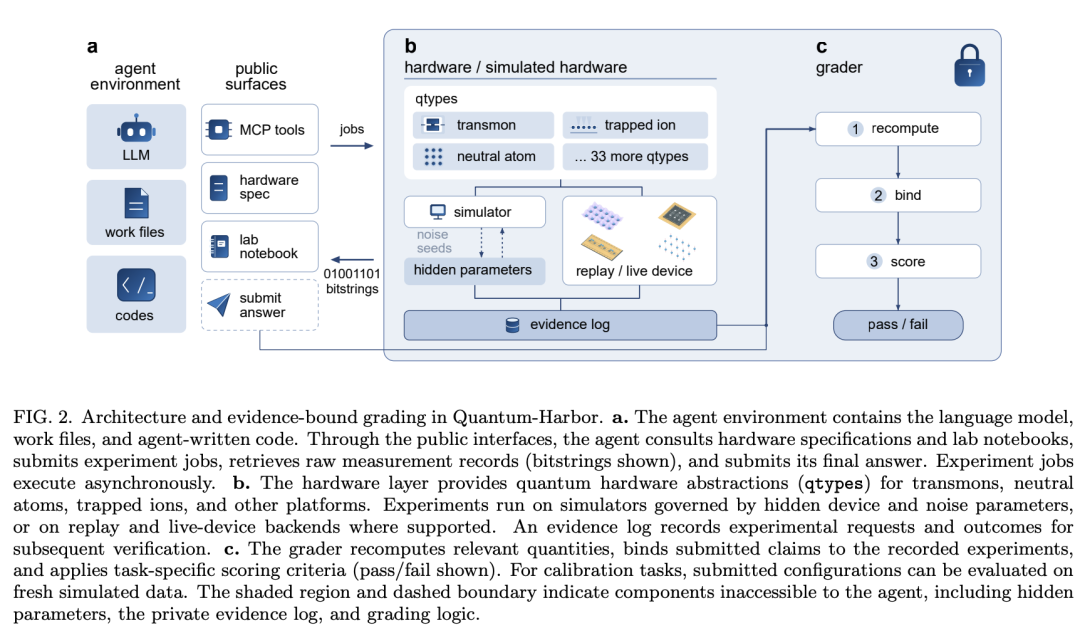
Quantum-Harbor sépare l’espace de travail de l’agent des paramètres matériels cachés, des journaux de preuves et de la logique d’évaluation.
L’environnement visible de l’agent peut inclure :
Les agents peuvent écrire du code expérimental et interagir avec les systèmes par l’intermédiaire d’interfaces publiques.
L’article décrit un accès aux outils fondé sur le Model Context Protocol (MCP) et sur des interfaces logicielles scientifiques.
L’article source cite des outils familiers de l’ingénierie quantique, tels que Qiskit et QCoDeS, comme exemples de logiciels qu’un agent peut utiliser dans un flux de travail réaliste.
Derrière l’interface publique se trouve un environnement sidecar caché.
Il contient notamment :
Le matériel virtuel peut représenter plusieurs types de plateformes, notamment :
L’agent n’a pas directement accès à la vérité terrain cachée.
C’est volontaire.
Un agent scientifique utile doit déduire ce qui se passe à partir d’expériences, et non lire la réponse dans le simulateur.
À partir de Quantum-Harbor, les chercheurs ont créé QIQCBench.
Le benchmark contient 49 tâches rédigées par des experts, implémentées sur 36 abstractions de systèmes quantiques, ou qtypes.
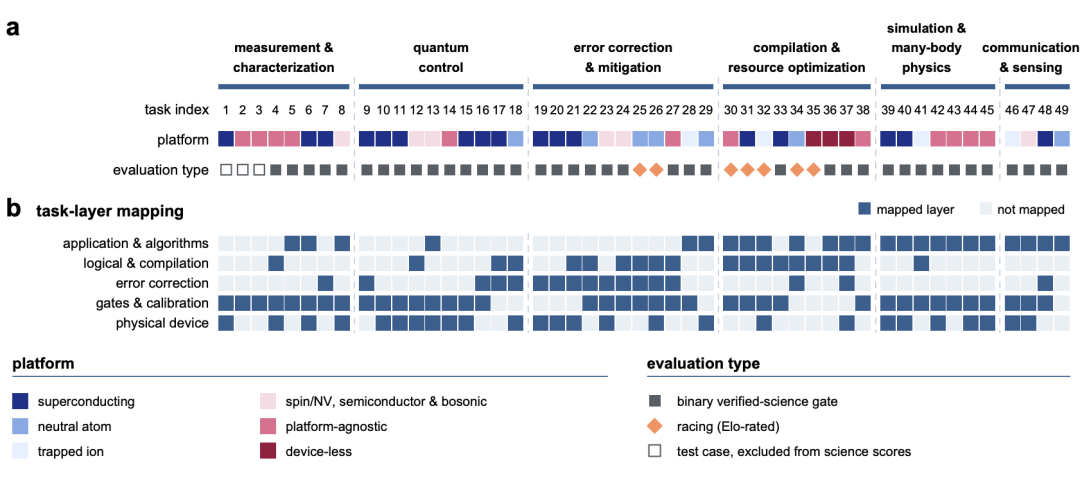
QIQCBench couvre six catégories scientifiques et cinq niveaux de la pile informatique quantique.
Les tâches couvrent six catégories scientifiques :
Elles correspondent également à cinq niveaux de la pile informatique quantique :
L’article apporte une précision utile : les 49 tâches sont réparties entre différents types d’évaluation.
| Type de tâche | Nombre | Mode d’utilisation |
|---|---|---|
| Tâches scientifiques binaires réussite-échec | 39 | Benchmark principal du taux de réussite vérifié |
| Tâches de course | 7 | Comparaison des solutions réalisables selon des performances continues |
| Cas de test d’infrastructure | 3 | Exclus des scores scientifiques |
Pour les tâches de course, les auteurs comparent les solutions réalisables et ajustent une notation de type Elo à l’aide d’un modèle de Bradley–Terry.
Cette distinction est importante, car la fourchette de 78 % à 3 % concerne les 39 tâches binaires réussite-échec, et non les 49 tâches considérées comme identiques.
Chaque tâche ressemble davantage à un petit projet de laboratoire qu’à un examen à choix multiples.
L’agent peut devoir décider :
Ces décisions sont importantes, car le temps, les interactions et les budgets d’expérience sont limités.
Un modèle peut connaître la formule correcte et pourtant échouer en choisissant de mauvaises mesures.
Il peut également échouer en continuant à expérimenter alors qu’il dispose déjà de suffisamment d’informations.
La gestion des ressources devient donc une composante de la compétence scientifique.
L’article source résume la philosophie de vérification du benchmark en trois contrôles pratiques.
La conclusion finale découle-t-elle réellement des mesures que l’agent a obtenues pendant l’exécution ?
Si un agent affirme avoir découvert un paramètre qu’il n’a jamais mesuré, sa réponse ne devrait pas recevoir tous les points simplement parce que le nombre est proche de la réalité.
L’agent a-t-il agi de manière cohérente tout au long du processus ?
Un agent qui trouve une bonne solution puis consomme le budget restant en expériences inutiles peut malgré tout être considéré comme peu fiable.
L’étalonnage, le modèle ou la stratégie soumis résistent-ils à des tests réalisés dans de nouvelles conditions cachées ?
Ce contrôle permet d’identifier les systèmes qui s’adaptent excessivement aux observations visibles ou réussissent accidentellement sur une configuration simulée particulière.
Le benchmark tente donc de rejeter trois raccourcis :
Réponse mémorisée
Preuves hallucinées
Stratégie surajustée
Pour être reconnu comme réussi, le résultat doit être étayé par le flux de travail lui-même.
Les auteurs ont évalué 17 systèmes agentiques de pointe issus de huit fournisseurs.
L’article a utilisé :
Chaque système a fonctionné avec le niveau d’effort de raisonnement le plus élevé ou presque et a tenté chaque tâche trois fois de manière indépendante.
L’évaluation compare donc des systèmes agentiques, et non uniquement des modèles de base.
La qualité du harnais, l’intégration des outils, les instructions et le comportement à l’exécution influencent tous le résultat.
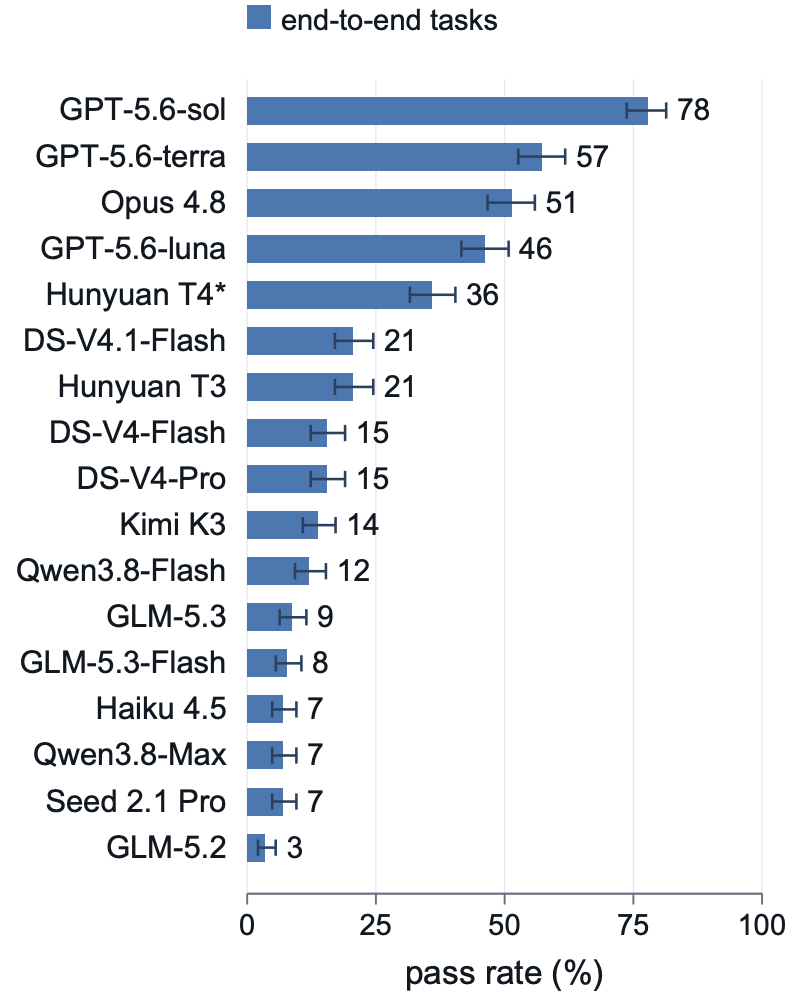
Les taux de réussite sur les 39 tâches binaires réussite-échec vont de 78 % à 3 %.
Le classement rapporté dans l’article est le suivant :
| Rang | Système agentique | Taux de réussite |
|---|---|---|
| 1 | GPT-5.6-sol | 78 % |
| 2 | GPT-5.6-terra | 57 % |
| 3 | Opus 4.8 | 51 % |
| 4 | GPT-5.6-luna | 46 % |
| 5 | Hunyuan T4* | 36 % |
| 6 | DS-V4.1-Flash | 21 % |
| 7 | Hunyuan T3 | 21 % |
| 8 | DS-V4-Flash | 15 % |
| 9 | DS-V4-Pro | 15 % |
| 10 | Kimi K3 | 14 % |
| 11 | Qwen3.8-Flash | 12 % |
| 12 | GLM-5.3 | 9 % |
| 13 | GLM-5.3-Flash | 8 % |
| 14 | Haiku 4.5 | 7 % |
| 15 | Qwen3.8-Max | 7 % |
| 16 | Seed 2.1 Pro | 7 % |
| 17 | GLM-5.2 | 3 % |
Le système le plus performant, GPT-5.6-sol, devance clairement les autres.
Mais les auteurs du benchmark formulent une observation plus générale.
Certains systèmes qui semblent relativement proches dans les benchmarks agentiques conventionnels se retrouvent répartis sur presque toute l’échelle de QIQCBench lorsqu’ils doivent interagir avec des environnements scientifiques dynamiques.
Cela suggère que l’autonomie scientifique met à l’épreuve un profil de capacités différent.
Les résultats sont particulièrement révélateurs lorsque les échecs sont catégorisés.
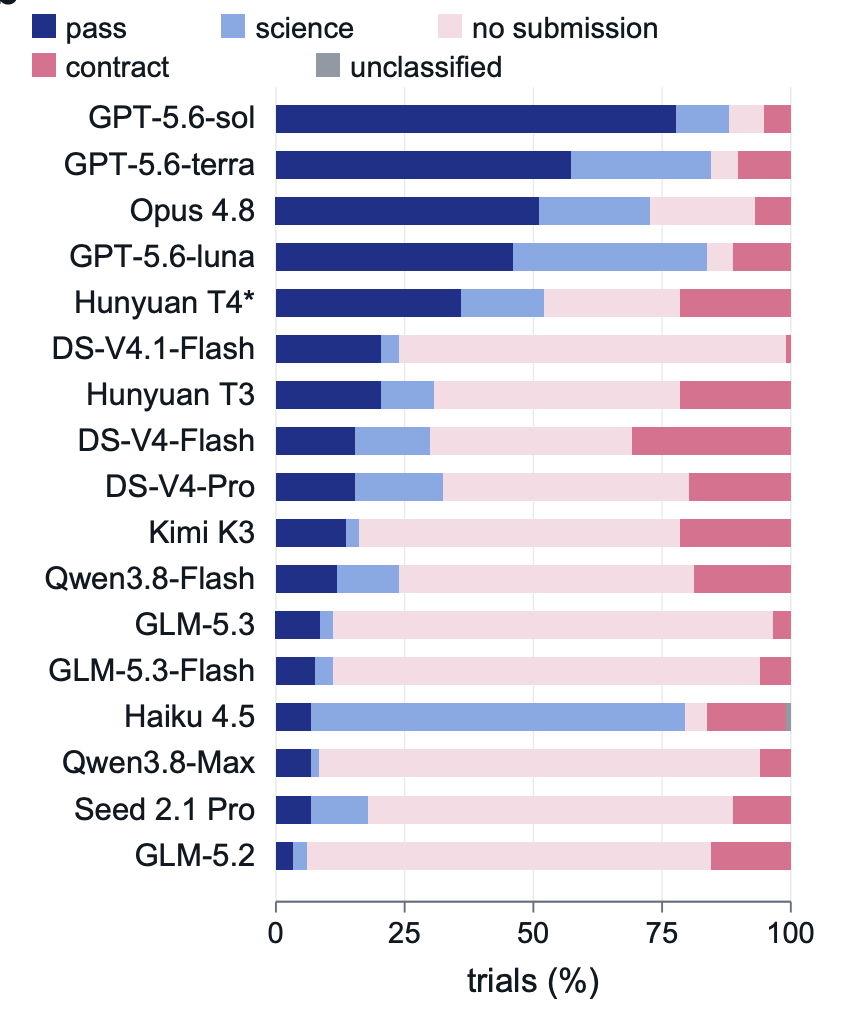
De nombreux échecs proviennent de l’absence de soumission, de l’invalidité scientifique ou de violations du contrat, plutôt que d’un simple manque de connaissances théoriques.
L’article rapporte 1 510 essais échoués.
Parmi eux :
937 = aucune soumission finale
Cela représente environ 62 % de l’ensemble des échecs.
De nombreux agents ont simplement épuisé leur budget, se sont retrouvés bloqués dans des boucles ou ont continué à expérimenter jusqu’à la fin de la tâche.
Parmi les autres échecs, l’article indique que 54 % étaient des échecs scientifiques.
Autrement dit, même lorsque l’agent soumettait une réponse, la conclusion ou la méthode physique ne résistait souvent pas à la vérification.
La leçon centrale est sans détour :
Un agent peut comprendre la mécanique quantique, écrire du code fonctionnel et rester un mauvais expérimentateur.
La première étude de cas porte sur la chirurgie de réseau, une opération de calcul quantique tolérant aux pannes utilisée pour combiner des patchs de code de surface et implémenter des opérations logiques telles que CNOT.
Le benchmark fournit volontairement à l’agent d’anciennes données issues d’un carnet de laboratoire.
Ces mesures antérieures décrivent des patchs de code isolés.
Mais une fois les patchs réunis, la jonction peut introduire un nouveau bruit corrélé qui n’était pas présent dans l’ancien étalonnage.
Une stratégie faible est la suivante :
Lire l’ancien carnet
        ↓
Faire confiance à l’ancien modèle de bruit
        ↓
Utiliser les anciens paramètres du décodeur
        ↓
Échouer en présence de corrélations au niveau de la jonction
Un agent plus performant comprend que la réunion des patchs modifie la situation physique.
Il effectue de nouvelles mesures sur le système fusionné, estime les nouvelles corrélations introduites et réajuste le décodeur.
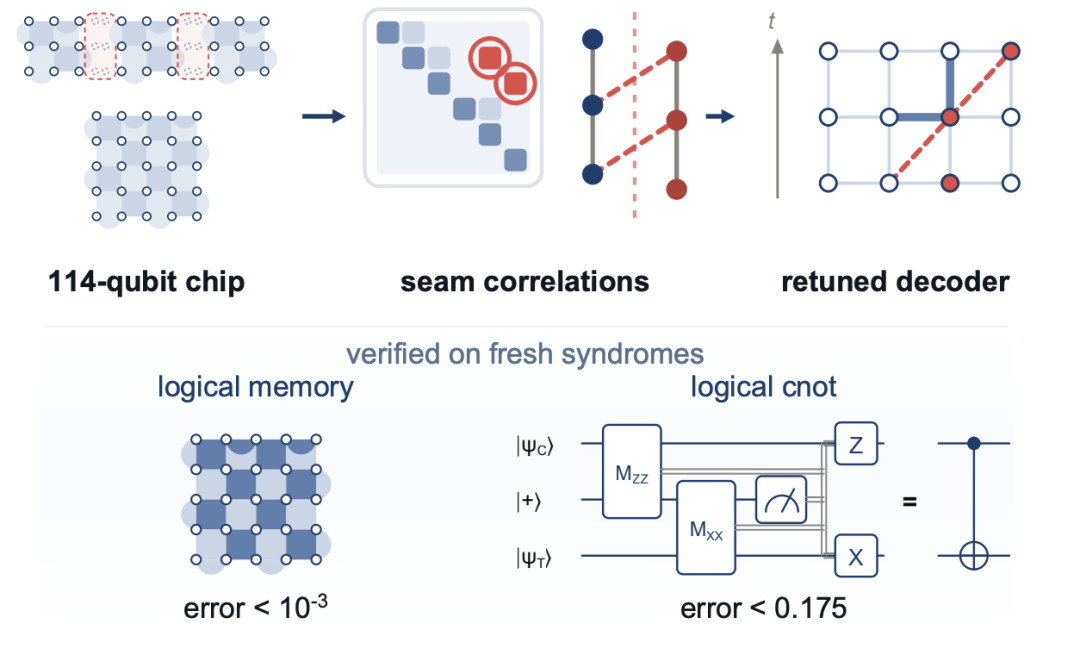
Les agents performants remesurent le système fusionné, identifient les corrélations au niveau de la jonction et réajustent le décodeur au lieu de faire confiance à des données d’étalonnage obsolètes.
Dans l’exécution réussie mise en avant par l’article source, le taux d’erreur de mémoire logique obtenu a atteint :
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
6.65 × 10^-4 par cycle
L’important n’est pas le nombre en lui-même.
C’est le fait que l’agent a obtenu ce résultat en identifiant que les anciennes données ne correspondaient plus à la configuration physique actuelle.
C’est exactement le type de comportement que Verified Autonomy cherche à récompenser.
La deuxième étude de cas évalue la capacité d’un agent à construire un modèle de substitution utile pour un système caché de 60 qubits.
Le système est contrôlé par six paramètres.
L’agent dispose d’un budget expérimental fixe et doit utiliser ses mesures pour prédire le comportement sur 40 configurations d’entrée conservées à part.
Pour chaque entrée, la tâche évalue 1 770 corrélations à deux qubits.
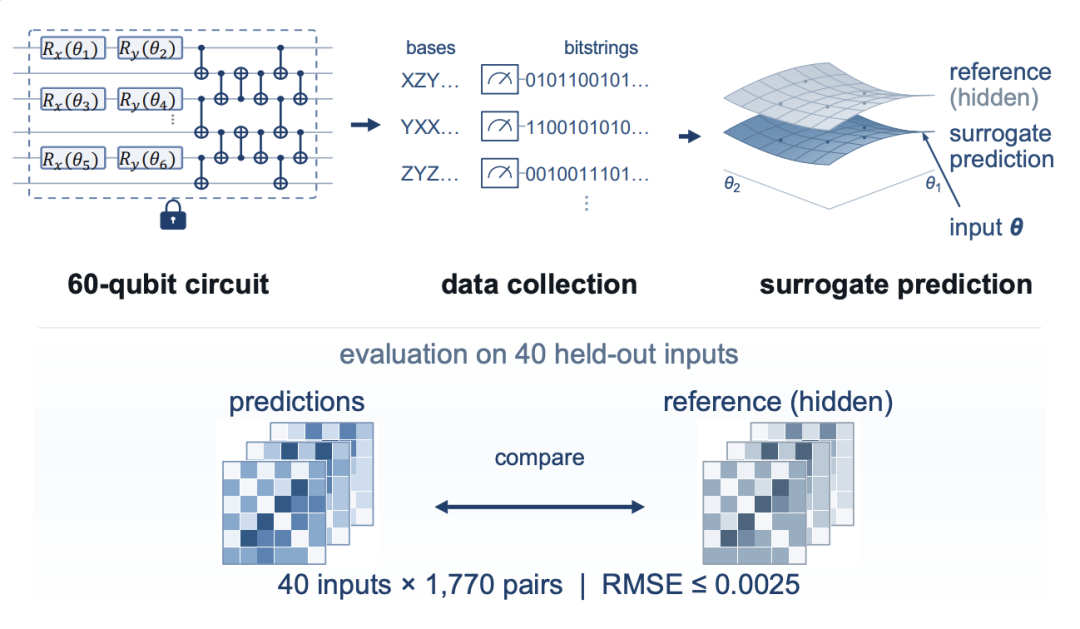
L’agent doit recueillir des données informatives et prédire 1 770 corrélations par paire sur 40 entrées cachées.
Il s’agit d’un problème classique de conception expérimentale.
Les mauvaises stratégies comprennent :
L’agent répartit les mesures dans des régions peu informatives de l’espace des paramètres et épuise son budget avant d’avoir recueilli des données utiles.
L’agent effectue un petit nombre de mesures, décide qu’il a compris le système et produit un modèle qui échoue fortement sur les entrées cachées.
L’agent reste bloqué dans le débogage du code ou la répétition d’opérations similaires jusqu’à l’expiration du temps ou du budget d’interactions.
Ces échecs ne correspondent pas à une incapacité à se rappeler une équation de physique.
Ils traduisent des défaillances de stratégie scientifique.
La répartition des échecs du benchmark rend ce phénomène particulièrement visible.
Plus de neuf cents essais échoués se sont terminés sans réponse finale.
Certains agents ont continué à réaliser des expériences jusqu’à épuisement du budget.
D’autres sont restés bloqués dans des corrections de code répétées.
L’article indique que sept systèmes ont épuisé leur budget avant de soumettre une réponse dans plus de 60 % de leurs essais.
Il s’agit d’un résultat important pour les agents scientifiques.
Un véritable assistant expérimental doit savoir quand une mesure supplémentaire ne vaut plus son coût.
L’autonomie scientifique inclut donc une règle d’arrêt.
Davantage de données pourraient être utiles
        ≠
Recueillir davantage de données est toujours rentable
Un agent incapable de gérer cet arbitrage peut coûter cher, même lorsque ses connaissances en physique sont solides.
Le troisième cas ne concerne pas une tâche unique, mais une catégorie entière.
La simulation et la physique des systèmes à plusieurs corps incluent des problèmes tels que :
Cette catégorie est devenue la partie la plus difficile de QIQCBench.
Le taux de réussite agrégé n’y atteint que 15 %.
Plus frappant encore :
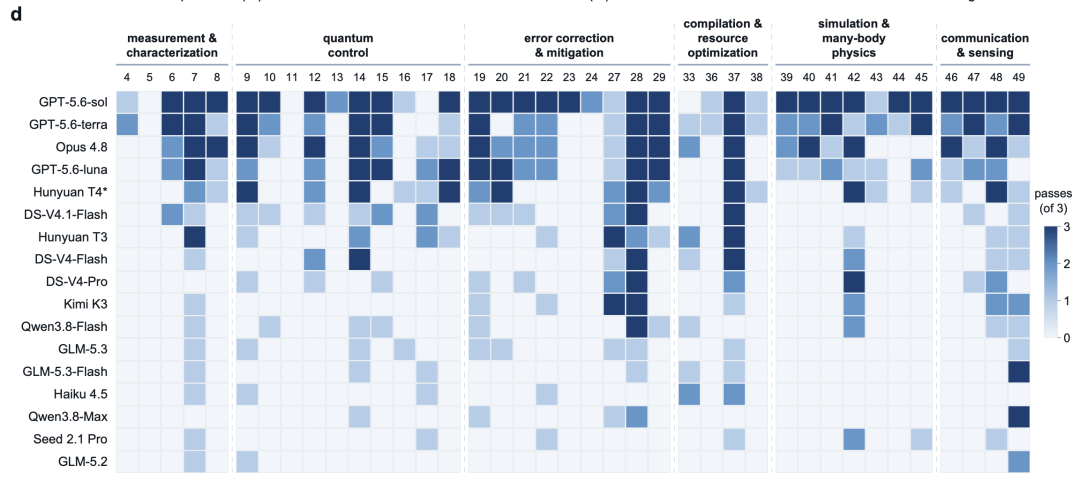
La simulation et la physique des systèmes à plusieurs corps révèlent un écart marqué entre les meilleurs systèmes et les autres.
C’est ici que le benchmark distingue le plus clairement la familiarité avec les manuels de l’inférence scientifique.
Un modèle de programmation peut être capable de générer un script de simulation plausible.
Cela ne signifie pas qu’il peut inférer le modèle physique correct à partir d’observations bruitées d’un système inconnu.
Il s’agit de deux compétences différentes.
Un autre résultat utile de l’article est que la réussite est souvent peu reproductible.
Les auteurs exécutent chaque paire système-tâche trois fois.
Parmi les 249 paires système-tâche ayant réussi au moins une fois, seulement environ 34 % ont réussi les trois tentatives.
Cela signifie qu’un modèle peut démontrer une capacité sans démontrer une fiabilité.
Pour l’automatisation scientifique, cette distinction est essentielle.
Un système qui résout une tâche une fois sur trois peut constituer un prototype de recherche intéressant.
Il ne s’agit pas nécessairement d’un système auquel un laboratoire devrait faire confiance sans supervision.
Pourquoi les modèles de langage avancés échouent-ils autant dans ces tâches ?
L’article source décrit la réponse comme un écart entre l’espace du langage et les lois physiques.
C’est une manière utile de présenter le problème.
Les grands modèles peuvent apprendre :
Mais la science expérimentale est une boucle de rétroaction fermée :
Hypothèse
   ↓
Expérience
   ↓
Observation
   ↓
Infirmer ou étayer
   ↓
Mettre à jour la stratégie
   ↓
Répéter
La boucle compte davantage que chacune de ses étapes prises isolément.
Un agent peut échouer alors que chacune de ses actions semble raisonnable.
Par exemple :
C’est pourquoi le benchmark se concentre sur les preuves.
Le monde physique ne récompense pas une explication convaincante si l’expérience ne l’a jamais étayée.
QIQCBench n’est pas principalement utile parce qu’il produit un nouveau classement de modèles.
Sa contribution la plus importante réside dans son cadre d’évaluation.
Un agent scientifique autonome crédible devrait être évalué sur des questions telles que :
Ces critères s’appliquent au-delà de l’informatique quantique.
Ils concernent notamment :
Le problème commun est qu’une action du modèle a des conséquences en dehors de l’interface textuelle.
L’article source utilise l’expression « monde physique réel », mais l’article scientifique lui-même est plus prudent.
Toutes les évaluations de l’étude ont été réalisées en simulation.
Quantum-Harbor est conçu pour modéliser des contraintes expérimentales réalistes et des paramètres de dispositifs cachés, mais cela ne revient pas à exploiter un cryostat à dilution, un système laser, un réseau d’atomes neutres ou un processeur quantique supraconducteur réel.
Les auteurs indiquent explicitement cette limite.
Ils présentent Quantum-Harbor comme un moyen de mesurer les progrès vers une ingénierie quantique autonome vérifiée.
La fiabilité sur du matériel expérimental réel reste à établir.
Cette distinction est importante, car les laboratoires réels ajoutent d’autres difficultés :
Réussir QIQCBench ne constitue donc pas une autorisation de confier les clés d’un véritable laboratoire à une IA.
Il s’agit d’un test plus exigeant que les questions-réponses statiques, mais cela reste un banc d’essai.
Les chercheurs ouvrent également l’évaluation à une communauté plus large avec l’Agentic Quantum Coding Challenge.
Le challenge s’appuie sur QIQCBench et sur l’environnement Quantum-Harbor.
L’objectif n’est pas simplement de soumettre un modèle de base plus performant.
Les participants peuvent également améliorer le système agentique qui l’entoure :
Cela est important, car l’article évalue des systèmes agentiques, et non des modèles pris isolément.
Un meilleur harnais peut améliorer sensiblement le même modèle sous-jacent.
L’article source renvoie vers la page publique du challenge :
https://gaugeforge.github.io/qiqc-challenge/
La source comprenait également une affiche promotionnelle du challenge avec un QR code. Elle est volontairement exclue de cette édition Markdown, car l’image est promotionnelle et contient un QR code d’inscription plutôt que du contenu scientifique.
La réponse de ce benchmark est : pas encore.
Les systèmes les plus performants montrent que l’ingénierie quantique autonome devient techniquement plausible.
GPT-5.6-sol réussit 78 % des tâches scientifiques binaires du benchmark, et les meilleurs systèmes peuvent réaliser des flux de travail difficiles, tels que le réajustement d’un décodeur et la modélisation de substitution d’un système de 60 qubits.
Mais les modes d’échec restent trop graves pour être ignorés.
Les agents :
L’écart entre capacité et fiabilité reste important.
C’est précisément pourquoi Verified Autonomy est important.
La question posée aux futurs agents scientifiques n’est plus simplement :
Le modèle peut-il résoudre ce problème ?
Mais plutôt :
Le système peut-il exécuter l’intégralité du flux de travail, utiliser les ressources de manière responsable, produire des preuves et rester correct lorsque l’environnement change ?
Quantum-Harbor est un laboratoire quantique virtuel contrôlé conçu pour évaluer des agents d’IA. Il fournit aux agents des outils et des mesures réalistes tout en gardant cachés les paramètres des dispositifs, la logique d’évaluation et les conditions de validation conservées à part.
QIQCBench est un benchmark construit sur Quantum-Harbor et composé de 49 tâches d’ingénierie quantique rédigées par des experts. Il couvre la mesure, le contrôle, la correction des erreurs, la compilation, la physique des systèmes à plusieurs corps, la communication et la détection.
GPT-5.6-sol s’est classé premier sur les 39 tâches binaires réussite-échec, avec un taux de réussite de 78 %. GPT-5.6-terra a suivi avec 57 %, tandis que Claude Opus 4.8 a obtenu 51 %.
Non. L’article précise explicitement que toutes les évaluations rapportées ont été réalisées en simulation. La fiabilité sur du matériel réel reste une question ouverte.
Verified Autonomy consiste à évaluer un agent à partir des preuves générées pendant l’exécution, et non uniquement à partir de sa réponse finale. Une conclusion doit être étayée par des mesures réellement obtenues par l’agent, ou une conception soumise doit réussir des tests sur de nouvelles données cachées.
Une grande partie des échecs provenait de la gestion du flux de travail plutôt que d’un manque de connaissances théoriques. Sur les 1 510 essais échoués, 937 n’ont donné lieu à aucune soumission finale, souvent parce que les agents avaient épuisé leur budget ou étaient restés bloqués dans de longues boucles d’exécution.
Ces tâches exigent que les agents infèrent un comportement physique caché à partir d’observations plutôt que de suivre simplement une procédure connue. La catégorie affichait un taux de réussite agrégé d’environ 15 %, les trois meilleurs systèmes devançant largement les 14 autres.
L’équipe de recherche a annoncé l’Agentic Quantum Coding Challenge autour de QIQCBench et de Quantum-Harbor. La page publique du challenge est accessible via le site GitHub Pages de GaugeForge.
Quantum-Harbor et QIQCBench déplacent l’évaluation des agents d’IA au-delà des questions-réponses statiques, vers le type de flux de travail dont les systèmes scientifiques ont réellement besoin : choisir des expériences, interagir avec des outils, interpréter des observations bruitées, gérer des budgets limités et justifier les conclusions finales par des preuves.
Les meilleurs systèmes sont déjà impressionnants. GPT-5.6-sol atteint un taux de réussite de 78 % sur les tâches binaires, tandis que GPT-5.6-terra et Opus 4.8 suivent avec respectivement 57 % et 51 %. Pourtant, le benchmark montre également que de nombreux systèmes avancés échouent en se bloquant, en dépensant excessivement leurs budgets expérimentaux, en faisant confiance à des hypothèses obsolètes ou en soumettant des conclusions qui ne peuvent pas être vérifiées indépendamment.
Comme toutes les évaluations ont été réalisées en simulation, ces travaux ne montrent pas que l’IA autonome est prête à contrôler du matériel quantique réel sans supervision. Ils proposent plutôt une méthode plus exigeante pour mesurer les progrès accomplis.
Pour l’IA appliquée aux sciences, la prochaine étape ne consiste pas seulement à produire une réponse plus intelligente, mais à exécuter un flux de travail expérimental complet dont les preuves, l’utilisation des ressources et les conclusions peuvent toutes être vérifiées indépendamment.
Partez d’une phrase et obtenez un site complet en quelques minutes.