For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/recursive-self-improvement-what-ai-resear-557e0db8.md.
Les systèmes d’IA prennent en charge une part croissante du travail nécessaire à la création d’IA : écrire des logiciels, déboguer des infra...
Les systèmes d’IA prennent en charge une part croissante du travail nécessaire à la création d’IA : écrire des logiciels, déboguer des infrastructures, exécuter des expériences et suggérer les prochaines pistes à explorer. L’amélioration récursive de soi, généralement abrégée en RSI, devient donc une question de recherche de plus en plus concrète.
La distinction essentielle est de savoir si l’IA accélère un processus dirigé par des humains ou si elle peut concevoir et développer de manière autonome un successeur plus performant. Le rapport BAAI fourni décrit un secteur qui se rapproche du second scénario. Les recherches publiques apportent des éléments concrets en faveur du premier, tout en laissant subsister une forte incertitude sur l’ampleur que pourraient prendre ces progrès.
Dans la discussion de recherche d’Anthropic, une RSI complète désigne la capacité d’un système à concevoir et développer de manière autonome son successeur. Un agent de programmation qui améliore un script d’entraînement peut contribuer à ce processus sans pour autant boucler l’ensemble du cycle.
Plusieurs capacités distinctes sont nécessaires :
La réussite à un niveau ne prouve pas la réussite à chacun des niveaux suivants. Anthropic indique explicitement qu’une RSI complète n’a pas été atteinte selon son analyse et qu’elle n’est pas inévitable.
Anthropic indique que, en mai 2026, Claude avait produit plus de 80 % du code fusionné dans sa base de code. Il s’agit d’une mesure d’attribution du code fusionné, et non d’une affirmation selon laquelle l’IA aurait pris plus de 80 % de l’ensemble des décisions d’ingénierie.
L’entreprise indique également que la production de code typique par ingénieur au deuxième trimestre 2026 était environ huit fois supérieure à son niveau de 2024, selon le nombre de lignes de code fusionnées par jour. Sa propre réserve est essentielle : les lignes de code mesurent imparfaitement la quantité et ne doivent pas être interprétées comme une multiplication par huit de la productivité utile.
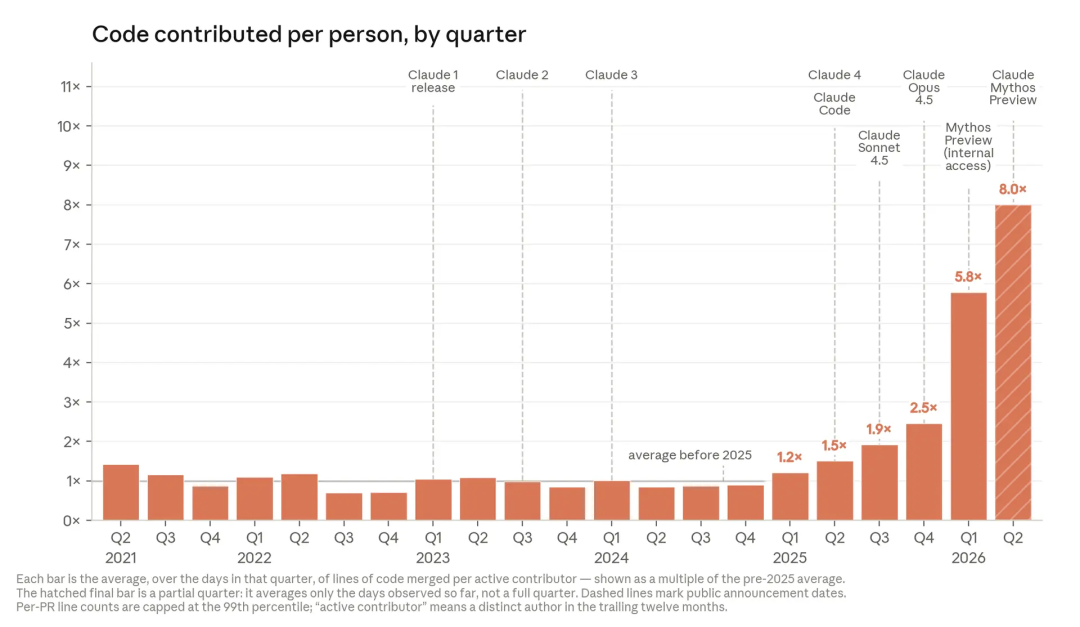
Graphique d’Anthropic reproduit dans l’article de Xinzhiyuan sur BAAI Hub.
Le changement pratique est qu’un ingénieur peut orienter et réviser davantage de travail sans saisir lui-même chaque élément de l’implémentation. Les objectifs, la qualité du code, l’infrastructure partagée et la capacité de revue restent toutefois des contraintes. Cela ne prouve pas que la revue humaine soit devenue inutile.
Écrire une implémentation ne représente qu’une partie de la recherche. Un agent doit aussi exécuter des expériences, examiner les résultats et déterminer si une modification a réellement apporté une amélioration.
Anthropic décrit un test d’optimisation répété dans lequel un modèle reçoit du code d’entraînement et tente de l’accélérer tout en préservant les contrôles de correction. Les résultats se sont nettement améliorés au fil des générations de modèles. L’entreprise avertit que l’accélération absolue dépend de la marge d’optimisation disponible dans le code de départ ; il ne s’agit pas d’une mesure d’une accélération équivalente de l’entraînement des modèles de frontière.
Son projet de recherche automatisée weak-to-strong fournit un autre exemple. Des agents pouvaient proposer et exécuter des expériences à l’intérieur d’un problème et d’un cadre de notation choisis par des humains. Cela constitue une preuve d’automatisation de la recherche dans des limites définies, plutôt qu’une démonstration selon laquelle le système aurait choisi indépendamment le programme de recherche le plus précieux.
SWE-bench évalue les modifications logicielles face à des tâches issues de dépôts et à des tests. Les horizons temporels d’achèvement des tâches de METR examinent la durée des tâches que les modèles peuvent accomplir à des niveaux de fiabilité définis.
Ces mesures répondent à des questions différentes. Un système peut devenir meilleur pour corriger des problèmes de dépôt ou réaliser des tâches plus longues sans être capable de planifier seul un programme de développement de modèle couronné de succès.
Les résultats relatifs aux horizons temporels sont également probabilistes. La durée d’une tâche dans un benchmark ne signifie pas que l’agent travaillera de manière fiable pendant la même durée réelle sur n’importe quel projet. Les références humaines, les seuils de réussite, l’accès aux outils et la distribution des tâches ont tous leur importance.
L’article source cite des discussions sur les réseaux sociaux concernant des agents internes, des cycles de publication plus courts, des modèles non publiés et d’importantes productions scientifiques. Ces récits peuvent signaler des sujets qui méritent d’être étudiés, mais ils ne démontrent pas indépendamment l’existence d’une boucle autonome d’auto-amélioration.
Des intervalles de publication plus courts peuvent s’expliquer de plusieurs façons. Un modèle qui résout des problèmes mathématiques difficiles démontre une capacité sur ces problèmes ; cela ne prouve pas, à lui seul, que le modèle a amélioré son propre processus d’entraînement. De même, une affirmation anonyme concernant le modèle interne d’un laboratoire ne remplace pas un rapport technique présentant des preuves reproductibles.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
La conclusion défendable est plus limitée : les divulgations publiques montrent que l’IA réalise une part croissante de l’ingénierie et d’une partie de la recherche expérimentale. La question de savoir si ces progrès conduiront à une RSI complète reste ouverte.
Anthropic évoque à la fois les bénéfices potentiels et les risques liés à un développement de plus en plus automatisé. Des agents de recherche plus capables pourraient accélérer les travaux scientifiques, tout en rendant la vérification, la surveillance et l’alignement plus exigeants.
Le même processus peut également créer des goulets d’étranglement opérationnels ordinaires. Si les agents génèrent du code plus vite que les humains ne peuvent le réviser, une génération plus rapide ne se traduit pas directement par un déploiement fiable plus rapide. La disponibilité du calcul, la qualité des expériences et les décisions sur ce qu’il faut construire restent pertinentes, même lorsque l’implémentation devient moins coûteuse.
C’est pourquoi l’évaluation de la RSI devrait suivre les éléments de preuve à chaque étape : ce que l’agent a fait, qui a défini son objectif, quelles ressources il a utilisées et comment le résultat a été vérifié.
RSI signifie amélioration récursive de soi. Dans ce contexte, le terme désigne la capacité d’un système d’IA à concevoir et développer de manière autonome un successeur plus performant, plutôt que de simplement aider un humain à améliorer un logiciel.
La génération de code montre qu’une partie du processus de développement peut être automatisée. Une RSI complète nécessiterait une combinaison bien plus large de définition des orientations de recherche, d’implémentation, d’entraînement et d’évaluation ; une forte proportion de code produit par l’IA n’est donc pas une preuve suffisante.
Il désigne le code attribué à Claude et fusionné dans la base de code d’Anthropic en mai 2026. Ce chiffre ne doit pas être interprété comme la part de l’ensemble du travail de l’entreprise réalisée de manière autonome, ni comme la part des décisions stratégiques prises par l’IA.
Elles peuvent indiquer une évolution du volume produit, mais elles ne mesurent pas directement l’utilité, la maintenabilité ou la valeur commerciale. Anthropic avertit elle-même que sa hausse par huit de la production de code surestime probablement le gain réel de productivité.
Ils décrivent les performances sur un ensemble particulier de tâches, à des niveaux de réussite indiqués, en utilisant les durées humaines des tâches comme référence. Ils ne garantissent pas qu’un agent puisse accomplir toute mission réelle d’une durée équivalente.
Oui. Un agent peut concevoir et exécuter des expériences à l’intérieur d’un problème et d’un cadre de notation fournis par des humains. Cette automatisation de la recherche peut être précieuse tout en laissant les décisions de niveau supérieur aux personnes.
La discussion principale d’Anthropic affirme explicitement qu’elle ne l’est pas. Le jugement de recherche, le calcul, l’infrastructure, l’évaluation et d’autres goulets d’étranglement peuvent limiter ou modifier la trajectoire ; les prévisions doivent rester distinctes des résultats démontrés.
Les données publiques confirment une forte augmentation de la programmation assistée par l’IA et de l’automatisation encadrée de la recherche. Ces avancées rendent pertinente l’étude de la possibilité d’une amélioration récursive de soi, mais elles n’établissent pas qu’une boucle entièrement autonome de développement de successeurs existe déjà.
La question essentielle est de savoir quelles parties du développement de l’IA un système peut réaliser et vérifier de manière indépendante, et non à quel point son calendrier de publication ou son benchmark phare semble spectaculaire.
Partez d’une phrase et obtenez un site complet en quelques minutes.



