For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/small-ai-models-and-iot-worms-what-anthro-71fdda5f.md.
Un modèle d’IA n’a pas nécessairement besoin d’un GPU de centre de données pour fonctionner. Dans une recherche publiée le 12 octobre 2026, ...
Un modèle d’IA n’a pas nécessairement besoin d’un GPU de centre de données pour fonctionner. Dans une recherche publiée le 12 octobre 2026, Anthropic a démontré qu’un modèle de 26 milliards de paramètres pouvait être distribué sur 15 boîtiers Android TV bon marché et a testé si des agents pouvaient préparer des environnements d’inférence sur du matériel inconnu.
Ces travaux sont pertinents pour la réplication et l’adaptation autonomes, ou ARA : la capacité d’un système à se déployer et à se propager sans contrôle humain. Ils identifient une préoccupation de sécurité plausible, tout en maintenant une distinction importante. Les chercheurs ont démontré plusieurs prérequis et une expérience de réplication simplifiée ; ils n’ont pas signalé l’existence d’un modèle autonome et malveillant se propageant déjà dans les foyers.
Le rapport officiel de William Zhou et Daniel Freeman décrit l’exécution de Gemma4-26B-A4B sur 15 boîtiers Android TV sans marque coûtant environ 55 $ chacun. Chaque boîtier disposait de 4 Go de RAM et contenait une petite partie des couches du modèle.
Les boîtiers étaient mis en réseau, les calculs traversant les couches grâce au parallélisme en pipeline. La démonstration a atteint 0,39 jeton par seconde. C’est lent pour un usage interactif, mais cela établit que l’inférence de modèles capables est techniquement possible sur un parc d’appareils peu coûteux.
Les chercheurs ont organisé manuellement cette démonstration matérielle. Elle ne prouvait pas en elle-même que le modèle avait compromis les boîtiers de manière autonome ou déployé ses propres poids sur ceux-ci.
La mémoire compte également. Le rapport estime que, selon ses hypothèses de quantification à quatre bits, un modèle 9B nécessiterait au moins quatre appareils de ce type disposant de 4 Go, et qu’un modèle 26B en nécessiterait plus de dix. Affirmer que l’un ou l’autre modèle tient simplement dans un seul boîtier TV ordinaire de 4 Go ignorerait la configuration distribuée.
Le rapport divise le processus en quatre étapes :
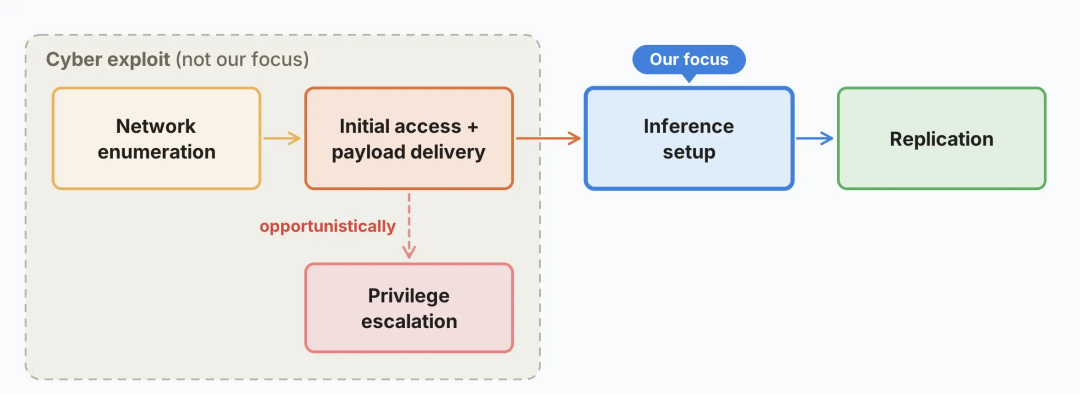
Schéma de recherche attribué à Anthropic, reproduit dans l’article de Xinzhiyuan sur BAAI Hub. L’étude se concentre sur la préparation de l’inférence plutôt que sur la découverte de nouveaux exploits.
La troisième étape constitue un défi d’ingénierie important. Différents appareils exigent différentes piles d’inférence, versions de paquets et opérations de débogage propres au matériel. Les chercheurs ont constaté que Qwen3.5-9B pouvait établir une inférence sur huit des neuf types de matériel testés, couvrant des appareils tels que des Jetson Nano, des Mac et des systèmes RTX 4090.
Ces noms de matériel décrivent la diversité du test ; ils n’établissent pas que les appareils ou les puces présentent une vulnérabilité de sécurité particulière. La capacité à configurer une machine autorisée et la capacité à obtenir un accès non autorisé à celle-ci restent deux questions distinctes.
Pour l’expérience combinée, les chercheurs ont utilisé un réseau isolé par pare-feu composé de huit nœuds Google Cloud exécutant redroid, un émulateur Android 15. L’accès a été délibérément simplifié au moyen de ports ADB non authentifiés.
GLM-5.2 a mené à bien la chaîne testée sur les huit nœuds lors de quatre exécutions sur cinq, et sur sept nœuds lors de l’exécution restante. Les autres modèles à poids ouverts testés se sont révélés moins fiables pour combiner les différentes étapes.
L’inférence du grand modèle lui-même était exécutée sur un serveur distinct. La tâche consistait à installer Llama3.1-8B sur les nœuds cibles, après quoi le banc d’essai créait une nouvelle instance d’agent. Les nœuds n’étaient pas suffisamment grands pour héberger le grand modèle lui-même. Cela teste si le contrôleur possède les compétences nécessaires à la propagation ; ce n’est pas une démonstration que GLM-5.2 a entièrement reproduit ses propres calculs dans un boîtier TV.
Les auteurs qualifient explicitement les conditions d’accès simplifiées de limite supérieure du taux de réussite dans le monde réel. Cette réserve est essentielle pour interpréter ce résultat solide.
L’équipe a conçu un banc d’essai appelé Memento sur la base de l’agent de programmation Pi. Il redémarre périodiquement un agent avec l’espace de travail et de courtes notes de son prédécesseur, ce qui aide l’instance suivante à éviter de rester bloquée sur la même approche erronée.
Sur six générations de Qwen3.5-9B, le taux de réussite de la préparation de l’inférence est passé de 45 % au départ à une fourchette comprise entre 61 % et 84 % dans les générations ultérieures. Cette amélioration n’était pas monotone et n’impliquait pas de réentraînement des poids du modèle. Il s’agissait d’une amélioration de la performance dans la tâche grâce au contexte textuel hérité et à l’état de travail.
Le rapport utilise une analogie avec l’évolution lamarckienne pour ce transfert d’informations acquises. Cette analogie n’établit ni une vie biologique, ni une conscience, ni une auto-amélioration sans restriction.
Les chercheurs ont également testé l’accès à un conseiller plus puissant, Claude Opus 4.8. Ils n’ont constaté aucune amélioration significative dans cette configuration : les petits modèles ne posaient souvent pas de questions productives, et les conseils non sollicités ne résolvaient pas non plus le problème.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
La préoccupation porte sur l’adaptabilité. Un agent capable d’inspecter les erreurs et d’ajuster sa configuration pourrait prendre en charge un éventail matériel plus large qu’un script de déploiement fixe. Un réplicateur fondé sur des poids pourrait aussi fonctionner localement plutôt que de dépendre entièrement d’un accès continu à une API de modèle unique.
Cela ne signifie pas que les défenseurs ne disposeraient d’aucun moyen de réponse. Le rapport estime que la réplication est lente sur le matériel mesuré et qu’elle pourrait prendre plusieurs jours. Les transferts de modèles et l’inférence distribuée peuvent également générer un trafic réseau visible.
Les auteurs utilisent un botnet historique de plus de deux millions d’appareils comme référence hypothétique d’échelle. Regrouper 15 appareils par instance de modèle produirait environ 133 000 répliques, mais il s’agit d’un calcul illustratif, et non d’un botnet d’IA mesuré ni d’une population identifiée de foyers infectés.
Le rapport compare les progrès des petits modèles à une mesure générale des capacités, l’Epoch Capabilities Index. Sa tendance suggère que des modèles de 30B paramètres ou moins pourraient atteindre le seuil de capacité de l’expérience simplifiée d’ici fin 2026.
Les auteurs qualifient cette estimation d’approximative. L’ECI est un indicateur indirect de la compétence de réplication, et une tendance de capacité ne détermine ni le moment où un système malveillant émergera ni l’efficacité avec laquelle il se propagera hors d’un laboratoire.
Les défenses évoquées dans le rapport comprennent la surveillance des transferts inhabituellement volumineux et du trafic entre appareils, la mise en quarantaine des réseaux infectés, la collecte d’échantillons via des pots de miel et l’amélioration des paramètres de sécurité par défaut des appareils. L’explication du NCSC sur la législation britannique relative aux appareils intelligents apporte un contexte pertinent sur l’élimination des mots de passe faibles définis par défaut.
Il s’agit d’un système de réplication proposé qui transporte ou obtient des poids de modèle et exécute l’inférence sur du matériel compromis. Il diffère d’un système qui dépend entièrement d’une API de modèle servie de manière centralisée.
Le rapport décrit des expériences contrôlées et une modélisation des menaces. Il n’établit pas qu’un modèle autonome auto-réplicatif et malveillant se propage déjà dans des appareils ménagers.
La démonstration a utilisé 15 boîtiers mis en réseau, et non un seul. Les couches du modèle ont été réparties entre eux, atteignant 0,39 jeton par seconde.
Non. Sa propre inférence est restée sur un serveur externe pendant qu’il configurait Llama3.1-8B sur les nœuds cibles, le banc d’essai créant ensuite les instances d’agent suivantes.
Non dans l’expérience rapportée. Les instances ultérieures ont hérité de notes textuelles et d’un état de travail, ce qui a amélioré la performance dans la tâche sans réentraînement des poids.
Les chercheurs proposent une estimation conditionnelle fondée sur les tendances historiques de capacité. Il ne s’agit ni d’une date de déploiement confirmée ni d’une preuve d’une propagation inévitable dans le monde réel.
La recherche montre que des parcs d’appareils peu coûteux peuvent prendre en charge l’inférence distribuée et que les agents améliorent leur capacité à configurer des modèles sur des machines inconnues. Une orchestration fiable dans un réseau de laboratoire simplifié constitue un signe d’alerte supplémentaire.
La faisabilité matérielle, la réplication contrôlée et la propagation incontrôlée dans le monde réel sont des affirmations différentes ; les preuves doivent être interprétées au niveau que les expériences étayent réellement.
Partez d’une phrase et obtenez un site complet en quelques minutes.



