Tencent Hunyuan a publié l'aperçu de Hy ASR 3.0, un nouveau modèle de reconnaissance vocale en temps réel basé sur les capacités de compréhe...
Tencent Hunyuan a publié l'aperçu de Hy ASR 3.0, un nouveau modèle de reconnaissance vocale en temps réel basé sur les capacités de compréhension linguistique de Hy3.
Ce modèle vise à faire évoluer la reconnaissance automatique de la parole au-delà du décodage acoustique isolé.
Les systèmes ASR traditionnels répondent principalement à une question :
Quelle séquence de mots correspond le mieux à cet audio ?
Hy ASR 3.0 ajoute une seconde question :
Dans ce contexte, quelle transcription est la plus pertinente ?
Cette distinction est cruciale lorsque l'audio contient :
Tencent indique que ce modèle combine un système acoustique haute précision avec les capacités de modélisation contextuelle et de raisonnement sémantique de Hy3. L'objectif n'est pas de réécrire de manière créative ce que l'utilisateur a dit, mais d'utiliser le contexte linguistique pour choisir la transcription la plus plausible lorsque l'audio lui-même est ambigu.
Tencent rapporte un taux d'erreur de mots de 3,34 % pour le mandarin, de 2,62 % pour l'anglais et de 3,12 % pour le cantonais sur des ensembles d'évaluation publics agrégés.
L'aperçu de Hy ASR 3.0 est désormais disponible en tant que moteur WebSocket en temps réel sur Tencent Cloud, avec une documentation fournie, et a été intégré à l'assistant Tencent Yuanbao. WorkBuddy et d'autres produits Tencent sont en cours d'intégration progressive.
L'aperçu public est disponible, mais ne correspond pas encore à la forme finale du produit décrite dans les annonces de diffusion plus large. Ses limites actuelles d'API méritent l'attention des équipes prévoyant une intégration en production.
Tencent a évalué l'aperçu de Hy ASR 3.0 sur plusieurs ensembles de données vocales publiques et l'a comparé à d'autres systèmes ASR.
Les taux d'erreur de mots agrégés rapportés par l'entreprise sont les suivants :
| Langue ou variante vocale | WER Hy ASR 3.0 Aperçu |
|---|---|
| Mandarin | 3,34 % |
| Anglais | 2,62 % |
| Cantonais | 3,12 % |
Plus le WER est bas, meilleur est le résultat.
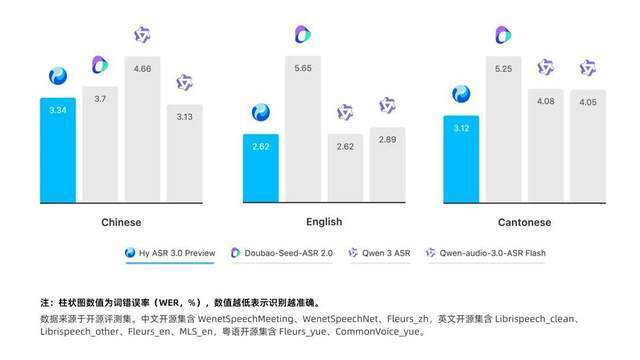
La légende du graphique indique que l'évaluation agrégée a utilisé les ensembles de données suivants :
Les données agrégées facilitent une comparaison large, mais peuvent également masquer des différences importantes.
Les performances du modèle peuvent varier selon les scénarios :
Par conséquent, les équipes de production devraient tester avec leur propre audio.
Plutôt que de choisir un modèle ASR uniquement sur la base d'un chiffre WER unique.
Le taux d'erreur de mots est généralement défini comme suit :
WER = (Substitutions + Suppressions + Insertions) / Nombre de mots de référence
Les trois types d'erreurs sont :
Un WER plus bas indique généralement une transcription plus précise.
Cependant, le WER ne couvre pas tous les cas de défaillance dans les scénarios réels.
Considérons deux erreurs d'un seul mot :
« Expédiez la commande demain »
→ « Expédiez la commande aujourd'hui »
Ainsi que :
« La couleur est bleu marine »
→ « La couleur est bleu marine » (variante orthographique)
Les deux peuvent produire des comptes d'erreurs similaires, mais la première peut modifier une action commerciale, tandis que la seconde peut n'avoir aucun impact sur l'activité.
Pour les domaines tels que le service client, la santé, la finance, la fabrication et les interfaces de commande, les équipes devraient évaluer à la fois l'impact sémantique et le WER.
Tencent a également publié des résultats d'ensembles d'évaluation internes couvrant quatre catégories pratiques :
Les résultats rapportés sont les suivants :
| Catégorie d'évaluation interne | WER Hy ASR 3.0 Aperçu |
|---|---|
| Reconnaissance générale | 4,95 % |
| Reconnaissance des dialectes | 9,31 % |
| Évaluation contextuelle | 4,76 % |
| Conditions acoustiques complexes | 6,36 % |
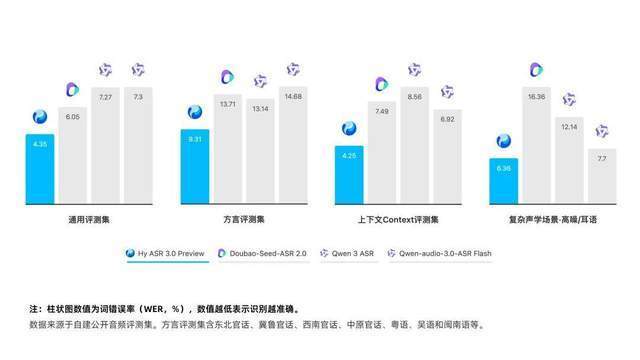
Tencent indique que Hy ASR 3.0 Preview a obtenu le WER le plus bas parmi les systèmes comparés dans les quatre catégories internes.
Ces résultats sont utiles en tant que preuves de produit rapportées par l'entreprise, mais les ensembles de tests internes ne constituent pas des benchmarks publics neutres.
Avant l'adoption, les organisations devraient se demander :
Tencent a regroupé les améliorations pratiques en quatre domaines.
Le modèle vise à améliorer la reconnaissance dans les scénarios suivants :
Tencent indique également que le modèle réduit les erreurs cumulées dans les énoncés plus longs.
Cette affirmation décrit la capacité sous-jacente du modèle. Actuellement, l'aperçu Tencent Cloud limite toujours chaque entrée d'API publique unique à 60 secondes. Par conséquent, les applications traitant des réunions ou des enregistrements doivent actuellement segmenter l'audio et gérer elles-mêmes le contexte entre les segments.
Une mauvaise segmentation peut réintroduire les problèmes que ce modèle est censé résoudre.
Par exemple, découper l'audio à des limites arbitraires de 60 secondes peut interrompre :
Par conséquent, la logique de segmentation doit autant que possible préserver les limites de phrases et les frontières d'activité vocale.
La parole contient de nombreux sons ambigus.
Le mandarin comporte un grand nombre d'homophones. L'anglais contient des mots et des noms à la prononciation similaire. Les accents régionaux peuvent rendre plusieurs transcriptions candidates acoustiquement plausibles.
Les décodeurs traditionnels peuvent choisir le mot avec la probabilité locale maximale.
Les systèmes dotés d'une sensibilité au contexte peuvent évaluer l'énoncé complet.
Par exemple, un utilisateur peut prononcer une phrase pouvant être transcrite en deux homophones différents. Des mots liés à la finance, aux jeux, à la médecine ou au voyage peuvent indiquer quelle signification est la plus probable.
Le flux de traitement attendu peut être simplifié comme suit :
Caractéristiques audio
→ Mots candidats
→ Contexte de la phrase
→ Vérification de la cohérence sémantique
→ Texte transcrit final
Cela ne signifie pas que le modèle comprend réellement la parole de la même manière qu'un humain.
Cela signifie plutôt que les composants linguistiques utilisent une fenêtre de contexte plus large et des probabilités sémantiques pour améliorer les décisions de transcription.
Les systèmes de reconnaissance vocale sensibles au contexte introduisent également un nouveau risque : la surgénéralisation sémantique.
Le modèle peut parfois remplacer une phrase peu courante mais correctement prononcée par une phrase courante qui semble plus fluide.
Par conséquent, l'évaluation en environnement de production devrait inclure :
L'objectif est d'utiliser le contexte sans inventer de contenu vocal qui n'a jamais été prononcé.
Les supports de publication mettent en avant l'amélioration par mots clés, applicable à :
Lorsqu'un modèle généraliste ne traite pas assez fréquemment un mot rare, les mots clés peuvent apporter une valeur importante.
Des exemples incluent :
Noms de médicaments propriétaires
Modèles de machines d'usine
Codes de comptes clients
Nouvelles marques lancées
Abréviations techniques
Le produit ASR général de Tencent Cloud dispose déjà d'une API de listes de mots clés et d'un paramètre hotword_id.
Cependant, la documentation actuelle de l'aperçu Hy ASR 3.0 indique clairement que l'amélioration par mots clés n'est pas encore disponible pour ce moteur en aperçu.
Par conséquent, il convient de distinguer les annonces publiques sur les produits des statuts d'API réellement accessibles :
| Capacité | Notes de version du modèle | Statut actuel de l'API en aperçu |
|---|---|---|
| Amélioration par mots clés | Décrite comme une capacité prise en charge | Répertoriée comme à venir |
| Entrée contextuelle | Décrite comme une capacité principale | Répertoriée comme à venir |
| Modélisation linguistique contextuelle interne | Caractéristique centrale du modèle | Disponible via le comportement du modèle |
Tant que Tencent Cloud n'aura pas confirmé la prise en charge dans la documentation officielle de l'API, les entreprises ne devraient pas élaborer de plans de lancement reposant sur l'injection de contexte externe ou sur des listes de mots clés.
Tencent indique que le modèle a été optimisé pour :
La robustesse au bruit est importante car la parole réelle ressemble rarement à des enregistrements de laboratoire propres.
Les microphones du service client peuvent capter les bruits de clavier et les voix de collègues à proximité.
Les assistants mobiles peuvent entendre le bruit de la circulation, le vent, la musique ou d'autres personnes qui parlent.
Les applications de réunion peuvent recevoir un audio compressé provenant de microphones d'ordinateurs portables éloignés.
Le modèle peut améliorer la robustesse, mais ne peut pas restaurer des informations jamais capturées.
Les équipes devraient toujours utiliser :
La qualité de la reconnaissance vocale est une propriété du système, et pas seulement une propriété du modèle.
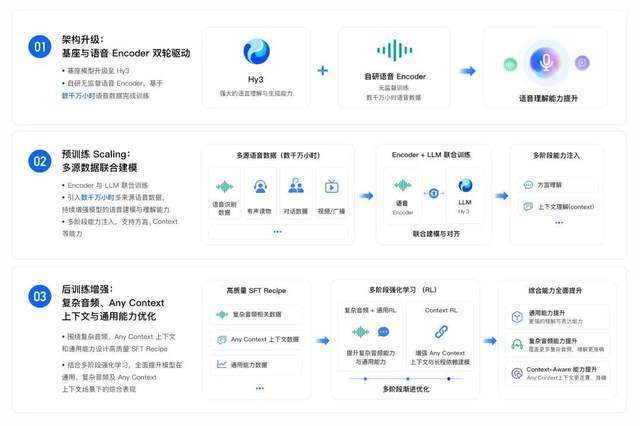
Tencent indique que le Hunyuan Hy ASR 3.0 Preview combine trois composants majeurs :
Hy3 fournit le composant de compréhension du langage.
Son rôle inclut :
Tencent décrit cette architecture comme une conception de mélange d'experts (MoE) qui équilibre performance et efficacité.
La documentation ASR publique ne divulgue pas le nombre total de paramètres, le nombre de paramètres activés, les profils de latence ou l'architecture d'inférence complète du Hy ASR 3.0 Preview.
L'encodeur vocal convertit l'audio brut en représentations acoustiques que le modèle linguistique peut traiter.
Tencent indique que cet encodeur a été entraîné sur des dizaines de millions d'heures de parole non étiquetée.
L'entraînement audio non supervisé ou auto-supervisé est précieux car la transcription manuelle de données vocales à cette échelle serait d'un coût prohibitif.
L'encodeur peut apprendre des structures récurrentes à partir de l'audio brut, telles que :
La qualité de cette représentation affecte toutes les étapes ultérieures.
Si deux sons sont confondus au stade de l'encodeur, le modèle linguistique doit davantage s'appuyer sur le contexte pour retrouver les mots corrects.
Tencent indique que l'encodeur vocal et le modèle linguistique ont été entraînés conjointement sur un vaste ensemble de données vocales multi-sources couvrant :
conjoint vise à réduire l'écart entre la reconnaissance acoustique et la compréhension du langage.
Plutôt que de considérer la reconnaissance vocale comme :
La tâche du modèle audio est terminée
→ Le modèle linguistique nettoie ensuite la transcription
Hy ASR 3.0 est présenté comme un processus davantage intégré :
La représentation vocale et la modélisation linguistique
→ Sont entraînées en synergie
→ Produisent une transcription contextualisée

Les frontières internes exactes entre l'encodeur, le décodeur, le modèle linguistique et les phases d'apprentissage par renforcement ne sont pas entièrement publiques.

## SFT et apprentissage par renforcement multi-étapes

Tencent décrit un schéma de micro-ajustement supervisé couvrant :

- La transcription générale.
- Des tâches contextuelles arbitraires.
- La terminologie spécialisée.
- Différents environnements acoustiques.
- Des groupes de locuteurs variés.
- Dix grandes zones dialectales.
- Plus de 20 zones dialectales plus petites.

La société rapporte également l'utilisation d'un apprentissage par renforcement multi-étapes pour :

- La précision générale de la transcription.
- Le comportement contextuel.
- Des cas complexes de longue traîne.
- La réduction des erreurs de substitution et de suppression.

Aucun article technique public ne fournit actuellement la conception complète des récompenses, la répartition des données, la puissance de calcul d'entraînement ou les résultats d'études d'ablation.

Par conséquent, les déclarations sur l'architecture doivent être considérées comme des descriptions techniques au niveau du produit, et non comme des spécifications de recherche reproductibles.

## Langues et dialectes pris en charge par le moteur actuel de Tencent Cloud

La documentation de Tencent Cloud décrit le moteur actuel `Hy-ASR-3.0-preview` comme prenant en charge :

- Le mandarin.
- L'anglais.
- 20 dialectes chinois ou variantes régionales.

La liste des dialectes fournie par la documentation est la suivante :

| N° | Dialecte ou variante régionale |
|-|-|
| 1 | Cantonais |
| 2 | Dialecte du Nord-Est |
| 3 | Dialecte du Henan |
| 4 | Dialecte du Shaanxi |
| 5 | Dialecte de Chengdu |
| 6 | Dialecte de Chongqing |
| 7 | Dialecte de Wuhan |
| 8 | Dialecte de Guiyang |
| 9 | Dialecte de Qingdao |
| 10 | Dialecte de Jinan |
| 11 | Dialecte de Changsha |
| 12 | Dialecte de Hefei |
| 13 | Dialecte du Hebei |
| 14 | Dialecte de Kunming |
| 15 | Dialecte de Lanzhou |
| 16 | Dialecte de Yinchuan |
| 17 | Dialecte de Nanchang |
| 18 | Dialecte de Pékin |
| 19 | Dialecte du Sichuan |
| 20 | Dialecte de Tianjin |

Les étiquettes dialectales dans la documentation ASR commerciale sont de larges catégories de produits.

La parole réelle dans chaque catégorie varie selon la ville, l'âge, le contexte social, l'alternance codique, le vocabulaire et le locuteur.

Prétendre prendre en charge un dialecte ne doit pas être compris comme une précision identique pour chaque locuteur de cette région.

## Disponibilité de l'aperçu actuel

Tencent Cloud a ajouté le moteur d'aperçu Hy ASR 3.0 au produit WebSocket en temps réel le **4 août 2026**.

Ce service public est actuellement décrit comme une version de test interne ou d'aperçu.

| Élément | Statut documenté actuel |
|-|-|
| Type de produit | Reconnaissance vocale en temps réel |
| Méthode d'accès | API WebSocket Tencent Cloud |
| Nom du moteur | `Hy-ASR-3.0-preview` |
| Durée audio | 60 secondes maximum par entrée |
| Format audio | PCM mono 16 kHz |
| Concurrence incluse | 20 connexions simultanées |
| Mandarin | Pris en charge |
| Anglais | Pris en charge |
| 20 dialectes | Pris en charge |
| Séparation des locuteurs | Non prise en charge dans l'aperçu |
| Paramètres VAD | Répertoriés comme non pris en charge dans l'aperçu |
| Substitution de mots | Non prise en charge dans l'aperçu |

Paramètres de seuil de bruit | Non pris en charge dans l'aperçu |
| Entrée de contexte externe | À venir |
| Amélioration des mots de réveil | À venir |

La référence générale de l'API WebSocket inclut des paramètres utilisés par d'autres moteurs, y compris les identifiants VAD et de mots de réveil.

Hy ASR 3.0 est soumis aux notes d'aperçu spécifiques au moteur.

Les paramètres apparaissant dans le mode API partagé ne garantissent pas que le moteur d'aperçu a déjà implémenté ce paramètre.

## Processus d'intégration de base de Tencent Cloud

La configuration officielle comprend trois étapes principales.

## Étape 1 : Activer le service de reconnaissance vocale Tencent Cloud

Ouvrez le service de reconnaissance vocale Tencent Cloud et terminez le processus d'activation du compte.

La documentation officielle de démarrage rapide se trouve à :

```Plaintext
https://cloud.tencent.com/document/product/1093/54362
Veuillez consulter les informations de facturation avant d'activer la facturation à la consommation.
Tencent Cloud indique que la facturation à la consommation est désactivée par défaut pour les nouveaux comptes et doit être activée manuellement.
Créez ou récupérez :
AppIDSecretIDSecretKeyCes identifiants servent à signer les demandes de connexion WebSocket.
Stockez-les dans un gestionnaire de secrets ou des variables d'environnement protégées.
Ne placez pas d'identifiants à long terme dans :
Pour les produits navigateur ou mobile, créez des informations de connexion signées sur un backend de confiance.
Le format du point de terminaison documenté dans la documentation Tencent Cloud est :
wss://asr.cloud.tencent.com/asr/v2/?{request_parameters}
Remplacez `` par l'AppID Tencent Cloud.
La demande inclut des paramètres de signature tels que :
secretidtimestampexpirednoncevoice_idengine_model_typeDecrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Pour l'aperçu Hy ASR 3.0, définissez :
engine_model_type=Hy-ASR-3.0-preview
Chaque connexion WebSocket nécessite un voice_id unique.
Si la connexion se termine ou échoue, l'ancien voice_id devient invalide et un nouveau voice_id doit être généré.
L'aperçu actuel exige :
Taux d'échantillonnage : 16 kHz
Canaux : mono
Format : PCM
Durée d'entrée maximale : 60 secondes
Testez l'intégralité de la chaîne audio, pas seulement le fichier brut.
Les SDK microphones, les API média des navigateurs, les systèmes téléphoniques et les plateformes de réunion peuvent rééchantillonner ou compresser l'audio avant qu'il n'atteigne le serveur.
Le service prend en charge la transcription en temps réel, renvoyant le texte pendant la transmission audio.
L'application doit gérer :
Ne supposez pas que chaque résultat de reconnaissance partiel est un résultat final.
L'interface ASR en temps réel peut réviser des mots ou phrases précédents après avoir obtenu plus de contexte.
L'interface utilisateur doit distinguer le texte temporaire du texte confirmé.
Construisez un ensemble d'évaluation représentatif incluant :
Du bruit.
Mesurez à la fois la qualité de reconnaissance et le comportement du système.
Tencent Cloud classe Hy ASR 3.0 en aperçu comme moteur de reconnaissance vocale en temps réel Grand Modèle 2.0.
La page de facturation actuelle indique :
| Option de facturation | Prix actuel affiché |
|---|---|
| Forfait prépayé 60 heures | Total 60 yuans, soit 1,00 yuan/heure |
| Forfait prépayé 1 000 heures | Total 950 yuans, soit 0,95 yuan/heure |
| Forfait prépayé 10 000 heures | Total 9 000 yuans, soit 0,90 yuan/heure |
| Forfait prépayé 100 000 heures | Total 88 000 yuans, soit 0,88 yuan/heure |
| Forfait prépayé 300 000 heures | Total 255 000 yuans, soit 0,85 yuan/heure |
| À la consommation | 1,00 yuan/heure, facturé quotidiennement |
Le tableau de facturation actuel de Tencent indique que la reconnaissance Grand Modèle 2.0 n'offre aucun quota audio gratuit.
Les 20 connexions simultanées incluses sont un quota de concurrence, pas une durée de reconnaissance gratuite.
Les prix peuvent varier. Avant de publier une offre commerciale ou d'estimer un budget à long terme, consultez la page de facturation en temps réel.
Sur la base du tarif actuel à la consommation de 1,00 yuan/heure :
100 heures de reconnaissance réussie
× 1,00 yuan/heure
= 100 yuans
Le budget de production doit également inclure :
Les frais ASR ne représentent qu'une partie du système de transcription complet.
Tencent indique que Yuanbao a participé au développement du modèle et est le premier produit Tencent à l'intégrer.
Les utilisateurs peuvent expérimenter la fonction via la saisie vocale dans Yuanbao, le modèle étant conçu pour améliorer :
Tencent indique que d'autres produits tels que WorkBuddy s'intègrent progressivement.
L'intégration des produits grand public peut différer de l'API publique d'aperçu Tencent Cloud.
Par exemple, Yuanbao peut utiliser des services internes, un contexte spécifique au produit ou des configurations de déploiement non encore ouvertes aux développeurs externes.
Il ne faut pas supposer que l'expérience dans Yuanbao correspond un à un aux paramètres de l'API publique.
L'aperçu Hy ASR 3.0 est positionné pour les interactions vocales courtes et à faible latence.
Les utilisations potentielles incluent :
L'aperçu actuel manque de séparation des locuteurs, ce qui peut limiter la transcription des appels multipartites, sauf si d'autres composants assurent la séparation des canaux ou des locuteurs.
Le moteur peut prendre en charge le sous-titrage en temps réel de courte durée pour :
L'application doit tester la stabilité des résultats partiels et le comportement de ponctuation.
La reconnaissance contextuelle peut améliorer les recherches impliquant :
Tant que l'injection de mots clés n'est pas ouverte dans l'aperçu, les termes rares
du catalogue peuvent encore nécessiter un post-traitement ou une couche de correction d'erreurs distincte.
Le moteur peut convertir des instructions parlées en texte pour :
Contrôle des appareils intelligents.
Le système de commandes ne doit jamais exécuter d'actions à fort impact simplement parce qu'un résultat de transcription semble très fiable.
Pour les opérations destructrices ou financières, confirmez l'intention analysée et exigez une approbation explicite de l'utilisateur.
De courts extraits audio peuvent être transcrits avant d'être envoyés dans les processus suivants :
La qualité de chaque étape de traitement IA en aval dépend du résultat de la transcription.
Lorsque les politiques le permettent, stockez l'audio brut ou les preuves de confiance afin que les sorties incertaines puissent être examinées.
Ce produit est toujours marqué comme étant en version aperçu ou bêta interne.
L'interface, les tarifs, les limitations et les fonctionnalités prises en charge peuvent changer.
L'API publique actuelle ne peut pas remplacer directement la transcription par lots de longs enregistrements.
Les fichiers audio longs doivent être traités par segments et peuvent nécessiter une couche contextuelle au niveau de l'application.
La version d'aperçu exige actuellement du PCM mono 16 kHz.
De nombreux environnements de production utilisent MP3, AAC, Opus ou des codecs téléphoniques, ce qui nécessite une conversion.
La documentation exclusive du moteur actuel indique que la séparation des locuteurs n'est pas prise en charge.
La transcription multi-locuteurs peut nécessiter des canaux audio séparés ou d'autres services de séparation des locuteurs.
Selon la documentation officielle, les capacités annoncées n'ont pas encore été rendues disponibles en tant que fonctionnalités d'API d'aperçu utilisables.
Les graphiques de référence proviennent de Tencent.
Une évaluation indépendante dans des conditions appariées renforcerait la crédibilité de la comparaison.
Tencent a fourni une description de haut niveau de l'architecture et du processus d'entraînement de Hy ASR 3.0 en aperçu, mais n'a pas publié de détails complets et reproductibles.
Le décodeur sensible à la langue peut privilégier les phrases courantes et ignorer ce qui a été réellement dit, même si c'est peu courant mais correct.
Les tests doivent inclure des phrases rares et inattendues.
Inclure au moins plusieurs centaines d'énoncés représentatifs, plutôt qu'un petit nombre d'échantillons de démonstration propres.
Créer des transcriptions de référence vérifiées manuellement avec une stratégie de normalisation claire.
Décider comment gérer :
Utiliser :
Ne pas regrouper tous les locuteurs de dialectes dans une seule moyenne.
Rapporter les résultats séparément par région et conditions d'enregistrement.
Créer des paires d'échantillons dont le contenu acoustique est similaire mais où le contexte de la phrase change la transcription correcte.
Évaluer les noms de produits et
Traiter d'abord la terminologie, puis répéter les tests une fois que Tencent aura ouvert la prise en charge des mots-clés.
Utiliser des enregistrements réels de l'environnement, et non uniquement du bruit superposé numériquement.
Confirmer que l'implémentation de segmentation de 60 secondes ne coupe pas les phrases importantes et ne produit pas de texte dupliqué.
Inclure les étapes suivantes :
Capture
+ Téléversement
+ Reconnaissance
+ Finalisation du résultat
+ Traitement en aval
Les enregistrements vocaux peuvent contenir des informations personnelles ou sensibles.
Avant le déploiement, la conservation des données, les droits d'accès, le chiffrement, le consentement de l'utilisateur et les politiques de suppression doivent être clairement définis.
| Domaine | Pipeline traditionnel | Direction de Hy ASR 3.0 |
|---|---|---|
| Préoccupation principale | Précision acoustique vers texte | Reconnaissance acoustique avec modélisation linguistique contextuelle |
| Homophones faciles à confondre | S'appuie généralement sur des probabilités locales | Utilise un contexte de phrase plus large |
| Dialectes | Modèles séparés ou couverture limitée | Moteur hybride unique documenté, prenant en charge 20 dialectes |
| Vocabulaire spécialisé | Mots-clés externes ou modèles personnalisés | Capacité de mots-clés annoncée ; prise en charge en aperçu à venir |
| Parole complexe | Modèle acoustique plus post-traitement | Entraînement conjoint parole-langage plus post-entraînement |
| Sortie | Texte transcrit | Texte transcrit avec un contexte plus cohérent |
| Risque principal | Substitutions acoustiques et mots manquants | Erreurs acoustiques plus surcorrection sémantique possible |
La nouvelle approche n'élimine pas le besoin d'ingénierie ASR traditionnelle.
Elle ajoute une couche linguistique plus puissante sur le même système de bout en bout.
Hy ASR 3.0 en aperçu est un modèle de reconnaissance vocale en temps réel proposé par Tencent Hunyuan, basé sur la fondation linguistique Hy3 et un encodeur vocal propriétaire. Son objectif est de combiner la reconnaissance acoustique avec la compréhension du langage contextuel.
La documentation Tencent Cloud indique la prise en charge du mandarin, de l'anglais et de 20 dialectes ou variantes régionales chinoises, notamment le cantonais, le mandarin du Nord-Est, le Henan, le Shaanxi, le Chengdu, le Chongqing, le Wuhan, etc. La précision peut varier selon les locuteurs et les régions.
Tencent a publié des résultats WER agrégés sur des références publiques : mandarin 3,34 %, anglais 2,62 %, cantonais 3,12 %. Ces résultats sont rapportés par l'entreprise sur la base de plusieurs ensembles de données agrégés, et ne constituent pas des résultats de tests unifiés reproduits de manière indépendante.
L'aperçu public actuel accepte au maximum 60 secondes d'audio par entrée. Les enregistrements plus longs nécessitent un traitement par segments, et l'application doit conserver un contexte efficace entre les segments.
Selon la documentation d'aperçu du 4 août 2026 de Tencent Cloud, ce n'est pas encore pris en charge. Ces capacités sont décrites dans les documents de lancement, mais les pages officielles de l'API indiquent que l'entrée de contexte et l'amélioration des mots-clés seront ouvertes ultérieurement.
La documentation actuelle de Hy ASR 3.0 en aperçu spécifie la prise en charge d'une entrée PCM mono 16 kHz. Les applications utilisant MP3, AAC, Opus ou d'autres formats doivent convertir l'audio avant l'appel.
Envoyez-le à ce moteur.
Les développeurs utilisent l'API WebSocket de reconnaissance vocale en temps réel de Tencent Cloud et définissent engine_model_type sur Hy-ASR-3.0-preview. La connexion doit être signée avec les identifiants Tencent Cloud.
La page de facturation actuelle de Tencent Cloud ne répertorie pas de quota audio gratuit pour la reconnaissance du grand modèle 2.0. La page affiche des forfaits prépayés à partir de 60 heures à 1 CNY par heure, et une facturation postpayée à 1 CNY par heure, incluant 20 canaux concurrents.
/com/document/product/1093/135476) : statut officiel actuel, dialectes pris en charge, limitations et configuration de base.
La version d'aperçu Hy ASR 3.0 de Tencent Hunyuan combine l'encodeur vocal avec les capacités du modèle de langage Hy3 afin d'améliorer la transcription en mandarin, en anglais, en dialectes, en langues mixtes, dans les environnements bruyants et dans les contextes dépendants.
Tencent rapporte un WER de 3,34 % pour le mandarin, 2,62 % pour l'anglais et 3,12 % pour le cantonais sur des ensembles de données publiques agrégés, tout en obtenant des résultats de premier plan dans ses tests de scénarios internes. Ces chiffres sont prometteurs, mais doivent encore être validés sur l'audio propre à chaque organisation.
La version d'aperçu actuelle de Tencent Cloud est plus limitée que la vision complète de la version finale.
Elle prend en charge la reconnaissance WebSocket en temps réel, le PCM mono 16 kHz et une entrée audio d'une durée maximale de 60 secondes. L'injection de contexte externe, l'amélioration par mots-clés, la séparation des locuteurs et plusieurs autres fonctionnalités ne sont pas encore disponibles sur ce moteur.
Le changement clé n'est pas que la reconnaissance vocale n'écoute plus les sons, mais que le modèle de langage aide désormais à déterminer ce que les sons sont les plus susceptibles de vouloir dire.
Partez d’une phrase et obtenez un site complet en quelques minutes.



