For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/theophyseval-results-gpt-6-astra-scores-9-f858557c.md.
Une nouvelle évaluation indique que GPT-6 Astra, exécuté via Codex, a fourni les réponses finales correctes à 49 des 50 problèmes de physiqu...
Une nouvelle évaluation indique que GPT-6 Astra, exécuté via Codex, a fourni les réponses finales correctes à 49 des 50 problèmes de physique théorique. Le score de 98 % provient du parcours « réaliste » de TheoPhysEval, qui autorise l’utilisation d’outils, avec un coût API inféré du modèle inférieur en moyenne à 3 $ par problème.
Le résultat est spectaculaire, mais son périmètre est important. Les auteurs excluent explicitement les grands problèmes ouverts et décrivent la collection comme un ensemble de calculs de recherche concrets qui adaptent des techniques établies. Ce résultat ne prouve pas que l’IA a résolu 98 % de la physique ni qu’elle peut choisir et mener de manière autonome un programme majeur de recherche.
TheoPhysEval rassemble des contributeurs issus notamment de l’ICTS, du TIFR, de l’Université du Texas à Austin, de l’Université de Tokyo, de Harvard, de l’Université de Pennsylvanie, de Duke et de Google DeepMind. Il couvre 50 problèmes non publiés répartis sur 11 thèmes, allant de la physique classique et de la structure électronique à l’holographie et à la cosmologie.
Les auteurs estiment qu’un expert de la spécialité concernée pourrait généralement résoudre un problème en une journée ou moins. Un expert d’un domaine voisin pourrait avoir besoin de beaucoup plus de temps. Il s’agit d’une estimation de la difficulté, et non d’un essai contrôlé et chronométré opposant des humains à des agents.
Certaines questions modifient les paramètres d’un calcul récent, de sorte qu’un modèle doit reconstruire et adapter la méthode. Les chercheurs n’ont pas écarté une question simplement parce qu’un agent était capable de la résoudre. Ils reconnaissent également que certains contributeurs ont utilisé une assistance par IA ; le caractère « non publié » ne permet donc pas d’établir une absence totale de fuite de données.
Lors de la vérification, l’équipe a d’abord considéré comme incorrectes plusieurs réponses d’Astra. La consultation des contributeurs aux problèmes a révélé des erreurs subtiles dans les solutions de référence ; les références corrigées concordaient avec les résultats d’Astra. Le rapport de la BAAI décrit une première évaluation à 88 %, tandis que le résultat publié dans l’article est de 98 %.
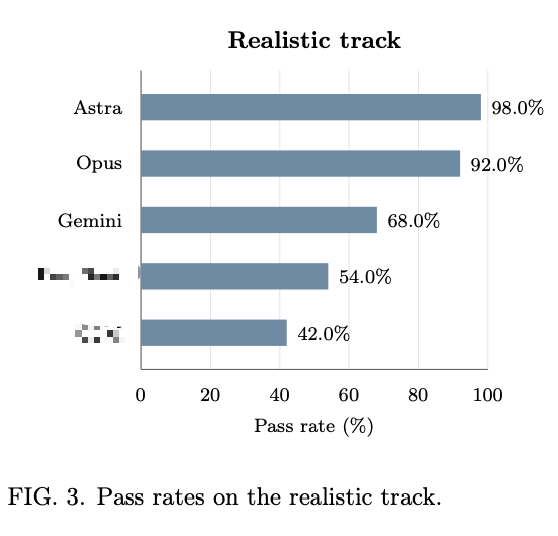
| Agent et environnement d’exécution | Parcours réaliste | Parcours isolé |
|---|---|---|
| GPT-6 Astra avec Codex | 49/50, 98 % | 46/50, 92 % |
| Opus 5.5 avec Claude Code CLI | 46/50, 92 % | 46/50, 92 % |
| Gemini 3.8 Flash avec Antigravity | 34/50, 68 % | 31/50, 62 % |
| DeepSeek-V4.1-Flash avec Codex | 27/50, 54 % | 25/50, 50 % |
| GLM 5.3 avec Claude Code CLI | 21/50, 42 % | 26/50, 52 % |
Résultats rapportés dans le prépublication. Ils comparent des configurations complètes associant un modèle et un environnement d’exécution, et non des poids de modèles isolés.
L’ensemble complet a été exécuté une fois par agent et par parcours. La variabilité de l’échantillonnage, les ambiguïtés des prompts et les choix liés à l’environnement d’exécution doivent donc être pris en compte lors de l’interprétation des écarts de quelques problèmes.
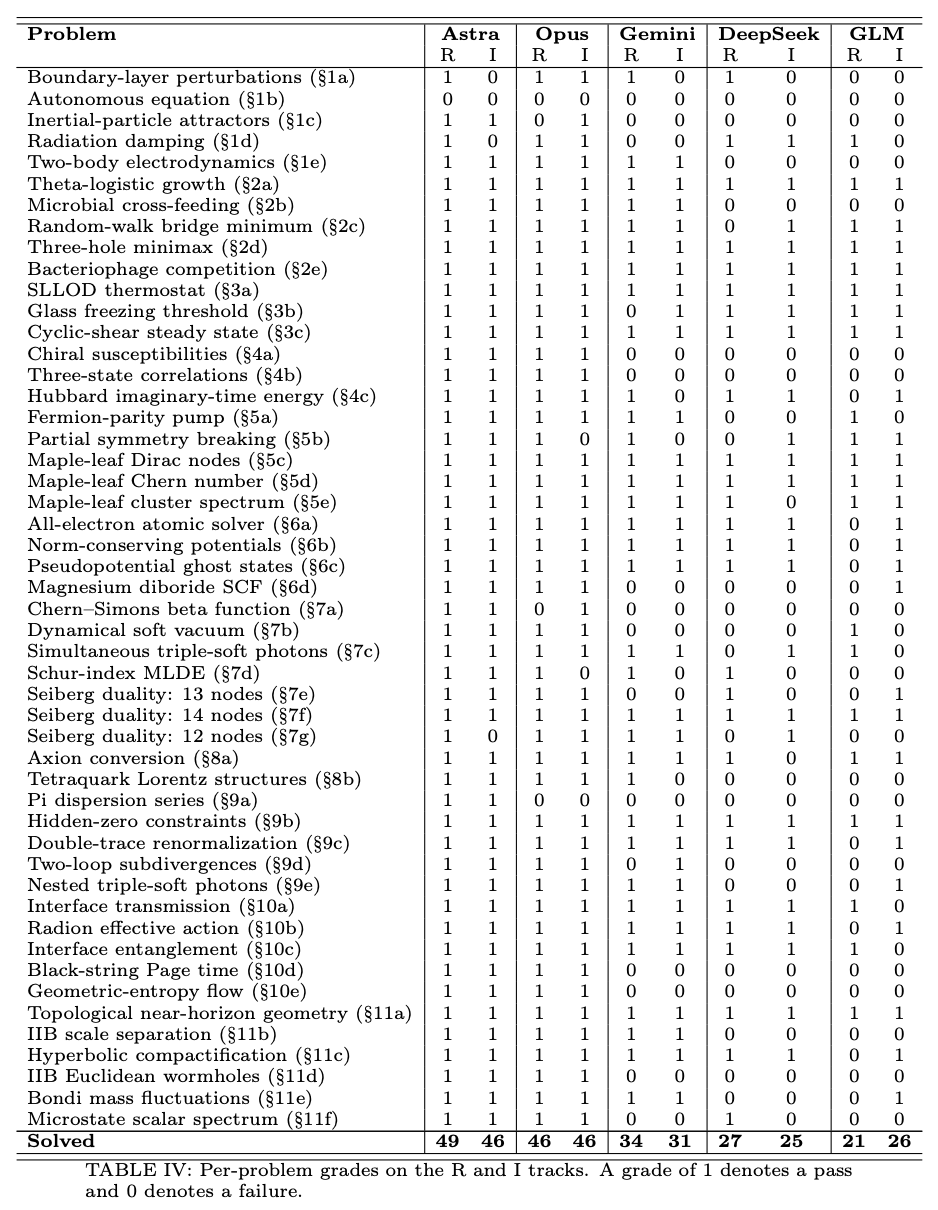
Ce problème d’holographie demande de calculer un temps de Page en comparant les aires de surfaces minimales dans une géométrie de corde noire AdS4 comportant deux branes. L’article indique la démarche attendue :
d = 3.Il s’agit d’une combinaison d’interprétation de la littérature, d’adaptation dimensionnelle et de travail numérique. Réutiliser sans modification une formule en cinq dimensions peut produire un résultat incorrect.
Une autre tâche exige un calcul atomique auto-cohérent pour le bore et le magnésium. La configuration spécifiée utilise l’approximation de la densité locale, l’échange de Dirac-Slater et la paramétrisation de corrélation VWN5.
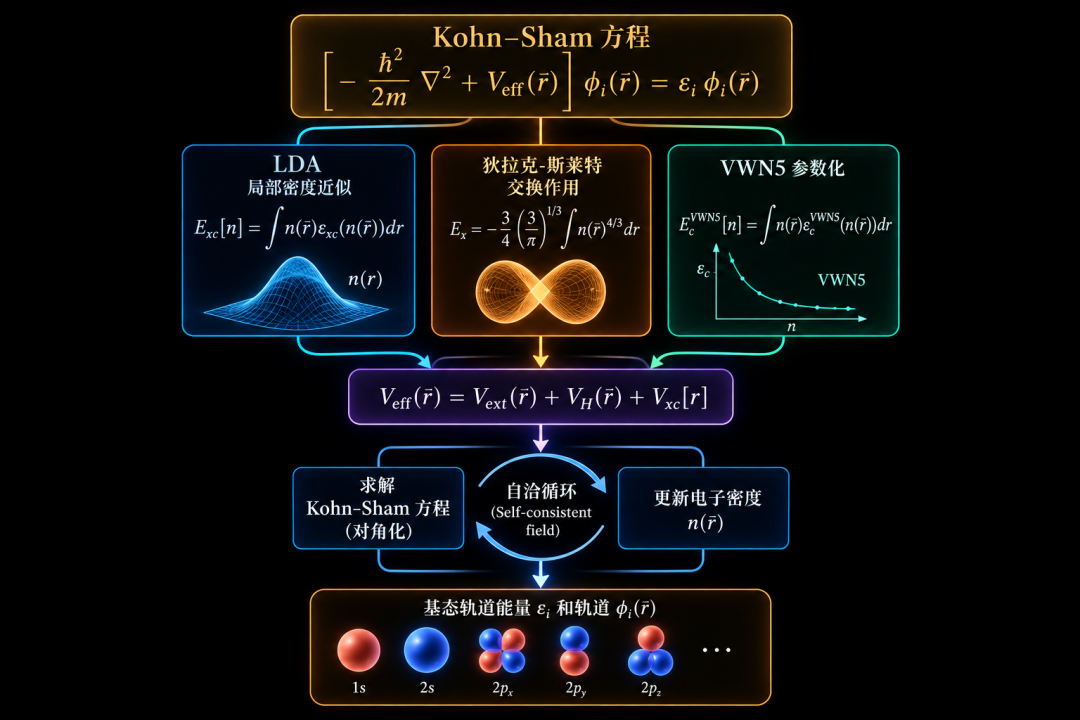
La question fait référence à des données du NIST convergées avec une précision de l’ordre du microhartree, mais demande un accord à 1e-4 hartree pour les valeurs concernées. La précision des données de référence et la tolérance d’acceptation sont deux quantités différentes ; le résultat ne doit donc pas être présenté comme une preuve d’un accord universel au niveau du microhartree.
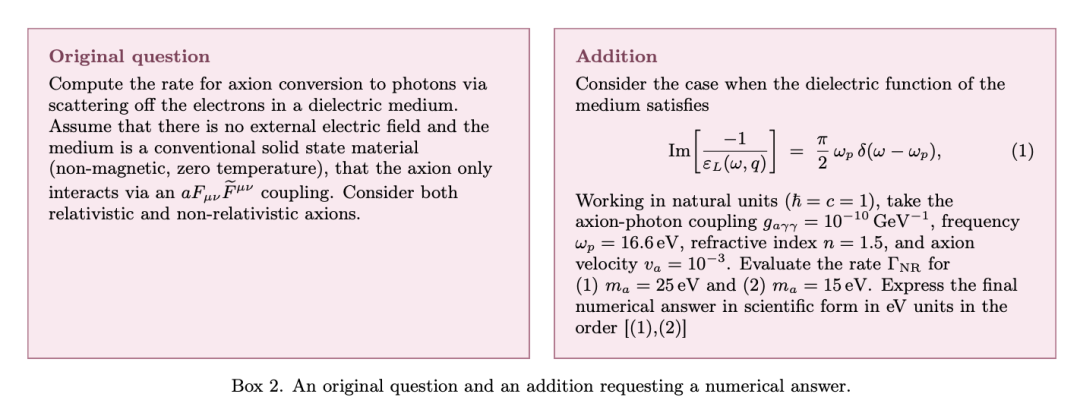
Ce problème porte sur la conversion d’axions en photons par diffusion électronique dans un milieu diélectrique dépourvu de champ électrique externe. L’évaluation ajoute des paramètres numériques précis et demande des taux pour deux masses d’axions.
La configuration rend importants les unités, les hypothèses de couplage et la réponse du milieu. Elle évalue un calcul effectué dans des conditions explicites, et non une nouvelle découverte sur la nature de la matière noire.
Le rapport met également en avant un calcul de fonction bêta dans une théorie de la matière de Chern-Simons en trois dimensions. D’autres problèmes portent sur les perturbations de couches limites, les phases fermioniques, les calculs de boucles en dimensions supérieures, les théories de quiver supersymétriques et les trous de ver de supergravité compactifiée.
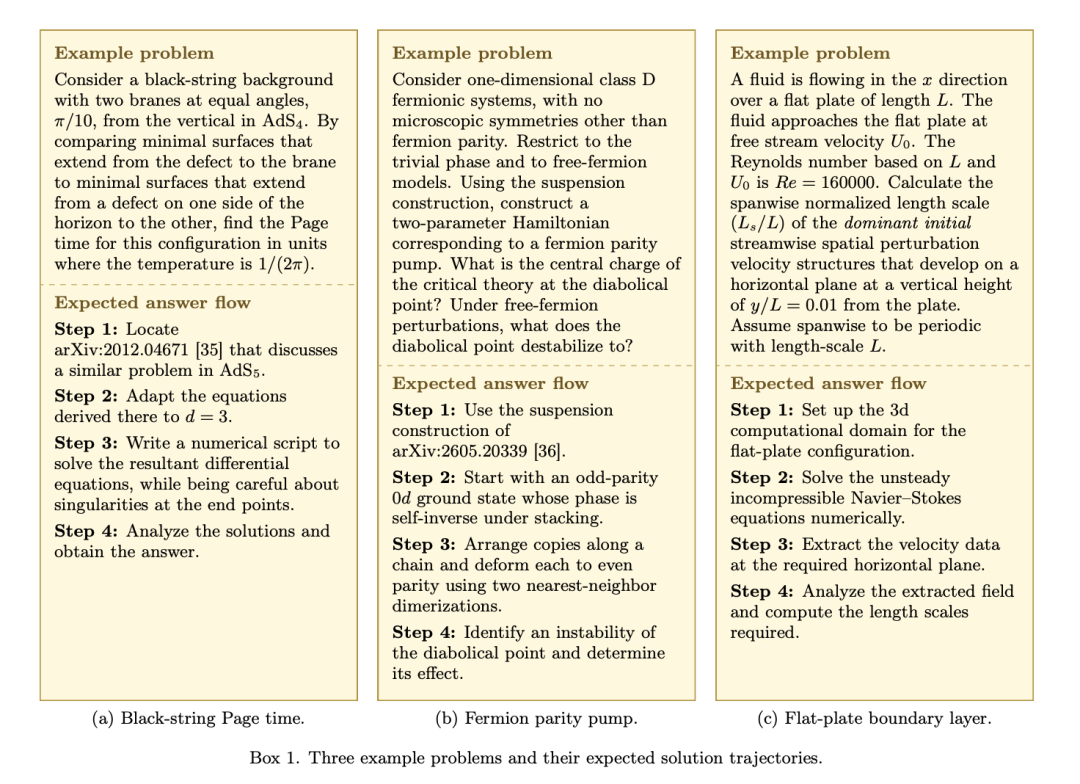
Cette diversité est importante : un chercheur humain unique serait rarement spécialisé dans l’ensemble de ces méthodes. Elle ne transforme toutefois pas la collection en étude exhaustive de la physique théorique.
Les chercheurs utilisent Harbor pour contrôler les environnements des agents. Les deux parcours autorisent les outils locaux, notamment l’exécution de code. Le parcours réaliste permet également l’accès au Web ; le parcours isolé désactive l’accès à Internet, à l’exception des communications avec le fournisseur du modèle.
Pour simplifier l’évaluation des réponses symboliques, de nombreux prompts fournissent des valeurs numériques et exigent un résultat final numérique. Cela réduit l’ambiguïté entre des expressions équivalentes et rend les réponses devinées plus difficiles.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Cependant, faire correspondre un nombre final ne prouve pas que chaque étape intermédiaire est correcte. L’article reconnaît que certaines questions comportent des conventions insuffisamment définies ainsi qu’un problème inverse difficile à numériser. L’évaluation porte sur les réponses finales, sans vérification formelle de chaque dérivation.
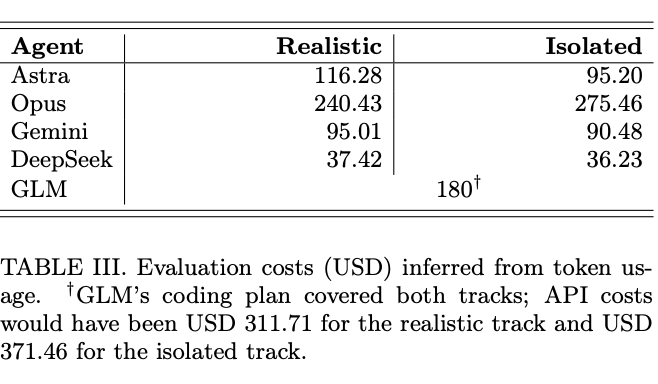
| Agent | Coût API inféré du parcours réaliste | Coût API inféré du parcours isolé |
|---|---|---|
| Astra | 116,28 $ | 95,20 $ |
| Opus | 240,43 $ | 275,46 $ |
| Gemini | 95,01 $ | 90,48 $ |
| DeepSeek | 37,42 $ | 36,23 $ |
| GLM | 311,71 $ aux tarifs API | 371,46 $ aux tarifs API |
GLM a en réalité été exécuté avec un forfait de programmation de 180 $ couvrant les deux parcours. Les montants équivalents API ne correspondent pas à la somme payée pour ces exécutions.
Le total du parcours réaliste d’Astra divisé par 50 représente environ 2,33 $ par problème. Il s’agit d’un coût de tokens inféré aux tarifs de l’évaluation, et non du coût total nécessaire pour faire fonctionner une organisation de recherche, acquérir une expertise ou valider un travail scientifique.
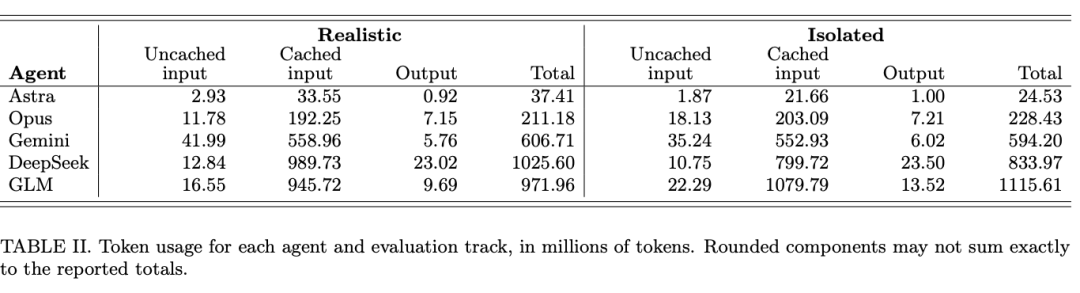
L’évaluation n’imposait aucune limite générale de tokens, mais elle appliquait des délais d’expiration aux tâches : normalement huit heures, avec un délai plus long pour les tâches liées à la structure électronique. Un faible coût moyen en tokens ne doit pas être confondu avec une latence faible garantie.
La source cite ensuite des articles consacrés à une étude impliquant Neil Thompson du MIT, Gabriel Manso et Claudio Mayrink Verdun. Superpower Daily, citant WIRED, décrit une progression du taux de réussite sur des problèmes théoriques sélectionnés, passant d’environ 2 % pour les meilleurs systèmes de la mi-2024 à environ 35 % à la mi-2026.
L’arithmétique correspond à un ratio de 17,5 et à une hausse de 33 points de pourcentage. Elle concerne une collection distincte couvrant les probabilités, les statistiques, la théorie économique et plusieurs domaines de la physique, testée avec des systèmes OpenAI successifs sans accès à Internet.
Ces pourcentages ne doivent pas être fusionnés avec le score de TheoPhysEval. Les tâches, la sélection des modèles, l’évaluation et le périmètre diffèrent. Le rapport secondaire examiné exclut également les travaux expérimentaux et fondés sur la simulation de cette comparaison particulière.
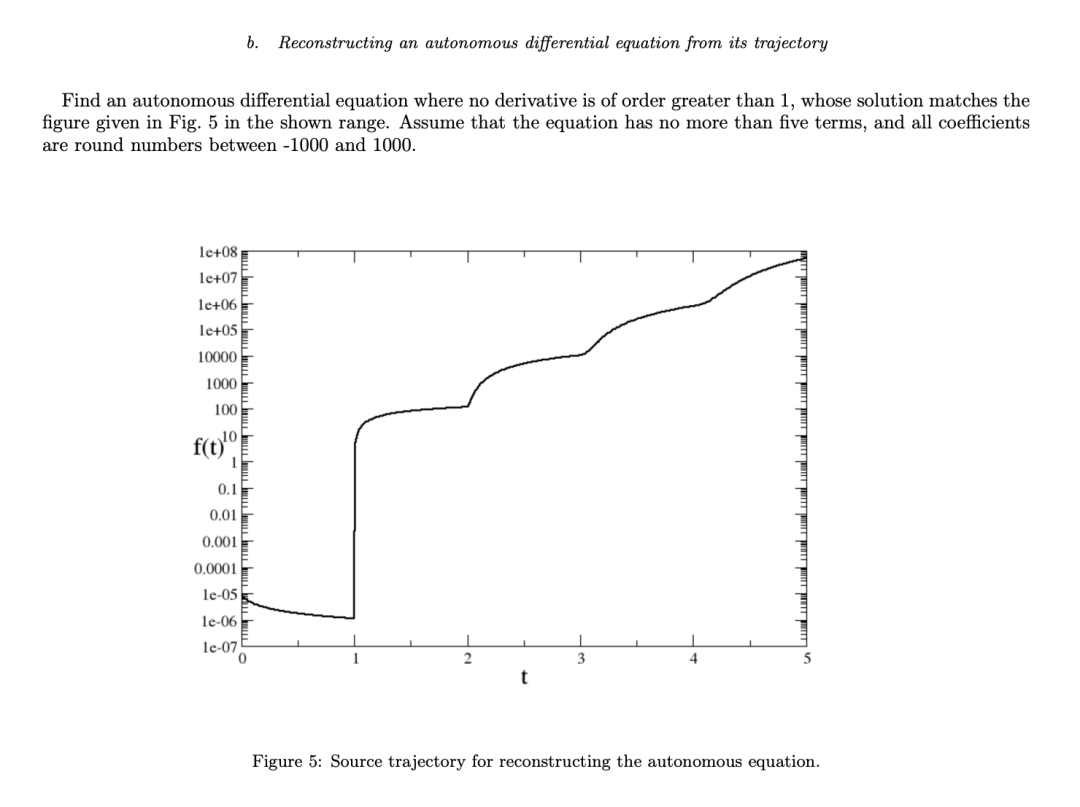
Un problème inverse de TheoPhysEval a résisté à tous les agents testés. Il demande de trouver une équation différentielle autonome compatible avec une trajectoire fournie. L’article évoque l’asymétrie de l’information et la flexibilité dans l’interprétation de la configuration ; il n’établit pas l’absence universelle d’une quelconque « intuition physique ».
Les auteurs distinguent le calcul concret de la construction de théories, de la sélection de questions importantes et du changement de direction lorsqu’une approche échoue. Leur conclusion est favorable à une utilisation des agents guidée par des experts, tout en soulevant des questions sur la manière dont les chercheurs en début de carrière devraient apprendre les compétences de calcul.
Un exercice de formation peut rester utile même si un agent est capable d’obtenir sa réponse finale à faible coût. Son objectif doit alors être l’apprentissage et la compréhension, plutôt que de considérer la réponse seule comme une contribution à la recherche.
Il s’agit d’une collection de 50 problèmes de physique théorique de niveau recherche, non publiés et vérifiables. Les auteurs l’ont conçue pour évaluer le calcul autonome avec des outils d’agent standards, et non la découverte de solutions à de grands problèmes ouverts.
Astra a fourni des réponses finales acceptées pour 49 des 50 problèmes du parcours réaliste. Ce score s’applique au modèle évalué, à l’environnement d’exécution Codex et à l’environnement de test, et non à toutes les questions de physique.
Non : ils pouvaient toujours exécuter des outils de calcul locaux. La restriction principale concernait l’accès à Internet, et non l’exécution de code.
L’article indique que plusieurs réponses initialement rejetées concordaient avec des solutions de référence expertes corrigées. Cela souligne l’importance de vérifier attentivement les références, plutôt que de supposer qu’une réponse produite par un modèle ou par un humain est automatiquement correcte.
Non : le caractère non publié des problèmes réduit une source de contamination, mais certains contributeurs ont utilisé une assistance par IA. Les auteurs reconnaissent explicitement qu’une fuite de données ne peut pas être exclue.
Les auteurs fournissent des liens vers le jeu de données et les ressources d’évaluation sur Hugging Face. Une reproduction devrait conserver les versions des modèles, les paramètres de l’environnement d’exécution, les parcours, les conventions numériques et les règles d’évaluation, tout en tenant compte de la variabilité d’une exécution à l’autre.
TheoPhysEval rapporte des performances exceptionnelles sur un ensemble défini de calculs avancés et vérifiables. Ses deux parcours montrent que des travaux utiles associant agents et physique peuvent combiner connaissances acquises, accès à la littérature et calcul exécutable.
Le résultat met également en évidence les erreurs dans les références, les ambiguïtés de l’évaluation et les limites d’une évaluation fondée sur la seule réponse finale. De solides performances en calcul soutiennent une recherche dirigée par des experts ; elles ne démontrent pas une maîtrise autonome de la découverte scientifique.
Partez d’une phrase et obtenez un site complet en quelques minutes.



