For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/typesafe-jev-vs-openai-decisions-api-fast-7c48d620.md.
Une nouvelle entreprise d’IA a levé **870 millions de dollars** quelques semaines seulement après avoir lancé un modèle qui ne cherche pas à...
Une nouvelle entreprise d’IA a levé 870 millions de dollars quelques semaines seulement après avoir lancé un modèle qui ne cherche pas à rédiger des essais, du code ou des réponses conversationnelles conviviales.
Cette entreprise est TypeSafe AI.
Son modèle s’appelle Jev.
TypeSafe a annoncé sa série A le 9 octobre 2026, pour une valorisation de 7,5 milliards de dollars. Andreessen Horowitz a dirigé le tour de table, auquel ont participé Sequoia Capital, l’investisseur historique DCVC et d’autres investisseurs.
L’équipe fondatrice de l’entreprise a également attiré l’attention.
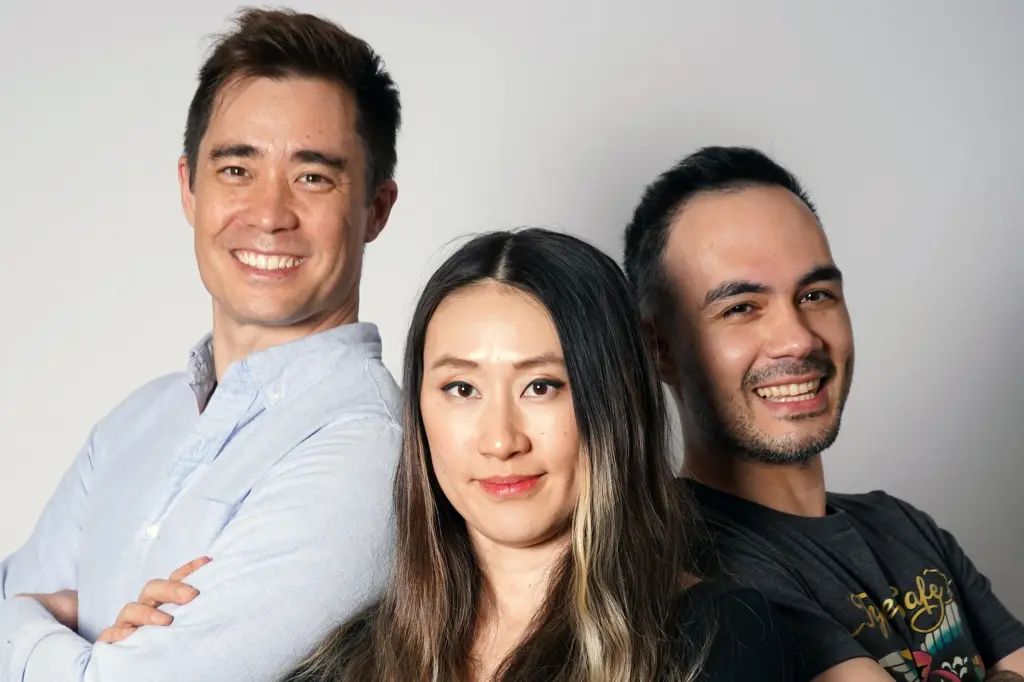
TypeSafe a été fondée par Erik Gafni, Sasha Sheng et Diogo Almeida. Almeida a auparavant travaillé chez OpenAI, où il a contribué aux recherches à l’origine des systèmes de suivi des instructions de l’ère ChatGPT. Sheng a précédemment travaillé chez Meta/FAIR, tandis que Gafni possède une expérience dans l’ingénierie et les start-up.
Jev a été lancé publiquement le 15 septembre.
Deux semaines plus tard seulement, OpenAI a annoncé un aperçu limité d’une orientation produit étonnamment similaire : une API rapide capable de renvoyer des probabilités, des choix et des scores au lieu de longs textes générés. OpenAI a fait passer ce produit, l’API Decisions, en bêta publique le 6 octobre.
Nikunj Handa, responsable produit des API chez OpenAI, a ensuite reconnu ouvertement que Jev avait inspiré cette catégorie de produits.
Cela rend Jev intéressant pour deux raisons.
Premièrement, il propose une autre façon d’utiliser l’IA au sein des logiciels.
Deuxièmement, il a contraint un laboratoire de pointe à réagir de manière inhabituellement rapide.
Jev ne cherche pas à être l’IA avec laquelle vous discutez.
Il cherche à être l’IA que votre logiciel appelle des milliers ou des millions de fois sans que vous ne voyiez jamais la réponse.
Ouvrez une boîte de réception et des centaines de petits jugements attendent d’être effectués.
Ce message est-il important ?
Contient-il une facture qui arrive bientôt à échéance ?
Nécessite-t-il une réponse urgente ?
L’heure de la réunion a-t-elle changé ?
Doit-il être archivé, transmis à un niveau supérieur ou ignoré ?
Un modèle de langage généraliste peut déjà répondre à ce type de questions.
Le problème est qu’un LLM classique est souvent conçu pour générer du langage.
Pour un seul e-mail, cette surcharge peut être négligeable.
À grande échelle, elle devient significative.
Si une application prend le même type de décision des milliers ou des millions de fois par jour, de petites différences de latence et de coût deviennent des dépenses opérationnelles importantes.
Jev est spécifiquement conçu pour ces jugements répétitifs.
TypeSafe décrit Jev comme un modèle System One.
Cette appellation fait référence au style de cognition rapide et intuitif du « Système 1 », popularisé par Daniel Kahneman.
Au lieu de demander à Jev de générer un paragraphe, une application lui fournit un état et un ensemble de questions prédéfinies.
Jev renvoie des valeurs typées telles que :
L’application peut utiliser directement le résultat.
Un schéma simplifié ressemble à ceci :
E-mail entrant
      ↓
Jev évalue plusieurs questions
      ↓
urgent_reply = 0.91
billing_related = 0.74
meeting_change = 0.03
      ↓
L’application applique ses propres règles
      ↓
Alerte / archivage / acheminement / vérification
La différence importante réside dans l’interface.
Avec un modèle de langage généraliste, les développeurs demandent souvent un format JSON ou une autre structure, puis valident la réponse générée.
Avec Jev, les sorties de décision typées constituent le cœur de la conception du produit.
L’API de TypeSafe expose un point de terminaison systemone et permet aux développeurs de soumettre plusieurs questions portant sur le même état partagé.
TypeSafe met l’accent sur la prise de décision en parallèle.
Si une application veut évaluer la même entrée selon plusieurs critères indépendants, ces questions peuvent être envoyées ensemble au lieu de transformer chacune d’elles en échange conversationnel distinct.
Cela est utile pour les logiciels qui doivent répondre à des questions telles que :
L’application combine ensuite ces résultats à l’aide de code classique.
C’est l’une des raisons pour lesquelles Jev ressemble moins à un chatbot qu’à une instruction conditionnelle intelligente.
TypeSafe affiche actuellement Jev aux tarifs suivants :
| Usage | Tarif de Jev |
|---|---|
| Entrée | 0,042 $ / 1 M de tokens |
| Sortie | Gratuite |
TypeSafe indique que la sortie est trop peu coûteuse pour être facturée, car Jev ne génère pas de longues séquences de texte de manière autorégressive.
Ce prix est important, car Jev cible des décisions susceptibles d’être prises extrêmement fréquemment.
Une décision trop coûteuse pour être automatisée à chaque action utilisateur peut devenir viable lorsque son coût diminue d’un ordre de grandeur.
Cela crée une nouvelle question de déploiement.
Au lieu de demander :
Cette action est-elle suffisamment importante pour appeler un modèle d’IA ?
Les équipes logicielles peuvent commencer à demander :
Pourquoi ne pas laisser l’IA évaluer également cette petite étape ?
C’est l’argument économique qui sous-tend le produit.
Le prix annoncé par token ne constitue qu’une partie du coût de production.
Les équipes doivent toujours mesurer :
Une décision bon marché qui est trop souvent erronée peut tout de même coûter cher.
Ce point devient important dans l’évaluation indépendante de Jev présentée plus loin.
Vercel a ajouté Jev à AI Gateway presque immédiatement après son lancement.
La réaction du premier jour a été exceptionnellement forte.
Selon Vercel, dans les 24 heures, Jev avait été utilisé par près de 13 % des équipes payantes d’AI Gateway.
Ce chiffre représentait plus du double de la portée atteinte le premier jour par tout autre lancement de modèle précédent sur la plateforme.
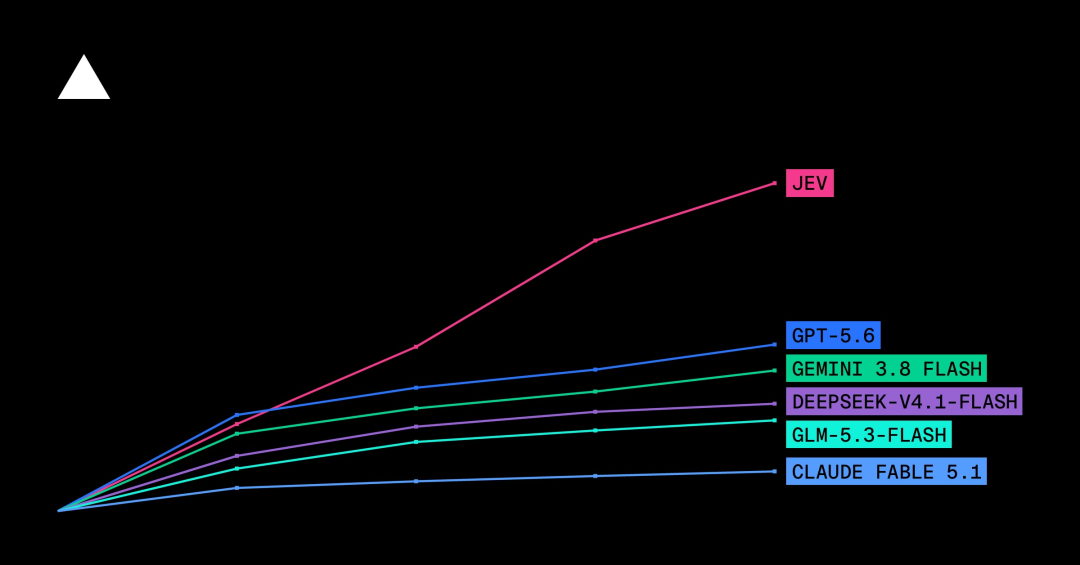
Vercel a ensuite qualifié Jev de modèle adopté le plus rapidement de l’histoire d’AI Gateway.
Cette progression du premier jour ne prouve pas une fidélisation à long terme.
Elle montre toutefois que les développeurs ont immédiatement identifié une catégorie de tâches pour lesquelles un modèle de décision spécialisé pouvait être utile.
Vercel cite notamment les exemples suivants :
Ces tâches ne sont pas particulièrement prestigieuses.
Elles correspondent précisément au type de tâches que les logiciels de production exécutent constamment.
L’idée à l’origine de Jev n’est pas apparue du jour au lendemain.
Diogo Almeida a expliqué que, lorsqu’il travaillait chez OpenAI, il s’était de plus en plus intéressé à une question fondamentale :
Si l’IA transforme l’économie, qui effectuera la plupart des appels aux modèles à l’avenir ?
Des humains ouvrant manuellement des fenêtres de discussion ?
Ou des logiciels appelant automatiquement une intelligence en arrière-plan ?
Sa réponse était la seconde option.
Cela modifie les critères qu’une interface d’IA doit optimiser.
Les modèles destinés aux utilisateurs humains bénéficient d’une conversation naturelle, d’une prose flexible, d’explications et de créativité.
Les modèles destinés aux logiciels bénéficient de :
Almeida a décrit Jev comme une réponse à l’écart entre des modèles impressionnants sur le plan conversationnel et des modèles faciles à utiliser comme primitives logicielles fiables.
TypeSafe indique avoir consacré environ deux ans au développement du système avant son lancement public.
Le lancement de Jev n’est pas passé inaperçu chez OpenAI.
Dans une interview de Latent Space enregistrée autour d’OpenAI DevDay, Nikunj Handa, responsable produit des API, a directement reconnu que Jev avait inspiré l’orientation de l’API Decisions.
Il a expliqué que les utilisateurs et les équipes internes demandaient un système de classification beaucoup plus rapide.
Il a également confirmé que le projet ne figurait pas encore sur la feuille de route quelques semaines auparavant.
OpenAI n’a pas entraîné un tout nouveau modèle de base uniquement pour la première version.
L’entreprise a plutôt utilisé GPT-6 Luna et construit autour de ce modèle une interface de décision et un chemin d’inférence dédiés.
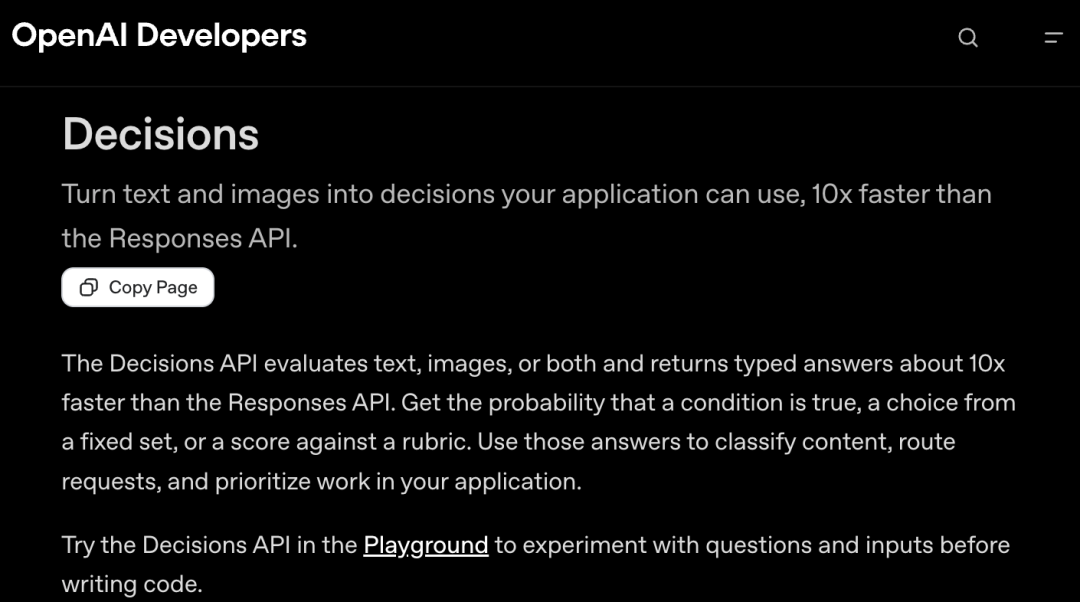
Le résultat est désormais disponible en bêta publique via :
POST /v1/decisions
L’API Decisions accepte des éléments probants partagés ainsi qu’une ou plusieurs questions, puis renvoie des réponses typées.
OpenAI prend actuellement en charge trois types de questions :
| Type de question | Résultat |
|---|---|
predicate | Probabilité qu’une condition soit vraie |
choice | Une option sélectionnée ainsi que des probabilités ou un niveau de confiance |
score | Un score réparti sur des niveaux ordonnés |
Cela recoupe fortement les cas d’usage ciblés par Jev.
Il s’agit aujourd’hui de la plus grande différence architecturale entre les produits publics.
TypeSafe indique que Jev utilise une architecture de modèle spécialisée ainsi qu’une méthode d’entraînement appelée Reinforcement Learning for Calibrated Decisions (RLCD).
La première version de l’API Decisions d’OpenAI utilise au contraire les poids existants de GPT-6 Luna, avec une interface dédiée au service des décisions.
Conceptuellement :
TypeSafe :
Modèle de décision spécialisé
→ sortie probabiliste typée

OpenAI :
GPT-6 Luna
→ chemin spécialisé de l’API Decisions
→ sortie probabiliste typée
Les deux produits peuvent donc sembler similaires pour les développeurs tout en adoptant des approches différentes en interne.
La modalité d’entrée constitue une différence pratique.
L’API Decisions actuelle d’OpenAI accepte du texte, des images ou les deux.
Le lancement public de Jev par TypeSafe était principalement axé sur les entrées textuelles ou représentant un état.
La documentation d’OpenAI comprend un exemple dans lequel l’API inspecte la photo d’un produit et estime si des dommages visibles sont présents, comme une fissure, une déchirure ou une bosse.
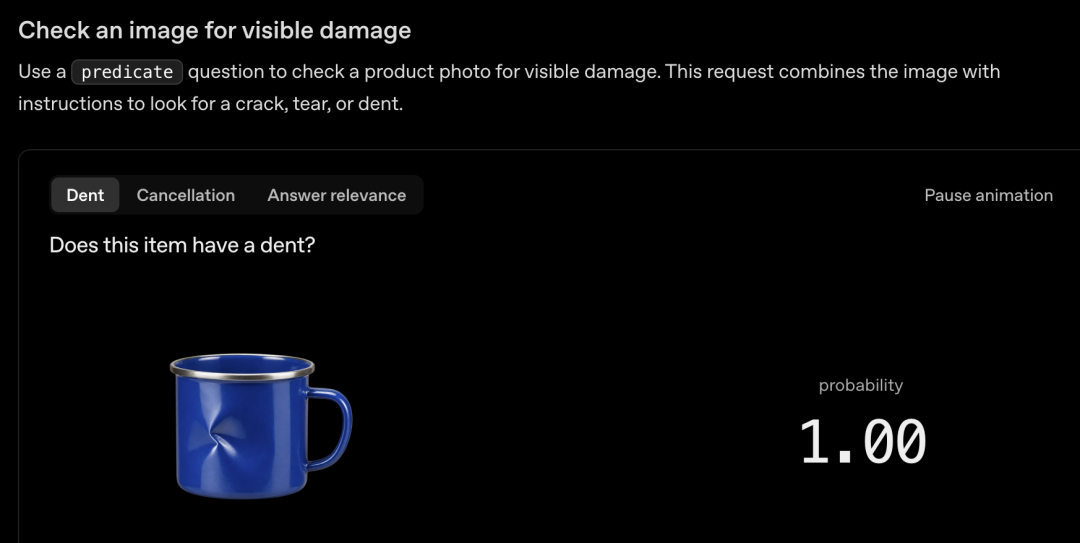
Une application de commerce électronique pourrait utiliser ce modèle pour orienter automatiquement les images vers une vérification.
Par exemple :
Photo du produit
→ L’API Decisions vérifie les dommages visibles
→ probabilité = élevée
→ acheminement vers une inspection manuelle
C’est un bon exemple de la manière dont les API de décision peuvent s’intégrer dans des logiciels ordinaires sans produire de réponse destinée à l’utilisateur.
L’utilisateur peut ne jamais savoir quel modèle a évalué la photo.
Il ne fait qu’expérimenter le flux de travail qui en résulte.
La tarification publique actuelle est simple.
| Produit | Prix d’entrée | Prix de sortie |
|---|---|---|
| TypeSafe Jev | 0,042 $ / 1 M de tokens | Gratuit |
| API Decisions d’OpenAI avec GPT-6 Luna | 0,10 $ / 1 M de tokens | Gratuit |
Sur le prix de base des tokens d’entrée, Jev est moins cher.
La documentation Decisions d’OpenAI indique que l’API renvoie des réponses typées environ 10 fois plus rapidement que l’API Responses.
Cette affirmation de facteur 10 correspond spécifiquement à une comparaison avec le propre chemin Responses d’OpenAI.
Il ne s’agit pas d’un avantage de vitesse publié de 10 fois par rapport à Jev dans une comparaison directe.
Cette distinction est importante.
De même, TypeSafe publie des multiplicateurs de vitesse et de coût bien plus importants dans ses propres évaluations de flux de travail, tout en reconnaissant explicitement que ces tests reposent sur sa propre méthodologie et peuvent se situer dans la partie haute des gains observés dans le monde réel.
Pour choisir une solution en production, les équipes doivent réaliser des benchmarks sur leur charge de travail réelle.
Ce qui rend cette histoire produit inhabituelle, c’est la franchise avec laquelle OpenAI a reconnu cette inspiration.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Dans l’interview de Latent Space, Handa a déclaré que Jev avait inspiré la catégorie et que les utilisateurs ainsi que les équipes internes d’OpenAI avaient rapidement commencé à demander une capacité de classification rapide similaire.
Il a décrit une petite équipe interne qui a rapidement construit un prototype avant d’en optimiser la latence.
Cela ne signifie pas que Jev et l’API Decisions sont identiques.
Cela montre en revanche que TypeSafe a identifié une véritable lacune produit.
La concurrence ne porte plus seulement sur la question suivante :
Qui possède le modèle généraliste le plus performant ?
Elle porte aussi sur une autre question :
Quelle est la primitive de modèle la moins chère et la plus rapide
pour une décision répétée spécifique au sein d’un logiciel ?
Il s’agit d’un marché différent de celui de l’évaluation traditionnelle des chatbots.
Le faible prix de Jev a fait l’objet d’un examen indépendant utile peu après son lancement.
Le 29 septembre, des chercheurs de l’Université de Bonn et de l’Institut Lamarr ont soumis une prépublication évaluant Jev 1.13.0.
L’étude portait sur :
Le coût total de l’API Jev était inférieur à 10 dollars.
Ce chiffre est remarquable.
Mais la partie la plus importante de l’article concerne la fiabilité.
Les chercheurs ont constaté que les probabilités de choix de Jev pouvaient être utiles pour la prédiction sélective.
En termes simples :
Si le système ne répond qu’aux cas pour lesquels il est le plus confiant, la précision peut être plus élevée.
Lorsque l’application accepte davantage de cas à faible confiance, la précision diminue.
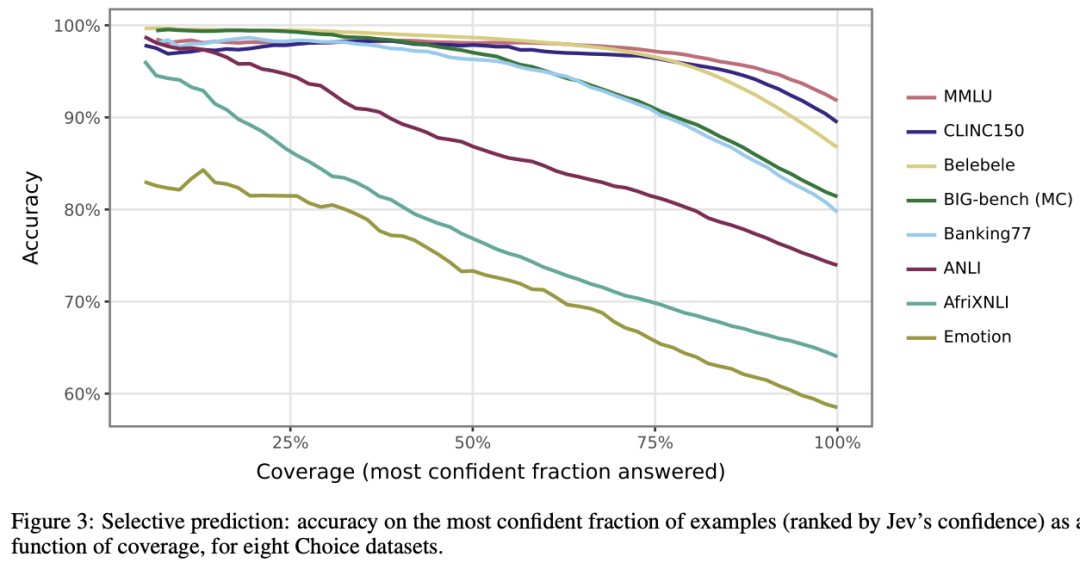
C’est précisément la raison pour laquelle les probabilités sont utiles dans l’automatisation.
Un flux de production peut définir des comportements différents selon plusieurs niveaux de confiance.
Par exemple :
confiance >= 0.95
→ automatiser

0.70 <= confiance < 0.95
→ demander une vérification secondaire

confiance < 0.70
→ vérification humaine
Les seuils exacts doivent provenir des données d’évaluation, et non de l’intuition.
L’étude a mis en évidence une réserve importante concernant les décisions binaires.
Les probabilités de Jev pouvaient bien classer les exemples tout en étant mal positionnées autour d’un seuil fixe de 0,5.
Cela signifie que la règle suivante :
si probabilité >= 0.5 :
    agir
n’est pas automatiquement optimale pour chaque tâche.
Dans une évaluation UNFAIR-ToS, les chercheurs ont indiqué que l’ajustement des seuils sur les données d’entraînement avait amélioré le micro-F1 de 0,50 à 0,75.
La leçon générale est simple :
Une probabilité est utile, mais l’application doit toujours déterminer à partir de quelle probabilité il est suffisamment justifié d’agir.
Cela ne concerne pas uniquement Jev.
Il s’agit d’une exigence fondamentale pour déployer de manière responsable des classificateurs probabilistes.
Revenons à l’exemple des e-mails.
Supposons qu’un modèle marque par erreur un e-mail promotionnel comme important.
Le coût se limite à une petite gêne.
Imaginons maintenant qu’il manque un e-mail nécessitant une réponse avant la fin de la journée.
Le coût peut être beaucoup plus élevé.
Le seuil approprié dépend donc de l’asymétrie entre les faux positifs et les faux négatifs.
Un système pratique peut appliquer des règles différentes selon les décisions :
| Décision | Paramètre par défaut le plus prudent |
|---|---|
| Détection des e-mails promotionnels | Automatiser de manière agressive |
| Détection des échéances de facturation | Utiliser un seuil plus bas pour les alertes |
| Classification juridique ou de conformité | Transférer les cas incertains |
| Action à haut risque sur un compte | Exiger une confirmation humaine |
| Étiquetage de contenu à faible valeur | Automatiser la plupart des cas |
Un modèle de décision performant n’élimine pas les règles métier.
Il facilite l’expression de ces règles métier dans le logiciel.
TypeSafe insiste sur le fait que la sortie de Jev est sûre du point de vue des types.
Il s’agit d’une véritable propriété d’ingénierie.
Si le développeur définit un ensemble de sorties autorisées, le modèle n’a pas besoin d’inventer une chaîne arbitraire qui ne respecterait pas ce schéma.
Mais il existe deux types de correction différents :
La sortie correspond au type autorisé.
La réponse sélectionnée est effectivement correcte.
Un modèle de décision peut garantir beaucoup plus fortement la première que la seconde.
L’évaluation indépendante rend cette distinction évidente : Jev peut toujours sélectionner la mauvaise réponse, même si sa réponse est parfaitement valide en tant que valeur typée.
C’est pourquoi l’interprétation la plus prudente pour la production est la suivante :
Jev élimine une grande catégorie d’erreurs de formatage et d’analyse, mais il ne supprime pas les erreurs du modèle.
La source originale souligne à juste titre que tous les jugements ne doivent pas être confiés à Jev.
Les propres documents de TypeSafe reconnaissent que les modèles System One spécialisés jouent un rôle plus limité que les modèles de langage généralistes.
Une répartition utile du travail peut être définie ainsi :
Exemples :
Exemples :
Exemples :
Exemples :
Un modèle bon marché ne doit pas créer une nouvelle dépense en produisant des décisions que les équipes doivent constamment corriger.
Le nom Jev fait référence à l’économiste William Stanley Jevons.
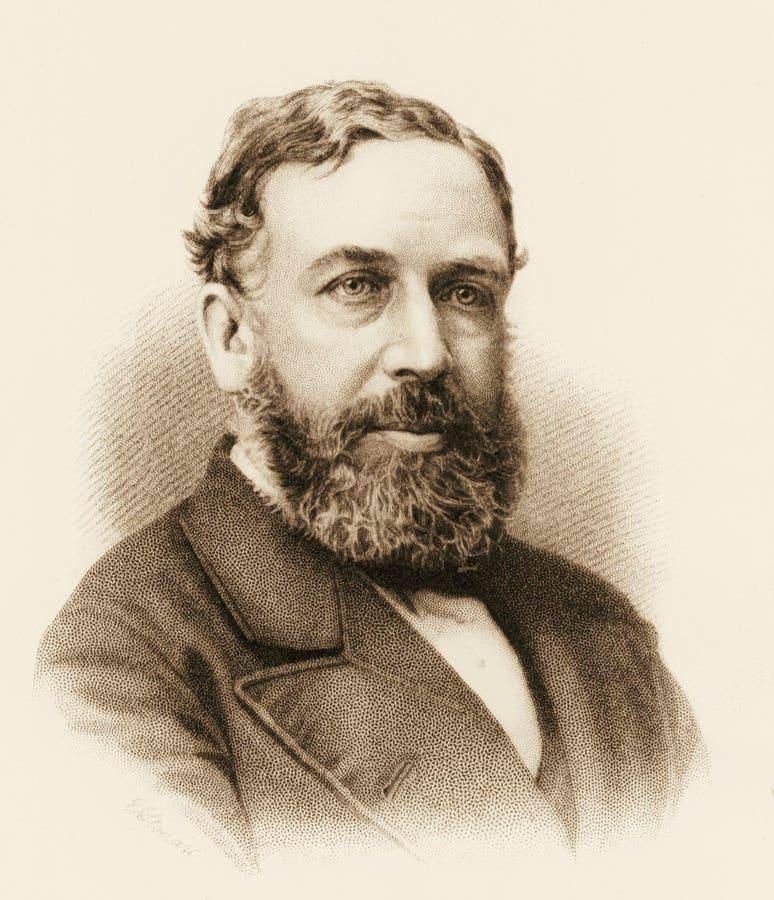
Jevons est associé à l’idée désormais appelée paradoxe de Jevons.
La version simplifiée est la suivante :
La ressource devient plus efficace
→ le coût par utilisation diminue
→ la demande augmente
→ la consommation totale de ressources peut augmenter
TypeSafe applique cette logique à l’intelligence machine.
Si chaque appel à l’IA devient beaucoup moins cher, les logiciels ne se contenteront peut-être pas de dépenser moins pour les mêmes charges de travail.
Les développeurs pourraient créer de nouvelles charges de travail qu’il était auparavant trop coûteux de justifier.
Cela est déjà visible dans des exemples tels que :
Le résultat pourrait être un coût par décision inférieur, mais un nombre total de décisions bien plus élevé.
C’est le pari du paradoxe de Jevons qui se trouve derrière Jev.
La partie la plus importante de cette tendance pourrait être invisible pour les utilisateurs.
Aujourd’hui, les utilisateurs interagissent souvent explicitement avec l’IA :
Ouvrir un chatbot
→ coller le contexte
→ rédiger une invite
→ lire la réponse
→ recopier le résultat dans un autre outil
Les modèles de décision natifs pour les machines suggèrent un autre modèle :
L’utilisateur utilise un logiciel classique
→ l’IA évalue de petites décisions en arrière-plan
→ le logiciel achemine, note, vérifie ou filtre automatiquement
→ l’humain ne voit que les cas importants
Une boîte de réception peut n’afficher que les messages urgents.
Un outil d’écriture peut signaler uniquement les phrases qui nécessitent une vérification.
Un agent peut sélectionner automatiquement l’outil suivant.
Un système d’assistance peut acheminer les tickets avant qu’une personne ne les voie.
Une marketplace peut classer les candidats immédiatement après leur inscription.
À ce stade, l’utilisateur peut ne pas se soucier de savoir si le système sous-jacent utilise Jev, GPT-6 Luna ou un autre modèle de décision.
Ce qui l’intéresse, c’est que le logiciel semble plus rapide et nécessite moins d’étapes manuelles.
La levée de fonds de TypeSafe prend tout son sens dans cette perspective.
L’entreprise ne parie pas sur le fait que les utilisateurs souhaitent ouvrir un nouvel onglet de chatbot.
Elle parie sur le fait que les logiciels effectueront un nombre considérable d’appels aux modèles.
TypeSafe indique qu’un tiers des entreprises du Fortune 500 utilisent déjà Jev, même s’il s’agit d’un chiffre d’adoption communiqué par l’entreprise et que celle-ci n’a pas nommé publiquement tous ces clients.
La série A de 870 millions de dollars donne à TypeSafe un capital important pour développer cette stratégie.
Dans son annonce de financement, l’entreprise indique vouloir construire :
La réaction rapide d’OpenAI avec l’API Decisions suggère que les grands laboratoires voient la même opportunité.
La prochaine question concurrentielle n’est pas simplement de savoir quel système est le moins cher.
Il s’agit de déterminer lequel produit des décisions suffisamment fiables pour que les développeurs acceptent de laisser les logiciels agir automatiquement sur leur base.
Jev est le premier « modèle System One » de TypeSafe AI, conçu pour prendre rapidement des décisions lisibles par les machines plutôt que pour générer du texte libre. Il reçoit un état partagé ainsi que des questions typées et renvoie des choix, des scores ou des probabilités que les logiciels peuvent utiliser directement.
TypeSafe affiche actuellement Jev à 0,042 dollar par million de tokens d’entrée, avec une sortie gratuite. Le coût réel d’une application dépend du volume de requêtes, de la taille des entrées, des nouvelles tentatives, des frais d’évaluation et du nombre de cas transmis à des modèles plus puissants ou à des humains.
TypeSafe décrit Jev comme un modèle System One fondé sur un transformeur, plutôt que comme un modèle de langage de grande taille classique destiné à la génération de texte. Son comportement produit distinctif est de ne pas générer de prose arbitraire, mais de renvoyer des décisions probabilistes typées.
Oui. La sûreté des types évite certaines erreurs de formatage et de schéma, mais la décision sélectionnée peut toujours être sémantiquement incorrecte. Une évaluation indépendante montre de bons résultats sur de nombreux jeux de données, tout en révélant des erreurs dépendantes de la tâche et des problèmes de calibrage des seuils.
L’API Decisions d’OpenAI est un point de terminaison en bêta publique, alimenté par GPT-6 Luna, qui transforme du texte ou des images en prédicats, choix ou scores typés. OpenAI la présente comme environ 10 fois plus rapide que l’utilisation de l’API Responses pour un travail de même catégorie.
Le prix actuel de l’API Decisions est de 0,10 dollar par million de tokens d’entrée, sans facturation des tokens de sortie. Le prix de base publié pour Jev est inférieur, à 0,042 dollar par million de tokens d’entrée, avec une sortie également gratuite.
Une probabilité n’indique pas à elle seule quelle action l’application doit prendre. Les équipes doivent choisir leurs seuils à partir de données d’évaluation annotées et du coût réel des faux positifs, des faux négatifs et de la vérification humaine, plutôt que de supposer que 0,5 constitue toujours le seuil approprié.
Les modèles de décision sont particulièrement adaptés à la classification, à l’acheminement, à l’attribution de scores, à la vérification et au branchement à grande échelle lorsque les sorties possibles peuvent être définies à l’avance. Les modèles généralistes sont préférables lorsque la tâche nécessite un raisonnement ouvert, des explications, de la génération de contenu ou une planification complexe.
TypeSafe Jev adopte une approche délibérément étroite de l’IA : au lieu de produire du langage destiné aux utilisateurs, il produit des décisions typées destinées aux logiciels. Cette conception rend la classification, l’acheminement, l’attribution de scores et la vérification à grande échelle beaucoup moins coûteux et plus faciles à intégrer au code.
L’adoption initiale du modèle a été suffisamment forte pour qu’OpenAI entre rapidement dans la même catégorie de produits avec l’API Decisions alimentée par GPT-6 Luna. Jev reste moins cher selon le prix de base publié des tokens d’entrée, tandis qu’OpenAI ajoute la prise en charge des images et l’échelle d’une plateforme de modèles généralistes existante.
Le principal défi d’ingénierie concerne la fiabilité, et non le formatage. Les sorties typées éliminent une catégorie d’erreurs, mais la précision des décisions dépend toujours du jeu de données, du seuil, du coût des erreurs et de la politique d’escalade. L’étude indépendante consacrée à Jev le montre particulièrement clairement.
Le changement plus profond est que l’IA pourrait cesser d’être quelque chose à laquelle les utilisateurs parlent explicitement pour devenir une couche de décision peu coûteuse, exécutée discrètement au sein des logiciels ordinaires.
Partez d’une phrase et obtenez un site complet en quelques minutes.