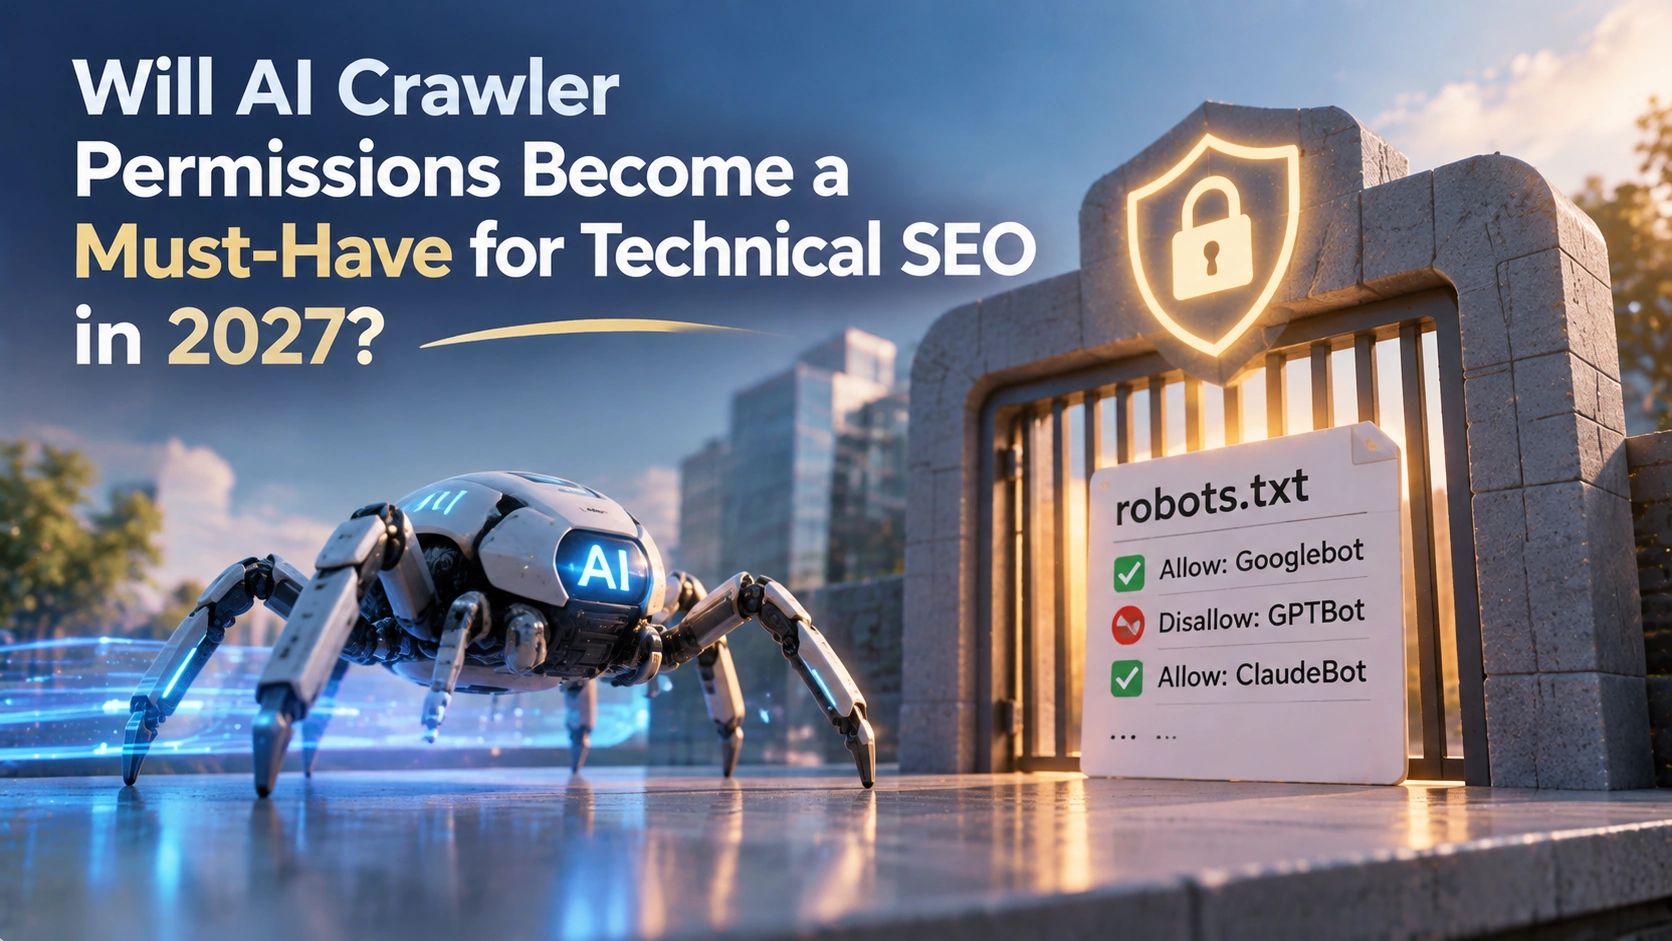
User-agent: Googlebot
Allow: /
User-agent: Google-Extended
Disallow: /
将来の共有学習選好シグナル(Google は 2027 年初頭のサポートを計画)
User-agent: __usage_ai-training
Disallow: /
特に注意すべきは、`Google-Extended` の `Disallow` によってウェブページが Google 検索結果から消えるわけではないことだ。公式ドキュメントは、サイトが Google 検索結果に掲載されることを妨げず、Google 検索のランキング測定要素としても使われないと明記している。逆に、`User-agent: *` の全サイト禁止は Googlebot にも連鎖影響する。この種の「ついで遮断」は技術 SEO で最もよくある自傷行為だ。
## AI Training と AI Grounding をなぜ分けて見る必要があるのか
これは 2027 年に最も書き間違えられやすい概念群だ。
**AI Training(学習)** は、ウェブページ内容を将来のモデル版の学習に使うかどうかを指し、影響するのはモデルパラメータだ。**AI Grounding(根拠)** は、モデルが回答する際に検索取得したウェブページ内容を事実根拠としてリアルタイムに使うかどうかを指し、ある回答の中にあなたの情報が現れるかどうかに影響する。前者はコンテンツ資産が無償利用されるかに関わり、後者は AI 回答にあなたが現れるかに関わる。商業的な帰結はまったく異なる。
Google 公式の `Google-Extended` 説明によると、このトークンが管理するのは、サイトから Google がクロールしたコンテンツを将来版の Gemini モデルの学習に使えるかどうかだ。これらのモデルは Gemini アプリと Vertex AI 上の Gemini を支え、Gemini アプリで Google 検索インデックスのコンテンツをモデルに提供して真実性と関連性を高める用途、および Vertex AI 上で Google Search を使う際の grounding にも使われる。つまり Google のこの実装では、学習許可と根拠許可は同じトークンで覆われている。「学習は禁止、引用は保持」を実現したい運営者は、対象プラットフォームごとにこのような分離機能があるか確認する必要がある。すべてのプラットフォームがすでに分離していると仮定してはいけない。
## 学習を遮断すると AI 検索の引用にも連鎖影響するのか

場面別に答える必要があり、一文でまとめられない。
**Google 検索内部では、影響しない。** AI 機能は検索インデックスの上に成り立っており、学習を遮断してもページがインデックス機会を失うことはない。これは `Google-Extended` と `Googlebot` を分離した設計の直接的な結果だ。
**サイト外の AI アシスタント場面では、しばしば影響する。** これらのシステムは独自のクローラーを使い、JavaScript を実行するか、robots.txt に拘束されるか、構造が明確なページを優先してクロールするかは、各プラットフォームのルールが異なる。学習を遮断することはしばしばクロールを遮断することと同じになり、クロールを止められると引用される可能性を失う。Moz のインタビューには実用的な注意がある。AI に見てほしいコンテンツでは、重要情報を生の HTML に直接出しておくべきだ。逆に JavaScript レンダリングを保護手段として使い、一括抽出されたくない資産を読みにくくすることもできる。これはトレードオフであり、無料のスイッチではない。
**監視の面では、見えなくなりやすい。** 遮断後に効果が見えないことこそ本当のリスクだ。ログに対応する記録すらなければ、「誰もクロールしていない」のか「クロールしたが引用されていない」のか判断できない。
## Google と他のプラットフォームの制御ルールはどこが違うのか
検証可能な公開資料から見ると、違いは制御粒度、命名方式、反映タイミングの三か所に集中している。
| 観点 | Google | 他のプラットフォーム(各社公式ドキュメントに準拠) |
| --- | --- | --- |
| 表現位置 | robots.txt のユーザーエージェントトークン + 計画中の共有選好シグナル | 各ドキュメントで定義された選好フィールド。命名と位置は統一されていない |
| 学習制御 | `Google-Extended` 独立製品トークン | 多くは個別の選好宣言で表現。フィールドはさまざま |
| 検索インデックスとの関係 | 公式にインデックスとランキングへ影響しないと明記 | 各社確認が必要で、相互に類推できない |
| 反映タイミング | 共有学習シグナルは 2027 年初頭サポート予定 | 段階的導入の途上 |
| 全面実施済みか | 共有シグナルは推進中 | 完了済みとは見なせない |
同じ robots.txt でもプラットフォームごとに意味は同じではない。プラットフォーム間の類推は最もよくある事実誤認だ。
## 五つの権限制御手段の境界
| 手段 | 影響範囲 | Google インデックスへの影響 | 第三者 AI への影響 | 可逆性 |
| --- | --- | --- | --- | --- |
| `Google-Extended` トークン | Google の学習・根拠用途 | 影響なし | 影響なし | 高。ファイル変更のみ |
| `Googlebot` トークン | Google 検索および画像・動画・ニュース等 | 直接影響 | 影響なし | 高 |
| `X-Robots-Tag` / meta robots | ページ単位のクロールとインデックス制御 | 直接影響 | プラットフォーム次第 | 中。再クロール待ち |
| クライアントサイドレンダリングの重要コンテンツ | コンテンツ可視性 | 通常はレンダリング可能 | しばしば不可視になる | 中。アーキテクチャ変更が必要 |
| WAF / IP ブロック | リクエスト層での遮断 | 連鎖遮断の可能性 | 有効だが粗い | 低。誤爆しやすい |
意思決定チェックリストは三つの問いに簡略化できる。このコンテンツは学習させたいか。引用させたいか。問題発生時に 10 分以内にロールバックできるか。どれか一つでも答えがないなら、設定を触るべきではない。
## サイト運営者の実行五ステップ
**第一ステップ、まず棚卸ししてから動く。** ログでどのユーザーエージェントが実際にアクセスしているか確認する。使える起点は UA 別のリクエスト数集計だ。
```bash
awk -F'"' '{print $6}' access.log \
| sort | uniq -c | sort -rn | head -30
まず一覧を見てから方針を決め、印象で特定 UA に禁止を追加しない。
第二ステップ、ポリシーを層別に定義する。 少なくとも三種類のページを区別する。検索と AI 引用が必要なマーケティングページ、人だけが読む機密コンテンツ、公開してよいが学習されたくない資料。三種類は同じルールを共有すべきではない。
第三ステップ、設定を書き、意図を注記する。 robots.txt 内でコメントを使い、各ルールの業務上の理由を説明し、後の引き継ぎと監査を容易にする。
第四ステップ、検証する。 プラットフォームの robots.txt テストツールで対象 UA の解析結果を確認し、同時にログを読み返してクロール変化を確認する。
第五ステップ、レビュー周期を設ける。 共有学習選好シグナルはまだ推進中であり、一度設定して長期間放置するのではなく、四半期ごとのレビューを推奨する。
よくある誤解と制限
robots.txt を法的障壁とみなす。 それは意思を表明するが強制力は提供しない。実際の保護にはコンテンツ層別、アクセス制御、契約条項を組み合わせる必要がある。
学習を遮断すればコンテンツが見えなくなると考える。 Google 検索側では成立せず、サイト外アシスタント側ではしばしば成立する。両者の結論は逆だ。
学習だけを処理し、根拠を扱わない。 プラットフォームが学習と grounding を同じトークンに束ねている場合、学習を遮断すると引用機会も同時に弱める。
数分で紹介サイトを作り、リード獲得を伸ばす
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
権限管理をトラフィックスイッチとみなす。 それは「誰が読めるか、読んだ後に何ができるか」を決めるもので、ランキング、トラフィック、成約結果を約束しない。
レンダリング差異を無視する。 コンテンツが JavaScript の中にしか存在しないことは、ある種のクローラーに対する沈黙に等しい。この種の問題は権限設定の範囲を超え、フロントエンドとアーキテクチャを一緒に変える必要がある。
技術 SEO の日常業務は、「検索エンジンに読めるようにする」から「誰が読め、読んだ後に何ができるかを明確に説明する」へ拡張しつつある。サイトのページ構造、構造化情報、コンテンツ更新自体が混乱しているなら、権限設定は混乱を記録するだけだ。サイト構築とコンテンツ運営を同じ体系で進めるほうが、後からルールを補うより通常はコストが低い。たとえば We0 はサイト生成時に SEO と GEO 最適化、CMS バックエンド、ドメイン展開を同じチェーンに置き、ページ構造、引用可能な情報ブロック、公開フローを一緒に形作る。その後の権限戦略も具体的なページ種別に落とし込みやすくなる。
FAQ
2027 年までに AI クローラー権限管理を完了する必要があるのか?
すぐに設定を変える必要はないが、2027 年までに棚卸しと方針を確定しておくことを勧める。共有学習選好シグナルはまだ推進中で、Google は 2027 年初頭のサポートを計画している。ページ層別を早めに把握したチームは、フィールドが正式に有効になったとき数行の設定変更で済む。
robots.txt で Google-Extended を禁止すると、サイトは Google 検索から消えるのか?
消えない。Google 公式ドキュメントによると、Google-Extended はサイトが Google 検索結果に掲載されることに影響せず、ランキング測定要素にもならない。検索インデックスに影響するのは Googlebot 関連のルールだ。
AI Training と AI Grounding は同じものか?
違う。学習はコンテンツが将来モデルのパラメータに入るかを決め、grounding はモデル回答時にあなたのコンテンツをリアルタイムに根拠として使うかを決める。一部の実装では両方を同じトークンで覆っており、各社確認が必要だ。
AI クローラーが JavaScript を実行しないことは、権限設定にどんな影響があるか?
影響は大きい。重要情報がクライアントサイドレンダリング結果にしか存在しない場合、権限設定をどれだけ正確に書いても相手は内容を読めない。中核情報を生の HTML に入れるか、この種のクローラーに見えないことを受け入れるかだ。
設定が実際に有効かをどう判断するか?
三つだ。公式テストツールで対象ユーザーエージェントの解析結果を検証する。アクセスログを読み返してクロールが変化したか確認する。実在する質問群を固定し、AI 回答にあなたのブランド情報と出典がまだ現れるか定期的に確認する。
関連ツール
- Google Search Console(インデックスとクロール診断)
- robots.txt テストツール(対象ユーザーエージェントの解析結果を検証)
- サーバーアクセスログ分析(UA 別にクロール分布を集計)
- We0(AI サイト構築とグロースのワークスペース。SEO と GEO 最適化、CMS バックエンド、ドメイン展開をカバー)
関連リンク
- Google の一般的なクローラー一覧(公式ドキュメント)
- サイト向けの共有 AI 学習制御オプション(Google 検索センター ブログ)
- Stop Calling It SEO: 12 Strategies To Dominate AI Search in 2026(Moz)
- 生成エンジン最適化(GEO)実践(Tencent Cloud Developer Community)
- We0 公式サイト
まとめ
2027 年の AI クローラー権限管理は、技術 SEO の通常納品項目になる可能性が高い。ただし核心は「AI を遮断する」ことではなく、検索クロール、モデル学習、コンテンツ根拠という三つの用途を分けて表明し、再確認可能な記録を残すことにある。判断根拠は三点だ。学習選好は共有の機械可読シグナルへ向かっており、Google は 2027 年初頭のサポートを計画している。制御対象は単一の Googlebot から独立した製品トークンへ拡大した。AI 引用は依然としてクロール可能であることを前提とする。実行面では、まずログを棚卸しし、ページごとに層別ポリシーを定義し、コメントで意図を注記し、解析結果を検証し、四半期レビューのリズムを設けることが、一度限りの禁止より有効だ。境界も明確である。robots.txt は取り決めであり強制ではなく、Google-Extended は Google 検索のインデックスとランキングに影響せず、学習許可と根拠許可は一部実装でまだ分離されていない。これらの違いを明確に書いてこそ、権限管理は不可逆な誤操作にならない。