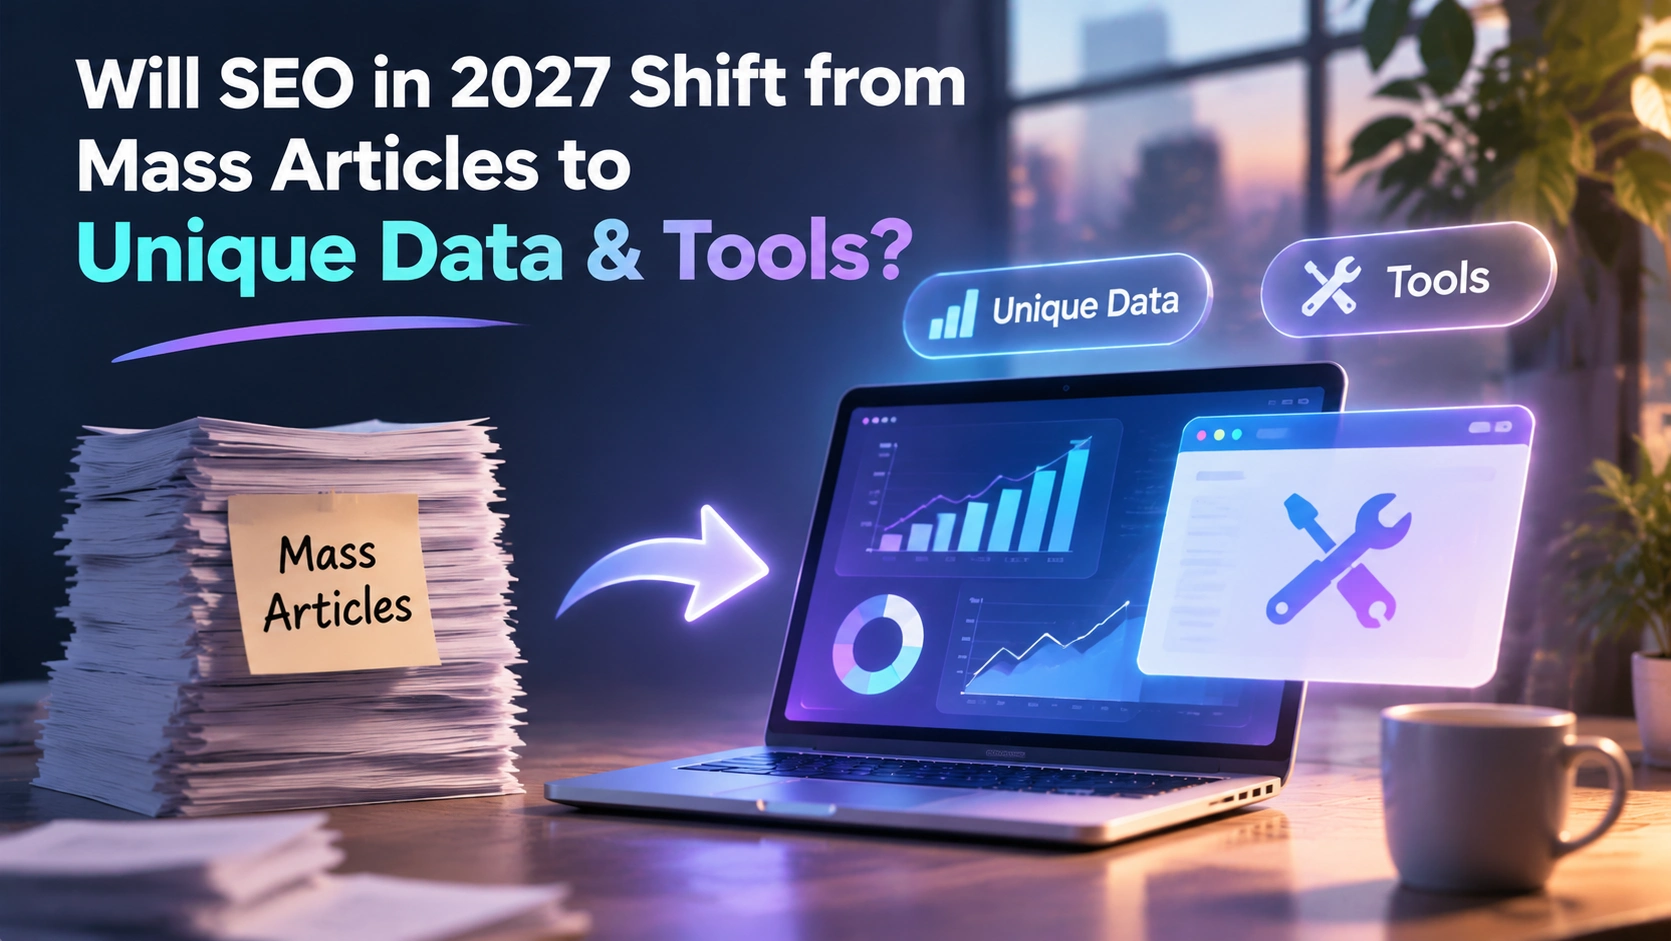
2027年の変化を一文に圧縮するとこうなる。数で積み上げたページのトラフィックの限界収益はさらに下がり、独立した情報を提供し、ユーザーが作業を完了できるページの相対的価値は上がる。
これは業界予測であり、検索エンジンがすでに公表したルールではない。判断を支えるのは三種類の公開資料だ。スパムコンテンツポリシーによる「大規模生成でユーザー価値がない」ことの定義、生成AIコンテンツガイドによる「内容が役立つか」の強調、そして生成検索の回答が一般に引用リンクを伴うという観察可能な現象である。
移行の実態は「ブログ更新をやめる」ことではなく、コンテンツ構成の再編である。解説型記事は主要なトラフィック源から土台の位置へ戻る。依然として必要だが、単独でコンテンツサイトの成長を支えることは難しくなる。独自データ、インタラクティブツール、検索可能なデータベースページ、実例が差別化競争の主戦場になる。
AIが生産コストをゼロに近づけた後、供給構造に何が起きたか
AIがまず変えたのはコスト構造だ。構造が完全で文章が通る汎用記事をほぼゼロコストで生産できるようになると、同じ検索意図の下でのページ供給は急速に膨張する一方、ユーザーの注意力の総量は変わらない。
結果は「AIコンテンツが罰せられる」ことではなく、「独立した情報の増分がないページが比較優位を失う」ことだ。実際に希釈されるのは次の三種類のページである。
- 都市名、業種名、年だけを差し替えたテンプレート変種
- 公開レポートを並べ替え、解釈を一段落だけ加えた「疑似リサーチ」
- ファーストビューで答えを示せず、全文を読まないと関連性を判断できない長文
これらのページは、青いリンクが10本しかなかった時代ならロングテールで残りを取れた。しかし回答が直接抜粋され、ページが証拠として引用される必要がある現在、その立場は明らかに悪くなっている。
政策はすでに「規模+新規価値なし」をレッドラインにしている
政策面には必ず区別すべき二つの事実がある。
第一に、Google ウェブ検索スパムコンテンツポリシーは、「検索ランキングを操作するために大規模に生成され、ユーザーに新たな価値をもたらさないページ」を大規模コンテンツ乱用(scaled content abuse)に位置づけ、この種の行為の判定がコンテンツを自動化で作ったか人手で作ったかとは無関係であることを明確にしている。キーワードは「規模」と「新規価値なし」が同時に成立することであり、「AIを使った」ことではない。
第二に、Google 生成AIコンテンツガイドは、サイトが自動化手段でコンテンツ制作を支援することを許可する。前提は、コンテンツがユーザーに役立ち、信頼性を備え、人間が品質に責任を持つことである。同一サイトの実用的で信頼でき、ユーザーを第一にするコンテンツのガイドラインも、判断の重心を「誰が書いたか、どう作ったか、なぜ信頼に値するか」といった検証可能な情報に置いている。
二つを合わせると、一括記事投稿のリスク点はツールではなく代替可能性にある。一群のページが数十の近似キーワードをカバーしても、ユーザーがどの記事を読んでも意思決定を完了できず、検索エンジンもユーザーもそれらを区別して扱う理由を持てない。
三つの予測シグナルと、守るべき一つの境界

第一に、政策の基準はすでに明確である。大規模で低価値の自動化ページは違反領域に属し、この境界は業界の推測に依存しない。
第二に、公式ドキュメントの重心は「有用性」にある。Google SEOスターターガイドが語るのは、検索エンジンがコンテンツを理解し、ユーザーがコンテンツを見つけ、訪問する価値があるか判断できるようにすることである。MDN Web Docs 用語集はSEOを基礎的なWeb用語として収録している。どちらも「独自データが必須」といった技術条件を示してはいないが、ユーザーが利益を得るかどうかを中心に置いている。
第三に、コンテンツ消費経路が変わっている。ユーザーはますます、AIアシスタントで引用付きの概要を先に受け取り、そのうえでどのページを開くかを決める。証拠として引用できるページは、通常、具体的な定義、具体的なサンプル、具体的な期間を持っている。
境界も明確にしなければならない。独自データ、オリジナル調査、インタラクティブツールは現在、Googleが公表するランキング要因ではない。それらを「公式に確認されたランキング加点要素」と言うのは誤りだ。より安全な表現は、ページの同質化が進む環境では、これらの形式が実際のユーザーシグナルや外部引用を得やすくなり、その結果として競争で優位に立ちやすい、となる。
五種類のコンテンツ形式の能力比較
| コンテンツ形式 | 中心的価値 | 主に受ける検索意図 | 再利用・維持コスト | インデックス推奨 |
|---|---|---|---|---|
| 通常のAI生成記事 | 基礎概念を説明し、ロングテールの問い方をカバー | 「何か」「どうやるか」の入門質問 | 低いが、同質コンテンツに覆われやすい | 同類ページを統合し、実際に差がある少数だけ残す |
| オリジナル調査記事 | 独立データと引用可能な結論を提供 | 「どれくらい」「トレンドはどうか」「業界比較」 | 高い。方法説明と定期更新が必要 | 優先的にインデックス。方法ページとデータ説明を併設 |
| インタラクティブツール | ユーザーがその場で作業を完了、または試算結果を得る | 「計算」「検査」「生成」「評価」 | 中〜高。ロジックと結果の継続保守が必要 | 優先的にインデックス。結果ページがクロール可能であることを確保 |
| データベース型ページ | 検索・絞り込み可能な構造化情報を提供 | 「一覧」「価格」「型番」「地域」 | 中。データソースの更新頻度に依存 | 一意性条件を満たす場合のみインデックスし、それ以外は収束 |
| 実際の事例 | 実体験、プロセス、結果の境界を提供 | 「効果」「どう導入するか」「やる価値があるか」 | 中。実際のプロジェクト蓄積に依存 | インデックス。主体、時期、制約条件を強調 |
表で最も見落とされやすいのは「再利用・維持コスト」の列だ。一括記事はコストが低いが、代償として再利用価値も低い。調査とツールは初期投入が高いが、一つのデータで複数の解説、多言語版、長期的な引用を支えられる。
「他社が短期間では作れない」独自データとは何か
「独自」は「自社で集計した」ことと等しくない。他者が短期間で再現しにくいことだ。差別化しやすいデータは通常、四つの来源を持つ。
- 自社業務の蓄積:製品内の匿名集計行動、成約サイクル、よくある失敗原因、機能利用分布。
- 顧客とプロジェクトの過程:公開までのサイクル、改版前後の比較、広告と自然流入の構造変化。
- 継続収集する業界パネル:求人情報、価格ページ、公開ドキュメント、政策テキストの定期スナップショット。
- 自社アンケートまたはインタビュー:サンプル数、募集方法、回収率を明示した一次調査。
データが引用されるには、四つの要素を同時に備える必要がある。定義(分子と分母の計算方法)、サンプル範囲(誰を含め、誰を除外するか)、期間(収集区間と更新頻度)、方法説明(どうクリーニングし、異常値をどう扱うか)。どれか一つ欠けると、読者もAIアシスタントもその数字が信頼できるか判断できず、差別化価値も割り引かれる。
反面例も覚えておく価値がある。公開レポートの数字を並べ替え、自分の解釈を加えても独自データにはならない。こうしたコンテンツは短期的なクリックを生むが、引用の障壁を形成できない。
計算機、テストツール、インタラクティブページが代替されにくい理由
要約は一つの説明を言い換えられるが、ユーザーの代わりに試算を完了することはできない。ユーザーが「この種のプロジェクトはいくらかかるか」「自分のサイトが特定の条件を満たすか」を検索するとき、本当に欲しいのは結果であり、説明文ではない。ツールページはしたがって二つの特徴を自然に備える。ユーザーの動作がページ上で発生し、ページ自体が答えの一部になる。
この優位性を検索パフォーマンスに落とし込むには、三つのことを処理する必要がある。
数分で紹介サイトを作り、リード獲得を伸ばす
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
- まずページがクロールできるようにする。中心的な説明文、入力項目の意味、結果の解説をできるだけサーバーサイドレンダリングまたはプリレンダリングで出力し、全内容をクリック後に初めて生成する形を避ける。クロール可能性はインタラクティブページの前提である。
- ツールページに構造化データを付与する。無料評価ツールを例にすると、
SoftwareApplicationタイプで名称、カテゴリ、価格をマークアップできる。
{
  "@context": "https://schema.org",
  "@type": "SoftwareApplication",
  "name": "ウェブサイトコンテンツのインデックス可否セルフチェックツール",
  "applicationCategory": "BusinessApplication",
  "operatingSystem": "Web",
  "offers": { "@type": "Offer", "price": "0", "priceCurrency": "CNY" }
}
- 結果を共有・引用できるようにする。パラメータをリンクで再現でき、結果に明確な計算説明があって初めて、外部ページやAI回答の参考根拠として扱われる。
企業事例とオリジナル調査はどう構成すべきか
事例の問題は通常、数ではなく構造にある。信頼される事例は少なくとも五つのことを説明する必要がある。プロジェクト背景と制約条件、取った具体的な行動(「コンテンツ戦略を最適化した」とだけ書かない)、観測可能な変化、観測期間、そして当てはまらない状況である。「効果」だけを結論として書くと、読者は自分に関係があるか判断しにくくなる。
オリジナル調査は三層構造で公開するのが適している。第一層は結論要約ページで、最も重要な発見とサンプル規模を一、二段落で説明する。第二層は方法ページで、データソース、クリーニング規則、欠損値処理、限界を説明する。第三層はデータセットまたは図表の付録で、他者が具体的な数字を引用しやすくする。調査系コンテンツには更新ログも残し、データ版と修正理由を明記すべきだ。そうでなければ半年後に数字が矛盾し、信頼性が急速に失われる。
ツールページとチュートリアルページを相互に支え合う四つの動作
ツールは「実行」を解決し、記事は「なぜ」「どうやるか」を解決する。両者は互いに流入入口と信頼の裏付けになる。
- 記事で需要を先に置く。チュートリアルで、どのような場合にこのツールが必要か、どのパラメータを入力するか、結果をどう解釈するかを説明し、ツールリンクを「計算を開始」「検査を開始」といった動作文脈に置く。段落にランダムに挿入しない。
- ツールを記事の証拠にする。記事の結論を再現可能な小さなツールで検証できれば、読者の滞在と再訪は自然になり、外部が同じページを引用する確率も高まる。
- 用語と構造を統一する。同じ指標をツールページ、チュートリアルページ、事例ページで完全に同じ名称と定義にする。ユーザーがページごとに異なる基準を見る事態を避ける。
- 更新の連動を作る。ツールのロジックを調整したときは、関連するチュートリアルと事例の例示数値を同時に修正し、バージョン番号や更新日を付けて、ページ間の矛盾を減らす。
プログラム生成ページがインデックスされる価値があるかどうかをどう判断するか
プログラム生成自体は違反ではない。違反になるのは「規模が大きい+新規価値がない」ことだ。公開前に次のチェックリストで項目ごとに確認し、いずれかが明確に「いいえ」なら統合またはインデックス対象外を検討する。
- 一意な情報:このページに、その組み合わせ固有のデータ、在庫、パラメータ、結論があるか?タイトル語句を変えただけなら即「いいえ」。
- 回答可能性:ユーザーが具体的な問題を持って来たとき、ファーストビューで答えまたは明確な次の一歩を示せるか?
- 真正性:ページ内の数字、名称、時期は実在するか、データソースに遡れるか?
- 組み合わせ規模:この一群のページは同一テンプレートの外殻か、それとも各組み合わせに実質的な差があるか?差がない組み合わせは大幅に縮小すべきだ。
- 保守性:データ更新後にページが自動同期されるか、それとも人手でページごとに修正する必要があるか?
- 入口価値:ページに内部リンクと明確なナビゲーション位置があるか、それともサイトマップから偶然発見されるだけか?
- クロール予算:低価値ページが重要ページのクロール予算を圧迫していないか?
確認後の行動は確認自体より重要だ。条件を満たさないページをより完全なまとめページに統合し、純粋なパラメータ変種には noindex を使いつつアクセス可能性を保ち、浮いたクロール予算をツールページと調査ページに回す。
企業は今どう優先順位を付ければよいか
今月からコンテンツ構成を調整するなら、三ステップで進められる。サイト全体を一度に書き直す必要はない。
- 既存資産を棚卸しする:上の表に沿って既存ページを分類し、テンプレート変種だけで存在するページを洗い出す。このステップで通常、最も多くの低価値な成果物を整理できる。
- 納品可能なツールまたはデータの切り口を一つ選ぶ:最も慣れている業務段階から始める。たとえば見積もり概算、構成比較、コンプライアンス自己チェックなど。まず一つの問題を正確に計算し、それから拡張する。
- 受け皿環境を整える:ツールページ、方法ページ、事例ページには安定したサイト基盤、保守可能なCMS、基礎的なSEO/GEO設定が必要だ。We0のようなサイト構築からリード獲得までのAIワークスペースなら、自然言語でページ構造を生成し、ビジュアルキャンバス、マルチエージェント連携、CMSバックエンド、ドメイン展開を通じて、ツールページとコンテンツページを同じサイトに置いて統合運用できる。これにより「ツールは作ったが誰も保守しない」というよくある断絶を減らせる。
FAQ
2027年に一括記事投稿はまだ有効か?
有効だが、適用範囲は狭くなる。実際のロングテールの問い方をカバーし、情報が正確で、継続的に保守される記事は依然として役立つ。都市名や年だけを変えたテンプレート変種は価値がますます低くなる。ユーザーにも検索エンジンにも相互に置き換え可能に見えるからだ。
独自データはGoogleが公表するランキング要因か?
いいえ。現在公開されている公式ドキュメントに「オリジナルデータ加点」といった技術条件はない。より合理的な理解は、独自データによってページが同類コンテンツに置き換えられにくくなり、外部ページやAI回答に引用されやすくなるというものだ。ただし、公式に確認されたランキング機構として表現すべきではない。
自社データを持たない中小チームはどうすればよいか?
入手しやすさが最も高いデータから始める。自社プロジェクトの公開までのサイクル、顧客のよくある質問の分布、改版前後の比較記録は、構造化された小規模調査に整理できる。規模は大きくなくてよいが、定義、サンプル、期間は明確に書かなければならない。ツールの方向も同じで、業界の一般的なルールを正確に計算する小さなツールは、大きなデータを追うより早く効果が出ることが多い。
インタラクティブツールページはJavaScript依存のため内容をクロールされないのではないか?
そのリスクはあるが回避できる。ツールの中心説明、パラメータの意味、結果の解説をクロール可能な形で出力し、ツールに適切な構造化データを追加すれば、検索エンジンはページ主題を理解できる。本当の問題は、内容をインタラクションの後に閉じ込め、初期ページがほぼ空白であることだ。
ツールページとチュートリアル記事は分けるべきか?
分けることを勧める。ツールページは「作業の完了」を担い、内容は短く、直接的で、すぐ使い始められる必要がある。チュートリアルページは「判断と説明」を担い、より完全に書いてよい。両者を相互リンクし、同じ用語定義を共有するほうが、二つの意図を一つの超長ページに押し込むより理解されやすく引用されやすい。
関連ツール
- We0:展示型ウェブサイト向けのAIサイト構築・リード獲得ワークスペース。自然言語での要件記述、複数エージェント連携によるページ生成、ビジュアルキャンバス調整、ドメイン展開、CMSバックエンド、SEO/GEO最適化をサポートし、ツールページ、事例ページ、調査のランディングページのサイト基盤として適している。
関連リンク
- Google ウェブ検索スパムコンテンツポリシー:大規模コンテンツ乱用などの違反行為の公式定義。
- Google 生成AIコンテンツガイド:AI支援でコンテンツを生産する際の公式要件と判断基準。
- Google:実用的で信頼でき、ユーザーを第一にするコンテンツの作成:コンテンツが信頼に値するかを評価する自己チェック観点。
- Google SEOスターターガイド:検索エンジン最適化の基礎知識とクロール・インデックスの要点。
- MDN Web Docs:SEO:SEOの用語定義と基礎解説。
まとめ
2027年のSEOの変化は、数量がゼロになることではなく、コンテンツ構造の移行として現れる可能性が高い。一括記事のコスト優位は依然として存在するが、その差別化優位は消えつつある。供給が膨張し、検索結果が直接答えを示し、AI回答が引用を伴う環境では、独立データを提供でき、ユーザーの作業完了を助け、実際の経験を説明できるページほど信頼され引用されやすい。政策上守るべき境界は明確だ。大規模に生成され新規価値がないページは違反領域に属し、オリジナルデータとインタラクティブツールは公式に確認されたランキング要因ではない。実行可能な道筋は、小規模な実データから始め、ツールページとチュートリアルページを相互に接続し、判断チェックリストでプログラム生成ページのインデックス範囲を管理し、クロール予算を本当に独自価値のある少数ページに集中させることである。