通常のFAQページのロジックは「人が答えを探す」ことだ。ユーザーは自分でどの項目を開くべきか判断し、全文を読み、自分の状況と照らし合わせる。一方、企業が実際に受ける質問は「このバージョンはプライベートデプロイに対応していますか。データを社内ネットワークの外に出せません」のような組み合わせ質問であることが多く、FAQには「プライベートデプロイに対応」と1項目あるだけで、読んでも確信を得られない。
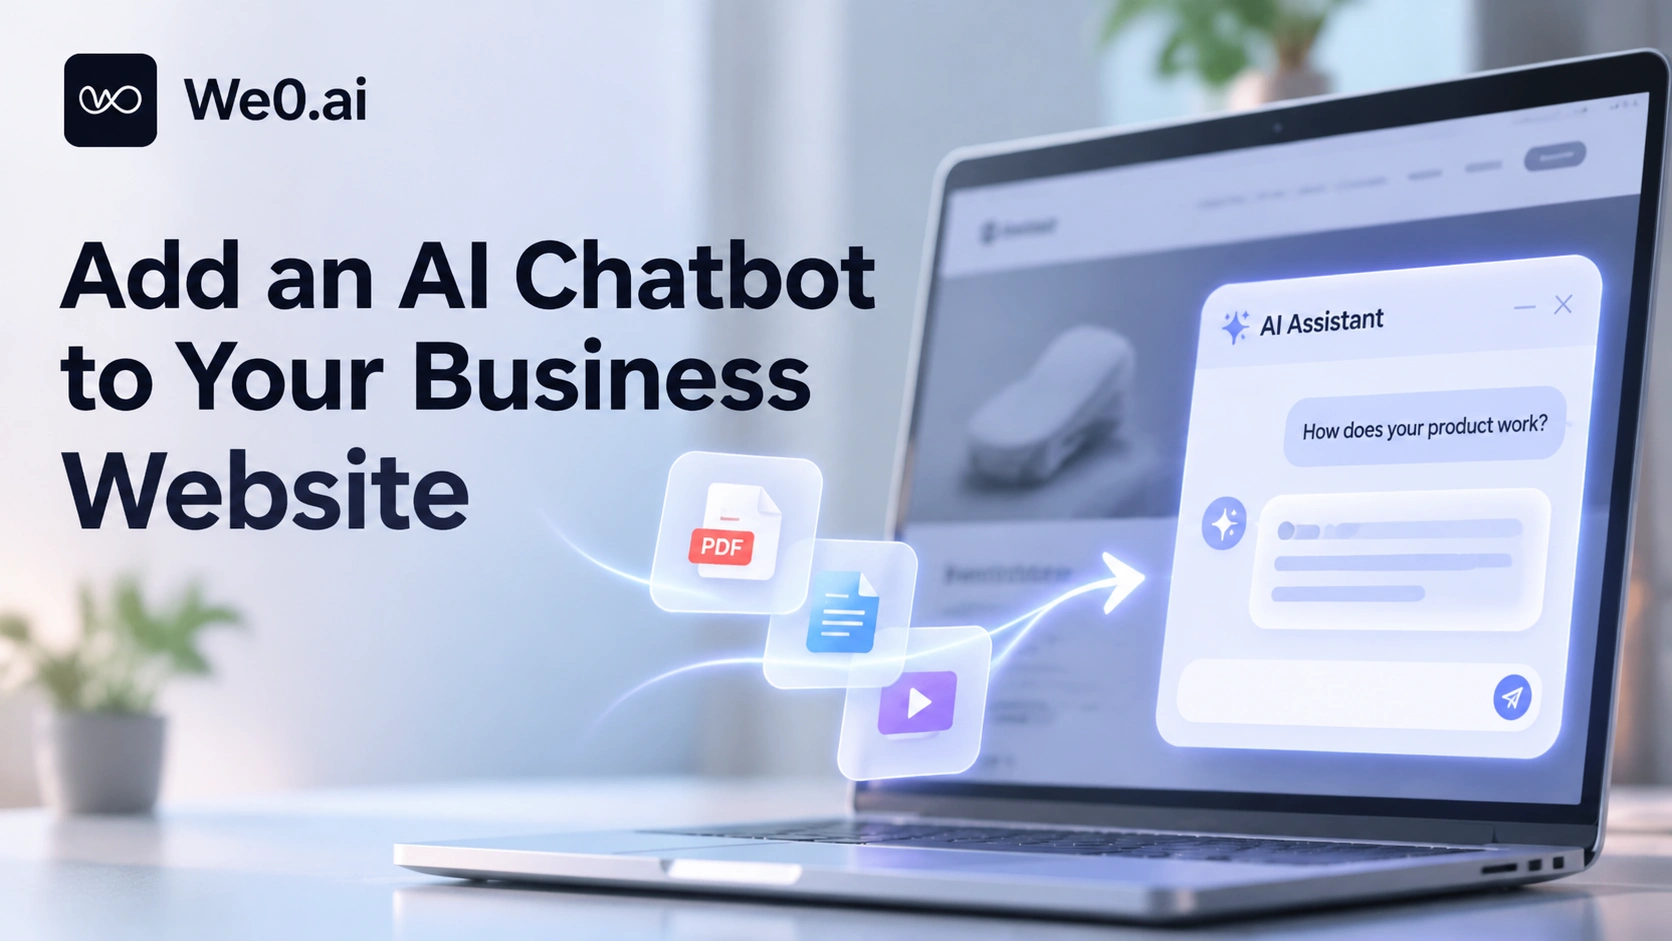
AIカスタマーサポートの違いは、答えが質問に応じてその場で構成されることにある。公式サイトのコンテンツ、製品ドキュメント、FAQリストをまとめてナレッジベースとし、ユーザーが質問するとまず関連資料を検索し、そのうえで大規模モデルが質問に直接答える文章を構成する(Alibaba Cloud AIカスタマーサポートのドキュメント)。プリセールス相談、機能案内、サイト情報提供のような高頻度・反復的な場面では、この違いが、ユーザーが読み続けるか、ページを閉じて競合に質問するかを決める。
したがって提供すべきはチャットボックスではなく、検索可能で十分に正確な知識資産である。ウィンドウの見た目は最後のステップであり、最初の2ステップがそれが役立つかどうかを決める。
AIカスタマーサポートに「自社製品を理解させる」技術的骨格:RAG
チャットボットに企業自身の資料に基づいて回答させる主流の方法は、検索拡張生成(RAG)である。その核心は、モデルにあなたの製品を「記憶」させることではなく、回答のたびにまずナレッジベースから関連する断片を探し、その断片に基づいて答えを書くことにある。ClouderaのRAG Studioドキュメントでは、この種のシステムを次のように説明している。チャットボットがナレッジベースにアクセスし、ユーザーの質問に関連する内容を検索し、その質問に即した回答を生成する(RAG Studioのユースケース説明)。
最小限の利用可能な連携は5ステップで構成される:
- 分割:マニュアル、規約、製品ページを検索可能な小さな塊に分割する;
- インデックス:各塊にベクトルまたはキーワードのインデックスを作成する;
- 検索:ユーザーの質問時にもっとも関連するいくつかの塊を取得する;
- 生成:取得した内容とユーザーの質問を一緒にモデルへ渡し、答えを構成させる;
- 引用:回答の横に出典を示し、ユーザーがクリックして確認できるようにする。
第5ステップは見落とされがちだが、同時に2つの問題を解決する。ユーザーの信頼と、後から「この文はどのドキュメントから出たのか」を追跡できることだ。資料が更新されてもモデルの再学習は不要で、ナレッジベースを変えればよい。これが、製品資料の反復が頻繁な場合にRAGがファインチューニングより適している理由である。
ステップ1:知識ソースを棚卸しし、どの内容をナレッジベースに入れるべきかを見極める
導入前に資料を広げて分類する。すべての内容がそのまま投入に適しているわけではなく、すべてを公開表示すべきでもない。
| 知識ソース | 向いている内容 | 導入時の注意点 |
|---|---|---|
| 公式サイトのページ | 製品紹介、機能ページ、価格ページ、ヘルプセンター記事 | 自動クロール可能だが、オンラインページが最新版であることを確認する |
| PDF / Wordドキュメント | 製品マニュアル、仕様書、API説明、利用規約 | スキャン画像は先に文字認識が必要。でなければ検索できない |
| FAQ標準Q&A | ポリシー、期限、返品・交換、請求書、アフターサービス手順 | ヒット優先度がもっとも高く、回答がもっとも制御しやすい |
| 内部資料 | 見積ルール、営業SOP、障害対応マニュアル | 権限に関わるため、公開知識と同じ検索範囲に混ぜてはいけない |
よくある失敗は、すべての資料を無差別にアップロードした結果、モデルが異なる時期の仕様書を3部検索してしまい、回答が互いに矛盾することだ。まず重複排除とバージョン収束を行うほうが、プロンプトを調整するよりはるかに効果的である。
ステップ2:ナレッジベースを構築し、検索可能にする
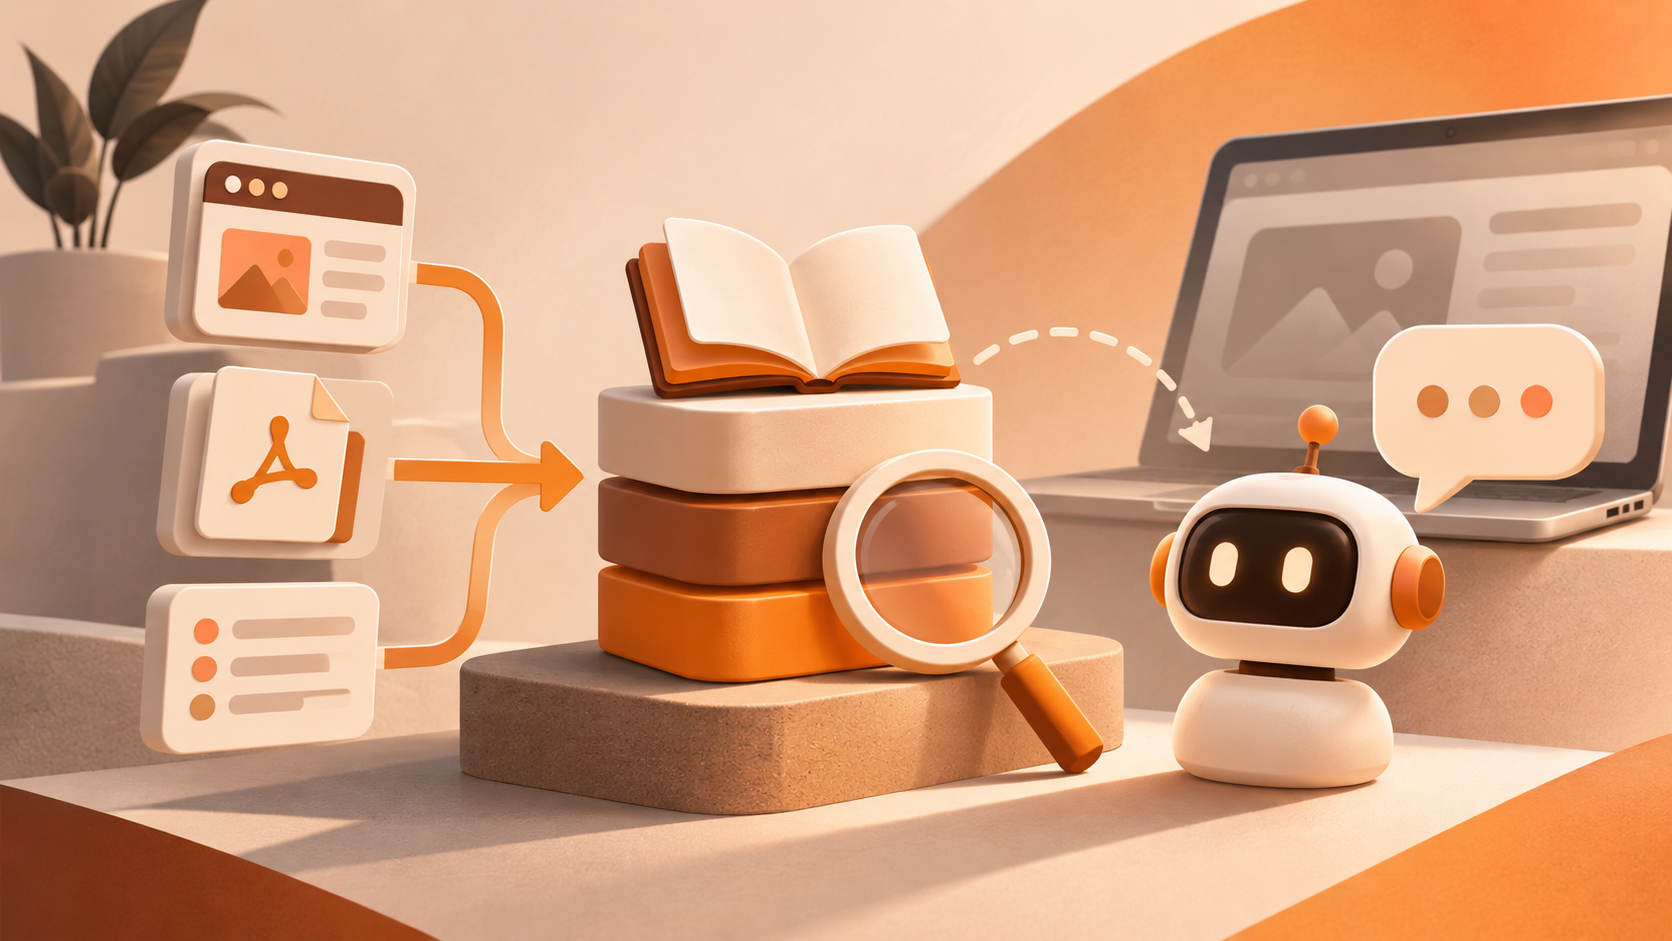
ナレッジベースの構築方法は通常3種類ある。サイト取り込み、ファイルアップロード、FAQ入力である。Alibaba Cloud AIカスタマーサポートの実装を例にすると、サービスを有効化するとシステムがサイトの公開内容を自動解析して初期ナレッジベースとし、クロールにかかる時間はサイトのコンテンツ量に依存する。ファイルアップロードはpdf、doc、docx、txt、markdown、excelの6形式に対応し、FAQは標準Q&Aペアを入力するために使う。ユーザーの質問が複数の知識ソースに同時に一致した場合、システムはFAQの標準回答を優先採用する(Alibaba Cloud AIカスタマーサポートのドキュメント)。
実行レベルでは、いくつかの動作をプロセスとして固定する価値がある:
- サイト取り込み完了後、クロールされたページ一覧を一通り確認し、期限切れのキャンペーンページや下書きページを削除する;
- コンテンツ更新時に手動で再クロールを1回実行するか、定時自動同期を有効にし、ナレッジベースが3か月前で止まらないようにする;
- もっとも誤答しやすい10組の質問をFAQとして書き、標準回答でモデルの自由な表現の余地を覆う;
- 各知識項目に担当者を残す。そうでなければ半年後に誰も古いドキュメントを削除できなくなる。
ステップ3:サポートウィンドウをサイトに設置する
ナレッジベースが通ってから、外周設定に移る。ウィンドウの色、サービス名、サービス紹介、開始質問といったフィールドは装飾に見えるが、実際には初回対話の品質に影響する。サービス紹介で能力の境界を明記すれば、ユーザーは「契約書を1部書いて」のような範囲外の質問をしない。開始質問で高頻度の入口を提示すれば、ユーザーが最初の一言をためらうコストを大きく下げられる(Alibaba Cloud AIカスタマーサポートのドキュメント)。
もう1つ見落とされやすい設定がある。連絡先だ。AIがユーザーの問題を解決できないとき、画面に電話、メール、その他の代替チャネルを用意する必要がある。そうでなければ、ユーザーは「わかりません」で遮られた後、本当に離脱してしまう。
サイト自体にログイン体系がある場合、公開知識とログイン後に見える知識を分けることは、2つの独立した知識範囲となる。この階層化を容易にするため、基盤サイトにはアカウント機能があるとよい。たとえばwe0のサイト機能には、メール認証、GoogleとGitHubログインの基本アカウント体系、およびユーザー管理からコンテンツ保守までのCMSバックエンドが含まれる(we0機能一覧)。このような基盤は、ログインとコンテンツ保守を自前で組み立てるコストを省ける。
AIが存在しない製品情報を捏造するのを避ける方法
これは導入過程でもっとも現実的なリスクだ。顧客が「SAMLシングルサインオンに対応していますか」と聞くと、モデルは会話を続けるために、もっともらしい「対応しています」を返す可能性が高い。
この種の誤りを減らすには、祈るのではなく制約による。使える手段をコスト対効果順に並べる:
- 回答範囲を限定する:モデルに対し、検索された断片だけに基づいて回答するよう明確に要求し、検索結果が空の場合はナレッジベースに当該項目がないと直接説明させる。
- フォールバック文言を用意する:ヒットしないときに空回りさせず、ユーザーに言い換えや有人対応への切り替えを促し、評価ボタンを残して負のフィードバックを収集する。
- FAQ優先:パラメータ、価格、コンプライアンスなど誤りが許されない点を標準Q&Aとして書き、モデルの自由表現より優先させる。
- 出典を必須にする:回答にソースリンクを付け、ユーザーが確認でき、あなたも振り返れるようにする。
- 公開前の抽出検査:実際のサポートチケットの過去質問でテストセットを作り、回答とドキュメントを1件ずつ照合する。「こんにちは」「御社はどこにありますか」のような質問で受け入れてはいけない。
利用可能なシステム指示の例はおおよそ次のとおりだ:
あなたは本サイトの製品カスタマーサポートです。下記の検索断片のみを使って質問に回答してください。
断片に答えがない場合は、「ナレッジベースに該当情報はありません」と直接返し、ユーザーに連絡先の確認を促してください。
断片に現れていない機能、価格、バージョン、約束を推測してはいけません。
回答の末尾に、ソースページのタイトルをリスト形式で示してください。
ユーザーの質問に基づいて製品を推薦できるか
できるが、推薦は資料に実在する条件に基づかなければならない。実行可能な方法は、「推薦」を「条件による絞り込み」に格下げすることだ。ユーザーの説明からシーン、規模、デプロイ方式などの要素を抽出し、ドキュメントに明記されたバージョン差分やプラン区分にマッピングし、最後に対応する製品ページを示す。こうすれば推薦の一文一文が追跡可能になる。逆に、モデルに「あなたにもっとも適したプラン」を自由に語らせれば、未確認の商業的約束を代わりにさせていることになる。
データ側も助けになる。一部のカスタマーサポートシステムのデータパネルは、質問をカテゴリ別に集約し、製品推薦もその1カテゴリとして、同時にセッション数、ユーザー数、回答済み質問数、問題解決率(回答済み質問数 ÷ 総質問数 × 100%)を集計する(Alibaba Cloud AIカスタマーサポートのドキュメント)。推薦系質問の解決率が長期に低い場合、通常はモデルが悪いのではなく、製品ページに意思決定に必要な情報——比較軸、価格帯、適する場面と適さない場面——が欠けている。
複雑な問題を有人サポートへ切り替える方法
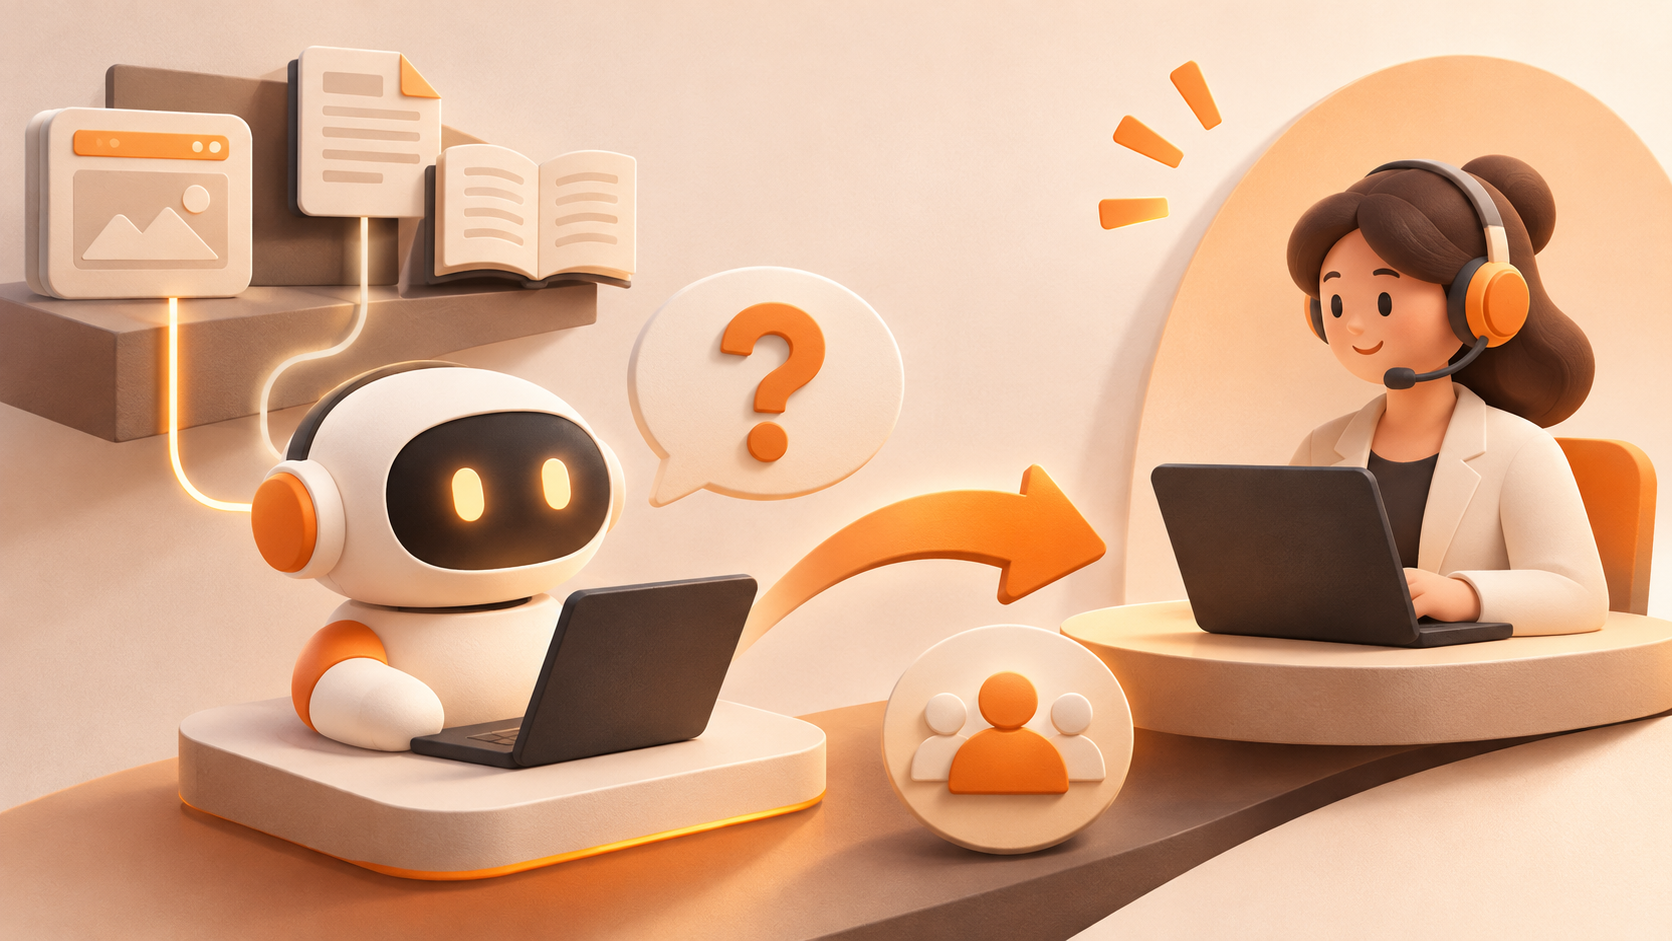
AIカスタマーサポートの価値は人を遮ることではなく、簡単な問題を消化し、複雑な問題を文脈付きで引き渡すことにある。有人対応への切り替えトリガー条件は、リストとして書くことを勧める。「状況による」は避ける:
数分で紹介サイトを作り、リード獲得を伸ばす
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
- 高価値または高リスクのキーワードに話題が一致する:見積、契約条項、カスタム開発、障害とデータセキュリティ、苦情;
- 2往復連続で未解決、またはユーザーが主動的に有人対応を求める;
- ユーザーの感情が明らかにネガティブで、明確な不満表現がある;
- ナレッジベースのヒット率が空で、かつ質問がアカウント、注文などバックエンド確認を要する事項に関わる。
転送時には会話サマリー、検索済みのソース、ユーザーがいるページを一緒に有人担当へ渡し、顧客が最初から説明し直さなくてよいようにする。このステップは技術難度は高くないが、体験の落差がもっとも大きい部分だ。多くの企業はAIカスタマーサポートを作ったものの、有人切り替えを「問題をもう一度説明してください」にしてしまっている。
会話を記録し、ナレッジベース更新の根拠に変える
サポート会話はもっとも安価なニーズ調査だ。システムは通常、会話履歴を保持し、ユーザーの質問、AIの回答、その回答が依拠した知識ソースを含み、状態(回答済み、部分回答など)でフィルタできる(Alibaba Cloud AIカスタマーサポートのドキュメント)。このデータを週に20分見るだけで、3種類のシグナルが得られる:
- 繰り返し出るがうまく答えられない質問:ナレッジベースに項目不足。FAQを補う;
- 回答が曖昧な質問:ドキュメントが抽象的。具体的なパラメータや例を補う;
- 顧客が主動的に聞くが準備していない質問:プリセールス需要のシグナル。製品とマーケティングへフィードバックする価値がある。
一部のシステムは「質問最適化」入口を提供し、未解決の問題をワンクリックで新しいFAQ項目に変換でき、標準回答を補うだけでよい。これを週次会議のプロセスに組み込めば、ナレッジベースは自ら成長する。
公開後:ナレッジベースの更新リズムと責任者
AIカスタマーサポートが公開から3か月後に誤答し始める場合、ほとんどはナレッジベースを誰も管理していないことが原因だ。固定リズムで保守することを勧める:
- 毎週:未解決問題リストを整理し、FAQを3〜5件補う;
- 毎月:価格ページ、プランページとドキュメントの整合性を確認し、期限切れのキャンペーン内容を非公開にする;
- 各リリース時:公開当日に機能ドキュメントと更新ログを同期更新し、AIを旧バージョンの代弁者にしない;
- 四半期ごと:実際の会話30件を抽出検査し、テストセットを再実行し、解決率の変化を記録する。
責任者はカスタマーサポート責任者でなくてもよいが、必ず1人の人間でなければならず、「チーム」ではいけない。複数人での共同管理は、誰も責任を負わないことと同じだ。
あるSaaS企業の完全な連携例
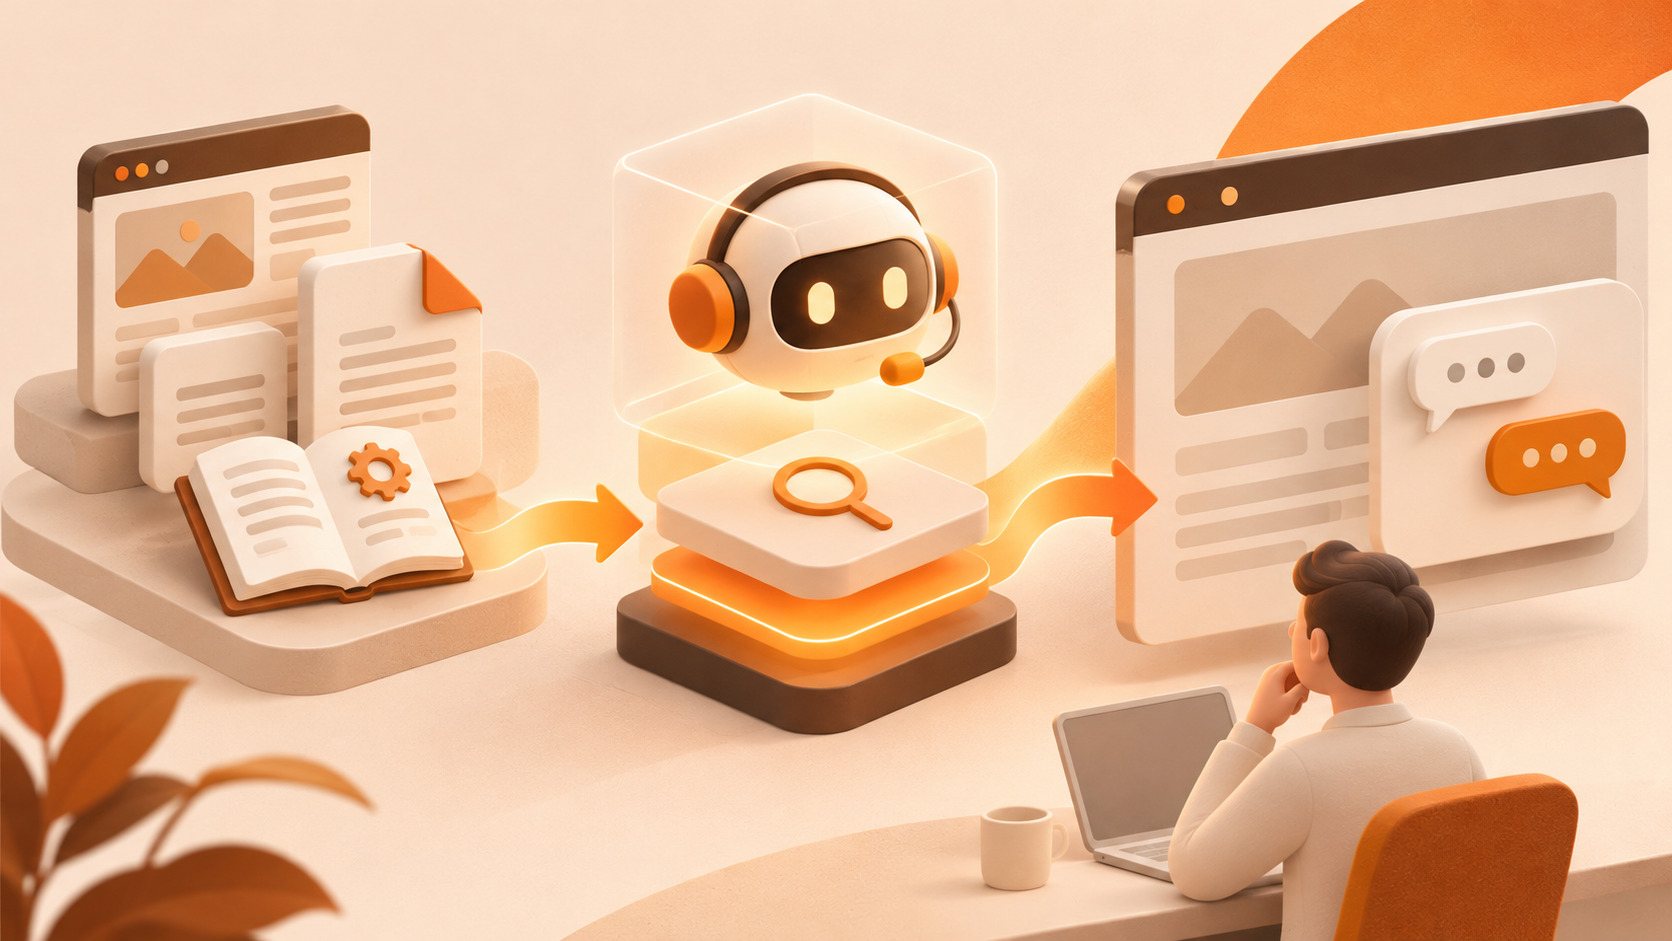
データダッシュボードを提供するSaaS企業が新しい公式サイトを公開したばかりで、製品には無料版、チーム版、プライベートデプロイの3形態があり、ドキュメントはヘルプセンターとPDFマニュアルに散在していると仮定する。
- ユーザーの質問:訪問者が価格ページ右下のウィンドウに「80人の分析チームで、データを社内ネットワークの外に出せません。どのように課金されますか」と入力する。
- 検索:システムがヘルプセンター、プライベートデプロイ説明、PDF見積マニュアルから関連内容を取得する。
- 回答の構成:まずデプロイ形態が「データを社内ネットワークの外に出さない」を満たすか答え、次にプライベートデプロイ方案の課金軸を説明する。口調は控えめにし、具体的な金額は約束しない。
- 関連ページの提示:プライベートデプロイ説明ページと営業への問い合わせ入口を添える。
- 解決できない場合は有人対応へ:ユーザーが契約条項と実施期間を追問し、高リスクキーワードに一致したため、直接有人対応へ切り替え、会話サマリーを添える。
- 蓄積:この質問は未解決リストに入り、運用担当が「プライベートデプロイはどのように課金されるか」というFAQを1件補う。
連携全体の中で、AIは「推測」しておらず、各ステップを1つのドキュメントまで追跡できる。
この連携でwe0が担えること、自社開発が必要なこと
企業サイト自体がまだ構築段階にあるなら、サポート機能も一緒に計画するほうが楽だ。we0の位置づけは、正式納品に向けたサイト機能の集合であり、公式の機能一覧にはAI機能接続(テキスト、画像、動画、音声などの生成機能。対話製品への拡張に適する)、CMSと管理バックエンド、認証体系、多言語構成、公開・リリースが含まれ、適用シーンではインテリジェントカスタマーサポートやナレッジベース系アプリケーションが明記されている(we0機能一覧)。
境界を明確にする必要がある。これらはサイト構築とAI接続の基盤機能であり、すぐに使える企業ナレッジベース型カスタマーサポートと同義ではない。ドキュメントの分割とインデックス、検索戦略、ユーザー権限による知識フィルタ、有人サポートへの転送とチケット連携は、通常、そのフルスタックコード生成能力を基に自社開発するか、サードパーティのRAGとカスタマーサポートシステムを統合する必要がある。評価時には「サイトを生成できる」と「ナレッジベース型カスタマーサポートを運用できる」を別物として扱えば、公開後に連携の半分が欠けていることに気づく事態を避けられる。
コンプライアンスとコンテンツ境界:どの資料をクロールしてはいけないか
知識ソースが広いほど、コンテンツがどのように入ってくるかに注意する必要がある。公開され、クロールが許可された自社コンテンツと許諾済み資料だけを取り込み、ペイウォール、ログイン制限、アンチクロール機構を回避してサードパーティコンテンツを取得してはいけない。EU司法裁判所のある顧問意見はこの点で参考になる。チャットボットが回答中にリアルタイムでニュース出版コンテンツを検索・再利用することは、コンテンツが違法に取得された場合、または回答の文言が原文をほぼ代替できる場合、出版者の権利侵害を構成する可能性がある。一方、自分の言葉で事実要約を作成し、原文リンクを示す場合はリスクが大幅に低い(関連案件の解説)。
企業公式サイトのカスタマーサポートにとって、この原則を翻訳すると簡単だ。ナレッジベースに入れるのは自社資料と許諾済みコンテンツであり、回答は要約と出典を中心にし、他人のコンテンツを全文復唱しない。
よくある質問
AIカスタマーサポートはPDFとWordを直接読めますか?
はい。一般的なサイト構築・カスタマーサポートプラットフォームを例にすると、ファイルアップロードはpdf、doc、docx、txt、markdown、excelなどの形式に対応し、アップロード後は解析プロセスを経て、解析成功後に検索対象となる(Alibaba Cloud AIカスタマーサポートのドキュメント)。スキャン版PDFは先に検索可能なテキストへ変換する必要がある。
ナレッジベースの価格が頻繁に変わる場合、どうやって正答を保証しますか?
価格、プランなど頻繁に変わる情報は個別にFAQ標準回答とし、月1回の確認を指定する。価格を複数のPDFに分散して書いてはいけない。そうしないとモデルが異なるバージョンを検索してしまう。
AIカスタマーサポートは内部資料を顧客に漏洩しますか?
知識範囲の区切り方次第だ。公開知識と内部資料は別の知識セットに置き、内部資料はログイン済みの特定ロールだけに公開する。プロンプトでモデルに「言わないでください」と頼む方法ではない。
回答にはソースリンクを付けるべきですか?
付けることを勧める。信頼性を高めるだけでなく、振り返り時に回答がどのバージョンのドキュメントに基づくか確認できる。
どのくらいで公開できますか?
主な時間は資料整理とテストセットの抽出検査にかかり、技術接続ではない。まずカバレッジ70%のバージョンを公開し、その後週単位でFAQを補うほうが、一度に全カバレッジを目指すより現実的だ。
関連ツール
- ナレッジベースとカスタマーサポートコンソール:サイト取り込み、ファイルアップロード、FAQ、質問最適化を管理
- CMSとコンテンツバックエンド:ヘルプセンター、製品ドキュメント、価格ページのバージョンを保守
- サイト分析ツール:対話入口のクリックとコンバージョンパスを観測
- チケット / IMシステム:AIから転送された有人会話と会話サマリーを引き受ける
- RAGとベクトル検索サービス:検索層を自社構築する場合に使用
関連リンク
まとめ
企業サイトにAIカスタマーサポートを導入する際、本当のエンジニアリングはチャットウィンドウではなくナレッジベースにある。まず製品資料をWebページ、ドキュメント、FAQの3種類に分けて棚卸しし、バージョンを収束させる。次にRAGで「検索—生成—引用」の連携を構築する。ウィンドウを設置するのは最後のステップにすぎない。公開後は、回答範囲の限定、FAQ優先、出典の必須化、テストセットの抽出検査で捏造リスクを抑え、有人切り替えリストで複雑な問題を守り、毎週の未解決リストでナレッジベースを継続的に成長させる。これらを責任者のいる固定リズムに変えて初めて、AIカスタマーサポートは反復問い合わせを本当に減らすのであり、誤った回答をより流暢に話すのではない。