curl -sL https://www.example.com/ | grep -o "[^"
curl -sL https://www.example.com/ | head -c 1200
レスポンスに `
` と大量のscriptタグしかなく、読める会社名、製品名、段落テキストがなければ、検索クローラーが最初に取得するのはこの空の殻である。GoogleのJavaScript SEOドキュメントはクロールとレンダリングの関係を説明している。スクリプト内容が完全に見えないわけではないが、レンダリングには追加のクロールキューとリソースが必要で、コンテンツとリンクがスクリプトに依存するほど、正しく読み取られる不確実性が高まる([Google JavaScript SEO の基本](https://developers.google.com/search/docs/crawling-indexing/javascript/javascript-seo-basics)参照)。
**修正方法**:重要コンテンツを初期HTMLに入れる——サーバーサイドレンダリング、静的生成、または少なくともタイトル、本文、内部リンクを実際のタグとして出力する。判断基準は簡単である。ブラウザのJavaScriptをオフにしても、ページが読めること。
## チェック2:TitleとMeta Descriptionは正しく書かれているか

AIがページを生成するときに最も漏れやすいのがメタデータである。なぜなら画面上では完全に見えないからだ。頻出する3つの誤り:
- **サイト全体で同じTitle**:テンプレート変数が置換されず、すべてのページが「ホーム | 某テック企業」になる;
- **Descriptionが空**:Googleが本文から独自に抜粋するしかなく、要約が情報量のない読み物になりがち;
- **Titleが長すぎる**:中国語のタイトルは約30文字を超えるとモバイルで切れ、訴求点が途切れる。
```html
企業サイト構築:要件定義から公開までの完全な流れ | ブランド名
セルフチェック方法:主要5ページ(ホーム、製品ページ、料金ページ、事例ページ、ブログページ)を抽出し、Titleがそれぞれ異なり、そのページの主題語を含むことを確認する。Descriptionは完全な一文であり、キーワードの詰め込みではないこと。
チェック3:sitemap.xmlとrobots.txtは本当に使えるか
この2つのファイルはクローラーがサイトに入る入口であり、AIサイト構築で最も見落とされやすい2ファイルでもある——画面上に存在しないからだ。
# https://www.example.com/robots.txt
User-agent: *
Disallow: /admin
Disallow: /preview
Disallow: /api
Allow: /

Sitemap: https://www.example.com/sitemap.xml
    https://www.example.com/pricing
    2026-03-01
重点的に3つを確認する。sitemap内のドメインは正式ドメインでなければならず、プレビュードメインではない。Disallowされたパスが同時にsitemapに現れてはいけない。Sitemap:行は絶対アドレスでなければならない。
同時にrobots.txtの限界を理解しておく。Googleはインデックスガイドで、robots.txtが制御するのはクロールであり、信頼できるインデックス防止手段ではないと注意している。robots.txtでブロックされたURLでも、外部リンクによって検索結果に現れることがある。ページを明確にインデックスさせない必要がある場合はnoindex(robots metaタグまたはX-Robots-Tagレスポンスヘッダー)を使うべきである。Googleはまた、2026年10月のドキュメント更新で「検索向けコンテンツのみをインデックスする」セクションを追加し、共有、共同作業、ツール出力専用の生成ページをデフォルトでインデックスしない設定にし、Search Consoleのページインデックスレポートと検索パフォーマンスレポートでインデックス異常を監視することを推奨している(詳細はGoogleインデックスガイド更新の解説)。
チェック4:canonicalはこのページを指しているか
rel=canonicalは検索エンジンに「この類似URL群の中でどれが主バージョンか」を伝える。AI生成時には3種類の誤りが頻出する:
- すべてのページがホームを指し、Googleに各ページがホームのコピーだと伝えるのと同じになる;
- プレビューまたはテストドメインを指し、正式ページが逆にコピー扱いになる;
- パラメータ付きアドレスとクリーンなアドレスが互いを指し、シグナルが行き来して衝突する。
-
正しい方法は、canonicalに絶対アドレス、https、あなたがインデックスされたい最終URLと完全に一致(末尾スラッシュの有無はサイト全体で統一)させること。多言語サイトでは各言語バージョンが自分自身を指し、hreflangで対応関係を構築する。英語版へ相互canonicalしない。
チェック5:構造化データに誤った情報が書かれていないか

AIは構造化データを「補完」するのが得意で、ついでに捏造するのも得意だ。存在しない評価、ない価格帯、架空の設立年。これらは構造化データの基本要件に違反する——データはページ上の可視コンテンツと一致しなければならない。
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "name": "ブランド名",
  "url": "https://www.example.com/",
  "logo": "https://www.example.com/logo.png"
}
原則は「少なすぎるより多すぎない」である。ページ上で見えるフィールドだけを書く。不確かな設立時期、評価、在庫状態は一律削除する。公開前に構造化データテストツールで実行し、解析エラーがないことを確認する。
チェック6:フォーム、ポップアップ、インタラクションがクローラーを妨げないか
フォーム自体はインデックスに影響しない。問題はそれらがしばしば本文を「置き換える」ことにある。ページ全体がリード獲得フォームだけ、コンテンツがログイン後にロック、ファーストビューで全画面ポップアップがCookie同意を先に求める。クローラーにとって、こうしたページは検索意図とのマッチングに使えるテキストが不足している。
また、AIサイト構築は大量の「使い捨て」ページを生成しがちだ——フォーム送信成功ページ、見積結果ページ、共有リンク。こうしたページがインデックスされると、サイト品質が薄まる。Googleの推奨に従い、デフォルトでnoindexにする方が安全である(インデックスガイド解説)。本当に検索向けのランディングページは、クリックで展開させるのではなく、完全に可視のHTML本文を保持すべきである。
数分で紹介サイトを作り、リード獲得を伸ばす
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
チェック7:次にAIでページを修正すると、SEO設定が戻らないか
これはAIサイト構築で最も過小評価されやすいリスクだ。ページは継続的に生成され、今日手作業で補ったTitle、canonical、robotsルールは、明日の「配色を変えて、ついでにコピーも最適化して」という再生成で上書きされる可能性がある。
実行可能な方法は記憶に頼らず、プロセスで制約することである:
- SEO関連設定をテンプレートまたはグローバル設定に集約し、ページごとの手書きを減らす;
- 再生成のたびにチェックリストを実行し、少なくともホーム、製品ページ、料金ページをカバーする;
- URL数の異常増加に注意する。テンプレート変更や新機能公開はしばしば新URLを一括生成する。Googleはプラットフォーム側のコンテンツ作成量とインデックス量の変化を同時に監視することを推奨している(同上);
- 公開前に必ず一度「設定項目Diff」を行う。Title、canonical、robots、sitemapの4項目を前回リリース版と比較する。
チェック8:なぜこれに投資する価値があるのか
テクニカルSEOは一部の専門家だけの話題ではない。Mordor Intelligenceの統計によると、テクニカルSEOサービス市場は2025年に15.73億ドル、2026年の16.89億ドルから2031年の28.37億ドルへ成長し、2026—2031年のCAGRは約10.93%と予測されている。うちテクニカルSEOカテゴリは2025年に32.41%を占める。理由はまさにレンダリング、サイト構造、リダイレクト、構造化データ、ページパフォーマンスが、コンテンツを大規模に発見・取得できるかを直接左右するからだ。レポートは同時に、Googleが依然としてCore Web Vitalsを検索評価に含めていると指摘している(データはTechnical SEO Services 市場レポート参照)。言い換えれば、ページの公開は始まりにすぎず、クロールされ、理解され、引用されるかどうかが、検索とAI検索時代の入場券なのである。
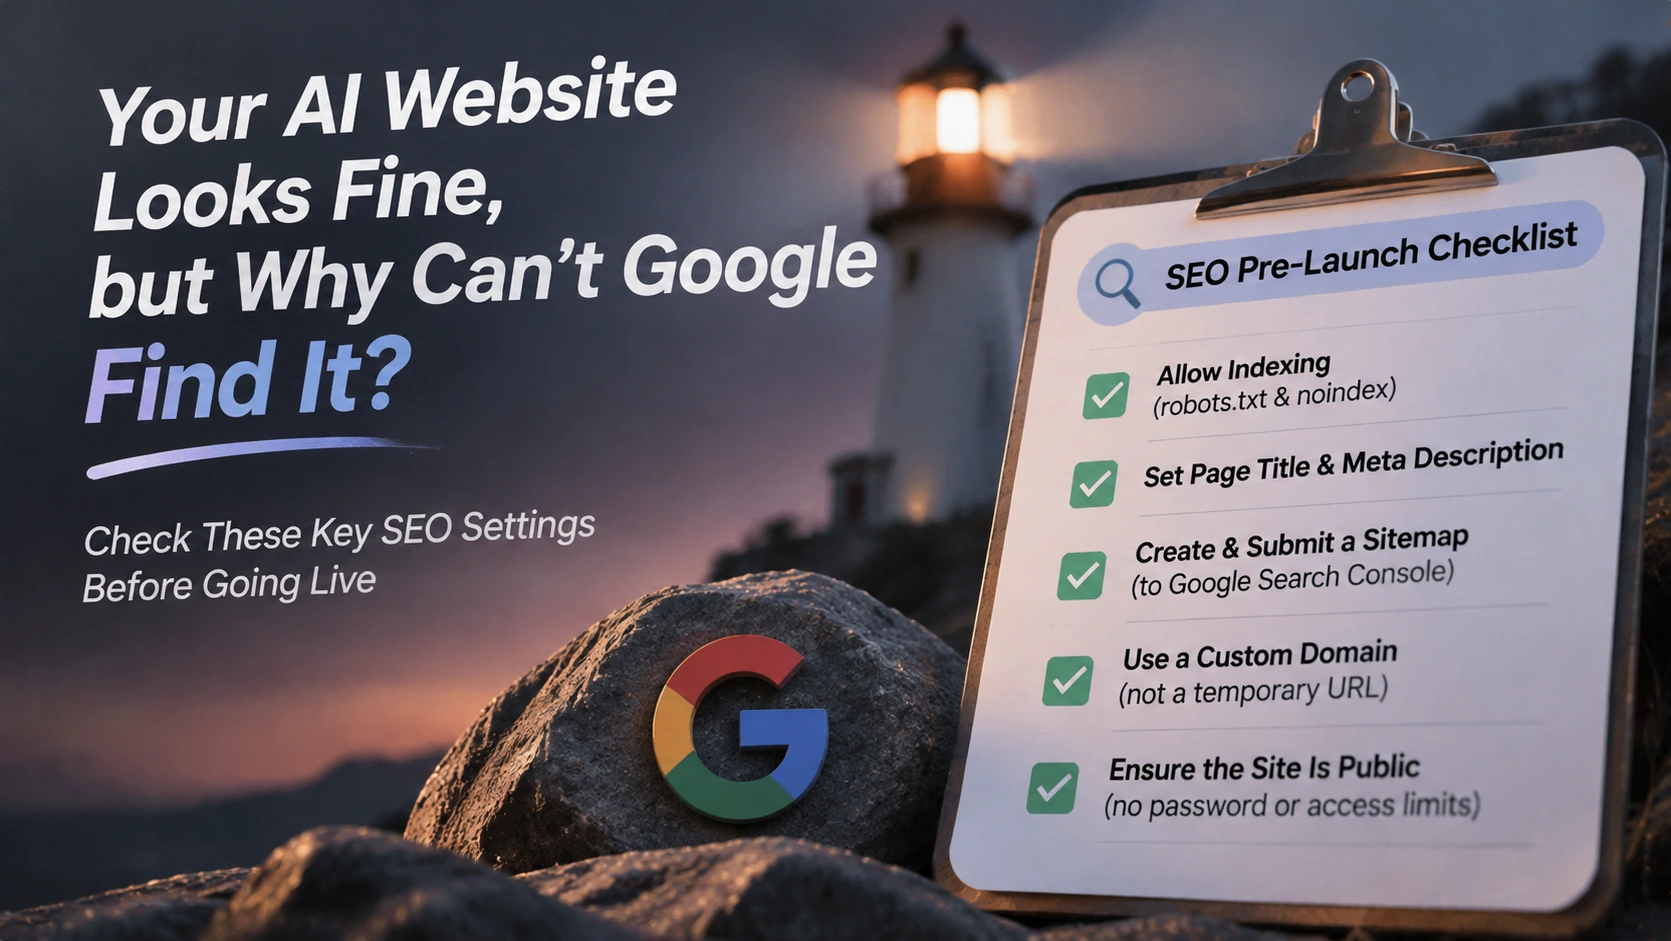
AIサイト構築の公開前10項目SEOチェックリスト
| # | チェック項目 | 合格基準 |
|---|---|---|
| 1 | 初期HTML | JSをオフにしてもタイトルと本文が見える |
| 2 | HTTPステータス | 主要ページが200を返し、旧アドレスは301で新アドレスへ |
| 3 | Title | 各ページで一意、主題語を含み、長さが適切 |
| 4 | Meta Description | 各ページ独立、完全な文 |
| 5 | robots.txt | 管理画面とプレビューのパスのみブロック、Sitemapは絶対アドレス |
| 6 | sitemap.xml | 正式ドメインとインデックス可能ページのみを含む |
| 7 | canonical | 自身の正式URLを指し、サイト全体でスラッシュ規則を統一 |
| 8 | noindex | プレビューサイト、結果ページ、共有ページはデフォルトでインデックスしない |
| 9 | 構造化データ | ページ上で可視のフィールドのみ記述、解析エラーなし |
| 10 | インタラクションとフォーム | 本文がポップアップ、ログインウォール、フォームに占有されない |
この表の価値は「高度なテクニック」ではなく、再現性にある。公開前に毎回実行すれば、10分で「作ったのに検索できない」の大半を防げる。
企業が今すべきこと
AIツールでサイトを構築しているなら、順序を次のように変えられる。まず構造とコンテンツを生成し、次にメタデータとインデックスルールを補い、最後に公開前検証をまとめて行う。We0のようなAIサイト構築プラットフォームは、ページ生成、CMSバックエンド、ドメイン展開、SEO/GEO設定を同じチェーンに置いている(We0公式サイト参照)。生成速度が速いことは一つの前提を変えない。検索エンジンは実際にHTMLへ出力されたものしか認識しないため、公開後の実測は依然として省略できない。
具体的なアクションは3ステップを推奨する。まずcurlで初期HTMLを見て、次にSearch Consoleでクロールとインデックス状態を確認し、最後に上記10項目を公開前の固定プロセスにして、チームのリリースフロードキュメントに書き込む。
FAQ
Q:AIが生成したサイトは本質的にSEO要件を満たさないのか?
いいえ。AI生成はあくまで生産方法であり、問題は生成プロセスがデフォルトで「ページの見た目が正しいか」に注目し、「検索エンジンが何を読んだか」を確認しないことにある。初期HTMLに本文が含まれ、メタデータとインデックスルールが正しければ、AIサイト構築と手作業でのサイト構築の検索パフォーマンスに本質的な差はない。
Q:ページがGoogleで見つからないのは、ペナルティを受けたからか?
多くの場合、まだ「ペナルティ」の段階ではなく、クロールまたはインデックスされていないだけである。まずインデックス状態を確認し、次にrobots.txtやnoindexでブロックされていないか確認し、最後にコンテンツ品質と競争度の問題になる。
Q:sitemapを送信するだけでインデックスは保証されるか?
いいえ。sitemapは発見の手がかりであり、インデックスの約束ではない。クローラーにどのページがあるかを早く知らせられるが、ページがインデックスされるかはクロールアクセス、コンテンツ品質、インデックスルール次第である。
Q:JavaScriptでレンダリングされたページはGoogleに必ず読まれないのか?
必ずしもそうではないが、不確実性は高い。レンダリングには追加リソースが必要で、ページがスクリプトに依存するほど、ファーストビューのテキストとリンクが正しく読まれる確率は下がる。中核コンテンツを初期HTMLに入れるのが最もコストの低い保険である。
Q:効果はどのくらいで見えるか?
インデックスとランキングに統一されたタイムテーブルはなく、クロール頻度、サイト規模、競争状況による。確実なのは、設定ミスは、あなたが発見して修正するまでずっと有効だということである。
関連ツール
- Google Search Console:ページインデックスレポートと検索パフォーマンスを確認
- Google JavaScript SEOドキュメント:レンダリングとクロールの実際のルールを確認
curl/ ブラウザ開発者ツール:初期HTMLとJSオフ後の可読性を検証- 構造化データテストツール:JSON-LDが解析可能か検証
関連リンク
- Google JavaScript SEO の基本
- Googleインデックスガイド更新の解説:共有可能ページと生成コンテンツ
- Technical SEO Services 市場規模とトレンドレポート
- We0公式サイト
まとめ
AIサイト構築は公開を速くするが、検索エンジンの働き方は変えていない。検索エンジンはHTML、レスポンスヘッダー、リンク構造を読み、あなたの画面上の完成イメージを読むのではない。公開前に初期HTML、TitleとDescription、robots.txtとsitemap、canonical、noindex、構造化データ、フォームとインタラクションの7箇所を確認し、それをプロセスとして定着させれば、「サイトは作ったのに流入がない」を常態から調査可能な問題に変えられる。