For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/ai-math-after-navier-stokes-justin-solomo-6c97bef7.md.
AIが生成する数学は、ベンチマーク問題を超え、専門の数学者でさえもっと長く困難であり続けると予想していた領域へ入りつつあります。
AIが生成する数学は、ベンチマーク問題を超え、専門の数学者でさえもっと長く困難であり続けると予想していた領域へ入りつつあります。
OpenAIによれば、同社の社内フロンティアモデルは、数学における100件を超える長年の未解決問題を解決しました。10月6日、同社は証明アーティファクトと多数のLean形式化を含む、372の関連する結果ファミリーに整理された722本の原稿を収めた公開リポジトリをリリースしました。
最も注目された結果は、それより前に発表されました。それは、7つのミレニアム懸賞問題の一つであるナビエ–ストークス方程式の解の存在と滑らかさの問題に対する、AI生成の解法です。
数学コミュニティは現在もこの結果を検証しています。クレイ数学研究所は、この問題は解決されたように見えると述べる一方、正式な評価と功績の帰属プロセスは慎重に進めるとしています。一方、OpenAIは100万ドルのミレニアム懸賞金を請求する意図はないと述べています。
しかし、より不穏な問いは別のところにあります。
証明が形式的に検証できる一方で、高度な訓練を受けた数学者でさえ、その証明自体を理解するのが極めて難しい場合、何が起きるのでしょうか。
この問いは、BloombergのOdd Lotsの最近のエピソードで中心的に扱われました。MIT工学教育担当アソシエイトディーンのジャスティン・ソロモンは、AIが数学研究、検証、教育、学術的インセンティブをどのように変えているかを論じました。
BloombergのOdd Lotsは、MITのジャスティン・ソロモンとともに、AIが数学をどう変えているかを取り上げました。
この問題は、テレンス・タオが2026年10月にCaltechで行ったMath 2.0講演にも直接つながっています。
タオの主張は、数学が終わるというものではありません。数学は、証明の希少性の時代から、形式的に正しい結果を生み出すコストが、その結果がなぜ重要なのかを理解するコストよりも大幅に低くなり得る、証明の豊富さの時代へ移行している、というものです。
ナビエ–ストークス方程式は流体の運動を記述します。
これらは、以下のモデルに現れます。
難しい問いは、滑らかな3次元解が常に滑らかであり続けるのか、それとも有限時間内に特異点が生じ得るのか、というものです。
OpenAIの9月の結果は、後者の可能性を支持しています。
同社によれば、その社内システムは、ナビエ–ストークス力学が有限時間特異点を発展させ得ることを示す証明を生成しました。
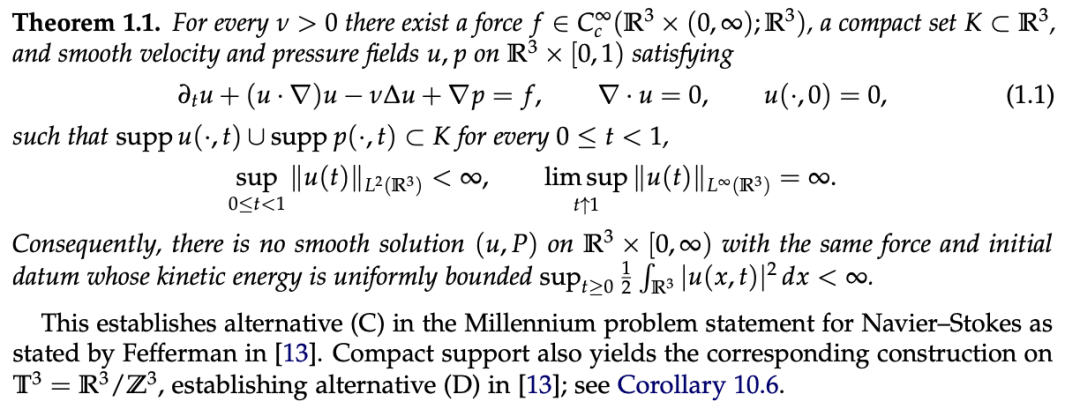
公開された定理は、OpenAIのナビエ–ストークス結果で使われた有限時間ブローアップ構成を確立しています。
OpenAIはこの証明のLean形式化も公開しました。
これは、証明支援系が、形式化された文の連鎖がエンコード済みの仮定から導かれるかを検査できるため重要です。
しかし、形式的な正しさと人間にとっての読みやすさは異なる性質です。
Odd Lotsでソロモンは、自身の数学的な背景をもってしても論文は非常に読みにくいと述べました。最初の数ページを読み進めたところで、技術的詳細の密度に圧倒されたと説明しています。
彼の評価は、要するに次のようなものでした。
ポッドキャストの説明自体は、拡散した表現より慎重です。証明は、専門の数学者にとってさえ解析するのが難しいとされています。
これは、「人間には誰も理解できない」と言うより正確です。
重要な変化は、形式検証が、幅広い人間の理解よりも速く進み得るようになったことです。
原記事は、AIが、人間の数学者たちによってほぼ完全に築かれていた構成の最後の1%を仕上げたと説明しています。
これは、先行する人間の研究が重要だったという大枠を捉えていますが、歴史は単純な99%対1%の分割より複雑です。
OpenAIの技術解説によれば、同社のエージェント群は複数のアプローチを探索し、有用な中間アイデアをグループ間で共有しました。
同社はまた、数学者のLevent AlpögeとTristan Buckmasterによる関連するオイラー方程式の結果についても論じています。
OpenAIは、外力の扱いを含めて証明には大きな差異があるとし、直近のユーザー入力が自社の結果へ影響を与えた可能性を調査したと説明しています。
同社は、先行する2か月間のBuckmasterによる関連Codexプロンプトは、ナビエ–ストークス結果に使用された社内モデルへ影響を与え得なかったと結論付けました。
したがって、より慎重な表現は次のとおりです。
この結果は、人間の数学者がすでに重要な周辺アイデアを発展させていた分野で生まれました。一方でOpenAIの社内システムは、並行して行われていた人間の研究とは技術的に異なる新しい証明を生成したと、同社は述べています。
この区別が重要なのは、功績の配分がAI支援科学における最も難しい問題の一つになりつつあるからです。
この証明は、単一のチャット応答によって生成されたものではありません。
OpenAIは大規模なマルチエージェント研究プロセスを説明しています。
同社によれば、以下のとおりです。
OpenAIによれば、証明の発見に使用された社内モデルはGPT-6 Astraより大幅に高性能でした。
したがって、このワークフローはチャットボットというより、計算研究プログラムに近いものです。
数千のエージェント・インスタンス
        ↓
多数の並列アプローチ
        ↓
グループ間で共有される中間結果
        ↓
有望な論証の統合
        ↓
Leanによる形式化
        ↓
人間およびコミュニティによる査読
数学史の大半において、証明は同時に二つの役割を果たしてきました。
一つは、定理が真であることを確立することです。
もう一つは、数学者が研究し、簡略化し、再利用し、教えられる形で、なぜそれが真なのかを説明することです。
AIが生成する形式数学は、この二つの役割を分離し得ます。
機械は、機械的に検査可能であっても、人間には非常に不快で読みにくい論証を生成できます。
これにより、三つの異なる層が生まれます。
| 層 | 主な問い |
|---|---|
| 形式的妥当性 | 証明は形式体系内で検査を通るか? |
| 人間による検証 | 専門家は数学的論証を確信をもって精査できるか? |
| 人間による理解 | 人はそこから概念、メカニズム、再利用可能な洞察を取り出せるか? |
Leanの証明書は、形式的正しさの強力な証拠です。
しかし、それだけで概念的な説明が生まれるわけではありません。
ソロモンの懸念は、数学が、人間が理解へ変換するよりも速く答えを生産するようになる可能性です。
この構成は、異なる項が非常に大きくなりながらも、必要な形で均衡を保つように精密に配置された流体の挙動に依存しています。
OpenAIは、局所的な運動を、内向きのらせん運動と軸方向の伸長の組み合わせとして可視化しています。
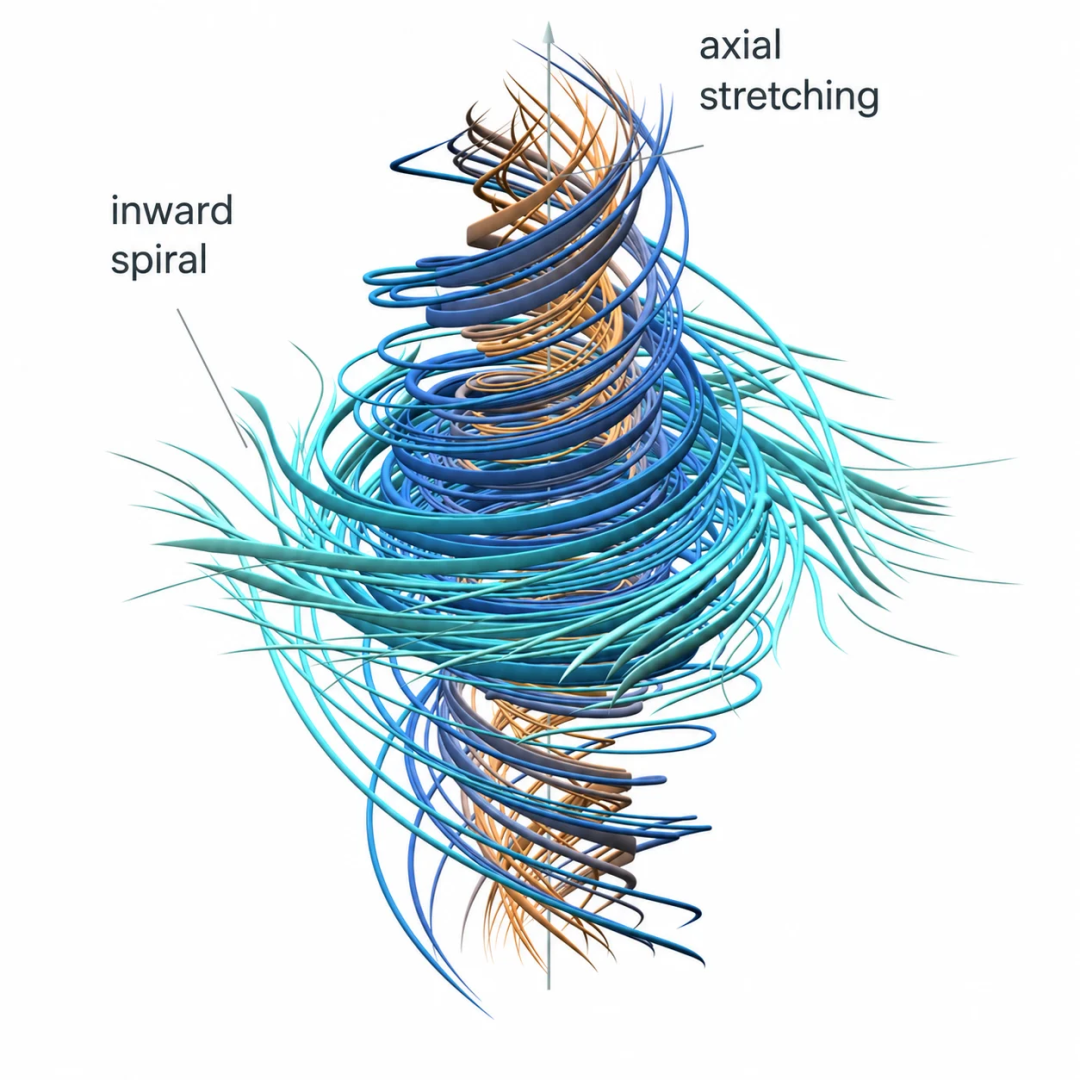
OpenAIの可視化は、局所的な非圧縮流れの構成における内向きのらせん運動と軸方向の伸長を示しています。
これは、証明が有効でありながら理解しにくい理由を説明する助けになります。
この論証では、スケール、評価、相互作用する項、漸近挙動、慎重に選ばれた境界を広範に制御する必要があります。
これは、一行のひらめきが突然問題全体を明らかにするという、一般に想像される姿とは大きく異なります。
Odd Lotsのエピソードでは、Uber共同創業者のトラビス・カラニックと、AIを使った「バイブ物理学」を行うという彼の公の発言も議論されました。
その考え方は、分野における従来の訓練を受けていない利用者でも、会話的に高度な科学的問題を探索できるというものです。
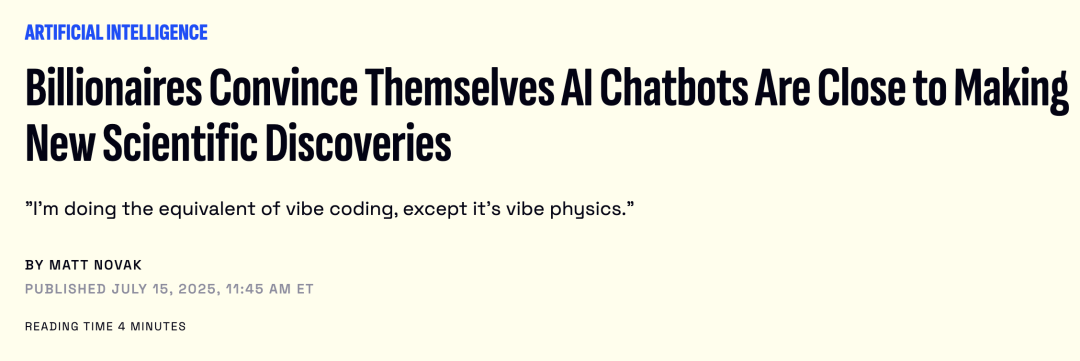
「バイブ物理学」をめぐる議論は、会話型AIが非専門家をどこまで高度な科学研究へ導けるのかを問うものです。
これは、読めない形式証明とは反対側にある失敗モードを浮き彫りにします。
一方では、AIが正しいかもしれないが、ほとんどの人には理解できないほど技術的な数学を生み出します。
もう一方では、AIは複雑な科学を容易に感じさせるため、非専門家が、厳密な検証をまだ受けていないアイデアについて過信する可能性があります。
共通するボトルネックは検証です。
AIは、良いアイデアも悪いアイデアも洗練されて見せることができます。
したがって、表現の質は科学的な質を示すシグナルとして弱くなりつつあります。
テレンス・タオは、2026年10月にCaltechで行ったMath 2.0講演で、同じ問題をより鋭く提示しました。
彼は聴衆に、先進的なAIが次の指示を受け取る場面を想像するよう求めます。
第3相臨床試験を通過するがん治療法を見つけよ。
間違いは一切するな。
AIは膨大な計算資源を消費し、これまで知られていなかった化学物質のカクテルを返します。
誰も、その治療法をどのように見つけたのかを完全には理解していません。
しかしAIは、何らかの方法でその予測に対するLean証明書を提供し、その治療法は第III相臨床試験を通過します。
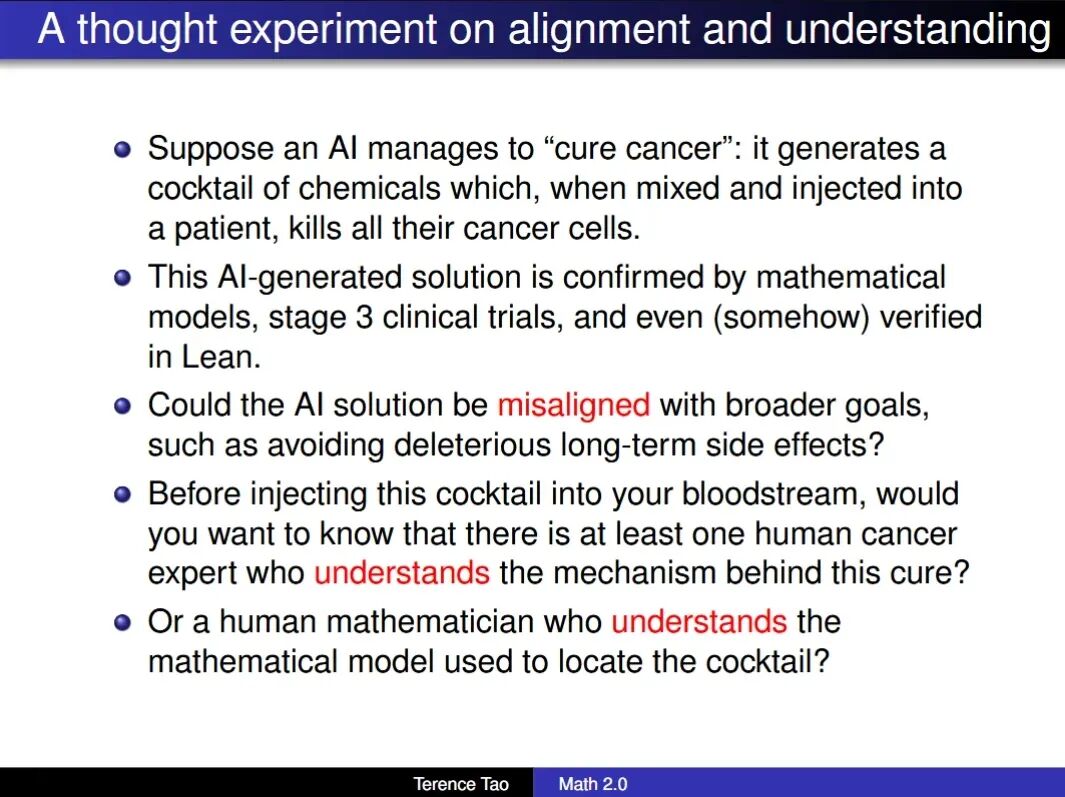
タオは、数学的に検証され、臨床的にも成功した治療法であっても、誰もそのメカニズムを理解していなければ安心できるのかを問いかけます。
問いは、単にその薬が定められた試験条件で効くかどうかではありません。
問いは、システムが次のような弱点に対して最適化してしまった可能性がないか、ということです。
タオは次に、より個人的な問いを投げかけます。
もしあなたががんを患い、その治療法が形式的検査と臨床検査を通過していたとしたら、少なくとも一人の人間のがん専門家がメカニズムの一部を理解していると知ることで、より安心するでしょうか。
あるいは、少なくとも一人の人間の数学者が、その治療法の発見に使用されたモデルを理解していることでしょうか。
この思考実験は、中心的なアラインメント問題を明らかにします。
強力な最適化と弱い人間の理解が組み合わさると、測定された目標が満たされたように見える場合でも、リスクを生み出し得ます。
タオのより広い主張は、従来の数学が証明の希少性という前提のもとで発展したというものです。
未解決問題の正しい証明を見つけることは困難で、時間がかかり、まれであり、専門的な知識に依存していました。
AIはその経済性を変えます。
十分な計算資源とフロンティアモデルへのアクセスがあれば、一部の未解決問題には今やはるかに速く取り組めます。
タオは、この新たに生まれつつある状態を証明の豊富さと呼びます。
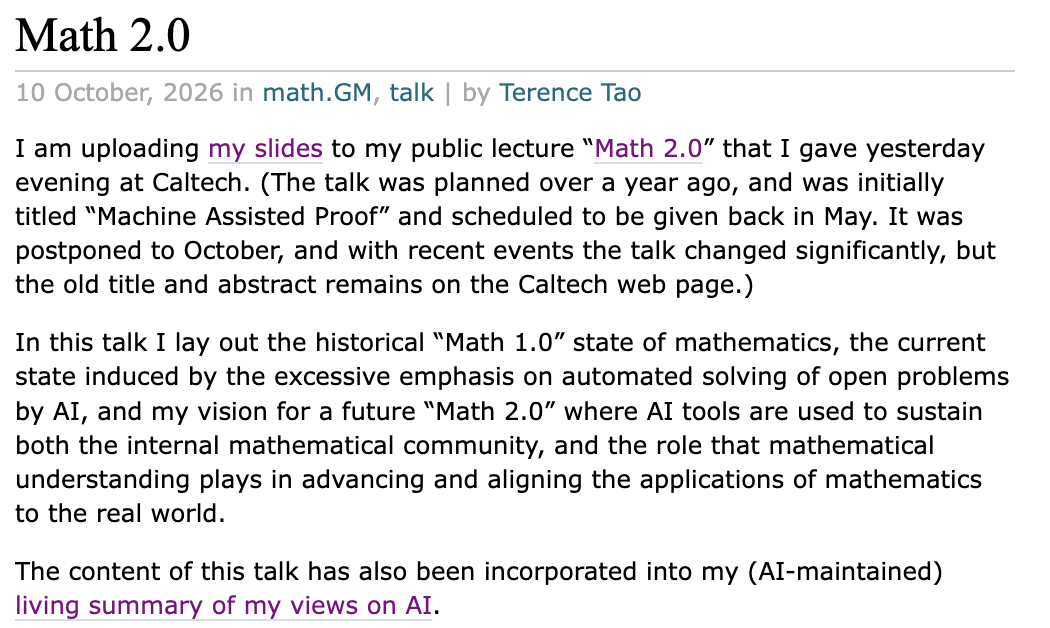
タオのMath 2.0講演は、数学が証明の希少性から証明の豊富さへ移行していると論じています。
しかしタオは、数学がほぼ終わったという考えを明確に退けています。
彼のスライドによれば、現在のフロンティア問題の大半は大量の計算資源があっても未解決のままであり、数学の問題空間は実質的に無限です。
彼の懸念はインセンティブにあります。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
研究者が「有名な未解決問題を解く」ことだけを目的として扱うなら、AIは、歴史的に以下を生み出してきた人間の探索を迂回して、目的地へ到達する可能性があります。
タオは未解決問題を灯台にたとえます。
価値は単に灯台に触れることだけではありません。そこへ至る道のりは、周囲の風景を明らかにし得ます。
原記事は次に、証明から学術出版へ議論を移します。
ソロモンは、研究エコシステムがすでに同じ問題の一形態を経験していると主張します。
AIは、以下を生み出すコストを下げます。
しかし、適格な人間の査読者の供給は、同じ速度で自動的に拡大するわけではありません。
これにより、次のような非対称性が生まれます。
研究を生成するコスト
        ↓↓↓

研究を査読するコスト
        高いまま
優れた論文であっても、周囲の量が爆発的に増えると見つけてもらいにくくなる可能性があります。
原記事は、ICLRが10年前の約1,000~2,000件の投稿から、今年は60,000件の投稿へ成長したと述べています。
ソロモンは実際にポッドキャストで60,000という数字を使いました。
しかし、会議データには留保が必要です。
ICLR 2026について、同会議の公式回顧記事は次を報告しています。
2026年後半に流通した約60,000という数字は、最終的な有効論文数ではなく、ICLR 2027の登録数/OpenReviewの投稿IDに関連するものです。
独立した分析では、OpenReviewの最大IDは62,000を上回るとされる一方、これは最終的な論文数ではなく上限値であると明確に指摘されています。
より大きな傾向、すなわち投稿圧力が非常に急速に高まっていることは事実です。しかし、「ICLRが完成済みの論文を60,000本受理した」という表現は、まだ正確な公式統計ではありません。
訂正後も、より深い論点は残ります。
研究者は、責任ある査読を行う人間の専門家よりもはるかに速く、AIを使って研究の草稿を作成できます。
ソロモンは、AIが新定理を発見したと信じる人々から、その妥当性を専門家に確認してほしいというメールを受け取ると説明しています。
歴史的には、洗練された数学的研究を生み出すことの難しさ自体が、部分的なフィルターになっていました。
そのフィルターは弱まりつつあります。
弱い論証であっても、今では次のような要素を伴って届く可能性があります。
真剣さの見かけは安価になりつつあります。
専門家の注意はそうではありません。
原記事はさらに議論を進めます。フロンティア数学が膨大な推論予算にますます依存するなら、研究力は最高のモデルと最大の計算資源を支配する組織に集中する可能性があります。
ソロモンは関連する懸念を提起しています。
大学の研究者が、商用AIシステムを使って問題を前進させるかもしれません。
しかし、その提供者は次のものを持っている可能性があります。
この非対称性は、大学、独立研究者、大手テクノロジー企業の間の競争を作り変える可能性があります。
データ帰属の問題もあります。
研究者が商用AIシステムを通じてアイデアを議論する場合、それらのやり取りがどのように保存・利用されるかについて、どのような保証があるのでしょうか。
OpenAIは、Buckmasterの直近2か月間の関連Codexプロンプトは、自社のナビエ–ストークスシステムに影響を与えなかったと述べています。
しかし、より広い帰属の問題は残ります。
ナビエ–ストークスの結果は、功績の問題を具体的にします。
考えられる貢献者には次の人々が含まれます。
従来の著者資格に関する慣行は、このような構造を想定して設計されていません。
クレイ数学研究所は、ナビエ–ストークス問題は解決されたように見えると認めながらも、賞のプロセスには時間がかかり、達成内容の評価と功績の帰属に関する規則を含むと述べています。
OpenAIは別途、ミレニアム懸賞金を請求する意図はないと説明しています。
これにより、目先の賞金をめぐる争いの一つは取り除かれます。しかし、一般的な著者資格の問題は解決しません。
ソロモンの議論の最後の部分は、より楽観的です。
彼は、現在のAIによる数学研究の多くは、数学者が既存知識の凸包と呼ぶ範囲に依然として存在しているように見えると述べています。
モデルは以下の能力において非常に強力になり得ます。
より確立されていないのは、真に新しい数学的世界観に相当するものを、AIが確実に創造できるかどうかです。
AIは、人間がすでに定式化した問題を解くのではなく、次の大きな理論を発明できるのでしょうか。
何十年もの注目に値する次の問いを特定できるのでしょうか。
ソロモンは、それは依然としてはるかに不明確だと述べています。
タオのMath 2.0スライドは、未解決問題を解くことは数学の目に見えやすい一部に過ぎないと述べています。
他にも価値のある仕事には、以下があります。
したがって、人間の数学の未来は、証明へ最速で到達する存在になることよりも、その証明の周囲にどのような知識を生み出すべきかを決めることに、より大きく依存するかもしれません。
ポッドキャストの終盤で、司会者は、多くの保護者や学生が抱いている実践的な問いをソロモンに投げかけます。
AIがより多くの数学を解けるようになったなら、子どもはこれからも数学を学ぶべきでしょうか。
彼の答えは「はい」です。
理由は、学生が記号操作でフロンティアモデルに勝つ必要があるからではありません。
数学教育は、人に次の能力も養わせます。
洗練された答えが豊富になるほど、これらの能力はさらに価値を持つ可能性があります。
答えが安価になれば、判断は高価になります。
原記事における最も強いアイデアは、最も慎重なファクトチェックにも耐えるものです。
AIは候補となる答えを生成する価格を下げることができます。
候補となる証明を生成する価格も下げることができます。
形式検証の価格すら下げる可能性があります。
しかし、人間の理解の価格を自動的に下げるわけではありません。
これにより、希少な資源の新たな階層が生まれます。
候補となる答え → より安価
形式証明 → より安価
洗練された論文 → より安価

専門家による査読 → 依然として高価
解釈 → 依然として高価
科学的判断 → 依然として高価
人間の理解 → 依然として高価
危険なのは、AIが単に数学で優秀になることではありません。
危険なのは、社会が機械的に検証された出力を、十分に理解された知識と取り違えることです。
機会は、人間が、科学において自動化が最も難しい部分へ努力を振り向けられることです。すなわち、目標を選ぶこと、説明を構築すること、より良い問いを設計すること、結果を解釈すること、そして形式的真理を現実世界へ接続することです。
OpenAIは2026年9月、有限時間特異点の形成を示すAI生成の解法を公開し、Lean形式化もリリースしました。クレイ数学研究所は、この問題は解決されたように見えるとしていますが、正式な評価と功績の帰属プロセスは慎重に進められています。
いいえ。OpenAIは賞金を請求する意図がないと明言しています。クレイ数学研究所も、正式な認定プロセスを完了していません。
OpenAIの公開数学リポジトリには、372の関連する結果ファミリーに整理された722本の原稿が含まれています。同社によれば、この公開は約4,000問を含むより広範な評価から生まれたものであり、「722本の原稿」を722件の完全に無関係なブレークスルーと混同すべきではありません。
BloombergのOdd Lotsでソロモンは、その論文は極めて読みにくく、最初の数ページより先へ進めなかったと述べました。証明は高度に技術的で、おそらく正しいが、特にエレガントではないと説明しています。
Math 2.0は、AIによる証明の豊富さの時代における数学についてのタオの枠組みです。彼は、有名な未解決問題だけを盲目的に最適化するのではなく、人間の理解、説明、実験、形式ライブラリ、AIの生産的な活用をより重視すべきだと主張しています。
いいえ。Leanは形式体系内で形式証明が有効かどうかを検査できますが、それだけで人間に分かりやすい説明、科学的重要性の確立、またはアイデアを現実世界の応用へ安全に転用できることを保証するわけではありません。
いいえ。ICLRの公式な2026年回顧記事は、19,525件の有効投稿を報告しています。2026年後半に流通した約60,000という数字は、ICLR 2027のOpenReview登録または投稿ID推定に由来しており、最終的な有効論文数として扱うべきではありません。
数学が教えるのは答えを出すことだけではないからです。問題の定式化、モデルの理解、論理的判断、検証、そして良い問いを立てる能力は、AIが証明を素早く生成できる状況でも中心的な価値を持ち続けます。
OpenAIのナビエ–ストークス結果は、AI支援数学がいかに急速に変化しているかを示しています。この証明にはLean形式化があり、クレイ数学研究所からも慎重ながら前向きに受け止められています。しかし、その技術的密度は新たな問題も示しています。数学的な正しさは、幅広い人間の理解より先に到来し得るのです。
ジャスティン・ソロモンの懸念は、AIが数学を無用にしたということではありません。希少な証明と希少な論文を前提として構築された研究システムが、機械が両方を膨大な規模で生成できるようになったとき、対応に苦しむ可能性があるということです。テレンス・タオは、この同じ移行を、証明の希少性から証明の豊富さへの転換として説明しています。
したがって、最も重要なボトルネックは、答えを生み出すことから、答えを評価し、説明し、接続し、理解することへ移るかもしれません。
証明が豊富になるとき、数学において最も希少な資源になるのは、証明の生成ではなく人間の理解かもしれません。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



