キーワード検索ボリュームが答えるのは「何人がこの語群で検索するか」であり、「この人が意思決定前に他に何を尋ねるか」ではない。AI検索は後者を決定的な変数に変えた。ユーザーがChatGPT、Perplexity、Gemini、Google AI Modeで制約条件付きの質問をすると、エンジンは自ら複数のサブクエリを生成して検索し、取得した段落を引用付きの回答に合成する。あなたが引用されるかどうかを決めるのは、ある語で上位表示されているかだけでなく、ページ内に単独で抽出でき、特定のサブクエリに正確に答える段落があるかどうかである。
したがってより正確には、検索ボリュームは依然として有用な需要規模のシグナルだが、それは起点指標であり終点指標ではない。キーワードリサーチには三つの追加作業が必要だ。すなわち、この需要の背後にある完全な質問チェーン、各質問に対応する検索形態、そしてページに抽出可能な回答ブロックがあるかどうかである。
検索ボリュームだけを見ると本当の購買意図を見落とす理由
従来のプロセスは「メインキーワード → 関連語 → コンテンツ」であり、各検索は独立し語形が固定された需要だと仮定していた。ユーザー行動はすでに変わった。実際の質問は予算、シナリオ、互換性、使い方を同時に含むことが多い。例えば「1万5千円以内、動画編集可能、バッテリー持ち良好、出張に便利なノートPC」などだ。これらの条件はAI検索では異なる分岐に分解され、それぞれ検索される。
B2B調達を例に取ると、「best CRM software」の背後には通常、連続する追问がある。中小企業に適するのはどれか?メール自動化に対応するか?Shopifyと連携できるか?月額最安はどれか?これら四つの質問の検索価値は元の語自体より高い可能性があるが、月間検索ボリュームはほぼゼロに近い。完全な問いを検索ボックスに入力する人は稀だが、AIにはそう尋ねる。
ここから二つの盲点が生じる。第一に、低検索ボリュームは低商業価値ではない。第二に、検索ボリュームは回答形態について何のヒントも与えない。比較型需要には表が必要、プロセス型需要には番号付き手順が必要、定義型需要には独立して成立する三五十字の説明が必要だとは教えてくれない。そしてまさにこれらの形態が、コンテンツが検索されるかどうかを決める。
Query Fan-Out(クエリファンアウト)とは何か
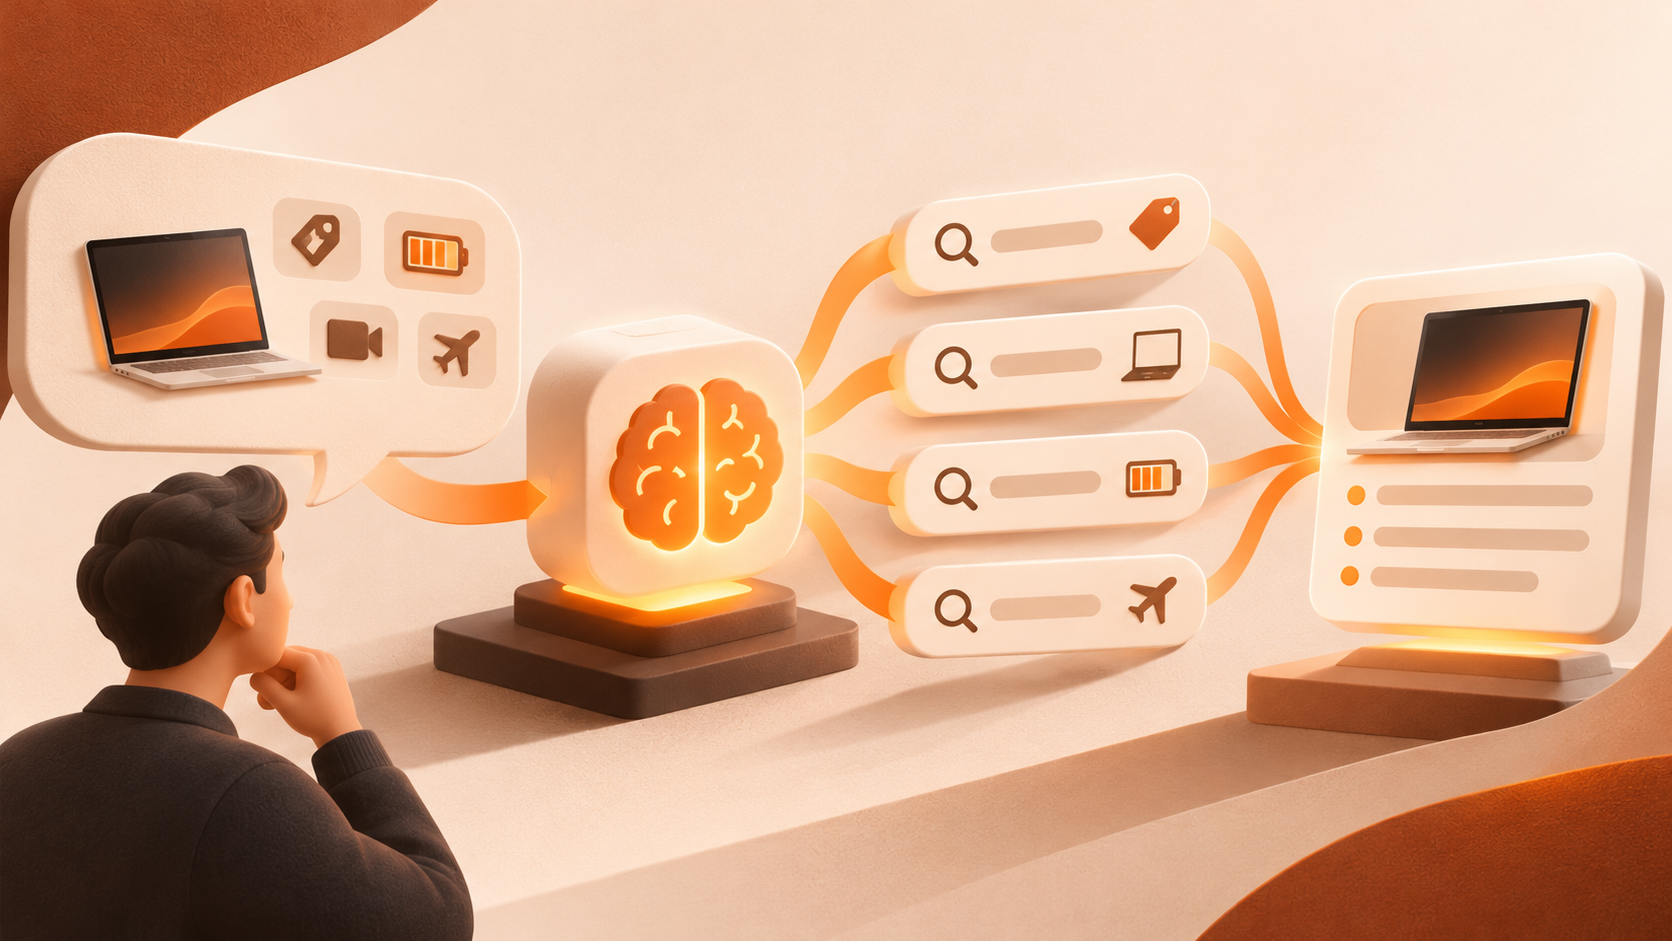
Query Fan-Outとは、AI検索エンジンが一つの質問をモデル自身が生成した複数のサブクエリに分解し、並列検索し、返された段落をスコアリングし、引用付きの回答に合成することを指す。GoogleはAI機能のドキュメントで、AI ModeやAI Overviewsのような体験がこの技術を使用し、通常の結果ページより「より広く、より多様な有用なリンクのセット」を提示する可能性があると説明している(Google Search Central)。
工学的には通常五つのステップに分かれる。意図と複雑さの識別、サブクエリの生成、高度に重複するサブクエリのフィルタリング、並列検索、回答の合成と引用付与。第三ステップが最も見落とされやすい。システムは重複よりもカバレッジを好み、内容が類似した二つのページは通常同時に検索されない。
規模については、公開観測ではおおよそ次の通りだ。AI Modeの単一質問は約8〜12の並列サブクエリを生成する(実測では3〜8が多い)。ChatGPTは平均して1回のウェブ検索で4.7のサブクエリを生成する。「数百回の検索」はDeep Searchのようなマルチラウンドパイプラインにのみ適用され、上限は約20ラウンドである。より重要なのはサブクエリの形態だ。逆分析によれば、その平均長は70〜80語に達し、複雑さは従来の三〜四語キーワードの約17〜26倍である(MaximusLabs)。エンジンはあなたのキーワードで検索するのではなく、文脈と使用シナリオを含む完全な記述で検索するのだ。
ファンアウトは無条件に発生するわけでもない。関連特許では、サブクエリを生成するかどうかが入力長、クエリ頻度、結果品質、トークン数、サーバー負荷と結びつけられている。短いナビゲーション型や単純な事実型の質問は、元の質問に近い検索を一度だけ実行することが多い。長い比較型や評価型の質問のみが最大の分岐木を展開する。したがって予算は複雑な商業的質問に優先的に配分すべきだ。
検索意図は「一つの語」から「一つの質問チェーン」へ
ナビゲーション、情報、商業調査、取引の四つの意図分類は依然として成立するが、AI検索では一つの主意図が複数層の副意図に延伸する。「How do I choose the best SEO tool for my business?」を例に取ると、主意図はツール選定だが、副意図には以下が含まれる。自分にはどの種類のツールが必要か?予算はいくらか?どの機能が重要か?技術的SEO能力は必要か?初心者と代理店にはそれぞれ何が適するか?
ここで混同されがちな二つの概念を区別すべきだ。キーワードクラスタリングは類似語を意図、意味、SERPの重複度でグループ化し、コンテンツの組織化を解決する。Query Fan-Outは一つの質問が複数の検索パスに分裂する仕組みを記述し、ユーザーが明示しなかったトピックも含めて検索がどう発生するかを解決する(SEO for Today)。前者は編集手法、後者は工学的メカニズムであり、互いに代替できない。
表:八種類のサブクエリとそれに必要なコンテンツ形態
ファンアウト分岐を分類すると、一つの質問は通常八種類のサブクエリを生成し、それぞれ必要な段落形態が異なる。この表はそのままコンテンツのセルフチェックリストとして使える。
| サブクエリの種類 | 例 | 必要なコンテンツ形態 |
|---|---|---|
| 完全一致 | best CRM software | 選択肢を直接示す回答ブロック |
| 意味的変異 | top CRM platforms | 買い手の別の言い方で同じ回答を言い換える |
| ナビゲーション型 | 某社の価格ページ | クロール可能で構造が明確な製品または価格ページ |
| 比較型 | A vs B for small business | 明確な属性を持つ表の行 |
| 定義型 | what is pipeline attribution | 独立して成立する三五十字の短い定義 |
| プロセス型 | how to migrate CRM data | 番号付き手順、一ステップ一アクション |
| ランキング型 | CRM tools for agencies | 絞り込み条件付きのスキャン可能なリスト |
| シナリオ型 | CRM for a 3-person team | チーム規模と使用シナリオを明示する限定文 |
純粋な散文ページは通常、そのうち二〜三種類しかカバーしない。表がなければ比較分岐は抽出する内容がなく、番号付き手順がなければプロセス分岐は空振りし、チーム規模を書いたことがなければシナリオ分岐はマッチしない。ここでの形式はレイアウトの好みではなく、検索性そのものである。
一つのキーワードから完全な質問チェーンへ拡張する:五ステップ実践法
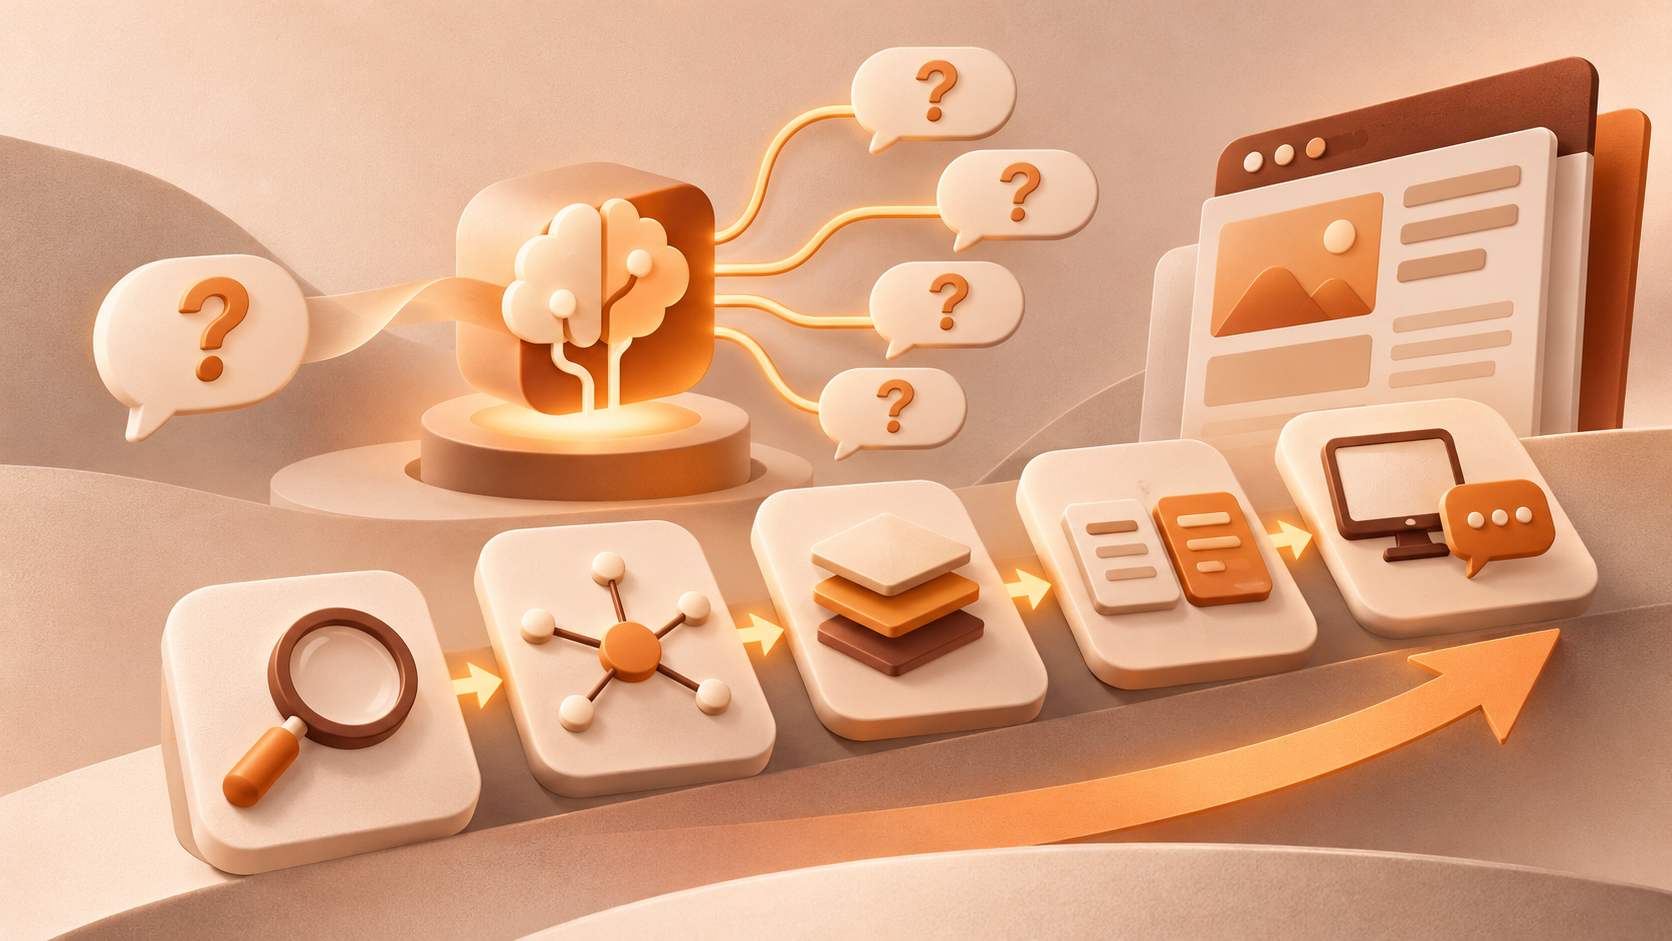
第一ステップ、キーワードではなくシードプロンプトを列挙する。理想的な顧客がデモ予約前に実際に入力する質問を10〜20条集める。口語的であればあるほどよい。
第二ステップ、各シードをPerplexityで一度実行する。そのインターフェースは実際に実行された検索を表示し、現在ファンアウト行動を観察できる数少ない場所である。
第三ステップ、それが導き出した5〜8の関連質問を一つずつ記録する。原文のままにし、キーワードに書き換えない。
第四ステップ、AlsoAskedのようなQ&Aツールで同じシード群をクロスチェックし、漏れた分岐を補う。
第五ステップ、生き残ったサブ質問を既存ページのH2とH3にマッピングする。原則は「一問題クラスター一ページ」であり、「一サブクエリ一ページ」ではない。各サブクエリに薄いページを個別に作ると権威性が希釈され、Googleの大規模コンテンツ乱用ポリシーの境界に触れる(MaximusLabs)。
明確にすべきは、実際の分岐木は会話的で個別化されており、外部から完全に再現することは不可能だ。質問チェーンは再構築された近似値であり、カバレッジ計画には適するが、正確なデータとして外部報告に使うべきではない。
数分で紹介サイトを作り、リード獲得を伸ばす
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
コンテンツクラスター:質問チェーンを三層構造に変える
実装時には三層に分けられる。柱ページは「この意思決定をどう進めるかの完全なフレームワーク」に答える。子ページは独立した検索需要を持つサブ質問、例えば某類方案の比較や某業界の価格構造を引き受ける。FAQブロックは枝葉の質問、例えば互換性、返金、最低要件を引き受ける。
サブ質問を個別ページにすべきかは三つのチェックで判断する。実際の会話で単独に質問されるか?その回答タスクは柱ページでは担えず、かつ脱線しないか?同級ページと重複しない点を一文で説明できるか?三問すべてを通過した場合のみ新ページを作る。
同時にボトムファネルの優先度差を意識すべきだ。購買型質問のファンアウトは通常、価格、プラン、無料枠、返金ポリシー、競合比較に集中するため、比較ページと価格ページは定義ページより購買経路に入りやすい。定義型質問はエンジン自身が回答してしまうことが多く、それを勝ち取っても言及を一度得る程度である。
FAQと製品ページはどう分担すべきか
両者は異なる検索タスクを担い、混ぜると両方とも悪化する。製品ページの目標は「自分に適するか」を明確にすることだ。誰に適するか、何の能力を含むか、境界はどこか、価格構造はどうか、どう始めるか。チーム規模、使用シナリオ、連携項目、制限条件を明示的に書くべきである。これらこそシナリオ型サブクエリがマッチングに使う限定情報だからだ。
FAQの目標は意思決定の摩擦を除去し、幹線には乗らないがユーザーが必ず尋ねる枝葉の質問に答えることだ。各回答は文脈から独立して成立する必要がある。代名詞を実体名に置き換え、先に結論を述べ次に条件を補い、長さを数十語に抑える。
ページ内部の構造順序も検索判断である。引用モードの観測では、引用シェアの約44%が本文の最初の30%に集中し、その後徐々に減少する(MaximusLabs)。したがって最も商業的な回答はページの最初の三分の一に置くべきであり、最後に残すべきではない。
検索エンジンと対話型検索を同時にカバーできるか
多くの場合可能であり、重複は想像以上に大きい。主要な入口の好みは矛盾しない。AI Modeはサブトピックのカバレッジと段落の明確さを重視し、ChatGPTは自己完結型のQ&Aブロックと専門性シグナルを重視し、Perplexityは鮮度とソースの透明性を重視し、Claudeのリサーチモードは深さと方法論を重視する。それらの共通点は、回答の前置き、ソースの可視性、平易な言葉、本文の真の深さである。
一つの方向性の変化に注意すべきだ。公開観測では、AI Overviewの引用が上位10位の自然検索結果に依存する割合は約76%から約38%に低下し、かなりの割合が100位圏外からの引用である(MaximusLabs)。その意味は「ランキングが無用」ではなく、「ランキングが引用の唯一の門槛ではなくなった」ということだ。段落が抽出可能か、直接質問に答えられるか、の重みが明らかに上がっている。
基礎的な作業は依然として必要だ。技術的なクロール可能性、コンテンツ構造、内部リンク、構造化データは、AI検索体験に入るための前提である(Google Search Central)。
企業が今すべきこと:六項目チェックリスト
| 優先度 | アクション | 完了基準 |
|---|---|---|
| 1 | 10〜20条の実際の顧客質問でキーワードリストを置き換える | 各条が完全な口語の問いである |
| 2 | Perplexityで一度実行し、後続の質問を記録する | 各シードにつき少なくとも5つの分岐を記録 |
| 3 | 中核商業ページで八種類のサブクエリカバレッジをセルフチェックする | 八種類のうち少なくとも六種類をカバー |
| 4 | 各H2の下に独立した回答ブロックを追加する | 代名詞を実体名に置き換え、先に結論次に条件 |
| 5 | 最も商業的なブロックを最初の三分の一に前倒しする | ファーストビュー後の一画面内に出現 |
| 6 | 各問題クラスターに唯一の帰属ページを指定する | 同じ質問に答える二つのページが存在しない |
同時に検索ボリューム判断の一部は保持する。それは依然として需要規模の推定、優先度の設定、季節性の判断に使える低コストのシグナルである。本当に放棄すべきは「検索ボリュームが高ければ書く、低ければ書かない」という単線ルールだ。
we0がこのチェーンをどう引き受けるか
問題チェーンをコンテンツ資産に変えるには、最終的にウェブサイトに落とし込む必要がある。面構造、FAQブロック、比較表、構造化データ、多言語版、その後の更新リズムだ。we0.aiが提供する道筋は、ウェブサイト構築とコンテンツ成長を同じワークスペースに置くことである。自然言語で要件を記述し、複数のAgentが協力して実行可能なページを生成し、ビジュアルキャンバスで調整して自社ドメインにデプロイし、CMSバックエンドでコンテンツを継続的に維持し、サイト側でSEOとGEO関連の設定を処理する(we0.ai)。
問題クラスターを迅速に検証する必要があるチームにとって、この統合の価値は「どれだけ速く生成できるか」ではなく、一つの要件からページ公開、そして問題チェーンに沿ったカバレッジチェックまで、途中で三つ四つのツール間でコンテンツやコピーを運び回す必要がないことにある。
FAQ
Q:キーワード検索ボリュームはまだ見る必要があるか?
必要だが、需要規模と優先度の判断に使うものであり、テーマ選定の唯一の根拠ではない。検索ボリュームはサブクエリ分岐、回答形態、意図階層を反映できない。これら三項目は問題チェーン研究で補完する必要がある。
Q:Query Fan-Outとキーワードクラスタリングは同じものか?
違う。キーワードクラスタリングは意図と意味で類似語をグループ化し、コンテンツの組織化に使う。クエリファンアウトはエンジンが一つの質問を複数のサブクエリに分解して並列検索するメカニズムであり、検索行動を説明するために使う。
Q:自分のページが引用可能かどうかをどう判断するか?
抽出可能性から始める。各小節に独立して成立する回答ブロックがあるか、実体と適用シナリオを明示しているか、表や手順があるか、ソースが見えるか。これらは手動で確認でき、第三者のスコアに依存する必要はない。
Q:小規模チームで完全な研究をする予算がない場合は?
まず最小閉ループを行う。10条の実際の顧客質問を選び、対話型検索を一度実行して分岐を記録し、中核商業ページに表、手順、回答ブロックを補完し、四半期ごとに再実行して日付を記し、結果の変化がコンテンツ調整によるものかエンジン更新によるものかを区別する。
Related Tools
- Google Search CentralのAI機能ドキュメント:公式見解と基礎要件を確認。
- Perplexity:インターフェースで検索プロセスが見え、ファンアウト行動の観察に適する。
- AlsoAsked:キーワードごとに問題クラスターを取得し、漏れた分岐を補完。
- we0.ai:ウェブサイト構築からコンテンツ運用、SEO/GEO設定までの一体型ワークスペース。
Related Links
- Google Search Central — AI features and your website
- MaximusLabs — What is Query Fan-Out?
- SEO for Today — Query Fan-Out: How AI Search Is Changing Keyword Research
- we0.ai — AI 智能建站与获客工作台
Summary
検索ボリュームは無効になったわけではない。それは「テーマ選定の根拠」から「需要規模の参考値」へと後退しただけだ。キーワードリサーチの追加作業は、一つの語を完全な質問チェーンへと拡張し、各質問に抽出可能な回答形式を用意し、単語ではなく問題クラスター単位でページを割り当てることである。これにより従来の検索結果にも、自らクエリを書き換える対話型検索にも対応できる。判断基準も変わる。この語にどれだけ検索ボリュームがあるかではなく、ユーザーが四番目、五番目の質問まで連続して追问したとき、あなたのサイトがまだ引用されるその一つの回答になれるかどうかである。