「完全自動納品」を厳格に定義するなら——企業がひとこと伝えるだけで、その後は一切関与せず、サイトが自社ドメインで正常に閲覧でき、内容が検索エンジンとAI検索に理解され、フォームのリードが自動でCRMに入るまで——2027年にエンドツーエンドの無人運転に到達する可能性は低い。
実際に起きるのは、納品が高度に自動化されたパイプラインに分解されることだ。ほとんどの工程は異なる役割のAI Agentが連続して引き受け、少数の重要ノードでは人による確認を残す。理由は単純である。AIサイト構築の能力境界は「1枚のWebページを生成する」ことから「動作するシステム一式を納品する」ことへ移り、現在のボトルネックは「書けるかどうか」ではなく「範囲、事実、リスクに誰が責任を持つか」にある。
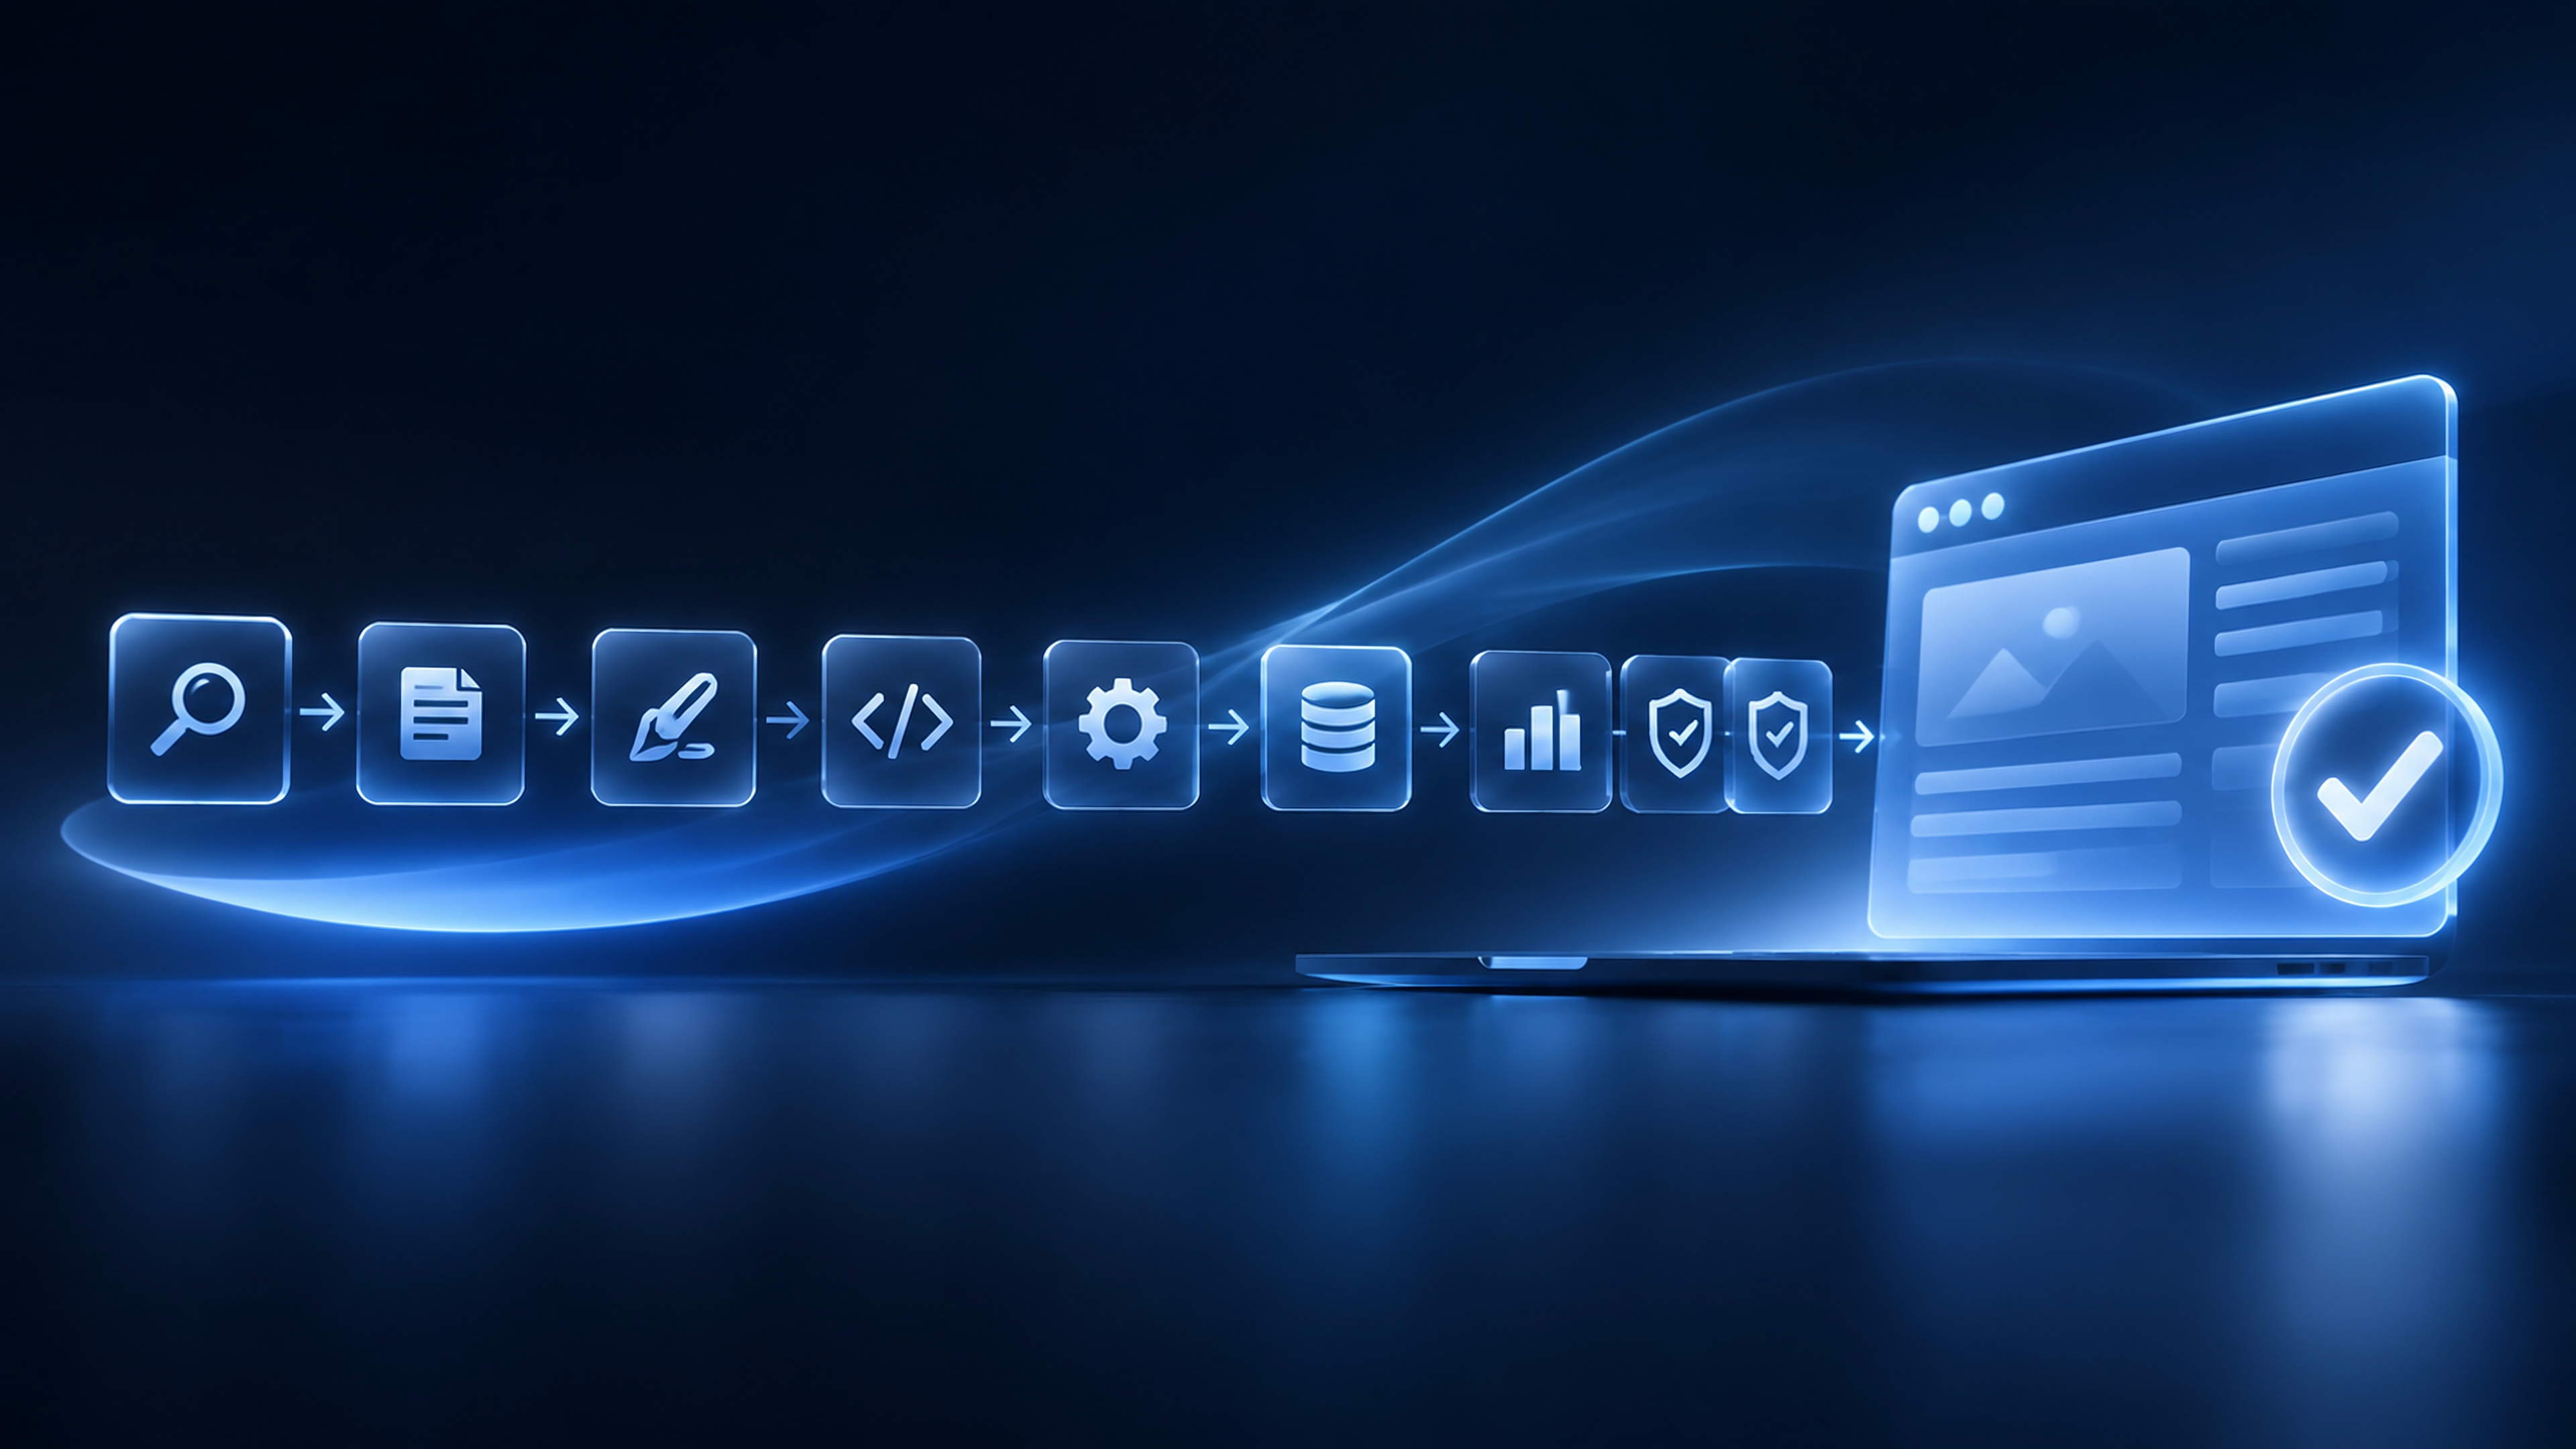
ひとつの要望から正式公開まで、その間に9つの工程がある
「AIサイト構築」で最も誤解されやすいのは、ページ生成をサイト構築のすべてだと捉えることだ。集客を担える公式サイトは、少なくとも以下の9つの工程を通る。工程を並べてみて初めて、どこをAgentが引き受けられ、どこを人が決めなければならないかが見えてくる。
| # | 工程 | 2027年の自動化見込み | 主なボトルネック |
|---|---|---|---|
| 1 | 要件分析・範囲定義 | 高:意図認識 + 構造化された要件リスト | 事業目標、予算の境界、優先順位の取捨 |
| 2 | 情報アーキテクチャとPRD | 高:構造テンプレート化の度合いが高い | スコープの膨張、バージョン固定 |
| 3 | ページ計画とコピー | 中高 | ブランドの表現基準、資格・コンプライアンス表現 |
| 4 | UIビジュアルデザイン | 中高 | ブランド一貫性とオリジナリティの判断 |
| 5 | フロントエンド開発 | 高 | コンポーネント規範、マルチデバイス対応の細部 |
| 6 | バックエンド、API、データモデル | 中 | 権限体系、データモデル、サードパーティAPIの意味論 |
| 7 | コンテンツ体系とSEO/GEO | 中 | 事実の正確性、キーワード戦略、構造化データ |
| 8 | テストと受け入れ | 中高 | 決済・資金ロジック、セキュリティ境界、データ整合性 |
| 9 | デプロイ、ドメイン、監視 | 高 | ドメインの実名認証/届出、DNS権限、ロールバックと観察期間 |
この表は、体験の差がしばしば第6、7、8工程に現れる理由も説明している。最初の5工程はすべてのツールがカバーする表層的な工程であり、後の4工程が、サイト公開後に実際にリードをもたらせるかどうかを決める。
2つの技術変数:コード能力とAgentのエンジニアリング化
第一の変数はモデルのコード能力である。OpenAIはGPT-6.2の紹介で、AstraとSolを「専門業務の新しい標準」と位置づけ、そのうちSolは日常業務のシナリオに向けたものとしている(OpenAI 発表説明)。コード能力がサイト構築にもたらす真の価値は、一度により多くのコードを生成することではなく、長いコンテキスト内でのファイル横断的な修正、リファクタリング、エラー特定がより制御可能になることにある——まさにこれが、パイプラインを連続して走らせ続ける前提である。
第二の変数はAgentのエンジニアリング化の収束である。AI Agentの進化の流れを体系的に整理した資料によれば、2022年のReAct論文が「観察—思考—行動」のループを確立し、2023年6月のFunction Callingがツール呼び出しを構造化標準に変え、2024年11月のMCPオープンソース化がツール接続をプロトコルとして統一し、その後A2AがAgent間の委任と協調の解決に着手した(AI Agent 完全ガイド)。ツール呼び出しが標準化された後、Agentが操作できる外部システムは急速に広がり、マルチAgentも実験的フレームワークからデフォルトのエンジニアリング構造へと変わった。
2つの変数を合わせて見ると、2027年のトレンドは「1つの超大型モデルがワンクリックでサイトを生成する」ことではなく、「複数の専門Agentが制御されたチェーン上で分業し、モデル能力が各ステップの品質上限を決める」ことである。
予測1:AIは曖昧なサイト構築要件を自動分析できるか
半分は実現できる。しかも、より成果を出しやすい半分である。
できることは3つある。口語的な説明を目標、対象読者、ページリスト、機能項目にマッピングすること。不足情報を仮説リストとして整理し、確認のために提示すること。不足点を指摘すること。たとえば製品画像がない、価格説明がない、資格・認証資料がない、といった点である。We0はこのステップを意図理解、範囲定義、方向性のすり合わせに分解し——散在する入力を構造化されたサイト要件に整理し、どのページ、フロー、素材が必要かを明確にする(we0.ai)。
より取引に近い側では、すでに完全な実装例がある。越境サイト構築サービス事業者がサイト構築フローを対話型実行のAgentにし、事業者が商品情報と対象市場を入力すると、システムがトップページ、商品詳細ページ、コレクションページ、ポリシーページを含むサイト構造を自動生成し、数分以内にサイト生成から公開準備までの重要ステップを完了する(関連報道)。これは「ひとつの要望 → サイト構造」という区間がすでに連続して走り切れることを示している。
できないのは、商業的な取捨を代わりに決めることだ。このバージョンの公式サイトは投資家に見せるのか、それともまず問い合わせを受けるのか。先に中国語サイトを作るのか、それとも最初から多言語対応にするのか。こうした問いに標準解はなく、モデルは選択肢を示せるだけで、選択の結果に責任を負うことはできない。
予測2:PRDとページ計画はどこまで自動生成されるか
PRDは工程の中で最も構造化度が高い文書であるため、自動化の難易度は最も低い。ページリスト、モジュール説明、フィールド定義、遷移関係、受け入れ要点は、PM役のAgentが初稿を生成できる。
本当のリスクは「書けない」ことではなく「書きすぎる」ことだ。AIがPRDを生成する際のデフォルトの傾向は、範囲を広げることにある——ブログを追加し、事例ライブラリを追加し、会員体系を追加し、多言語を追加する。範囲が一度膨張すると、後続の設計、開発、デプロイもすべて膨張し、納品期間とコストがかえって制御不能になる。
実行可能な制約はこうだ。v1の範囲を「ページリスト + 各ページの受け入れ基準」として凍結し、プロジェクト付属文書として固定する。新規要件はv2のバックログに入れ、今回の納品には含めない。このステップに人が使う時間は十数分だが、節約できるのは数週間の手戻りかもしれない。
予測3:デザインAgentと開発Agentは本当に協調できるか
協調はできる。ただし協調のインターフェースはチャット履歴ではなく、バージョン管理可能な中間成果物である。少なくとも3つが必要だ。デザイントークンとコンポーネント規範、ページとAPIのデータ契約、実行可能な受け入れテストケース。この3つが安定して初めて、デザインと開発の2つのAgentが互いに手戻りせず、それぞれ独立して進められる。
現在すでに、役割分担を同じチェーン上に置く製品がある。We0の「アイデアを記述 → AIがリアルタイム構築 → 調整して公開」は、要件整理、マルチAgent生成、ビジュアルキャンバスでの微調整、ドメインデプロイを1つのフローにつなぎ、ページとリアルタイムプレビューがフローの進行に合わせて切り替わる(we0.ai)。これは現在の実装形態を観察できる参照例である。マルチロールのチェーンはすでに概念から製品へと進んでおり、現段階の自動化が依然として「分業 + 引き継ぎ」であり、「引き継ぎなしの自律」ではないことも示している。
この種の協調が信頼できるかどうかは、2点を見れば十分だ。中間成果物をエクスポートできるか、問題が起きたときに前のチェックポイントまで戻ってやり直せるか。
予測4:AIはコード問題を自動で発見・修正できるか
階層別に見るほうが正確である。
高度に自動化できる部分:コンパイルと型チェック、静的検査、単体テスト、リンクとデッドリンクのスキャン、基本的なアクセシビリティ検査、パフォーマンス予算と依存関係の脆弱性スキャン。これらはすべて確定的なルールであり、Agentは自分で実行し、自分で修正し、自分で再テストできる。
完全に手放すのが難しい部分:決済と資金に関わるロジック、権限とデータ境界、データ移行の整合性、サードパーティAPIの意味論変更後の挙動差異。こうした問題は自動修正が誤ると、代償が利益をはるかに上回る。合理的なエンジニアリング手法は、サンドボックス実行 + チェックポイント + 人による承認ゲートであり、Agentに本番環境を直接変更させることではない。
業界の構造もこの方向に収束しつつある。2026年4月、AnthropicとOpenAIは1週間のうちに、構造が高度に類似したマルチAgent基盤を発表した。そこにはサンドボックス、チェックポイント、権限分離が含まれている(AI Agent 完全ガイド)。
予測5:デプロイとドメイン設定はどこまで自動化できるか
デプロイは9つの工程の中で自動化度が最も高い区間であり、最も過小評価されやすい区間でもある。ビルド成果物、プレビュー環境、HTTPS証明書、CDN配信、基本監視は、現在では1本のリリースチェーンで完了できる。We0も、自社ドメインへのワンクリックデプロイを標準の出口としている(we0.ai)。ただし、必ず人が通さなければならない関門がいくつかある:
数分で紹介サイトを作り、リード獲得を伸ばす
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
- ドメインの実名認証と届出:主体情報、資料審査、期間はツールでは決められない。
- DNSの制御権:DNSをどの事業者でホストするか、企業メールに必要なレコードを使うかどうかは、企業のIT担当が確認する必要がある。
- サードパーティ認可:SSO、CRM、分析・広告プラットフォームのアカウント認可は代理入力できない。
- ロールバックと観察期間:公開後24〜72時間のエラー率、フォーム成功率、インデックス状態を誰が見張り、誰がロールバックを判断するかは、ボタン1つではなくフローである。
この4項目を事前にチェックリスト化してこそ、自動デプロイの利益が公開当日の事務プロセスによって相殺されない。
人間の開発者の役割:コードを書くことから標準を定めることへ
上記の予測が大部分当たるなら、人間の仕事は両端に集中する。フロント側では標準を定め、バックエンド側では判断を行う。
- 標準を定める:受け入れ基準、パフォーマンスとセキュリティのベースライン、コンテンツの事実とコンプライアンス表現、ブランドトーンの境界。
- 判断する:範囲の取捨、リスクの受容、公開とロールバックの判断、異常時の責任所在。
- 最終対応:システム横断の複雑な統合、レガシーデータ移行、非定型の業務ルール。
言い換えれば、2027年は「1人の人間がAgentチームを率いてプロジェクトを進める」ことに近く、「誰もプロジェクトを進めない」ことではない。エンジニアリング能力は消えず、問いを立てる能力、レビューする能力、分解する能力へと変わる。
企業の選定:必ず検証すべき7つの納品能力
サイト構築市場の古くからの問題は依然として存在する。テンプレートの改造をカスタム納品として扱うこと、プロジェクトが多層下請けされること、資産の権利帰属が不明確なこと、公開後の運用保守が欠けること(業界総括)。AIサイト構築ツールに置き換わっても、リスクの形は変わったが、検証すべき問題の論理は変わっていない。
| 能力 | 該問的質問 | なぜ重要か |
|---|---|---|
| 要件明確化の仕組み | 自ら追加質問し、構造化された要件リストを出力するか? | 曖昧な要件が途中で反復手戻りになるかどうかを決める |
| 中間成果物の可視性 | PRD、ページ計画、デザイン稿をエクスポートできるか? | プロジェクトが引き継ぎ可能で監査可能かを決める |
| コードと資産の帰属 | コードをエクスポートでき、自ら移行・ホスティングできるか? | 長期的に単一プラットフォームにロックインされるかを決める |
| 編集可能性 | 生成後にビジュアルキャンバス上でレイアウトとコンテンツを変更できるか? | 日常運用に開発者の介入が必要かを決める |
| テストとロールバック | プレビュー環境、チェックポイント、ロールバック機構はあるか? | 問題発生時に迅速に損切りできるかを決める |
| コンテンツとSEO/GEO | 構造化コンテンツ管理、多言語、構造化データをサポートするか? | サイトが検索とAI検索に理解・引用されるかを決める |
| 公開後の運用 | CMS、監視、改善のプロセスは整っているか? | 公式サイトは長期資産であり、一度きりの納品物ではない |
もし3つだけ質問できるなら、こう聞くといい。エクスポートできるか、ロールバックできるか、公開後に誰がコンテンツを変更するのか。
企業が今すべきこと:5ステップの実行
- 目標をひとことで書き、1つだけに絞る。この版の公式サイトは問い合わせを受けたいのか、資金調達を支えたいのか、それとも広告流入を受け止めたいのか。
- AIに要件リストとページ計画の初稿を生成させ、その後に一度引き算を行い、v1のページ数を1週間以内に受け入れ可能な量まで圧縮する。
- 受け入れ基準を凍結する。各ページにどの情報が必要か、フォーム送信後にリードがどこへ行くか、モバイルで必ず通すべきチェックは何か。
- まず公開チェーンのリハーサルを行う。ドメイン、届出、DNS、HTTPS、フォームのデータ戻しをすべて通してから、ビジュアルの細部を議論する。
- 公開後は週単位で3組のデータを見る。フォーム成功率、主要ページの直帰、検索およびAI検索で引用されているページ。データが基準に届かない場合は、まずコンテンツ構造を変え、その後にビジュアルを変える。
現実の境界:2027年でも依然として自動化が難しい部分
- 事業上の位置づけと取捨:モデルは選択肢を列挙できるが、選択を引き受けることはできない。
- コンテンツの事実と資格:価格、顧客事例、認証情報は企業が提供し、責任を負わなければならない。
- セキュリティと資金ロジック:決済、権限、プライバシーに関わる部分は人による審査が必要である。
- システム横断統合:ERP、CRM、履歴データの移行と意味論のすり合わせ。
- 責任の所在:問題発生時に誰がロールバックを決め、誰が外部に説明するのか。
別種のリスクも業界で繰り返し指摘されている。「完全自動サイト構築」を盲目的に追い求めた結果、内容が空虚でブランド表現に欠けることが多い。大規模モデルのAPIをつなぐことをスマートなサイトと見なすこと、Agentの継続監視と校正コストを過小評価することも、よくある誤判断である(AIサイト構築の実践観察)。これらを明示したほうが、かえってAIサイト構築をうまく使える。自動化できる工程はAgentに任せ、自動化できない判断は自分たちに残すのだ。
FAQ
2027年、本当にひとことでサイトを公開できるのか?
簡易な展示型サイトは制御された環境ではすでにこの体験に近づいている。要件を説明し、リアルタイムプレビューし、自社ドメインへワンクリックでデプロイする。しかし決済、会員、バックエンド、複数システム連携を伴う正式サイトでは、範囲、コンテンツの事実、セキュリティ境界を人が確認する必要がある。
AIサイト構築はフロントエンドやデザイン職を置き換えるのか?
置き換えるというより分業を変える可能性が高い。反復的なページ構築、スタイル調整、定常テストは大幅に自動化され、要件判断、受け入れ基準、複雑な統合、公開判断の価値はむしろ上がる。
マルチAgent協調と単一AIアシスタントの本質的な違いは何か?
単一アシスタントは1つのコンテキストで全役割を同時に担うため、タスクが複雑になると過負荷になりやすい。マルチAgentは要件、PRD、デザイン、開発、デプロイを異なる役割に分け、それぞれに明確な入出力を持たせ、フローでつなぐ。中間成果物は個別に検査し、ロールバックできる。
AIが生成したサイトはChatGPTやGeminiのようなAI検索に引用されるのか?
引用されるかどうかは、ページ構造が明確か、コンテンツに検証可能な事実があるか、構造化データと安定した情報階層があるかで決まり、「AI生成かどうか」との関係は小さい。製品、価格、事例、資格を引用可能な情報ブロックとして書くことが、より現実的な最適化方向である。
AIサイト構築ツールを選ぶときに最も陥りやすい落とし穴は何か?
エクスポートとロールバック能力を無視すること。公開後に移行できず、改版に退路がないことは、見た目の粗さよりはるかに深刻な長期コストである。
関連ツール
- We0:展示型サイト向けのAIサイト構築・集客プラットフォーム。自然言語生成、マルチAgent協調、CMSバックエンド、多言語サイト、ドメインデプロイ、SEO/GEO最適化をカバーする。
- Google Search Console:ページのインデックス、クロールエラー、クエリ実績を確認する。
- 構造化データ検証ツール:Organization、Product、FAQなどのマークアップが規範に適合しているか検証する。
- サイトパフォーマンス・アクセシビリティ検査ツール:パフォーマンス予算とアクセシビリティ検査を公開前の必須項目として固定する。
関連リンク
- OpenAI:GPT-6.2 AstraとSolの発表
- AI Agent 完全ガイド:歴史的進化、各社の路線、今後の方向性
- AIネイティブサイト構築の総括と中堅・大企業向け選定ガイド
- AI Agentがサイト構築を再定義している:スマートサイト時代の実践と誤解
- AIサイト構築Agentの公開:独立系サイトが「会話即実行」段階へ
- We0:サイト構築から集客までのAIワークスペース
まとめ
2027年のAIサイト構築は「パイプライン納品」にかなり近づく。要件の構造化、PRD初稿、ページ計画、ビジュアルとコードの実装、定常テスト、デプロイと公開——これらの工程は異なる役割のAgentが連続して引き受けられ、納品期間は週単位から日単位、さらに短くなる。ただしエンドツーエンドの無人運転はまだ現実的ではない。範囲の取捨、コンテンツの事実、セキュリティと資金ロジック、システム横断統合、公開判断には責任を持つ人が必要だ。
企業にとって判断基準は「完全自動かどうか」ではなく、「どの工程が自動化されたか、中間成果物をエクスポートできるか、問題時にロールバックできるか、公開後に誰が継続してコンテンツを変更するか」である。この4点を明確に問うことが、「ワンクリック公開」の宣伝を追うよりも現実のリターンに近い。