For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/anthropic-s-2021-roadmap-coding-agents-to-438c8006.md.
2021年7月の短いAnthropic研究ロードマップは、人と会話しながらソフトウェアを作成、編集、説明できるアシスタントを描いています。今日読むと、リポジトリの探索、ツールの利用、フィードバックからの学習、実環境での安全な行動といった、現在もコーディングエージェントを形作る問い...
2021年7月の短いAnthropic研究ロードマップは、人と会話しながらソフトウェアを作成、編集、説明できるアシスタントを描いています。今日読むと、リポジトリの探索、ツールの利用、フィードバックからの学習、実環境での安全な行動といった、現在もコーディングエージェントを形作る問いが見えてきます。
公開リンクされているスキャンが興味深いのは、完成版のClaude Codeが5年前に存在していたことを証明するからではなく、こうしたつながりを示しているからです。そこには研究目標と意見の相違が記録されています。これは、リリース済み製品、完了した実験、あるいは今日のモデルアーキテクチャに関する声明とは異なる種類の証拠です。
この文書の長期目標は、安全で有益なAGIです。提案された概念実証は、自然言語を通じてユーザーとソフトウェアに取り組める汎用アシスタントです。
説明されているタスクは、コードの次の数文字を補完することを超えています。質問への回答、関数の作成、バグの特定、APIの設計、スタイルやベストプラクティスに関するユーザーとの議論が含まれます。野心的な最終状態は、ソフトウェアエンジニアリングの同僚に相当する幅広さです。
この表現は、チームがその目標に直ちに到達できるとは想定していなかったことも認めています。これは研究の方向性を示したものであり、この文書を、今日の機能がすべてすでに確定していた2021年のClaude Codeリリース計画として、後から説明すべきではない理由です。
現在のClaude Codeドキュメントにより、この大まかな願望と実製品を比較できます。テーマ上の連続性は明確ですが、この文書だけでは、各機能について途切れのない実装履歴を立証することはできません。
コメントには、すぐに役立つものを構築することと、より汎用的な能力を実証することの間にある実務的な緊張関係が表れています。
Tom Brownは、リポジトリ閲覧を価値ある出発点として提案しています。Nelson Elhageは、プロジェクト内の型定義を見つけるという具体例を挙げています。これらは、特に不慣れなコードベースに入るときの、開発者にとって一般的なニーズです。
Andy Jonesは、このアプローチを、printfデバッグとエディタ利用を強調するデモと対比しています。リポジトリ検索はプログラマー向けアシスタントの強力な最初の機能になり得る一方、ほかのアクションは、モデルがツールを利用できることをより説得力をもって示す可能性があります。
Dario Amodeiの回答は、短期的にはツール利用のデモを、長期的には非常に高性能なプログラマーを優先しています。このやり取りが有用なのは、順序付けが明示的な選択として示されているためです。初期の研究マイルストーンは、まだ最も有用な完全製品でなくても価値を持ち得ます。
事前学習のセクションでは、強力な言語・コードモデル、コード中心のデータセット、能力を後続のファインチューニングに結び付ける評価が求められています。また、1兆以上を含む、任意の規模まで大きなモデルを訓練する科学についても論じています。
これは表明された研究目標です。現在のClaudeモデルが1兆パラメータを持つという開示でも、2021年時点でチームがすでにそのようなモデルを訓練していた証拠でもありません。
同じセクションでは、非常に大きなコンテキスト、または大量の記憶や経験を取り込む同等の手段を検討しています。したがって、1つの特定の現在のコンテキストウィンドウ設計を定めるのではなく、複数の可能な仕組みを開いたままにしています。
| ロードマップ項目 | それが裏付けること | それが立証しないこと |
|---|---|---|
| 汎用ソフトウェアアシスタント | ソフトウェアの共同作業は初期の研究目標だった。 | 2021年に完成していたClaude Code。 |
| 1兆パラメータ以上のモデル | 非常に大きなスケールは研究アジェンダの一部だった。 | 現在のClaudeリリースのパラメータ数。 |
| 大規模コンテキストまたは同等のメモリ | チームは拡張された経験とメモリを検討していた。 | 固定された単一のアーキテクチャ、または現在の正確なトークン上限。 |
| 検索、デバッグ、編集によるツール利用 | このアジェンダにはソフトウェア環境で行動することが含まれていた。 | 信頼でき、制限のない自律運用。 |
人間のフィードバックとアラインメントのセクションには、モデルの判断が、行動やサンプル品質に関する人間の判断とどのように対応するかを研究する内容が含まれています。自己評価に明示的に言及し、この問いをバイアス、公平性、社会的帰結に結び付けています。
これは、モデル自身の評価を研究対象として用いることについての意味ある初期の定式化です。こうした判断が自動的に信頼できること、またはモデルが自身の出力を安全に認証できることを示すものではありません。
この文書は、GANまたは識別器の訓練とスケーリング則に関する議論の中で、テスト時コンピュートにも言及しています。これは、チームが事前学習を超えた計算について考えていたことを示します。ただし、後の推論モデルにおけるあらゆる手法と無条件に同一視したり、現代の推論時スケーリングシステムがすでに規定されていた証拠として扱ったりすべきではありません。
この区別により、歴史的な比較はより強固になります。この文書は、似た語彙が5年間にわたって同一の手法を意味するふりを読者に求めることなく、関連する研究課題を明らかにしています。
最も直接的に関連するコメントの1つは、サンドボックス化されていないツールを安全にデプロイする方法を問うものです。Amodeiは、特に懸念しているのはデプロイ時にコードを実行するツールであると明確にしています。
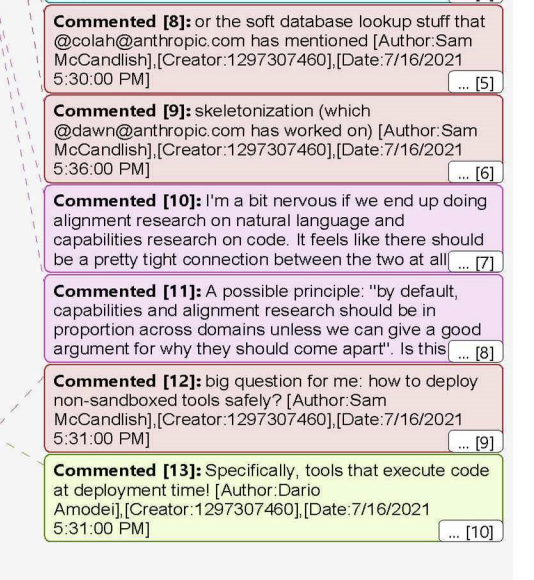
出典:2021年7月のロードマップスキャン。BAAI Hub上でQbitAIが抜粋したものです。該当するコメントは、拡張コメントページを含むリンク先PDFで確認できます。
この懸念は、エージェントの設定において現在も理解しやすいものです。コマンド実行やファイル編集が可能なシステムは環境を変更できるため、安全な挙動は最終回答の丁寧さやもっともらしさだけで判断できません。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
現在のClaude Codeサンドボックスのドキュメントは、サンドボックス化されたBashツールに対するファイルシステムおよびネットワークの制限と、それが提供する保護の限界を説明しています。これは現在の実装に関する参照情報であり、そのような仕組みのすべてがロードマップ時点ですでに定義されていた証拠ではありません。
この歴史的コメントは、問題を明確に特定しています。有用なツールへのアクセスは、設計、テスト、維持すべき境界も生み出します。
Amanda Askellは、コメントで別の懸念を提起しています。能力が主にコード領域で進歩する一方、アラインメント実験が自然言語に集中したままであれば、アラインメントのテストは、実際に開発されている能力にとって有用でなくなる可能性があります。
彼女は、両者を分ける十分な理由がない限り、能力研究とアラインメント研究を領域横断で均衡させることを提案しています。この点は運用上のものです。デプロイされるシステムが別種の環境でますます行動するようになる場合、研究しやすいインタラクションの評価には隔たりが残り得ます。
ロードマップの社会的影響に関するセクションにも同様に、モデルの評価、第三者によるシステム評価の支援、実験できる外部研究者の範囲の拡大が含まれています。これらは研究上の目標であり、その後のアクセスプログラムや評価が提案されたすべての原則を満たすという保証ではありません。
これらを合わせて見ると、安全性に関する議論は、一般的なミッションステートメントよりも具体的です。訓練フィードバック、評価の対象領域、実行可能なツール、外部評価を結び付けています。
この文書は、限定的ながら有用な歴史的結論を裏付けています。現代のコーディングエージェントに結び付けられる複数のテーマは、Anthropicの初期研究計画ですでに関連付けられていました。ソフトウェア支援、ツール利用、フィードバック、スケール、メモリ、安全性が同じアジェンダに現れています。
これは、ロードマップがその後のあらゆる成功を生んだこと、最終的な製品が必然だったこと、ほかの研究所に類似の発想がなかったことを証明するものではありません。そのような主張には、この文書を超えた追加の歴史的証拠と比較が必要です。
開発者にとって最も有用な問いは、今なお具体的です。モデルはタスクのどの部分を実行できるのか、どのツールを利用できるのか、どのようにミスを検出するのか、そして不正確なアクションがより広い環境に影響することを何が防ぐのか。ロードマップが価値を持つ理由の一部は、これらの問いが現在も認識可能であることにあります。
これは、Jared Kaplanの名が記され、最終更新が2021年7月とされる、Concise Research Roadmapという公開リンク済みのスキャンです。6ページのコピーには研究本文と拡張コメントが含まれますが、その裁判所提出資料としての来歴は本記事では独立に認証していません。
いいえ。これは汎用ソフトウェアアシスタントに関する研究の方向性を説明するものです。後の製品に似た目標があったことは、その製品がすでに構築またはリリースされていた証拠とは異なります。
いいえ。1兆以上のモデルへの言及は研究目標です。現在のClaudeモデルのアーキテクチャやパラメータ数を確定するものではありません。
ロードマップは、行動および出力品質に関する人間とモデルの判断の関係を研究することを提案しています。また、モデルの判断だけで十分だと仮定するのではなく、この話題をバイアス、公平性、社会的帰結に結び付けています。
この表現は、アラインメント、識別器、スケーリング研究の文脈で登場します。評価時の計算への関心を示していますが、後の推論モデルで使われるすべての手法を規定しているわけではありません。
コード実行ツールは実際の環境に変更を加えられるため、最終回答だけを評価してもリスクの一部を見落とします。サンドボックス、権限管理、対象領域に適したテストは、この問題の異なる側面に対処しますが、いずれも慎重な実装が必要です。
2021年7月のロードマップは、ソフトウェアの同僚という構想を、ツール、大規模モデル、メモリ、フィードバックに関する研究と結び付けています。そのコメントは、実行可能なツールに伴う安全性の問題と、能力開発に遅れるアラインメントテストの問題も特定しています。
これは、現代にも通じるテーマを含む初期の研究アジェンダを記録したものであり、2021年に完成した製品や現在のClaudeモデルの仕様ではありません。
ひとことから始めて、数分で完全なサイトを手に入れましょう。
