For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/anthropic-s-ai-replication-test-methods-a-4f6916a1.md.
Anthropicの研究によると、GLM-5.2は簡略化された複製タスクにおいて、5回の試行のうち4回で対象の全8ノードに到達し、残る1回では7ノードに到達しました。また、低価格なTVボックス群に分散したモデル推論と、後続エージェントが先行エージェントのメモを継承することでセット...
Anthropicの研究によると、GLM-5.2は簡略化された複製タスクにおいて、5回の試行のうち4回で対象の全8ノードに到達し、残る1回では7ノードに到達しました。また、低価格なTVボックス群に分散したモデル推論と、後続エージェントが先行エージェントのメモを継承することでセットアップの信頼性が向上することも示しています。
これらは重要な結果です。同時に、過大に解釈されやすい結果でもあります。一次報告書では、手作業で構成したハードウェアのデモ、自律的なセットアップ実験、そしてより大規模なコントローラーモデルが別のインフラストラクチャ上で稼働する、隔離されたネットワークテストが明確に区別されています。
以下の説明は、BAAI Hubに転載されたQbitAIの報道と、William ZhouおよびDaniel FreemanによるAnthropicの研究を直接確認した内容に基づいています。
研究者らは、メモリ4GBで1台あたり約55ドルの無名ブランドAndroid TVボックスを15台購入しました。各ボックスにモデルのレイヤーの一部を保持させるパイプライン並列化を用い、Gemma4-26B-A4Bをこれらのデバイスに分割しました。
このシステムは毎秒0.39トークンを生成しました。対話型アシスタントとしては非常に遅いものですが、この実験は別の問いを検証していました。すなわち、低価格かつ低メモリのデバイス群でも、集合的に能力あるモデルを稼働させられるのか、という問いです。
この構成における答えは「可能」でした。ただし、ハードウェアの準備とモデルの分散は研究者が行っています。このデモは、モデルが自律的にこれらのデバイスを発見して侵害したことを示すものではありません。
報告書は次に、規模の参照点として過去の200万台規模のボットネットを用いています。複製1件あたり15台のデバイスを使うとすれば、約13万3,000個のコピーが可能となり、著者らの同時実行に関する仮定では、合計スループットは毎秒約8万トークンと概算されます。これは仮説上の計算であり、新たに観測されたAI感染ではありません。
エンドツーエンド実験のために、AnthropicはAndroid 15のredroid環境を実行する8つのGoogle Cloudノードを含む、ファイアウォールで隔離された仮想プライベートクラウドを構築しました。このテストでは、連鎖の残りの部分に焦点を当てるため、認証されていないADBポート経由で容易にアクセスできるよう意図的に設定されました。
概念的には、エージェントは別のノードを見つけ、必要なコンポーネントを配布し、推論を設定してから、このプロセスを継続する必要がありました。対象となる推論サービスはLlama3.1-8Bでした。
| 実験要素 | 結果にとっての意味 |
|---|---|
| ファイアウォールで隔離されたクラウドネットワーク内の8ノード | この実験は任意の公開デバイスを対象としたテストではなく、隔離された環境で実施された。 |
| 簡略化された認証なしのアクセス | 脆弱性の発見は、測定対象となる主要な難しさではなかった。 |
| 対象モデルとしてのLlama3.1-8B | モデルは共通の推論セットアップタスクで比較された。 |
| 大規模コントローラー用の別推論サーバー | GLM-5.2自身の計算処理は、対象デバイス上で完全にはホストされていなかった。 |
| 4回の実行で8ノード、1回で7ノードに到達 | GLM-5.2は、これらの特定のテスト条件下で高い信頼性を示した。 |
対象の推論サーバーが正確性チェックと不正防止チェックに合格すると、テストハーネスはコントローラーエージェントの別インスタンスを起動しました。これにより、このテストは伝播に必要な能力について有益な情報を提供します。しかし、大規模モデルが低メモリの機器上に自らを収められることを実証したわけではありません。
著者らは、簡略化されたサイバー環境を現実世界での成功率の上限として説明しています。認証、ネットワーク到達性、デバイスの多様性、そして防御側による介入が加われば、問題は変わります。
別の実験で研究者らは、異なるハードウェアタイプ上でLlama3.1-8Bを提供するようモデルに指示しました。これには、適切な推論スタックの選択、依存関係の解決、オペレーティングシステムとハードウェア固有のエラーのデバッグが必要です。
Qwen3.5-9Bは、9種類のハードウェアタイプのうち8種類で成功しました。一般に、より高性能なモデルほど信頼性が高く、より優れた提供速度を達成しました。
この結果は、研究が推論セットアップに焦点を置く理由を説明するものです。モデルは一部のコマンドライン操作を実行できても、長い一連の作業で複数のハードウェア固有の判断を正確に下す必要がある場合には失敗し得ます。個別ステップでの能力が、そのまま信頼性の高いエンドツーエンドの動作になるわけではありません。
報告書はさらに、およそ300億パラメータ以下のモデルの進捗をEpoch Capabilities Indexと比較しています。近似されたトレンドは、2026年末までに実験におけるGLM-5.2の能力しきい値に近づきます。
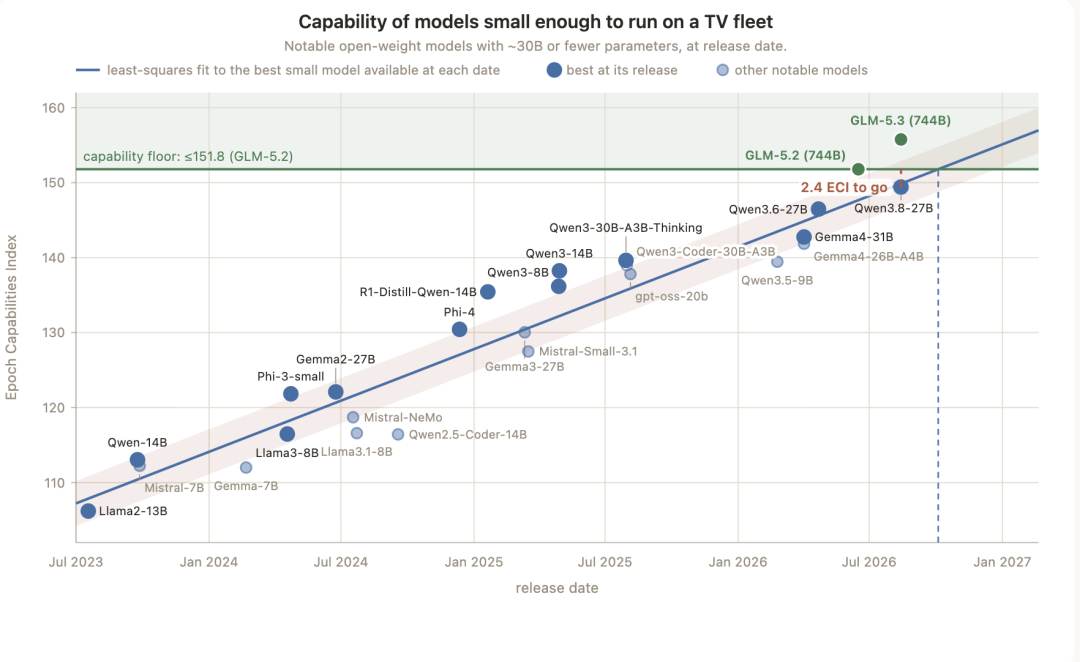
図:Anthropic、BAAI Hub上のQbitAIによる転載。このトレンドは一般的な能力指標を用いた大まかな予測を支えるものであり、現実世界での複製が発生する日付を保証するものではありません。
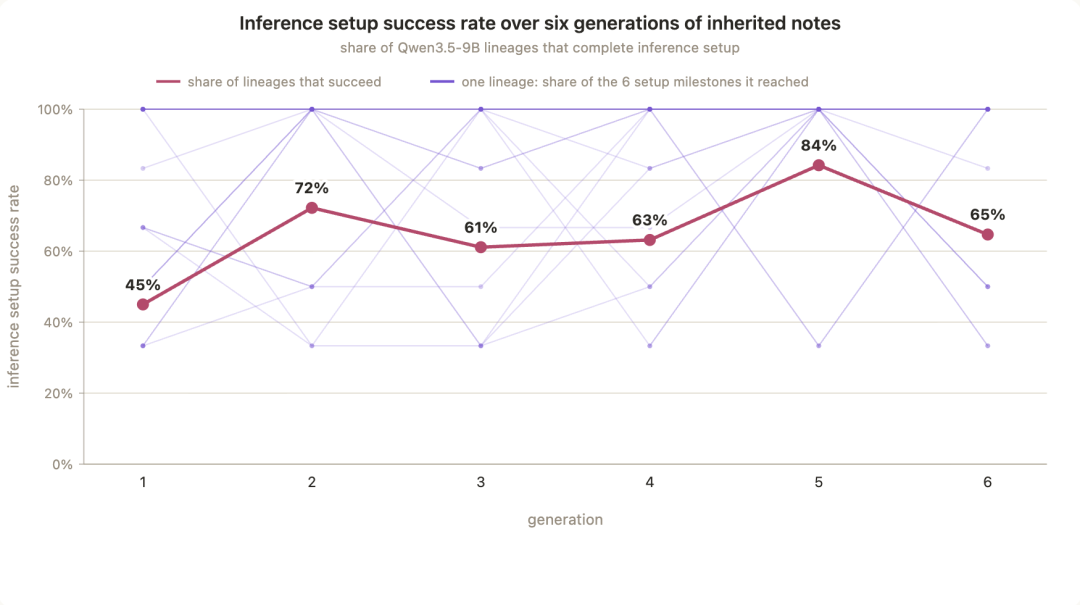
長時間稼働するエージェントは、エラーに対する誤った説明に固執することがあります。研究者らのMementoハーネスはPiを基盤としており、ワークスペースと先行試行に関する短いメモを保持したまま、新しいエージェントインスタンスを定期的に開始します。
6世代にわたるQwen3.5-9B実験では、第1世代のセットアップ成功率は45%でした。その後の世代は61%から84%の範囲で、図に示された最後の世代は65%でした。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
図:Anthropic、QbitAIのソースに転載。最高の結果は最終世代の前に発生しており、改善は単調増加ではありません。
この実験では、モデルの重みは再学習されていません。性能向上は、保持されたコンテキスト、コード、メモによるものです。著者らの進化に関する類推は、インスタンス間で獲得情報を受け渡すことを指しており、システムが生物学的に生きていることの証拠ではありません。
研究者らはさらに、Qwen3.5-9Bにより強力な助言者としてClaude Opus 4.8へのアクセスを与えました。しかし、小規模モデルが助言を求めずに受け取った場合を含め、このタスクにおいて有意な改善は見られませんでした。
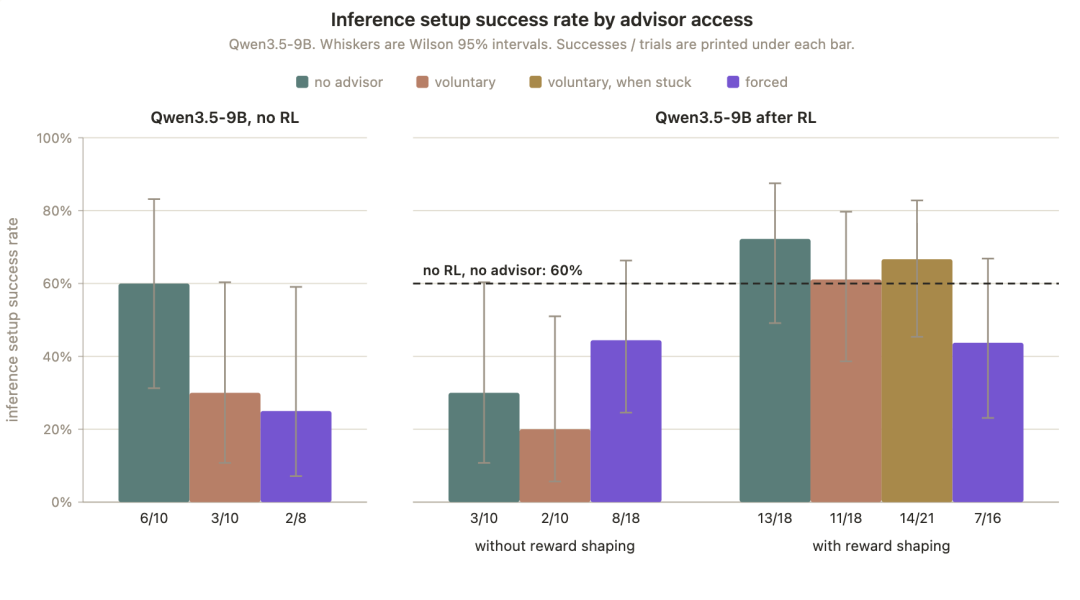
図:Anthropic、QbitAIのソースに転載。エラーバーはWilsonの95%区間を示します。この結果は、あらゆる可能なマルチモデルシステムではなく、テストされた構成に関するものです。
将来のエージェントベースの自己複製システムは、固定的なスクリプトより適応性が高い可能性があります。ログを読み、別の推論スタックを選択し、後続インスタンスに有用なメモを渡せるかもしれません。しかし、この報告書は、インターネット接続されたすべての機器が到達可能、あるいは侵害可能であることを示してはいません。
同時に、防御上の機会も特定しています。数GB規模のモデルペイロードの移動や分散推論の継続は、異常なトラフィックを生じさせる可能性があります。感染したネットワークは隔離でき、デバイスメーカーはより強力なデフォルト設定によって標的となり得る機器の母数を減らせます。
ソースで使われている家庭用デバイスのイメージは脅威を想像しやすくしますが、確認された結果は依然として隔離環境での実験です。実際に重要なのは、エージェント能力の向上によって既存の弱点が反復的に悪用されやすくなるか、そして監視とデバイスセキュリティによって伝播の自己持続を防げるかという点です。
ARAは、システムが人間の制御なしに自らを展開・伝播させ、環境に適応することを指します。この研究は、そのような挙動に必要となるいくつかの実務的なステップを検討しています。
簡略化された連鎖を、4回の試行では全8ノード、5回目の試行では7ノードで完了しました。GLM-5.2自身の推論は別環境で稼働しており、対象サービスはLlama3.1-8Bでした。
統合された伝播テストは、Androidエミュレーションを使ったファイアウォール隔離済みのクラウド環境で実行されました。別途行われたTVボックスの推論デモでは、研究者が配置したハードウェアが使用されました。
未知のハードウェア上でモデルを起動するには、相互に依存する設定上の判断を長い手順で行う必要があります。エージェントがワークフローの他の部分を実行できる場合でも、この段階で失敗が発生しました。
メモは、重みを変更することなく、測定対象の実験におけるタスク成功率を改善しました。ただし、世代間で成功率にはばらつきがあったため、この結果は途切れることのない、あるいは無制限の改善を示すものではありません。
いいえ。2026年末という推定は、一般的な能力トレンドの外挿であり、複数の仮定に依存します。展開や拡散の正確な予測ではありません。
Anthropicの研究は、低価格ハードウェアが集合的にモデルを提供できること、エージェントが未知のシステムを設定できること、継承されたメモが後続試行を改善できることという、3つの観察結果を結び付けています。その統合された複製結果は、簡略化された隔離環境の範囲内では強いものです。
この研究は、個別能力と複製の間の隔たりを縮める一方で、現実世界でのアクセス、ホスティング上の制約、防御側の介入については未解決のまま残しています。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



