For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/azure-maia-300-microsoft-s-2027-multi-gig-1e316d9a.md.
Microsoftは、独自のAIインフラストラクチャプログラムを、はるかに大規模な導入フェーズへ移行させようとしています。
Microsoftは、独自のAIインフラストラクチャプログラムを、はるかに大規模な導入フェーズへ移行させようとしています。
2026年10月12日、同社はAzure Maiaファミリーを2027年からマルチギガワット規模で導入する計画を明らかにしました。導入規模の拡大に伴い、MaiaはMicrosoftの製品およびサービスにおける主要な推論システムとなる見込みです。
この発表は、Microsoftが設計したAIハードウェアの2世代を結び付けています。
Maia 200はすでに量産され、Microsoftのワークロードを処理しています。次世代システムであるMaia 300は、2027年に本番導入を開始する予定で、長文コンテキスト推論、レイテンシーに敏感な対話、持続的なマルチステップのエージェントワークロード向けに特別に設計されています。
Microsoftの中心的な主張は、推論効率をもはやチップ単体だけで改善することはできない、というものです。
同社は、以下を一つのシステムとして共同設計しています。
このシステムレベルのアプローチこそ、Microsoftがマルチギガワット規模へ拡大しようとしているものです。
Maia 300を説明する前に、Microsoftの発表は現行世代から始まります。
Maia 200は、もはや開発プラットフォームだけではありません。
Microsoftによると、同システムは現在、Microsoft Copilotを含む本番ワークロードを処理しており、同時にMicrosoft AIチームによる次世代モデル開発も支援しています。
同社は、GitHub CopilotおよびMicrosoft Foundryも2026年末までに続く見込みだとしています。
これらのワークロード全体で、Maia 200は以下を実行できます。
これは、MicrosoftがMaiaを単一の独自モデルファミリー専用シリコンとして提示していないため、重要です。
このアーキテクチャは、AzureおよびMicrosoft自身のサービス内で、異種混在のモデルポートフォリオを支えることを意図しています。
Microsoftは非常に大規模なAI製品を運用しています。
そのため、同社のインフラストラクチャチームは、導入済みモデルが時間、メモリ帯域幅、ネットワーク容量、電力をどこで消費しているかを直接把握できます。
Microsoftによれば、まず汎用アクセラレーターを設計し、後からアプリケーションの利用方法を決めるのではなく、ハードウェアとソフトウェアのグループが何年も前から連携して作業します。
目標は、将来のモデル要件を予測し、以下のようなハードウェア上の選択へ反映することです。
このフィードバックループは、すでに次世代の設計に影響を与えています。
Microsoftによると、Maia 200は以下の地域で導入されています。
Microsoft Teams、Copilot、Coworkを含む製品の組み込みAI機能について、Microsoftは、Maia 200が主要GPUインフラストラクチャと同社が説明するものに対し、最大1.7倍のトークン毎ワットを実現できると報告しています。
これは、標準化された第三者システム全体にわたる独立公開ベンチマークではなく、Microsoftが報告した比較です。
表現の違いは重要です。
これはMicrosoftの社内における本番運用経験の証拠ではありますが、あらゆるモデル、プロンプト、バッチサイズ、レイテンシー目標、GPU導入において普遍的に1.7倍優位であると解釈すべきではありません。
Microsoftによると、Maia 200の本番運用経験は、Maia 300の設計に直接反映されました。
新システムは、以下を含むより幅広いワークロードをサポートすることを意図しています。
これらのワークロードに共通する制約は推論です。
モデルは、より長いコンテキストを処理し、より多くの状態を維持し、より多くのステップを実行しながらも、応答性を維持する必要があります。
MicrosoftはMaia 300を、Azure Maiaプログラムの第3世代と説明しています。
設計は推論第一です。
これは、トレーニングスループットだけではなく、導入されるAIシステムで支配的になると同社が予測するワークロードを中心に、Microsoftが最適化していることを意味します。
これらのワークロードには、以下が含まれます。
目標指標は、もはや生のFLOPSだけではありません。
データセンターが以下の固定制約の範囲内で、どれだけ多くの有用なトークンを提供できるかです。
Microsoftによると、Maia 300は主要なGPUベースシステムよりメガワット当たり40%多いトークンを提供すると見込まれています。
この数値は、完全なクロスベンダー試験方法論を伴う公開独立ベンチマークではなく、システムレベルの導入効率に関するMicrosoftの見通しです。
また、Microsoftによると、完全な96アクセラレーターラックにおいて、Maia 300はMaia 200の最大7倍のラック規模トークンスループットを提供できます。
この二つの数値は異なる比較を測定しています。
| 主張 | 比較 |
|---|---|
| メガワット当たり40%多いトークン | Maia 300と主要GPUベースシステムの比較 |
| 最大7倍のラック規模トークンスループット | 完全な96アクセラレーターのMaia 300ラックとMaia 200の比較 |
これらを同じ意味のものとして扱うべきではありません。
Maia 300の背景にある主要な考え方の一つは、データ移動が大きなボトルネックになっていることです。
現代の推論システムは、以下を繰り返し移動させます。
計算ユニット、メモリ、ネットワークリンクの間でこれらを移動するたびに、レイテンシーとエネルギーが必要になります。
Microsoftの答えは、Maia 200で導入されたSoftware Defined Locally Accessed Dataflow Architecture、すなわちSDLAの進化形です。
ソフトウェアが、以下の間でデータをどこに配置し、いつ移動させるかを制御します。
Maia 300は、この考え方をマルチチップレット設計全体に拡張しています。
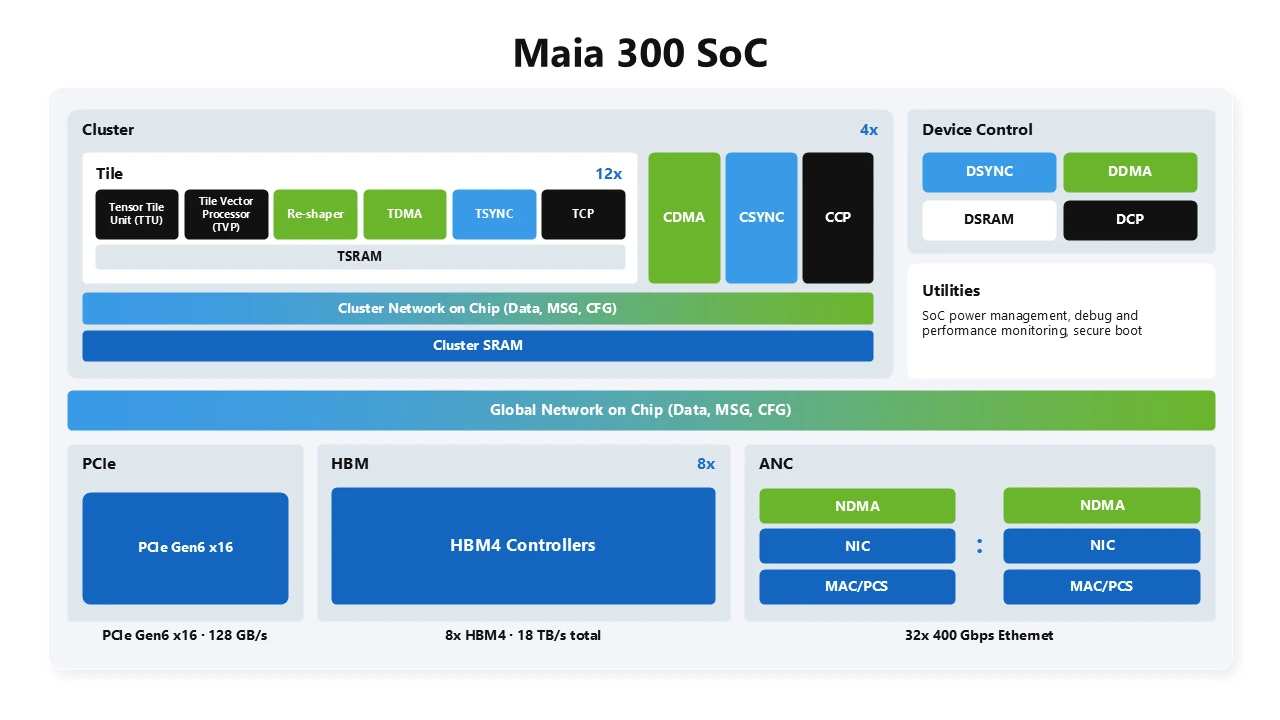
Maia 300は、より均一なメモリ構成から、チップレット全体で局所性を考慮する非一様メモリアーキテクチャへ移行します。
目的は明快です。
データを使用する計算処理の近くに保持する
→ 移動するバイト数を減らす
→ レイテンシーとエネルギーを削減する
→ 利用率を高める
このアーキテクチャでは、ソフトウェアが局所性を制御する責任をより直接的に担います。
これは、モデル状態およびKVキャッシュの移動がワークロードを支配しうる、長文コンテキストやデコード負荷の高い推論において特に重要です。
メモリは、Maia 300における最大級の強化点の一つです。
各アクセラレーターは8基のHBM4スタックを使用し、以下を提供します。
Microsoftによると、これはおおよそ以下を実現します。
このシステムは、ソフトウェア管理型スクラッチパッドとしてオンダイSRAMも使用します。
これにより、頻繁に再利用されるデータを計算処理の近くに保持し、HBMへの負荷を低減できます。
推論においてこれは重要です。多くのワークロードは、計算エンジンのピーク演算能力よりも、状態をどれだけ速く計算エンジンへ供給できるかによって制限されるためです。
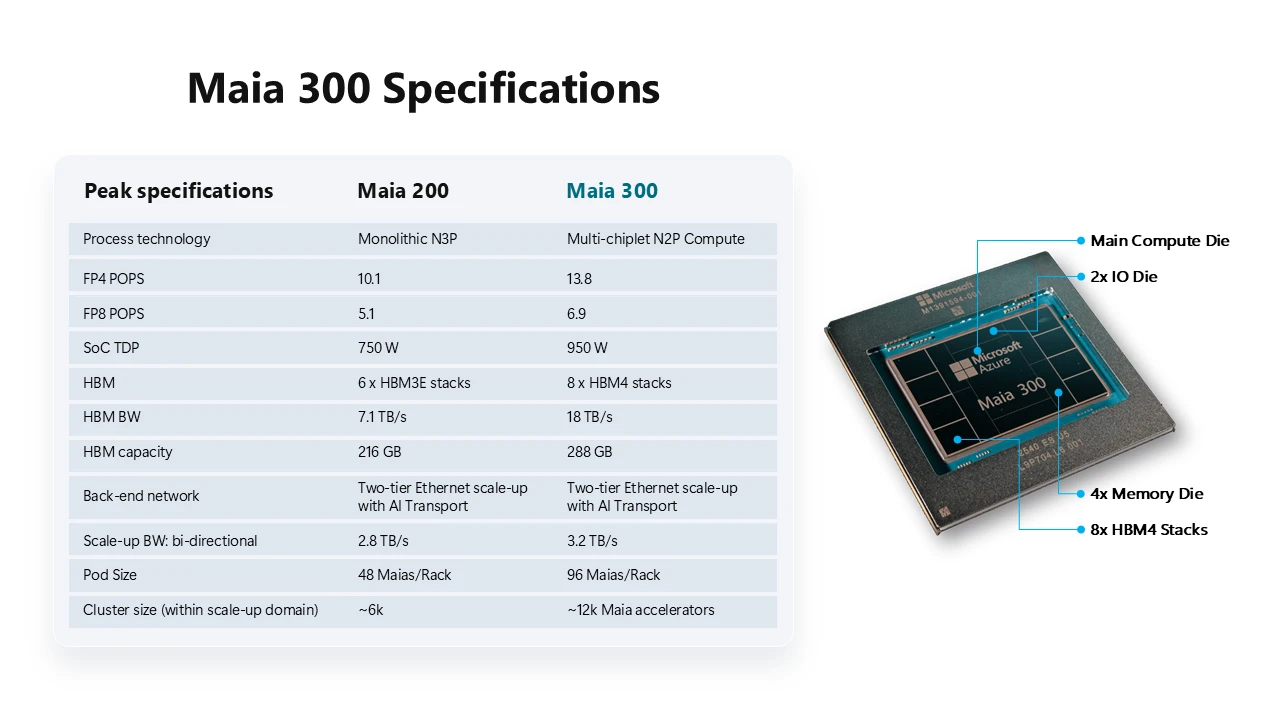
Maia 300は、Maia 200と同じ意味での単一モノリシックダイではありません。
Microsoftは主要機能をチップレット間に分離しています。
このアーキテクチャには、以下の異なる機能が含まれます。
コンピュートチップレットはTSMCのN2Pプロセスで製造されます。
その理由は技術的なものだけでなく、経済的なものでもあります。
最先端のプロセス技術を、性能対電力のメリットが最も大きい部分に集中させる一方、他の機能には帯域幅、接続性、コストに最適化された設計を使用できます。
Microsoftの技術アーキテクチャ記事によると、この変更はMaia 200比で以下に寄与します。
Maia 300は、低精度推論への対応も拡大しています。
Microsoftは技術アーキテクチャ資料において、強化されたMXFP4対応と、3ビット未満のストレージ形式を強調しています。
低精度化により、以下を削減できます。
その利点は、単に数値が小さくなることではありません。
モデルが低精度でも必要な品質を維持できる場合、インフラストラクチャは以下を支援できます。
Microsoftによると、ベクトルエンジンには、softmaxや低精度データ変換といった推論カーネル向けの命令レベル最適化も追加されています。
大規模環境では、アクセラレーターが効率的に通信できなければ有用性は限られます。
Maia 300は、データフローモデルをネットワーク自体へ拡張しています。
Microsoftは、イーサネットベースのインフラストラクチャ上でカスタムAIトランスポートを使用し、2層のスケールアップトポロジーを採用しています。
単一のMaia 300ラックには、以下が含まれます。
96アクセラレーター
複数のラックは、その後スーパーポッドへ接続できます。
Microsoftの技術アーキテクチャでは、最大スーパーポッドは以下のように説明されています。
128ラック
12,288基のMaia 300アクセラレーター
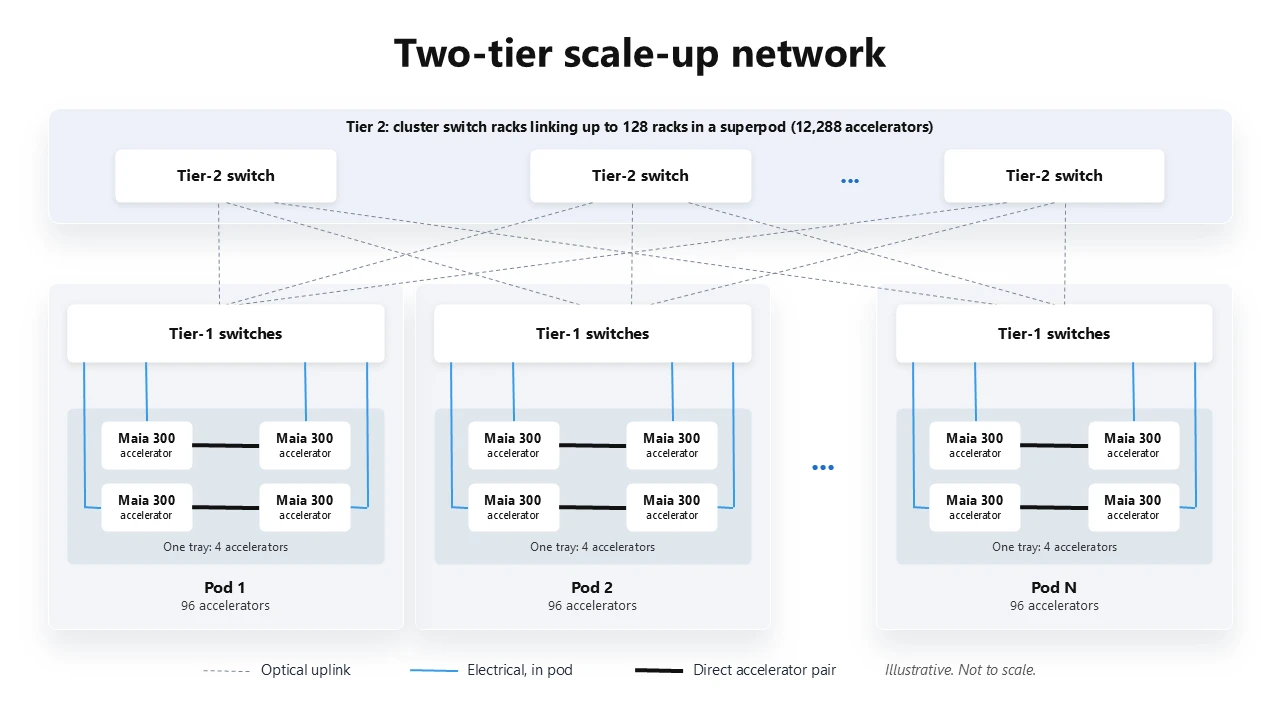
ラック内では、直接リンクがアクセラレーターのペアを接続し、スイッチド電気パスが完全な96アクセラレーターポッドを接続します。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
Microsoftによると、ラック内のスケールアップを電気接続で維持することで、電力とコストの削減に役立ちます。
第2のネットワーク層では、ラックをまたぐために光接続を使用します。
これにより、最大128ラックが同じスケールアップドメインに参加できます。
Microsoftが掲げる目標は、物理的な境界ごとに個別の通信セマンティクスを公開しないことです。
同じ一般的な通信モデルが、以下にまたがります。
これにより、スケジューラーとソフトウェアは、テンソル並列、パイプライン並列、エキスパート並列のワークロードを配置する方法において、より高い柔軟性を得られます。
Maia 300のラックは、システム設計の主要部分です。
各ラックには以下が含まれます。
Microsoftのアーキテクチャ比較では、ラックチャート内の総HBM容量を27.7 TBに丸めています。
この差は、96 × 288 GBを丸めたことによるものです。
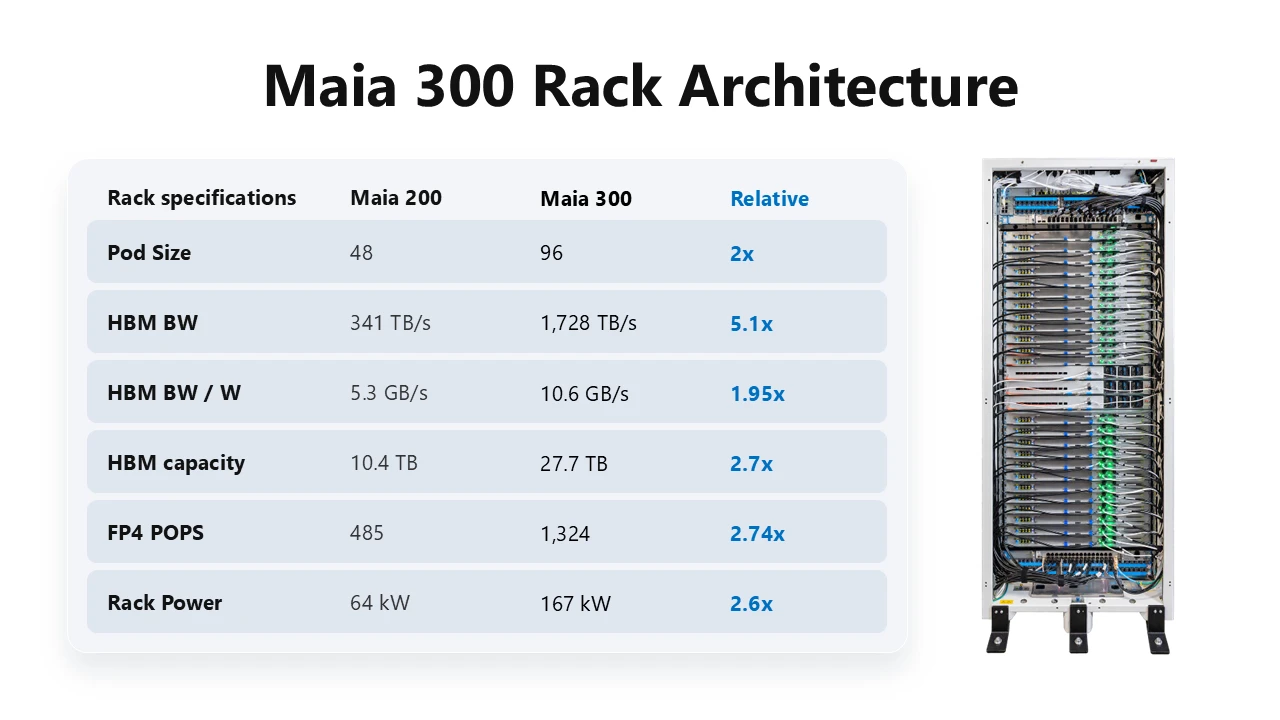
アクセラレーター密度はMaia 200の2倍です。
Microsoftは、個別のホストトレイを必要とするのではなく、ホストコンピュート、メモリ、ストレージ、冷却、アクセラレーターを各トレイに統合しています。
これによりラックスペースが解放され、電力および熱管理を一つのシステムとして処理できます。
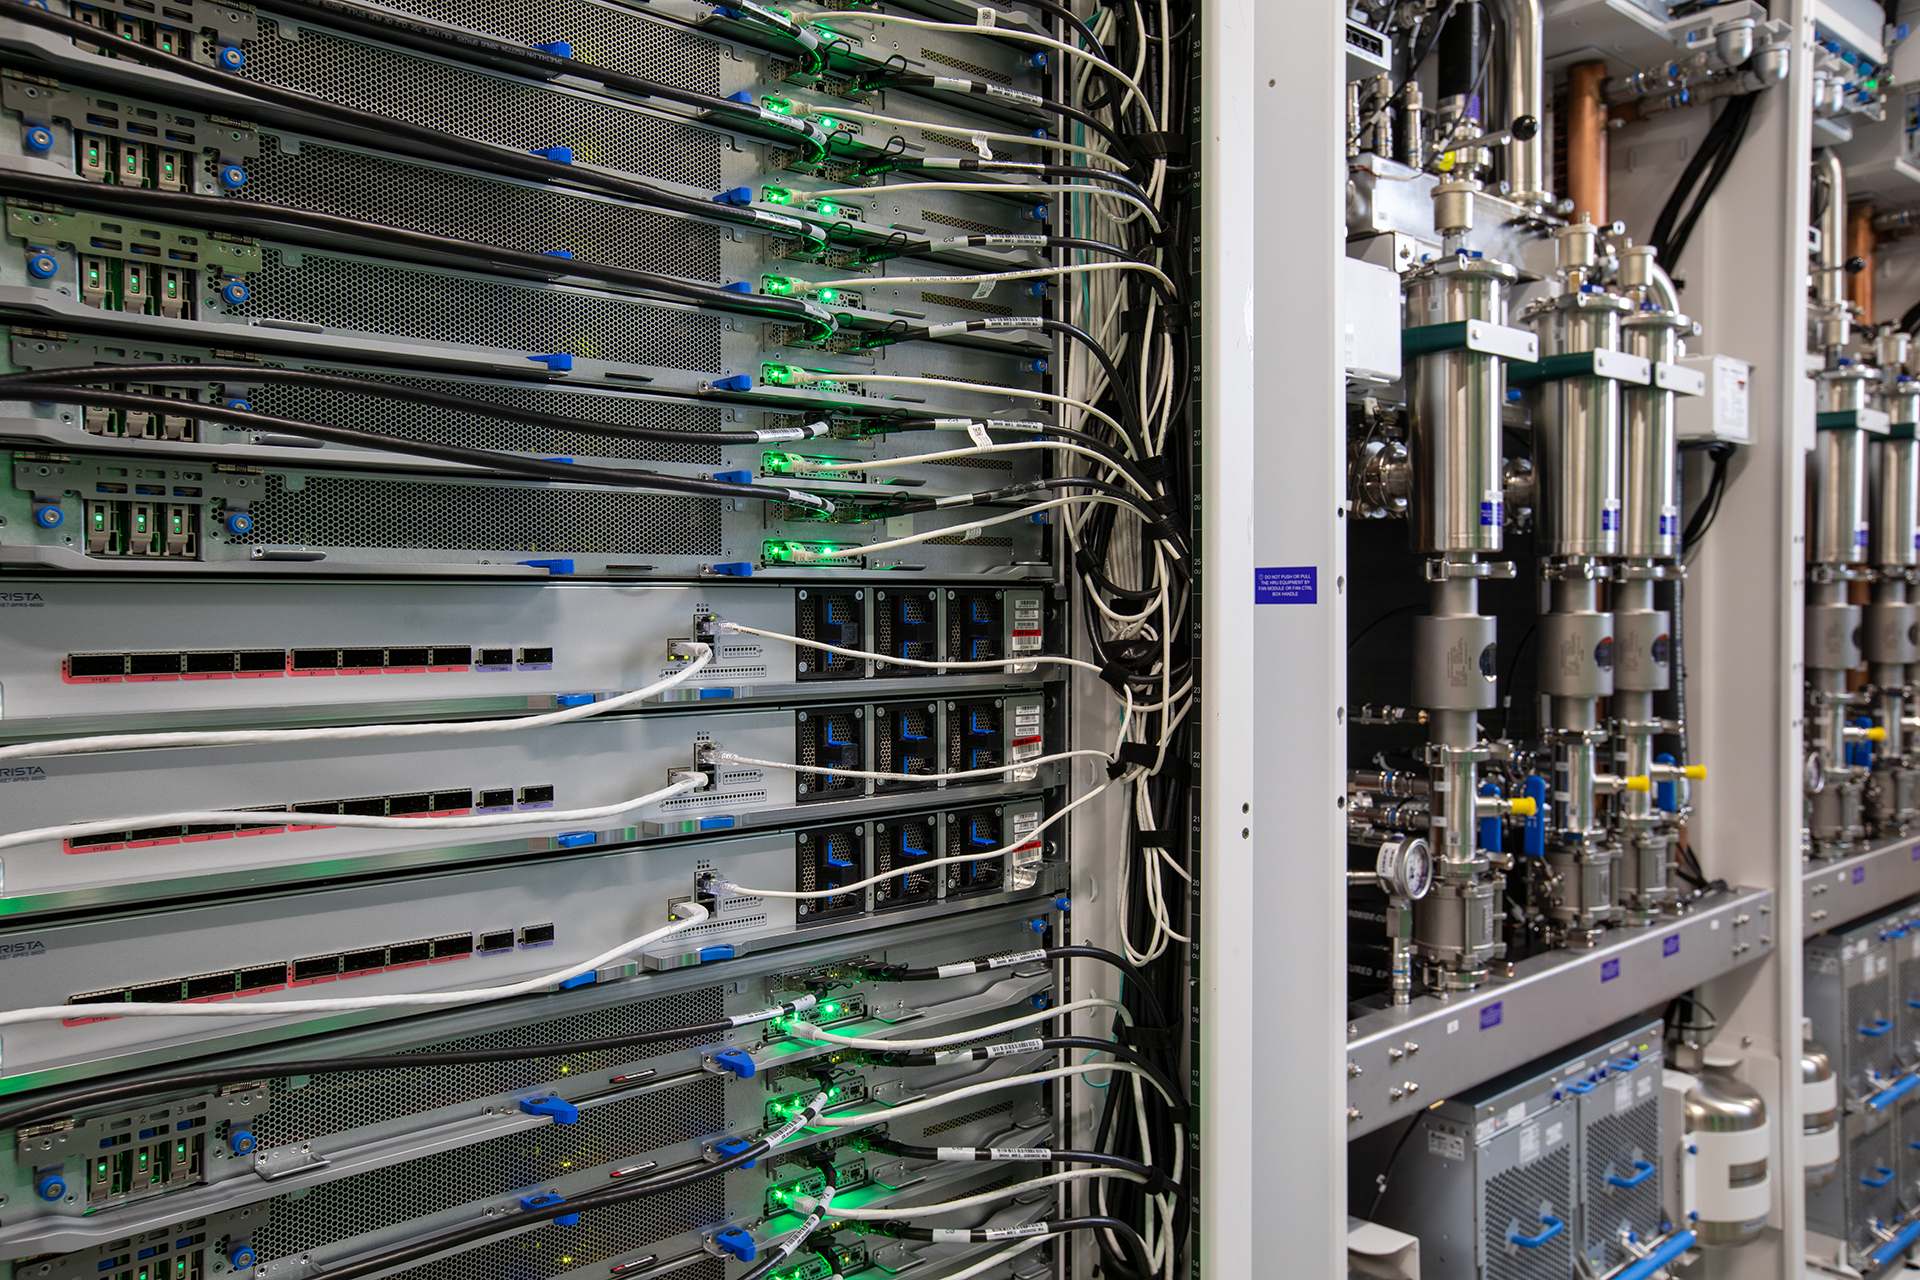
167 kWのAIラックは、熱管理における大きな課題を生み出します。
Microsoftによると、液冷は以下のようなコンポーネントから生じるラックの熱負荷の80%以上を除去します。
メモリ、ストレージ、その他の補助システムを含むコンポーネントには、引き続き空冷を使用します。
このラックは、そのインフラストラクチャがある施設では、設備の水配管に直接接続できます。
それ以外に空冷中心の施設では、熱交換ユニットを使用することもできます。
この柔軟性は、導入規模にとって重要です。
Microsoftは、一つの厳密な冷却構成を中心に構築されたデータセンターだけでMaiaを拡大することはできません。
次の表は、Microsoftが公開したMaia 300の仕様と、Maia 200との比較をまとめたものです。
| 仕様 | Maia 200 | Maia 300 |
|---|---|---|
| プロセス/パッケージ方式 | モノリシックN3P | マルチチップレット、N2Pコンピュート |
| FP4ピーク | 10.1 POPS | 13.8 POPS |
| FP8ピーク | 5.1 POPS | 6.9 POPS |
| SoC TDP | 750 W | 950 W |
| HBM | 6 × HBM3E | 8 × HBM4 |
| アクセラレーター当たりのHBM容量 | 216 GB | 288 GB |
| アクセラレーター当たりのHBM帯域幅 | 7.1 TB/s | 18 TB/s |
| 双方向スケールアップ帯域幅 | 2.8 TB/s | 3.2 TB/s |
| ラック当たりアクセラレーター数 | 48 | 96 |
| おおよそのラックHBM容量 | 10.4 TB | 27.7 TB |
| ラック電力 | 64 kW | 167 kW |
| 公開済みの最大スケールアップドメイン | 約6,000アクセラレーター | 約12,000アクセラレーター |
これらはMicrosoftが公開したピーク性能/システム仕様です。
アプリケーションレベルの保証ではありません。
実際のスループットは、モデル、精度、バッチサイズ、レイテンシー目標、並列化戦略、ソフトウェアスタック、ワークロード構成に依存します。
注目すべき数値は、Azure Maiaを2027年からマルチギガワット規模で導入するというMicrosoftの計画です。
これはインフラストラクチャ規模に関する表明です。
Microsoftは、この表明にひも付く正確な総ギガワット数、導入ごとのスケジュール、アクセラレーター数を開示していません。
また、単一のMaia 300データセンターが必ず複数ギガワットを消費するという意味に解釈すべきでもありません。
ギガワット規模のプログラムは、以下にまたがる可能性があります。
同社の発表は、施設ごとの構築計画ではなく、意図的にシステム戦略に焦点を当てています。
AIインフラストラクチャは、利用可能な電力の範囲内にどれだけの有用な計算能力を収められるかによって、ますます制約を受けています。
データセンターは、以下も提供できなければアクセラレーターを無制限に追加できません。
これが、Microsoftがメガワット当たりのトークン数を重視する理由です。
この指標は、モデル提供の出力を、データセンター拡張をますます左右する希少資源へ結び付けます。
より高速であっても、比例してより多くの電力を消費するチップは、実際の導入課題を解決しない可能性があります。
目的は、同じインフラストラクチャ枠内で、より多くの有用なAI出力を生成することです。
Microsoftの発表は、Maia 300が別のアクセラレーター選択肢になるという説明にとどまりません。
同社は、導入規模の拡大に伴い、MaiaファミリーがMicrosoftの製品およびサービスの主要な推論システムになると述べています。
これにより、MaiaはMicrosoftのスタック全体で戦略的に重要なものとなります。
同社は、以下を含むワークロードを挙げ、または参照しています。
これは、MicrosoftがGPUや他のアクセラレーターを放棄することを意味しません。
Microsoftは、その広範なインフラストラクチャを異種混在かつモデル多様であると明示的に説明しています。
Maiaプログラムは、自社のサービスパターンを中心に緊密に最適化できる、もう一つのインフラストラクチャ選択肢をMicrosoftに与えます。
Microsoftの発表の最終セクションでは、同社がFrontier Transformationと呼ぶ構想の中にMaiaを位置付けています。
その考え方は、AIインフラストラクチャを孤立した層として最適化すべきではない、というものです。
Microsoftは以下をつなげようとしています。
シリコン
→ システム
→ データセンター
→ モデル提供
→ エージェント
→ アプリケーション
Microsoftはこれらすべての層を運用しているため、アプリケーションから得られる本番フィードバックを将来のハードウェアに反映できます。
逆方向も同様です。
新しいハードウェア機能は、将来のモデルとエージェントが大規模に経済的に実現できることを形作る可能性があります。
これがMaiaの戦略的目的です。
同社は、一つのチップがすべてのアクセラレーターを置き換えることを証明しようとしているのではありません。
Azureにおける他のハードウェアと並存できる、垂直統合型で共同設計された推論プラットフォームを構築しているのです。
Maia 300の公開仕様は充実していますが、主要なシステムの大部分はまだ量産前です。
本番導入は2027年に始まります。
実際のワークロードでシステムが稼働し始めると、いくつかの点が重要になります。
Microsoftは、主要GPUベースシステムよりメガワット当たり40%多いトークンを見込んでいます。
重要な問いは、それが異なるモデルやレイテンシー目標全体でどのように維持されるかです。
カスタムシリコンが成功するのは、コンパイラー、カーネル、可観測性、デプロイメントツール、モデル対応が、本番チームにとって十分に成熟している場合に限られます。
Microsoftは、MaiaがOpenAI、MAI、オープンソースのモデルファミリーをサポートすることを目指しています。
異種混在アーキテクチャ全体での本番効率は重要な試金石になります。
12,288アクセラレーターのスケールアップドメインは、アーキテクチャ上重要です。
実環境での利用率、障害復旧、スケジューリング、ラック間通信によって、その理論上の規模のどれだけが有用な容量へ変換されるかが決まります。
ワット当たりの性能は、総コストの一部にすぎません。
データセンター運営者は、以下にも関心を持ちます。
この戦略が機能するなら、Microsoftの優位性は一つのベンチマーク数値ではなく、システム全体を最適化することから生まれるでしょう。
Azure Maia 300は、Microsoftの第3世代カスタムAI推論システムです。マルチチップレットアクセラレーター、HBM4メモリ、ソフトウェア定義データフロー、カスタムのイーサネットベース・スケールアップネットワーキング、クラウド規模AI推論向けに設計された96アクセラレーターのラックアーキテクチャを組み合わせています。
Microsoftによると、本番導入は2027年に開始されます。同社はまた、Maiaファミリーを2027年にマルチギガワット規模の導入へ拡大し始める計画です。
これは、Microsoftが複数ギガワット単位で測定される総電力規模のMaiaインフラストラクチャを計画していることを意味します。Microsoftは正確な総量、アクセラレーター数、単一データセンターが複数ギガワットを消費するという説明を公開していないため、見出しだけからそれらの詳細を推測すべきではありません。
各Maia 300アクセラレーターには、容量288 GB、ピークHBM帯域幅18 TB/sのHBM4スタックが8基搭載されています。96アクセラレーターラックでは、合計で約27.6~27.7 TBのHBMを搭載します。
Microsoftは、完全な96アクセラレーターMaia 300ラックについて167 kWの電力枠を仕様として示しています。アクセラレーターSoC自体のTDPは950 Wです。
Microsoftは、Maia 300が主要GPUベースシステムよりメガワット当たり40%多いトークンを提供すると見込んでいます。ただし、この主張について完全な独立クロスベンダーベンチマーク方法論は公開していません。したがって、この結果は普遍的なベンチマーク上の結論ではなく、Microsoftによるシステムレベルの性能見通しとして扱うべきです。
Microsoftは、MaiaがMicrosoftの製品およびサービスの主要な推論システムになると述べています。一方で、Azureをモデルとシリコンの選択肢を持つオープンで異種混在のプラットフォームとしても説明しています。Maiaは、AzureがMicrosoft製シリコンだけを使用する証拠ではなく、より広範なインフラストラクチャ構成の一部です。
Microsoftによると、Maia 200はすでにMicrosoft Copilotを処理しており、MAIチームの次世代モデル開発を支援しています。GitHub CopilotおよびMicrosoft Foundryは、2026年末までに続く見込みです。
MicrosoftはAzure Maiaを、カスタムアクセラレータープログラムから大規模推論プラットフォームへと転換しています。Maia 200はすでに本番ワークロードを処理しており、Maia 300は2027年に導入開始予定で、長文コンテキスト、デコード負荷の高いエージェント型推論を中心に設計されています。
最大の変化はシステムレベルにあります。アクセラレーター当たり288 GBのHBM4、18 TB/sのメモリ帯域幅、マルチチップレットN2P設計、167 kWラック当たり96アクセラレーター、12,288アクセラレーターに達するスケールアップファブリック、そしてラック熱の80%以上を除去する液冷です。
Microsoftの目標は、Maiaファミリーをマルチギガワット規模の導入へ拡大し、Azureの異種混在性を維持しながら、自社製品およびサービスを支える主要な推論システムにすることです。
Maia 300の本質は、一つのチップが別のチップを置き換えることではなく、AI推論の経済性を軸に、シリコンからデータセンター、エージェントまでの全経路をMicrosoftが設計していることにあります。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



