名前:デプロイ-本番環境 説明:アプリケーションを検証し、本番環境にデプロイします。--- 1. checklist.mdを読んでください。2. 完全なテストスイートを実行します。3. 移行計画を確認します。4. 実行
checklist.md を読んでください。scripts/verify-release.sh を実行してください。
重要な仕組みは**段階的開示(プログレッシブ・ディスクロージャー)**です。

Claude はスキルが関連するかどうかを判断するのに役立つ短い説明を見ます。完全なスキル本文とサポートファイルは、そのプロセスが必要な場合にのみ読み込まれます。

Mukta 氏はこれを本棚に例えています。

人は会話を始める前にすべての本を覚えておく必要はありません。関連情報が含まれているかもしれない本がどれかを知っていて、適切なタイミングでそれを取り出せばよいのです。

スキルは「増え続けるコンテキストファイル」問題の解決に役立ちます:

- 安定した高レベルの事実は `CLAUDE.md` に残せます。
- 詳細なプロセスはスキルに移せます。
- サポート資料は必要な時までアクティブなコンテキストの外に置いておけます。

Anthropic 公式のスキルドキュメントによると、チームが同じ指示・チェックリスト・複数ステップのプロセスを繰り返し会話に貼り付けている場合、または `CLAUDE.md` の一部が簡潔な事実ではなくプロセスに発展している場合に、スキルを作成することが推奨されています。

### スキルには依然として人間の管理が必要

スキルは再利用可能ですが、それでも誰かが以下を決定する必要があります:

- どのワークフローにスキルを作る価値があるか
- プロセスをどのように構築するか
- どのファイルを含めるか
- スキルがいつ時代遅れになるか
- 誰に編集権限があるか

エージェントはスキルの作成と維持を支援できますが、このシステムは依然として部分的に人間の管理に依存しています。

これが4つ目のアプローチにつながります。

## 第4世代:ファイルシステムを記憶として扱う

Mukta 氏は、ファイルシステムベースの記憶を、Anthropic が現在多くのエージェント記憶システムで好んでいるパターンであると説明しています。

その理由は非常に実用的です。

エージェントはすでに以下のことが得意です:

- ファイルの一覧表示
- ファイル名の検索
- `grep` の実行
- Markdown の読み取り
- ディレクトリの閲覧
- テキストの編集
- バージョンの比較

高度に特化した記憶インターフェースを発明する代わりに、チームは記憶をファイルとして整理し、エージェントに通常のファイルシステムツールを提供することができます。

可能なレイアウトの一つは次のとおりです:

```Plaintext
memory/
├── organization/
│   ├── principles.md
│   ├── terminology.md
│   └── security-policy.md
├── teams/
│   ├── engineering/
│   │   ├── architecture.md
│   │   └── release-process.md
│   └── support/
│       ├── escalation-rules.md
│       └── response-style.md
├── projects/
│   └── billing-redesign/
│       ├── decisions.md
│       ├── known-issues.md
│       └── current-status.md
└── agents/
    └── agent-104/
        └── scratchpad.md
このレイアウトは、異なるレベルの記憶をサポートします:
これも段階的開示を体現しています。
エージェントはディレクトリを検索し、現在のタスクに関連するファイルのみを読み込むことができます。
ファイルシステムスタイルのインターフェースは、すべての企業記憶が管理されていないファイルとしてノートパソコン上に存在することを要求するものではありません。
基盤となる実装は依然として以下を使用できます:
重要な点は、エージェントがシンプルでナビゲート可能な抽象化を得られることです。
質疑応答セッションで、ある聴衆がこれはデータベースの再発明と同じかどうか尋ねました。
Mukta 氏は、このアーキテクチャが馴染みのあるソフトウェアエンジニアリングの原則に回帰していることを認めました。チームはどの動作が決定的であるべきかを理解すれば、モデルが毎回即興で行うのではなく、それらの動作を制御フレームワークに移行できます。
Markdown ファイルでいっぱいのフォルダは、単一ユーザーには有効かもしれません。
しかし、何千ものエージェントが共有の組織記憶を更新できるようになると、危険になります。
Mukta 氏は4つの本番原則を強調しました:
すべての記憶更新には履歴が必要です。
有用なメタデータには以下が含まれます:
出所の追跡がない記憶エントリは、信頼を得るのが困難です。
エージェントが次のように追加したと仮定します:
- 金曜日の本番デプロイは承認不要です。
出所・レビュアー・改訂履歴がなければ、別のエージェントがこの記述を権威あるものと見なす可能性があります。
バージョン管理は以下をサポートします:
バージョン管理された記憶システムは、次の質問に簡単に答えられるべきです:
このルールの出現につながったのはどのインタラクションですか?
2つのエージェントが10:00に同じ記憶を読み取ったとします。
エージェントAは10:02に更新を書き込みました。
エージェントBはこの変更を知らず、10:03に自分のバージョンを書き込み、誤ってエージェントAの更新を削除しました。
Mukta 氏はハッシュベースの並行性パターンを説明しました:
エージェントは記憶を読み取り、ハッシュAを記録する
        ↓
エージェントは更新を起草する
        ↓
エージェントは再度記憶を読み取り、ハッシュBを記録する
        ↓
ハッシュA == ハッシュB の場合:
    更新をコミットする
そうでない場合:
    再読み込み、リベース、再試行する
これが楽観的並行性制御です。
モデルはどのような変更を提案するかを決定できますが、制御フレームワークは古い書き込みが新しいバージョンを置き換えるのを決定的に防ぐべきです。
すべてのエージェントがすべての記憶を編集できるべきではありません。
合理的な権限モデルの例は次のとおりです:
| 記憶の範囲 | 典型的なアクセス方法 |
|---|---|
| 組織原則 | ほとんどのエージェントは読み取り専用。審査プロセスを通じてのみ書き込み |
| セキュリティポリシー | 関連エージェントは読み取り専用。制限された人間による制御書き込み |
| チームプロセス | チームは読み取り専用。指定されたメンテナーが書き込み |
| プロジェクト決定 | プロジェクトエージェントは読み取り専用。提案された編集は承認が必要 |
| エージェント下書き領域 | 単一エージェントが読み書き |
| ユーザー設定 | ユーザー範囲のエージェントがアクセス |
| 機密の顧客コンテキスト | 厳格なロールベースのアクセス |
エージェントは不確かな観察を組織全体のルールに変えるべきではありません。
権限の境界は Dreaming にも適用されるべきです。統合タスクは、そのアイデンティティがアクセスを許可された会話記録と記憶のみを受け取ることができます。
記憶は組織の最も価値あるAI資産の一つになる可能性があります。
それには以下が含まれます:
Mukta 氏は、チームがこの資産を単一製品内でのみ動作するように設計することを避けるべきだと考えています。
可搬性のある記憶システムは以下を持つべきです:
可搬性により、同じ丁寧に整理されたコンテキストが以下をサポートできます:
うまく設計された記憶ツールでも、2つの構造的な限界があります。
エージェントはタスクを完了しながら記憶を整理しなければなりません。
記憶への書き込みは、現在の目標に使用できるリソースを消費します。
エージェントは以下の可能性があります:
制限2:エージェントは1つのセッションしか見えない
あるエージェントが、特定のコマンドが一度失敗したことに気づくかもしれません。
しかし、同じコマンドが他の300のセッションでも失敗していることを、そのエージェントは見ることができません。
サポートエージェントが、ある顧客が特定のポリシーに困惑しているのを見るかもしれません。
しかし、同じ困惑が地域全体で繰り返し発生していることを見ることはできません。
システム全体をカバーする学習メカニズムには、より広い可視性を持つプロセスが必要です。
このプロセスこそ、Anthropicが**「ドリーミング」**(Dreaming)と呼ぶものです。
ドリーミングは、通常の作業が完了した後にエージェントの履歴をレビューする非同期プロセスです。
Anthropicの現在のAPIリリースノートでは、Claudeホスト型エージェントの「ドリーミング」機能は研究プレビューとして説明されています。
一度の「ドリーム」は以下を読み取ります:
その後、再編成された出力用記憶ストレージを作成し、そこで以下のことが可能です:
これはモデルの再トレーニングではありません。
基盤となるモデルの重みは変更されません。
改善は、永続化されたコンテキストを変更し、将来のセッションがこれらのコンテンツを検索できるようにすることから生まれます。
Muktaは、通常の記憶と「ドリーミング」の違いを説明するために学校を使いました。
想像してみてください:
教師は1人の生徒が間違いを訂正するのを助けることができます。
教務主任は、地理の生徒全員が同じ知識ポイントで間違いを犯していることに気づくことができます。それは、カリキュラムの概要にその内容がまったく含まれていないからです。
システムレベルの修正は、各試験用紙を個別に採点することではありません。
カリキュラムの概要を更新することです。
エージェント用語:
これにより、システムは単一のエージェントでは気づくことができないパターンから学習できるようになります。
簡略化されたドリーミング処理パイプラインは次のようになります:
フローチャート TD
    A[既存の記憶ストレージ] --> D[ドリームオーケストレーター]
    B[セッション記録] --> D
    C[ツール呼び出しとメタデータ] --> D
    D --> E1[レビューエージェント 1]
    D --> E2[レビューエージェント 2]
    D --> E3[レビューエージェント 3]
    E1 --> F[パターン集約器]
    E2 --> F
    E3 --> F
    F --> G[提案された記憶変更]
    G --> H{人間による承認}
    H -->|承認| I[更新された記憶ストレージ]
    H -->|拒否| J[既存の記憶を保持]
レビュープロセスは、ユーザーとアシスタントのメッセージだけでなく、より多くのものを検査できます。
有用な証拠には以下が含まれます:
ドリームエージェントはその後、次のようなパターンを探します:
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
Mukta氏は、Anthropicの設計には関連するセッション記録の例と、パターンの発生頻度を示す統計データを含めることができると述べました。
これらの証拠は、人間が提案された記憶変更が妥当かどうかを判断するのに役立ちます。
ドリーミング処理は広範なアクセス権を持ち、エージェントクラスター全体の将来の動作に影響を与える可能性があります。
これにより、自動かつ無審査の更新はリスクを伴います。
より安全なワークフローは次のとおりです:
例えば:
## 提案された記憶更新

**対象:** `teams/engineering/test-process.md`

**観察された問題:**
エージェントが63の関連セッションのうち18のセッションで、単体テストコマンドを使用して統合テストを実行しました。

**証拠:**
セッション `s-102`、`s-111`、`s-118`、`s-124`、……

**提案された追加内容:**
- データベースコンテナを必要とするすべてのテストに `npm run test:integration` を使用します。
- `tests/integration/` 配下のファイルには `npm test` を使用しないでください。

**信頼度:** 高

**人間の判断:** 保留中
これにより人間による監督が維持され、エージェントクラスターが分析作業の大部分を実行できるようになります。
ドリーミング処理には追加のモデル呼び出しが必要です。
一見すると、これは不要なオーバーヘッドのように思えます。
Mukta氏は、よりクリーンな記憶ストレージは総コストを削減できると述べています。なぜなら、将来のエージェントが最初の試行で正しくタスクを完了する可能性が高くなるからです。
最初の試行。
有用な経済的比較は次のとおりです:
ドリーミングのコスト
対比
繰り返される失敗、再試行、手戻り、過度に長いコンテキストのコスト
潜在的な節約は以下から得られます:
Anthropicはまだ、各組織がどれだけ節約できるかを示す一般的なベンチマークを公開していません。具体的な価値は以下に依存します:
多数のエージェントが関連する作業を実行し、同じパターンに繰り返し遭遇する場合、「ドリーミング」は最も報われる可能性が高くなります。
チームは完全なプラットフォーム統合を待たずに、このコンセプトをテストできます。
手動バージョンは毎週実行できます。
レビュー担当者が閲覧権限を持つ会話記録のみを収集します。
以下のように整理します:
以下を含めます:
CLAUDE.mdプロンプトは次のように書くことができます:
これらの承認されたセッション記録と現在の記憶ファイルをレビューしてください。

繰り返し発生する失敗、ユーザーによる繰り返しの修正、古い指示、
欠落したプロセス、重複したエントリを特定してください。

各提案された変更について:
1. 対象ファイルを指定してください。
2. 裏付けとなるセッションIDを提示してください。
3.

このパターンが出現する頻度を説明する。
4. 最小限の効果的な修正を起草する。
5. ファイルを直接編集しない。
以下の修正は却下する:
バージョン管理を使用し、コミットまたは監査記録にソース証拠を含める。
同じ失敗が後続のセッションで減少するかを追跡する。
測定がなければ、「夢を見る」ことは学習システムではなく、ドキュメント生成作業になる。
記憶が答えるのは:
エージェントは以前の作業から何を覚えておくべきか?
グラフ構造エンジニアリングが答えるのは、別の質問である:
現在のタスクのどの部分が実際に相互に依存しているのか?
BAAIの元記事は、記憶の話題を、AI開発コミュニティで流通しているグラフ構造エンジニアリングのガイドラインに結び付けている。
そのガイドラインの中心的な主張は、多くの「ワークフロー」は本質的にすでにグラフである——ただ設計が悪いだけだ、というものだ。
リスト形式で書かれたワークフローは、人為的に直列プロセスに変換されることが多い:
調査
    ↓
要約
    ↓
比較
    ↓
ファクトチェック
    ↓
執筆
これらのステップの一部は、確かに前の出力に依存しているかもしれない。
他のステップは、意味もなく待っているだけかもしれない。
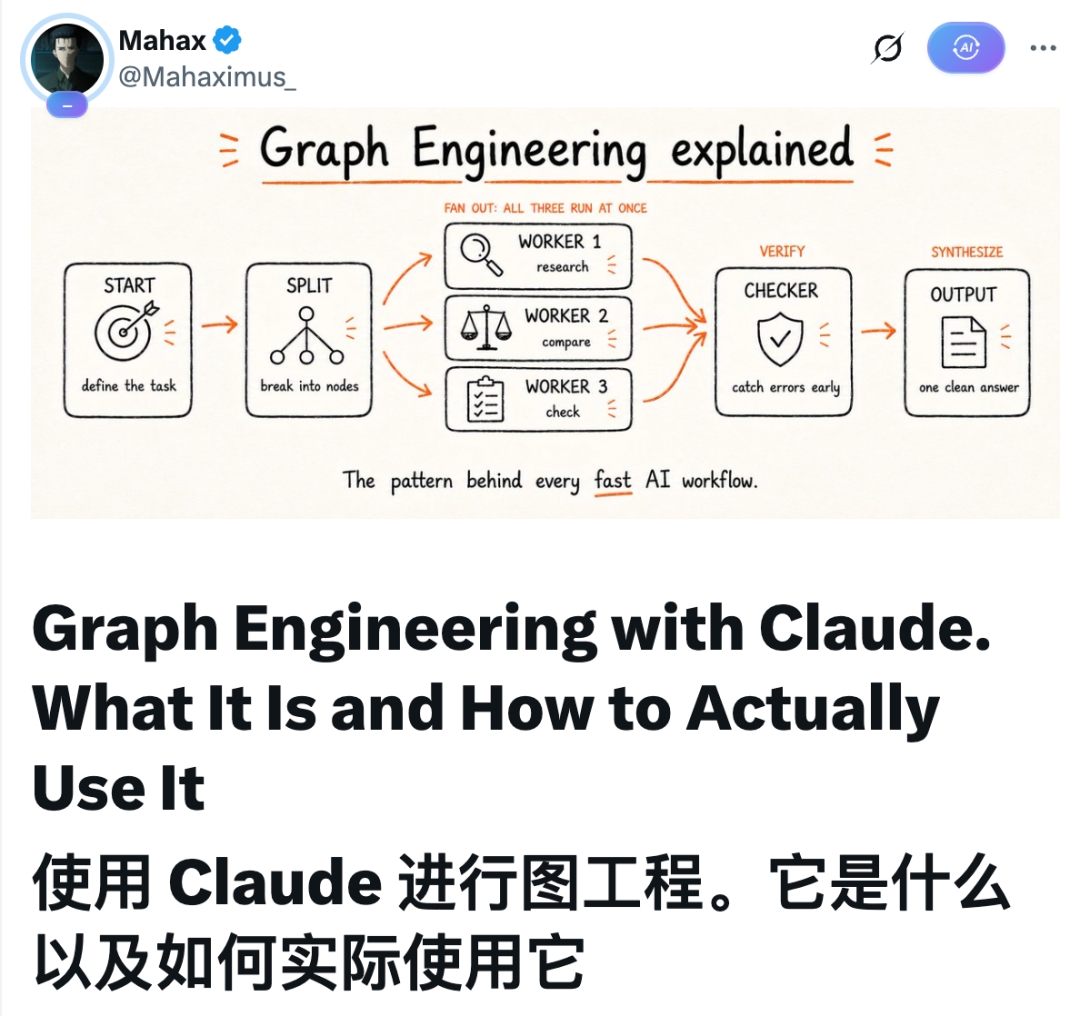
ワークフローグラフでは:
例:
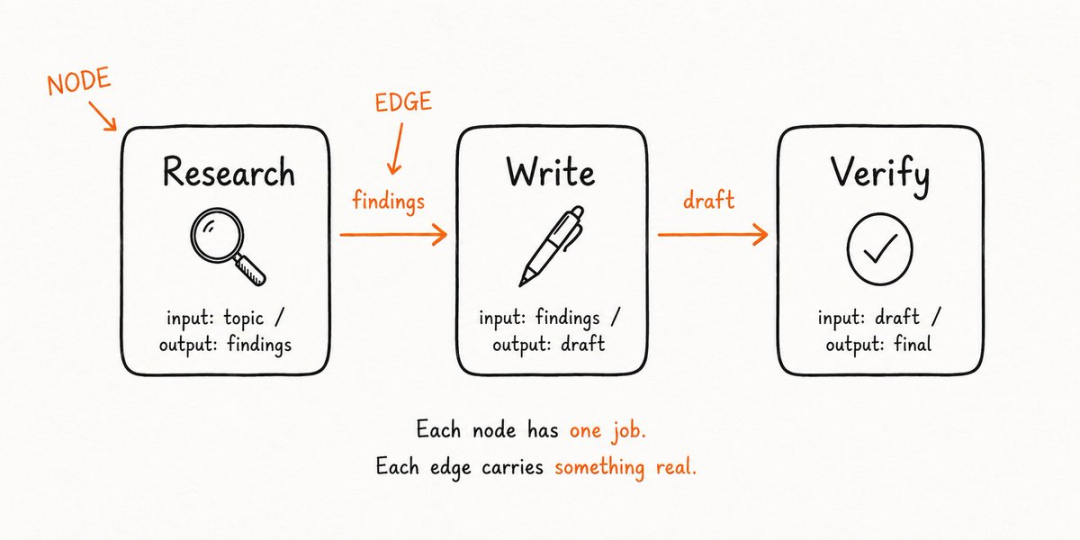
調査ノードは調査結果を産出する。
執筆ノードはこれらの調査結果を消費し、草稿を産出する。
検証ノードは草稿を消費し、チェック済みの結果を産出する。
これらの矢印は妥当である。なぜなら、各下流ノードは上流ノードの出力を必要とするからである。
コミュニティのグラフガイドラインは、各矢印に対して単純なテストを提案している:
次のタスクは本当に前のタスクの出力を必要とするか?
答えがノーであれば、その依存関係は疑似依存である。
次のワークフローを考えてみよう:
競合他社Aの調査
    ↓
競合他社Bの調査
    ↓
競合他社Cの調査
    ↓
比較レポートの作成
競合他社Bの調査は、通常、競合他社Aの調査の出力を必要としない。
競合他社Cの調査は、通常、競合他社Bの調査の出力を必要としない。
これらのタスクは並行して実行できる:
flowchart TD
    A[比較基準の定義] --> B1[競合他社Aの調査]
    A --> B2[競合他社Bの調査]
    A --> B3[競合他社Cの調査]
    B1 --> C[比較レポートの作成]
    B2 --> C
    B3 --> C
疑似エッジを削除することで待ち時間を減らすことができる。
3つの調査タスクがそれぞれ10分、12分、15分かかる場合:
グラフは、個々のエージェントを速くするわけではない。
変更するのはスケジューリングの方法である。
疑似エッジを削除すると、一般的な形状が現れる:
これは通常、ダイヤモンドと呼ばれる。
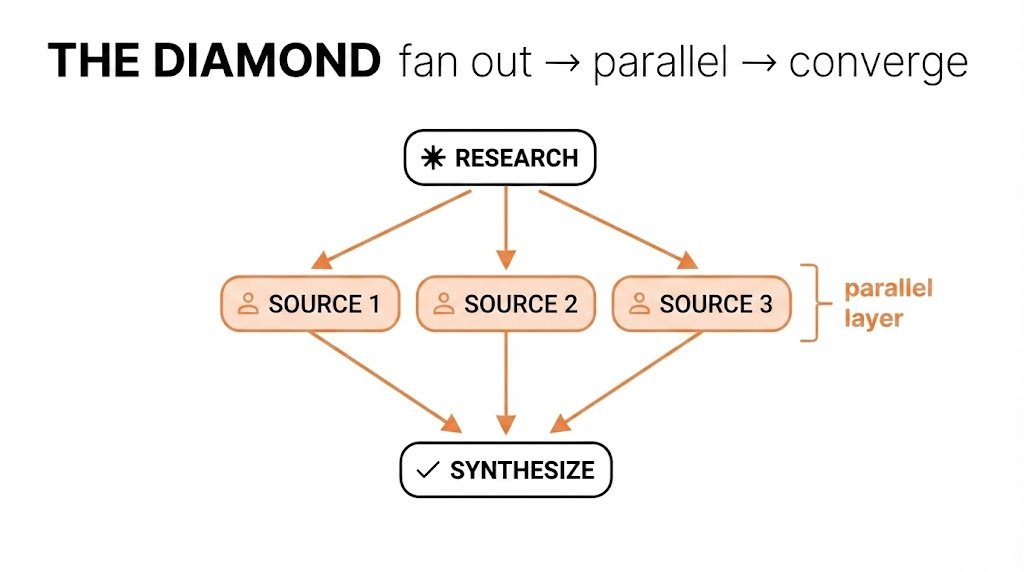
調査の例は次のようになるだろう:
flowchart TD
    A[調査質問] --> B1[市場データ]
    A --> B2[顧客エビデンス]
    A --> B3[競合分析]
    B1 --> C[チェッカー]
    B2 --> C
    B3 --> C
    C --> D[最終総合]
総所要時間は、主に最も遅いブランチによって決まり、すべてのブランチの所要時間の合計ではない。
並行処理は新たなリスクを導入する。
1つのワーカースレッドが、薄弱、陳腐化、または裏付けのない出力を生み出す可能性がある。
システムが検証なしにすべてを統合すると、1つの悪いブランチが最終回答を汚染する可能性がある。
そのため、グラフガイドラインは総合の前にチェッカーを配置する。
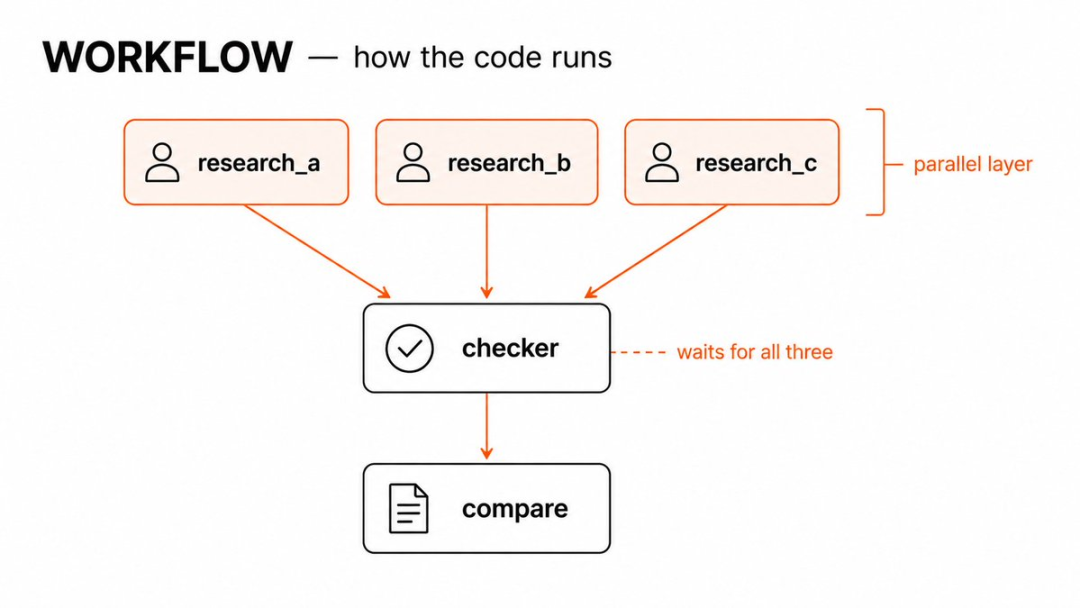
チェッカーは次のように問いかけることができる:
出力は要求された形式に適合していますか?
有用なチェッカーには明確な受け入れ基準が必要です。
例:
ひとことから始めて、数分で完全なサイトを手に入れましょう。



