中国の最先端モデル競争は、兆パラメータ時代へと深く突入している。アリババのQwen3.8-Maxはすでに2.4兆パラメータに達し、月之暗面のKimi K3はさらに高い水準へと引き上げられている
中国のフロンティアモデル競争は、兆パラメータ時代へと突入している。
阿里巴巴(アリババ)のQwen3.8-Maxは2.4兆パラメータに達し、月之暗面(Moonshot AI)のKimi K3は公表された規模を2.8兆パラメータまで押し上げている。
ByteDanceは次の飛躍を準備している可能性がある。
AIBaseが晩点LatePostの報道を引用して伝えたところによると、ByteDanceは2026年8月7日時点で、5兆超パラメータの基盤モデルの訓練を議論しているという。同報道によれば、このプロジェクトはまだ初期段階にあり、最終的なモデルの公開が保証されているわけではない。
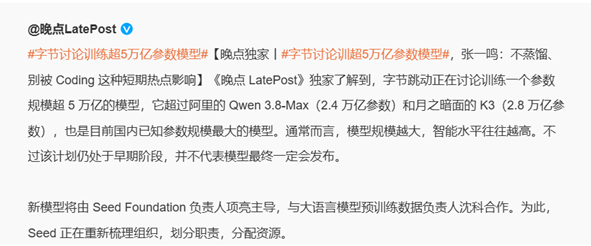
規模だけを見れば、このプロジェクトは中国で公開報告された中で最大級のAIモデルプロジェクトの一つとなる。
しかし、同日にはもう一つの重要な更新があった。
8月7日遅く、ロイター通信は英国フィナンシャル・タイムズ紙および関係者の情報として、ByteDanceが最大10兆パラメータのモデルを訓練しており、このモデルはすでに事前学習段階に入っていると報じた。ByteDanceは当時、この報道に対して公式な回答をしていない。
この2つの報道は必ずしも矛盾しない。最初に「5兆超」として議論されたプロジェクトが、最終的により大規模な構成を目指す可能性もある。しかし、ByteDanceがモデルアーキテクチャやパラメータ数を正式に開示していないため、本記事のすべての数字は確認済みのモデル仕様ではなく、報道された計画として扱うべきである。
晩点LatePostの当初の報道によると、ByteDanceは5兆超パラメータのモデルを議論しているという。
これは、現在中国の複数のフロンティアモデルが開示している規模をはるかに上回るものとなる。
| モデル | 公開報告された総パラメータ | ステータス |
|---|---|---|
| Qwen3.8-Max | 2.4兆 | アリババが公開済み |
| Kimi K3 | 2.8兆 | 月之暗面が公開済み |
| 報道されたByteDanceモデル | 5兆超 | 報道された計画 |
| 後続のFT/ロイター報道 | 最大10兆 | 報道によるもので、公式確認なし |
月之暗面は公式にKimi K3を2.8兆パラメータの混合専門家モデルと説明しており、各トークンで1040億パラメータが活性化される。
ロイター通信は8月3日、アリババのQwen3.8-Maxが2.4兆の総パラメータを含むと報じた。
ByteDanceが最終的に5兆から10兆パラメータのモデルを訓練し展開する場合、これはモデル総規模の顕著な拡大を意味する。
しかし、これは自動的にモデルの能力が2倍から3倍になることを意味するわけではない。
AIBaseの情報源は、5兆パラメータモデルを、GPT-5.6やAnthropicの最新ハイエンドモデルなどの米国の主要フロンティアシステムと同程度のカテゴリーにあると説明している。
この比較には重要な限定条件を付ける必要がある。
OpenAIとAnthropicは、GPT-5.6、Claude Fable 5、Claude Mythos 5の正確なパラメータ数を公開していない。
ロイター通信も8月7日の報道で同じ見解を示している。米国の主要システムとの直接的な規模比較は困難である。なぜなら、これらの研究所はモデルのパラメータ数を公表していないからだ。
パラメータ数はモデルの能力を測る一つの側面に過ぎない。
性能は以下にも依存する:
これは混合専門家モデルにとって特に重要である。
スパースMoEモデルは数兆の総パラメータを持つ可能性があるが、各トークンではそのごく一部のサブセットのみが活性化される。
Kimi K3は良い例である。
その公式仕様書には以下が記載されている:
したがって、重みの総数は、各推論ステップで使用される計算量とは別物である。
ByteDanceは、報告されているモデルが同様のスパースアーキテクチャを使用するかどうか、また各トークンでどれだけのパラメータが活性化されるかについては、まだ公開していない。
当初の報道は、NVIDIA H100 GPUを例にその規模を示している。
その見積もりによると、5兆パラメータのモデルの訓練にはおおよそ以下が必要:
両方のシナリオの総アクセラレータ時間はほぼ同じオーダーとなる:
| シナリオ | GPU数 | 期間 | 概算GPU日数 |
|---|---|---|---|
| 長期クラスター | 100,000 | 347日 | 3,470万 |
| 大規模短期クラスター | 1,000,000 | 35日 | 3,500万 |
これらの数字は、情報源による大まかなシナリオ見積もりとして理解されるべきであり、一般的な工学的公式ではない。
実際の訓練要件は、以下に大きく依存する:
NVIDIA公式のH100仕様書によると、SXMバージョンのTDPは最大700Wで、HopperのTransformer EngineとNVLinkインフラストラクチャを通じて大規模transformer訓練をサポートする。
数十万基のアクセラレータ規模では、GPUクラスターだけで、電力、ネットワーク、冷却、データセンター容量が最優先の制約条件となる規模に達する。
AIBaseの情報源は、100万基のH100クラスアクセラレータを同時に実行することは、極端なインフラストラクチャ構成であると正しく指摘している。
より現実的なプロジェクトでは、訓練をより小規模だが依然として巨大なクラスターに分散させる可能性がある。
情報源が提案するより現実的なアプローチは:
これでも、依然として最大級の訓練クラスターの一つとなる。
人類史上、最も野心的なモデル訓練プロジェクトの一つである。
そして事前学習は単なる一つの段階に過ぎない。
フロンティアモデルには、以下のステップを完了するための時間と計算リソースも必要である:
したがって、AIBaseの当初の記事は、プロセス全体に少なくとも半年かかり、成熟したモデルが登場するまでに総計でほぼ1年に近づく可能性があると見積もっている。
その後、英国フィナンシャル・タイムズ紙の報道(ロイター通信の要約)は、このモデルがすでに事前学習段階に入っており、この段階は通常約3〜6ヶ月かかり、その後微調整と公開段階に入ると述べている。
両方の説明は同じ実際的な結論を指し示している。この規模のプロジェクトは長期的なインフラストラクチャ工事であり、最初の訓練クラスターが稼働した後にすぐにモデルが現れるものではない。
この規模の訓練は、単なる研究課題ではない。
それはインフラストラクチャと資本の問題でもある。
ByteDanceは、十分な財務力、消費者向け配信チャネル、クラウドインフラストラクチャ、データセンター容量、AIエンジニアリングチームを持ち、この規模のプロジェクトに真剣に取り組むことができる数少ない中国のテクノロジー企業の一つである。
当社公式のSeed組織は以下の領域をカバーしています:
ByteDanceのインフラストラクチャチームは、その業務を分散学習、強化学習システム、高性能推論、基盤モデル向けコンパイラ技術をカバーするものとして明確に説明しています。
また、採用資料にも以下の業務内容が明確に記載されています:
これらはまさに、数兆パラメータ規模でモデルを学習する際に極めて重要となるシステムエンジニアリング上の課題です。
AIBaseはまた、複数の大手フロンティアラボが利用可能なAI計算リソースの規模に関する第三者機関の推定値も引用しています。
記事に記載されたおおよその数値は以下の通りです:
これらの数値は監査済みの在庫データとして扱うべきではありません。
OpenAIとAnthropicは、自社施設、クラウドパートナー、確保済み容量における利用可能な全アクセラレータのリアルタイム数を公開管理しているわけではありません。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
DeepSeekの約6万基のアクセラレータという数値は、当初SemiAnalysisの推定に由来し、その後様々な報道で広く引用されています。これらの推定には、A100、H100、H800、H20など複数のアクセラレータの混在が含まれており、単一タイプのフリートではありません。
正確な在庫数よりも信頼できるのは、よりマクロな重要ポイントです:
フロンティアモデルの開発は、超大規模なアクセラレータ計算能力へのアクセスにますます依存するようになっており、モデル規模が拡大し続ける中で、超大型インフラを保有する企業と小規模ラボとの間の差は極めて大きなものになる可能性があります。
数兆パラメータへと急上昇しています。
H100換算の計算能力を使用することで計算に関する議論は理解しやすくなりますが、ByteDanceが必ずしも単一タイプのアクセラレータに依存するわけではありません。
大手AI企業は以下を組み合わせて使用できます:
新しいアクセラレータは、同じトレーニング計算量を完了するために必要な物理的なGPU数を変えることができます。
ソフトウェアも同様に重要です。
以下の領域での改善:
これらは、モデル全体の規模とトレーニングコストの関係を大きく変える可能性があります。
したがって、「Xモデルには正確にY枚のGPUが必要」という表現は、常にシナリオの仮定として捉えるべきであり、固定された法則ではありません。
情報源は主に、この計画を豆包のインテリジェンスレベルを世界のフロンティアに押し上げる試みとして位置づけています。
これはおそらく動機の一部に過ぎません。
より大きな基盤モデルは、ByteDanceのAIエコシステムの複数の部分を支える可能性があります。
豆包は、ByteDanceが中国市場で展開する主要な消費者向けAI製品の一つです。
より強力な基盤モデルは以下を向上させることができます:
超大規模モデルはまた、Seedチームに新たな研究プラットフォームを提供し、以下を探求することができます:
ByteDanceはまた、エンタープライズサービスやクラウドサービスを通じてモデル能力を商業化することもできます。
したがって、フロンティアモデルは消費者向けチャットボット以外にも潜在的な価値を持ちます。
AIBaseの記事における最後の問題が最も重要です。
トレーニングコストが極めて高いモデルが、それに見合うリターンを生み出せるでしょうか?
フロンティアラボは最終的なトレーニング実行のためだけに支払うわけではありません。
総支出には以下が含まれます:
その後、モデルは以下のいずれかの組み合わせを通じて価値を生み出さなければなりません:
パラメータ規模は、許容可能な推論コストで有用な能力に変換される場合にのみ経済的意味を持ちます。
これが、現在のフロンティアモデルが単なる総パラメータ数ではなくスケーリング効率をますます重視する理由です。
例えば、Kimi K3は総パラメータ数が2.8兆ですが、トークンあたりの活性化パラメータはわずか1040億です。月之暗面は、前世代と比較してアーキテクチャのスケーリング効率が向上したと述べています。
したがって、本当の競争は:
誰が最も多くのパラメータを持つか?
ではなく、むしろ:
誰が最小のリソースで最強の能力を生み出せるか?

持続可能な学習・推論コストで、最も有用なインテリジェンスに変換できるか?
AIBaseは『晩点LatePost』の報道を引用し、ByteDanceが5兆パラメータ超のモデルについて議論していると報じています。同日遅くに、ロイターは『フィナンシャル・タイムズ』を引用し、ByteDanceが最大10兆パラメータになる可能性のあるモデルの事前学習をすでに開始していると報じました。ByteDanceは正確な数値を公式に確認していません。
情報源は、このモデルがByteDanceの豆包エコシステムを強化すると予想していますが、ByteDanceは報道されたモデルがどのように展開されるかを正式に発表していません。フロンティアモデルは、エンタープライズAPI、エージェント、研究、およびByteDanceのその他の製品もサポートする可能性があります。
必ずしもそうとは限りません。総パラメータ数はモデル品質を直接決定するものではありません。アーキテクチャ、活性化パラメータ、学習データ、後続学習、強化学習、推論時の思考、ツール使用がすべて同様に重要であり得ます。
月之暗面は公式に、Kimi K3の総パラメータ数が2.8兆、活性化パラメータが1040億であると発表しています。スパース混合エキスパート(MoE)アーキテクチャを採用しています。
阿里巴巴とロイターの報道によると、阿里巴巴のQwen3.8-Maxの総パラメータ数は2.4兆です。これも、トークンごとに全パラメータを活性化するのではなく、スパースモデル設計に基づいています。
情報源は、約3500万H100 GPU・日に相当する大まかなシナリオを示しています。例えば、10万枚のH100で347日間、または100万枚のH100で約35日間です。実際の必要量は、アーキテクチャ、精度、利用率、トークン数、ハードウェア、学習効率によって大きく変動する可能性があります。
OpenAIはGPT-5.6のパラメータ数を公開していません。GPT-5.6のパラメータ数に関するいかなる主張も、推測の域を出ません。
あるモデルとの直接的な数値比較は
報道によると、ByteDanceのモデルに関する情報は現時点では依然として推測の域を出ない。
現時点では正式なリリース日は発表されていない。ロイター通信は英フィナンシャル・タイムズの報道に基づき、このモデルは事前学習段階にあり、この段階には数か月かかる可能性があり、その後にファインチューニング、評価、デプロイが行われると報じている。
報道によると、ByteDanceは現在公開されている中国のモデルを上回る規模の超大型基礎モデルを準備している。AIBaseと晚点LatePostは当初、このプロジェクトを5兆パラメータ超と説明していたが、当日のその後のロイター/フィナンシャル・タイムズの報道では、このモデルは10兆パラメータに達する可能性があり、すでに事前学習段階にあるとされている。
このような規模のプロジェクトには、膨大な計算リソースが必要となる。情報筋が例示したH100計算量は約3500万GPU日相当だが、実際のトレーニング要件はアーキテクチャ、アクティブパラメータ、ハードウェア世代、利用率、トレーニング効率によって異なる。
より大きな問題は、ByteDanceが最大のモデルを構築できるかどうかではない。総パラメータ数は、特にスパース混合専門家(MoE)システムにおいては、知能を測る不完全な指標である。
真の試練は
ByteDanceが兆単位の計算量を、性能が顕著に優れ、サービスを支えるに足る効率を持ち、その背後にあるインフラストラクチャを正当化する価値を持つモデルに変換できるかどうかにある。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



