For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/claude-code-feels-worse-model-vs.md.
基礎となるモデルが変わっていなくても、Claude Codeが時には能力が低下したように感じられることがあります。本稿では、モデル選択と努力レベルの違いを解説し、努力がファイル読み取り、テスト、ツール呼び出し、タスク完了にどのように影響するか、またいつ努力レベルを上げるべきか、モ...
Claude Code の出力結果が弱いと感じたとき、多くの開発者はすぐにより大規模で高価なモデルに切り替えようとします。
この反応は理解できるものの、多くの場合、誤った設定に対して行われています。
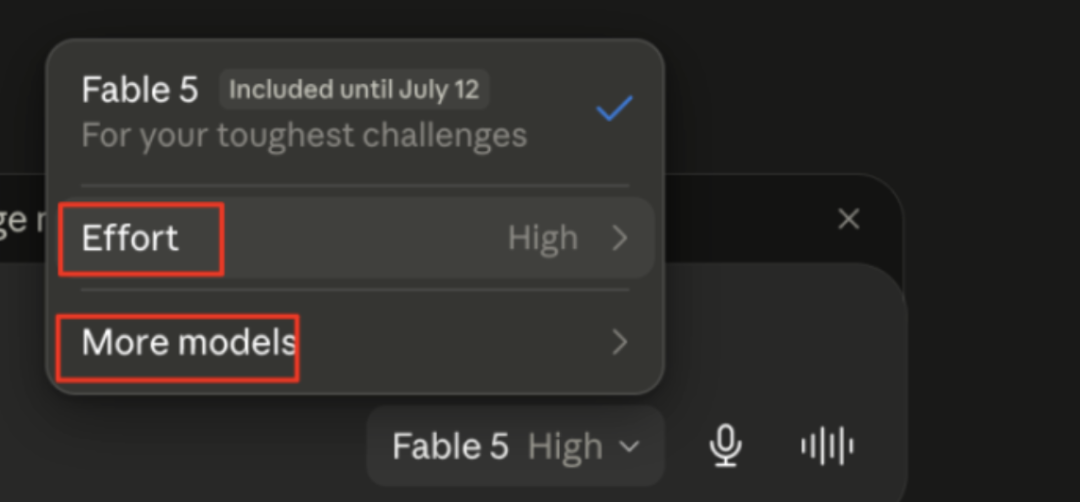
Claude Code には出力を改善できる2つのコントロール項目があります。モデル と 努力レベル です。これらは関連していますが、役割が異なります。モデル選択はシステムの基盤となる能力を変更するものであり、努力レベルは Claude が現在のタスクにどれだけの作業量を費やすかを調整します。
この違いにより、モデル自体は変わっていないにもかかわらず、Claude が突然緻密さを欠くように感じられる理由が説明できます。また、高努力レベルでの小規模モデルが、低努力レベルでの大規模モデルの性能を上回ることがある理由も説明できます。
この混乱は、開発者がClaude Codeの動作に変化を感じたときに特に顕著になります。
ユーザーからは、Claudeが本来読むべきファイルを読み飛ばしたり、テストの実行を避けたり、複数ステップの作業の途中で止まったり、あるいは自律的に調査する代わりにユーザーに追加情報を求めたりするといった報告が寄せられています。
広く議論されたGitHub issueでは、Claude Codeが「複雑なエンジニアリングタスクには信頼できない」と表現されています。原著記事で引用された分析では、数千のセッションを調査し、推論または実行作業量の急激な低下が報告されています。
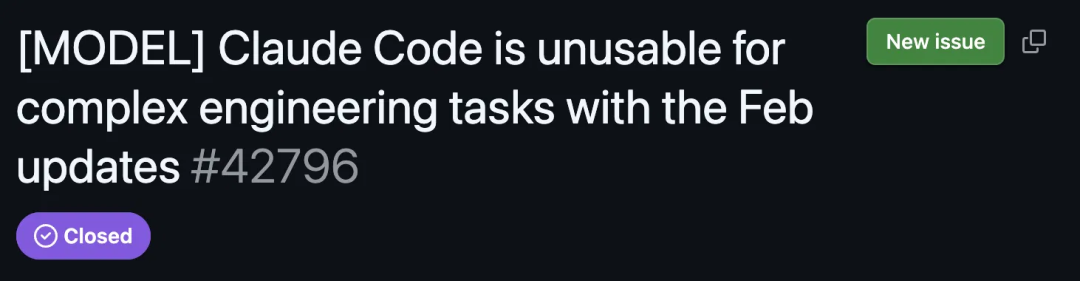
多くのユーザーは当初、自分のプロンプト、リポジトリの指示、またはローカル設定に問題があると考えました。原著記事によれば、より直接的な原因はデフォルトの努力レベル設定の変更でした。
レイテンシを低減するため、Anthropic は一部のClaude Codeユーザーのデフォルト努力レベルを一時的に high から medium に引き下げました。モデルの重みが弱くなったわけではありませんが、Claudeは各タスクに費やす時間、トークン数、ツール呼び出しの回数が少なくなるように促されました。
その影響は誤解されやすく、以下のように現れます:
Anthropic はその後、影響を受けたユーザーに対してより高いデフォルト設定を復元しました。しかし、その時点でこの出来事は重要な見解を示していました。モデル自体に変化がなくても、努力戦略が変わると、モデルは「賢くなくなった」ように感じられるのです。
Anthropic の説明は、実用的な一言に集約できます。
モデルは頭脳を変える。努力の程度は、その頭脳が現在のタスクにどれだけ徹底的に取り組むかを決定する。
モデルは、固定された訓練済みの重みによって定義されます。
訓練が完了すると、これらの重みによって、モデルの一般的な知識、学習されたパターン、推論能力、プログラミング経験、能力の範囲が決まります。プロンプト、リポジトリファイル、CLAUDE.md、コンテキスト内のドキュメントはモデルを導くことはできますが、これらの重みを書き換えることはできません。
つまり、モデル選択は主に次の質問に答えるものです。
このモデルはこの種の問題を解決できるか?
あるライブラリがモデルの訓練データのカットオフ日以降にリリースされた場合、現在のセッションでドキュメントを提供してモデルに使用させることはできます。しかし、これによってモデルにそのライブラリが永続的に学習されるわけではありません。関連する知識は現在のコンテキスト内にのみ存在します。
同じ制限により、モデルが存在しないAPIを自信を持って捏造する理由も説明できます。モデルは、関数の有効性を保証する内部データベースを照会しているのではなく、学習されたパターンに基づいて最も可能性の高い後続の内容を生成しているのです。
Claudeがコードやテキストを処理する前に、入力はトークンに分割されます。
例えば、次のようなコード行です。
const x = await fetch(...)
これはモデルの語彙表からトークンIDに変換されます。モデルは人間のように文字を読み取るのではなく、これらの数値表現を使用して処理を行います。
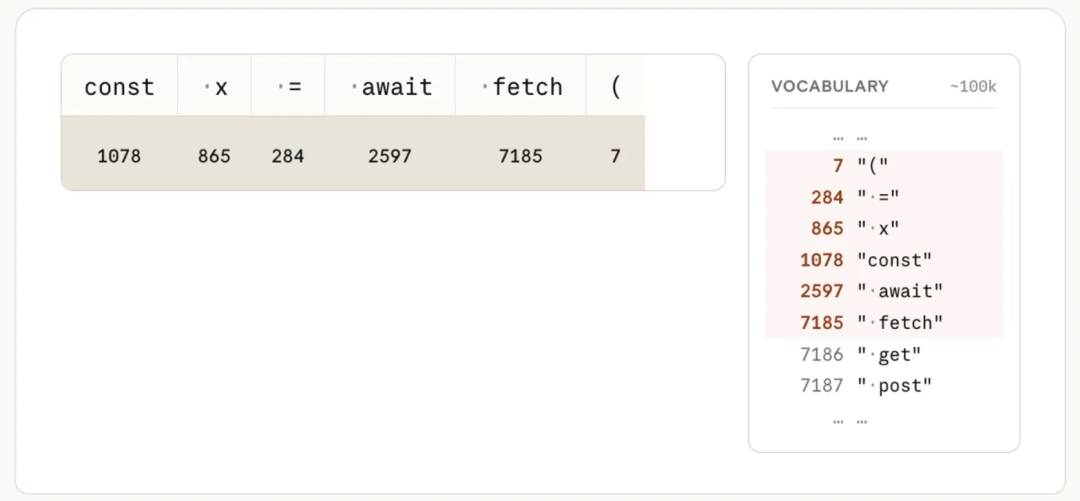
その後、モデルは一度に1つのトークンを予測します。各トークンが生成されるたびに、シーケンスが再処理されて次のトークンが予測されます。
この反復的な生成プロセスは、レイテンシとコストの主な要因の1つです。能力の高いモデルはより良い予測を生成できますが、だからといってモデルが自動的にすべてのファイルをチェックしたり、すべてのテストを実行したり、すべての長いタスクの各フェーズを完了し続けるわけではありません。
このような動作こそが、努力が発揮される場面です。
多くのユーザーは、努力度が高いことを「モデルにもう数秒考えさせる」ことだと解釈しています。
この解釈は不完全です。
Anthropicの努力パラメーターは、モデルが全体としてトークンを消費し、作業を実行しようとする意欲に影響を与えます。これは以下に影響します:
低努力度では、Claudeは速度とトークン効率を最適化します。最も明白なファイルのみを読み取り、狭い範囲の修正を行い、素早く返す可能性があります。
高努力度では、Claudeは周辺コードをチェックし、設定を読み取り、テストを実行し、結果を検証し、タスクがより完了状態になるまで継続する傾向があります。
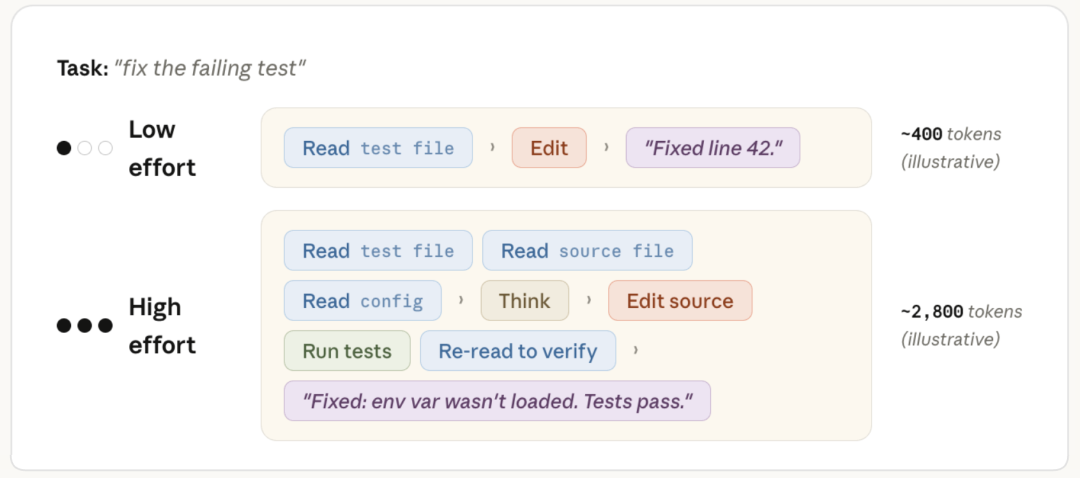
Anthropicガイドの図表では、説明用の例が使用されています:
具体的な倍率は固定ルールではありません。投入は行動シグナルであり、厳格なトークン予算ではありません。タスクが異なれば、消費パターンも異なる可能性があります。
重要なのは、追加のトークンが隠れ推論にのみ使用されるわけではないということです。トークンはファイルの読み取り、ツールパラメーターの生成、検証ステップの実行、より完全な応答の作成にも使用されます。
これにより、一見直感に反する結果が得られます:
十分なコンテキストを持ち、投入度が高い小規模モデルは、浅い処理しか許されていない大規模モデルよりも優れたパフォーマンスを発揮できる。
2人の開発者を想像してみてください:
エキスパートの方が直感に優れているかもしれませんが、ゼネラリストの方が証拠を収集する機会が多いです。
これはモデル能力と投入の違いに似ています。
大規模モデルはより高い品質上限を確立します。より高い投入は、モデルが現在のタスクでその上限に向かってどこまで進もうとするかを決定します。
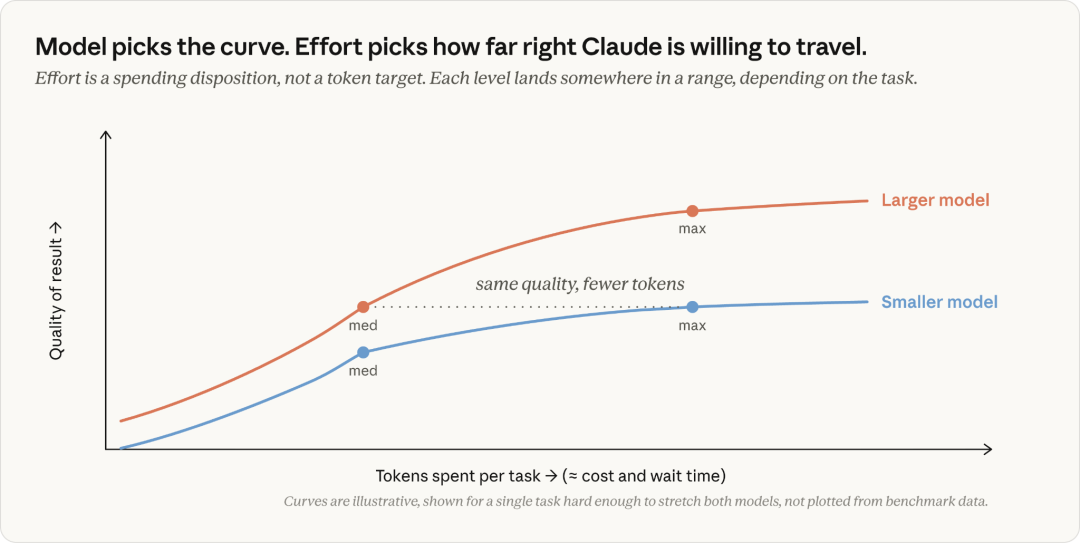
これはモデルサイズが重要でないことを意味するわけではありません。投入に関係なく、小規模モデルの能力を超えるタスクも存在します。モデルはトークンを多く費やすだけでは、欠けている能力を補うことはできません。
これは、モデルを大きくすることが常に最初の選択肢や最も安価な解決策ではないことを意味します。
Anthropicの最も有用なアドバイスは、診断フレームワークです。
Claudeが悪い結果を生み出した場合、すぐにモデルを変更しないでください。まず失敗のタイプを特定します。

設定を変更する前に、タスク自体を検証します。
質問:
CLAUDE.md は正確ですか?多くの場合、モデルの問題のように見えるものは、実際にはコンテキストの問題です。
モデルが不完全な要件、古い指示、または間違ったファイルを取得した場合、より高い投入もより大きなモデルも問題を確実に解決できません。
Claudeが以下のような場合、問題は投入不足である可能性が高いです:
これらの場合、投入レベルを上げる必要があります。
モデルはすでに十分な能力を持っている可能性があります。
必要なのは、タスクをより徹底的に完了する必要があるという、より強いシグナルだけです。
以下の場合、問題はモデル自体にある可能性が高いです:
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
これらの場合、より強力なモデルに切り替えてください。
より高い努力は同じ重みに発揮する余地をより多く与えますが、強い能力セットで重みを置き換えるわけではありません。
具体的なモデルラインナップとデフォルト設定は時間とともに変化するため、常にAnthropicの最新ドキュメントを確認してください。実用的な選択ロジックは、特定のモデル名よりも長持ちします。
以下のタスクでは、通常、Sonnetなどの高速なモデルで十分です:
タスクが複数のファイルにまたがる場合や検証が必要な場合は、より高価なモデルに移行する前に、まず努力レベルを上げてください。
以下の場合、Opusなどのより強力なモデルが適切です:
利点は単により多くのトークンだけではありません。より大きなモデルはより強力なパターンを学習しており、より高い能力上限を持っている可能性があります。
元の記事では、Fableは他のモデルがまだ行き詰まった場合に呼び出すエキスパートモデルとして説明されています。
このようなモデルは、以下のタスクに最も価値があります:
最高能力のモデルは最も高いトークンコストも持つため、その追加能力が結果を変えることができる場合にのみ使用してください。
| タスクタイプ | 開始モデル戦略 | 推奨努力レベル |
|---|---|---|
| 名前変更、フォーマット、小規模テキスト編集 | 高速またはバランスモデル | 低または中 |
| 明確なテストがある狭いバグ | バランスモデル | 中 |
| 複数ファイルのバグ修正 | バランスモデル |
| 高 |
| 要件が明確な大規模リファクタリング | バランス型またはより強力なモデル | 高または非常に高 |
| 不明確なアーキテクチャの失敗 | より強力なモデル | 高 |
| 長期間の自律的なコーディングワークフロー | 強力なモデル | 非常に高または最大 |
| 徹底的な調査後も繰り返し失敗する場合 | より強力なモデルに切り替え | 検証に十分な高さを維持 |
これは出発点であり、固定ルールではありません。
最適な設定は以下に依存します。
プロンプトごとに努力レベルを変更し続けると、コストとレイテンシの予測が困難になります。
Anthropicは、選択したモデルのデフォルトの努力レベルから始め、その後、努力レベルをより広範なワークの好みに合わせて調整することを推奨しています。
例えば:
素早い質問や大量のサブタスクには低い努力レベルを使用します。
通常の開発には中間の努力レベルを使用します。
難しいコーディングやエージェントワークフローには高い努力レベルを使用します。
追加の慎重さが必要な場合にのみ、xhigh または max を使用します。
APIユーザーにとって、effort パラメータは可視テキスト、ツール呼び出し、ツールパラメータ、拡張思考に適用されます。単一の隠れた推論予算に限定されません。
これにより、effort はモデルがどれだけの作業を試みるかを直接操作できるコントロールとなります。
元の記事では、Claude Code の ultracode モードについても言及されています。
重要な考え方として、一部の長時間タスクは複数のエージェントスレッドから恩恵を受ける可能性があります。1つのClaudeインスタンスが大規模タスクの各部分を順次チェックする代わりに、コーディネーターが独立した作業を専用エージェントに委任できます。
例としては以下が挙げられます。
AnthropicのManaged Agentsドキュメントでは、エージェントが独立した会話履歴を持ち、並行して操作できるマルチエージェントセッションについて説明されています。これにより、タスクが適切に分解されていれば、カバレッジを向上させ、完了時間を短縮できます。
マルチエージェント実行が自動的に優れているわけではありません。
以下の増加を招く可能性があります。
利用可能だからという理由ではなく、タスクに独立した作業フローが含まれる場合にのみ使用してください。
より広範な示唆として、AIコーディングはモデルランキングを超えつつあります。
従来、ワークフローはシンプルでした。
現代のエージェントコーディングでは、より積極的なスケジューリングが必要です。
チームは以下を使用する可能性があります。
これは、検索ボックスを使用するよりも、技術チームを管理することに近くなっています。
このシステムを運用する人は、以下を理解する必要があります。
目標は最も多くのトークンを消費することではなく、結果が受け入れられる確率を高める場所にトークンを費やすことです。
Claude Codeが弱い結果を生成した場合、以下の順序でトラブルシューティングを行います。
モデルの選択は、基礎となる訓練済み重みを変更し、能力範囲全体を変えます。Effort は、Claude が現在のタスクで推論、ファイル読み取り、ツール呼び出し、テスト、検証などにどれだけの作業を投入するよう促されるかを制御します。
一部のタスクでは可能です。十分なコンテキストと高い努力レベルを持つ小さなモデルは、低い努力レベルの大きなモデルよりも深く調査できる場合があります。ただし、努力は真の能力限界を突破することはできません。
Claude が低い努力レベルで実行されているか、タスク範囲が明確に定義されていないか、必要なツールやコンテキストが不足している可能性があります。まずプロンプトとリポジトリの説明を確認し、Claude が利用可能な検証を完了する前に停止した場合、努力レベルを上げてください。
Claude が正しいコンテキストを持ち、タスクを明確に調査し、関連するチェックを実行したにもかかわらず、誤った結論に達した場合にモデルを切り替えます。単に作業をスキップしただけの場合は、努力レベルを上げることが優先すべきより良いステップです。
同じではありません。Anthropic は努力を厳格なトークン制限ではなく、行動的なシグナルとして説明しています。これは、Claude が応答、ツール呼び出し、関数パラメータ、拡張思考にトークンを投入する意欲の度合いに影響を与えます。
日常的なタスクにはデフォルトまたは中間の努力レベル、難しいコーディングやエージェント的なタスクには高努力レベル、長時間実行される、または特に要求の厳しいワークフローには非常に高または最大努力レベルを使用します。自身のタスクに基づいてコストとレイテンシを再評価してください。
元の記事では、ultracode は Claude Code の高強度モードとして説明されており、非常に高い努力レベルを組み合わせ、必要に応じて複数のエージェントの調整を可能にします。製品の動作は変更される可能性があるため、特定の実装に依存する前に、現在の Claude Code のドキュメントを確認してください。
いいえ。努力レベルはリクエストまたはセッションの動作のみを変更します。モデルの重みを更新したり、Claude に新しい知識を永続的に教えたりすることはありません。
モデルと努力度: Anthropic によるClaude Codeにおけるモデル選択と努力度に関する公式説明。
Claude 努力度ドキュメント: 努力度、対応モデル、API動作に関する公式ドキュメント。
正しいClaudeモデルの選び方: Anthropic による能力、コスト、タスクタイプに基づくモデル選択ガイド。
Claude Code 変更履歴: Claude Codeの変更点とデフォルト設定に関する公式リリース履歴。
Claude 管理型エージェントのマルチエージェントセッション: 複数のClaudeエージェントを調整するための公式ドキュメント。
オーケストレーションパターンの構築: Anthropic による高努力度とマルチエージェントオーケストレーションを組み合わせた使用ガイド。
Claude Code GitHub リポジトリ: Claude Codeの公式ソースコードリポジトリ、問題追跡、変更履歴。
基礎となるモデルが変更されていなくても、Claude Codeの能力が低下しているように感じられることがあります。その原因は、努力度の設定が低すぎる、コンテキストが不完全、ツールが不足している、またはタスクの範囲が不明確である可能性があります。
モデル選択が能力の上限を決定します。努力度は、Claudeがファイルの読み取り、ツールの呼び出し、テストの実行、作業の検証を通じて、その能力をどの程度活用するかを決定します。
まずは入力内容の改善から始めてください。Claudeが可能な作業をスキップする場合は努力度を上げてください。タスクを十分に調査しても問題が解決しない場合は、モデルを切り替えてください。
最適なClaude Codeの構成は、必ずしも最大のモデルではなく、適切な努力度、コンテキスト、ツール、タスク検証のもとでの正しいモデルです。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



