For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/claude-code-loop-engineering-four-ways.md.
Claude Codeの4つのループ設計(ターン型、目標型、スケジュール型、プロアクティブ型)を整理し、トリガー、検証条件、権限、予算、停止条件を解説します。
編集が成功したという理由だけで、UI変更が完了したと宣言してはいけません。
いずれかのチェックに失敗した場合は、問題を修正し、ステップ1から再実行する。
核心となる考え方は、表現そのものではなく、このスキルによりClaudeが人間のレビュー担当者と同じエビデンスを取得できるようにすることにある。
定量的なチェックは特に有効である:
検証プロセスがより定量化可能であればあるほど、人間による介入の頻度は低下する。
1回の操作では不十分だが、終着点を明確に記述できる場合に、目標ベースのループ機構が特に有効となる。
Claude Codeは、オペレーションエージェントに結果が「十分良い」かどうかを自己判断させるのではなく、毎回の操作後に独立した評価器を使用する。
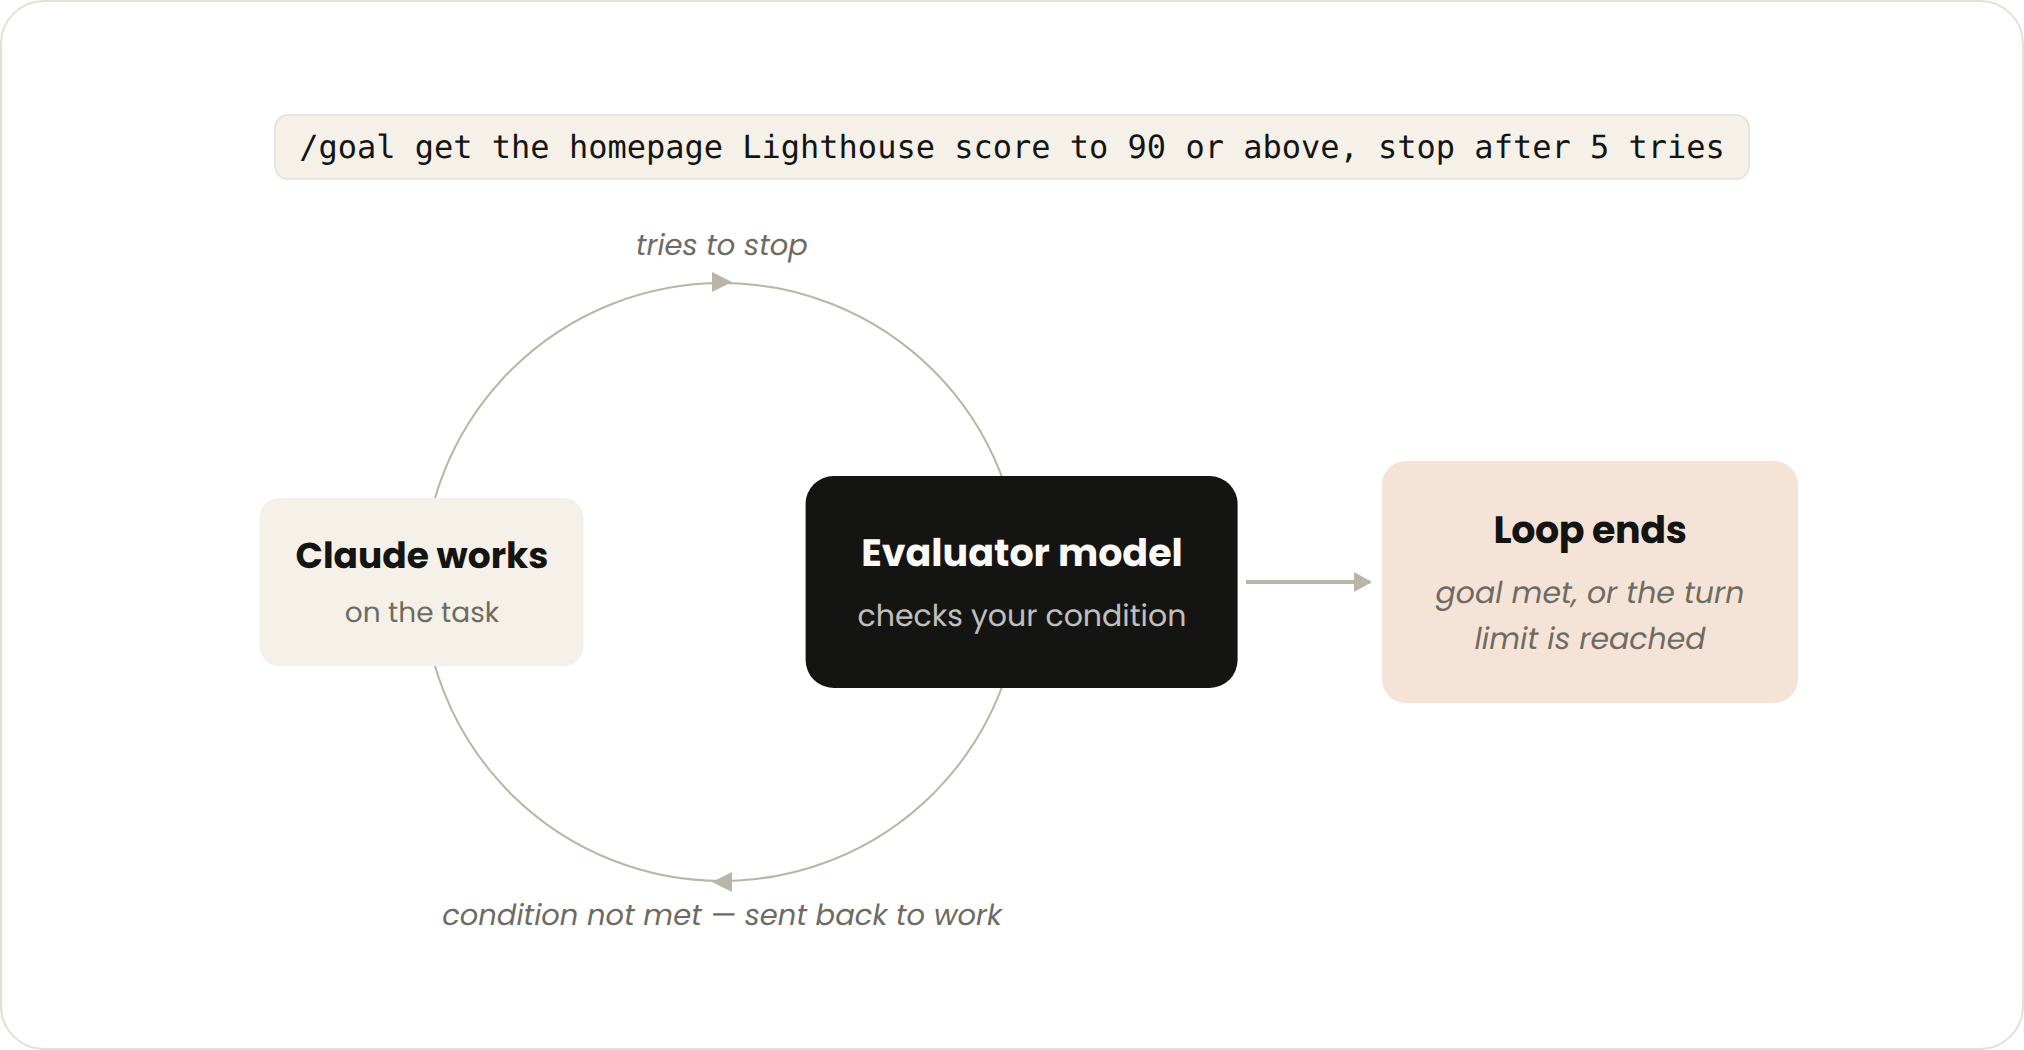
ユーザーが現在のセッションで目標を開始する。
以下のいずれかの場合にループは終了する:
目標ベースのループは、検証可能な終着点を持つタスクに適している。例えば:
Anthropicの公式サンプルは以下の通り:
/goal トップページのLighthouseスコアを90以上にし、5回試行したら停止する。
もう一つの実用的なサンプル:
/goal test/authディレクトリのすべてのテストに合格し、lintステップでエラーが出ないようにする
現在のClaude Codeドキュメントによると、/goal ディレクティブにはClaude Codeバージョン2.1.139以降が必要である。
Claudeが1ラウンドの操作を完了すると、軽量で高速な評価器モデルが条件が達成されたかどうかをチェックする。
条件が満たされていない場合は、自動的に次のラウンドの操作が開始される。条件が満たされた場合は、現在の目標がクリアされ、セッションの制御がユーザーに戻される。
この分離が重要なのは、作業モデルが自身の出力の唯一の評価者となるべきではないからである。
効果的な完了条件は以下を備えるべきである:
弱い目標:
/goal ホームページを改善する
「改善する」という言葉では、測定可能な終着点が定義されていない。
強い目標:
/goal モバイルのLighthouseパフォーマンススコアを少なくとも90に向上させ、
アクセシビリティを95以上に維持し、5回試行したら停止する
弱い目標:
/goal テストを修正する
強い目標:
/goal test/paymentsディレクトリのすべてのテストに合格し、スキップされたテストがなく、
かつ npm run lint コマンドの終了コードが0であること
モデルは成功の意味を推測すべきではない。
/goal は権限を変更しない目標は複数のラウンドにわたって継続するが、すべてのツール呼び出しを自動的に承認するわけではない。
デフォルトの権限モードでは、Claudeはまだ許可されていないコマンドに対して一時停止と確認を求める可能性がある。
無人での目標実行の場合、Anthropicは、利用可能で適切な場合に、/goal を自動モードと組み合わせて使用することを推奨している。これは、許可されたツール、リポジトリの境界、および潜在的な副作用をレビューした上で行うべきである。
/loop と /schedule一部の作業は、前のラウンドの完了によってトリガーされるのではなく、時間によってトリガーされる。
タスクは同じままでも、入力が変化する:
各実行は、設定された時間間隔またはスケジュールによって開始される。
ローカルループは、ユーザーがキャンセルするか、環境を閉じるか、監視タスクが完了したときに停止する。
クラウドルーチンは、一時停止または無効化されるまで、その設定に従って実行され続ける。
時間ベースのループは以下に適している:
公式サンプルでは /loop を使用:
/loop 5m プルリクエストを確認し、レビューコメントに対処し、失敗したCIを修正する
このプロンプトは設定された間隔で再実行される。
ローカルループは、現在のマシンとセッションに依存する。コンピューターがシャットダウンされるか、プロセスが停止すると、ループも停止する。
ノートパソコンを閉じた後も実行を続ける必要がある作業には、Claude Codeは /schedule を使用してクラウドルーチンを作成できる。
アクティブなルーチンは以下のように開始される可能性がある:
/schedule 毎時: #project-feedback の新しいバグレポートを確認する
Claude Codeルーチンは、Anthropicが管理するクラウドインフラ上で実行され、以下の方法でトリガーできる:
本稿執筆時点では、ルーチンは研究プレビュー段階にあるため、動作、制限、APIインターフェースは変更される可能性がある。また、利用可能性は関連するClaudeプラン、組織ポリシー、およびウェブ版Claude Codeが有効になっているかどうかにも依存する。
よくある間違いは、外部システムの変化速度よりもはるかに高い頻度でループを実行することである。
新しい問題が1日に数回しか発生しないのであれば、問題キューを毎分チェックしても意味がない。これにより、トークン使用量、ツール呼び出し回数が増加し——
ノイズが増えるだけで結果に影響はない。
ポーリング間隔を、想定される変化の頻度に合わせること:
| 外部変化のパターン | 妥当な初期ポーリング頻度 |
|---|---|
| 活発なプッシュ後のCIステータス | 5~10分ごと |
| チームフィードバックチャンネル | 30~60分ごと |
| 日次のSlackサマリー | 1日1回午前中 |
| 依存関係の更新 | 毎日または毎週 |
| ドキュメントの乖離 | 毎晩または毎週 |
これらは開始時の推奨であり、普遍的なルールではない。外部システムがサポートする場合は、ポーリングよりもイベントトリガーの方が一般的に優れている。
プロアクティブループは、前述の基本要素を組み合わせたものである。
無人で動作し、計画された作業や入ってくる作業に応答し、各タスク項目を定義されたフローに沿って進める。

Code の能動的ループ内容に関連し、その動作フロー(トリガー、実行、フィードバックなどの段階を含む)を直感的に示しており、ドキュメント内の「トリガー」「停止条件」などの内容と対応しています。](https://we0-cms.oss-cn-beijing.aliyuncs.com/cms-assets/image/2026/07/0106395e-ee08-41b8-bc17-2b28e0bbd11a-f55a5db1-fee1-4a0e-8ca9-96752a156eb0.png)
スケジュールされたタスク、APIリクエスト、GitHubイベント、メッセージ、問題、またはその他の外部シグナルが作業を開始します。
各独立タスクは、目標達成後に終了します。
周囲のルーチンは、無効化されるまで将来の作業を受け付け続けます。
能動的ループは、明確に定義された反復作業フローに適しています:
Anthropicの例は、Claude Codeのいくつかの機能を組み合わせたものです:
/schedule 新しいレポートを確認します。/goal 1回の実行で達成すべき内容を定義します。組み合わせた指示は次のようになります:
/schedule 1時間ごと:#project-feedback のバグレポートを確認する。

/goal:この実行で見つかった各レポートについて、
トリアージ、処理、応答が完了するまで停止しない。

バグ修正時は、並列作業ツリーで3つの解決策を探索し、
独立したレビュアーが検証するワークフローを使用する。
これはもはや単なる反復的なプロンプトではありません。狭いワークフロー向けの小さなオペレーティングシステムです。
動的ワークフローは、サブエージェントを大規模に調整するためのスクリプトです。
ClaudeはJavaScriptオーケストレーションスクリプトを作成し、実行環境がバックグラウンドでそれを実行します。中間結果はメインの会話コンテキストを満たすことなく、スクリプト変数に保持できます。
Anthropicはワークフローを以下のタスクに位置付けています:
現在のドキュメントによると、動的ワークフローにはClaude Codeバージョン2.1.154以上が必要です。数十または数百のエージェントを調整できるため、大規模な本番タスクを実行する前に、小規模なパイロットテストを実施する必要があります。
スケジュールタスク、オーケストレーション、フィードバックループ、作業キューは、新しいエンジニアリング概念ではありません。
真の変革は、コーディングエージェントがループにより深く参加できるようになったことにあります:
プロンプトは消えたわけではありません。より大きな制御システムの構成要素となったのです。
現在、より重要な設計上の問いは次のようになります:
丁寧に書かれたプロンプトは、停止条件の欠如を補うことはできません。
Anthropicは検証を繰り返し強調しています。つまり、Claudeが自身の出力を確認し測定できるようにすることです。
人間のエンジニアがブラウザアクセスなしでページの構築を求められたら、それは手探りで作業することになります。エージェントも同様です。
役立つ検証ツールには以下が含まれます:
終了コード0または1を返すスクリプトは、モデルにある要件が満たされているかどうかをゼロから推論させるよりも、一般的に安価で信頼性が高いです。
例えば:
npm test
npm run lint
npm run typecheck
組み合わせた検証スクリプトは次のようになります:
#!/usr/bin/env bash
set -euo pipefail

npm run typecheck
npm run lint
npm test
Claudeは変更のたびにこのスクリプトを実行できます。このループは、毎回受け入れプロセス全体を再解釈する必要がありません。
Anthropicはまた、新しいコンテキストを持つレビューアを使用することを推奨しています。
実装エージェントは自身の推論プロセスをすでに見ており、同じ仮定を繰り返す可能性があります。独立したレビューアはそのパスにそれほど制約されず、別の角度から結果を確認できます。
高価値の変更には、システムは以下を使用できます:
エージェントの数が多ければ良いというわけではありません。レビューの価値が追加コストを正当化できる場合にのみ追加します。
無限に続く可能性のあるループは、強力であると同時に危険です。
3つの主要な障害モードがあります。
各ラウンドで、入力トークン、出力トークン、ツール呼び出し、有料モデルの使用量が消費される可能性があります。
ラウンド数や予算の上限がない場合、オープンエンドのループはほとんど追加価値を生み出さずにコストを消費し続ける可能性があります。
Claude Agent SDKは以下をサポートしています:
max_turns / maxTurnsmax_budget_usd / maxBudgetUsd公式SDKドキュメントには次のように記載されています:
デフォルトでは、どちらの制限も設定されていません。
本番環境のエージェントには、明確な制限が合理的なベースラインです。
エージェントが同じファイルを繰り返し編集しても、新たなテスト合格や測定可能な改善が生まれない可能性があります。
システムが同じ失敗した解決策の異なるバリエーションをループで試している間でも、ログは活発に見えるかもしれません。
進捗がないことを示す有用なシグナル:
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
進捗が止まった場合、堅牢なループは実行を停止するかエスカレーションする必要があります。
反復により、欠陥のある解決策がより正確になるのではなく、より複雑になる可能性があります。
エージェントは誤った仮定の周りにレイヤーを追加し、一見ますます完全に見えるが、実際の動作からはますます遠ざかるコードを生成する可能性があります。
独立したレビュー、決定的テスト、明確なロールバックパスは、このような失敗を防ぐのに役立ちます。
実用的なループには、少なくとも3種類のゲートを含める必要があります。
完了状態は、テスト、スクリプト、評価器、または外部状態の観測によって確認可能であるべきです。
例:
少なくとも1つのハード上限を設定します:
1つの制限があれば、無限の失敗を有限の失敗に変えることができます。
システムが目標に向かって進んでいない場合に実行を停止します。
例えば:
連続3回の試行で新しいテスト合格がなく、
同じファイルが変更された場合、実行を停止し、障害を報告する。
本番レベルの実装では、指示だけに頼るのではなく、スクリプトやワークフロー状態でこれを追跡できます。
ループは、推論リソースを最も価値の高い段階に投入するように設計されるべきです。
Anthropicは以下のコスト管理手段を推奨しています。
小タスクにマルチエージェントワークフローは不要です。
以下の方法から始めてください:
/goal を使用。/loop または /schedule を使用。高速で低コストなモデルで処理可能なもの:
最強のモデルは以下に温存:
動的ワークフローは多数のエージェントを生成する可能性があります。
まずは小規模で実行:
バックログ全体。
試験運用により、トークン消費、ツールのボトルネック、よくある障害、不足しているガバナンスポイントが明らかになります。
プロセスが決定的である場合、コードを一度書いて、Claude に実行させるだけで済みます。
例:
時間ベースのループは、基盤システムの変化速度を反映すべきです。
間隔が短すぎるとコストが増加し、より良い結果にはつながりません。
Anthropic は消費状況を確認するためのいくつかのコマンドを提供しています:
/usage
このコマンドは、スキル、サブエージェント、MCP統合などの分野での最近の使用状況を表示します。
引数なしで /goal を実行すると、現在の目標のターン数とトークン消費が表示され、/workflows はワークフローエージェントの使用状況を表示し、エージェントを停止するための制御オプションを提供します。
利用可能性はClaude Codeのバージョンと有効化された機能によって異なる場合があります。
自動化は無制限のアクセスと同義ではありません。
Claude Codeは、どのツールやコマンドを実行できるかを制御する権限モードをサポートしています。
開発マシンでの自律的な作業のために、Anthropic は明確な許可ルールを保持するか、限られた一般的な操作を自動承認しつつも高リスクコマンドは制御するモードの使用を推奨しています。
権限をバイパスするモードは、隔離された環境でのみ使用すべきです。例えば:
ファイルの編集、シェルコマンドの実行、外部システムへのアクセス、プルリクエストの作成が可能なプロアクティブループには、以下も必要です:
目的はすべての人間の判断を排除することではなく、本当に判断が必要な決定に人的リソースを集中させることです。
以下の意思決定フローを参照してください。
制限された権限。
Anthropic は、あなた自身が現在ボトルネックとなっているタスクから始めることを推奨します。
3つの質問をしてください。
例:
有用な目標は、活動だけでなく状態を記述します。
良い例:
すべての支払いテストが合格し、TypeScriptエラーが残っていない。
悪い例:
支払いモジュールの改善を続ける。
タスクが毎時間、毎日、毎週、または既知のイベント後に発生する場合、ループやルーティンに適している可能性があります。
いずれかの答えが「はい」なら、最初のループの候補タスクです。
失敗したプルリクエストチェックを繰り返し修正するチームを想像してください。
現在のPRを確認し、失敗したCIテストを修正し、変更内容を説明してください。
開発者はCIが変わるたびに手動でこの操作を再実行します。
以下のことができるスキルを作成:
/goal 必要なすべてのCIチェックが合格、4回試行後に停止
セッションは複数回の修正試行を続けられます。
/loop 10m PRを確認し、新しいレビューコメントを処理し、
失敗した必須チェックを修正します。
エージェントが外部の変更を確認します。
プルリクエストイベントやスケジュールによってトリガーされるクラウドルーティンを作成します。
以下に制限:
進化は段階的です。各フェーズは、前のフェーズに信頼できるチェックができてから自動化を追加します。
「コードベースを改善する」は際限なく続く可能性があります。
観察可能な結果に分割しましょう。
テスト、スクリプト、または独立した評価者を使用しましょう。
単一のエージェントと強力な検証者は、調整が不十分な大規模ワークフローより優れている場合があります。
毎分のポーリングは本質的に応答性が高いわけではありません。
上限なしのループは高価な障害につながる可能性があります。
決定的な実行には、権限、フック、サンドボックス、隔離環境を使用しましょう。
同じエラーが繰り返し発生する場合、それを生み出したスキル、ルール、検証、ワークフローを改善しましょう。
ループエンジニアリングは、停止条件に達するまで、反復的なエージェントワークフローを設計することです。プロンプトの内容だけでなく、トリガー、検証、制限、権限、エスカレーションに焦点を当てます。
プロンプトの文言。
Anthropic はループをターンベース、目標ベース、時間ベース、プロアクティブに分類しています。
それらの主な違いは、新たなループを開始する仕組みと、作業をいつ停止するかを決定する主体や要因にあります。
/goalの役割とは?/goalは、現在のセッションに完了条件を設定します。各ラウンド終了後、独立した評価器がその条件が満たされているかを確認し、満たされていない場合は次のラウンドを開始します。目標が達成されるか、設定された制限に達するまでこのプロセスが続きます。
/loopと/scheduleの違いは何ですか?/loopはローカルマシン上で一定間隔ごとにプロンプトを繰り返し実行するため、マシンやセッションが停止するとループも停止します。一方、/scheduleはクラウド上の定期タスクを作成し、Anthropicが管理するインフラ上で実行され続けるため、ノートパソコンがオフの状態でも影響を受けません。
ワークフローに境界が設定されていない場合、ループの実行時間は予想以上に長くなる可能性があります。無人実行を許可する前に、定量化可能な完了条件、ハードなラウンド数やコスト上限、そして進捗がない場合の停止ルールを定義すべきです。
いいえ。通常のClaude Codeセッションと再利用可能な検証スキルで十分な場合が多いです。動的ワークフローや複数のエージェントは、大規模な並列処理や独立したレビューが必要なタスクにおいてより有用です。
最もシンプルなループタイプを使用し、日常的な作業には小さなモデルを選び、小規模な作業量で試験的に導入し、スクリプトで決定論的な推論を代替し、不要なポーリングを減らし、明確なラウンド数や予算の制限を設定しましょう。
権限、リポジトリ、認証情報、予算、停止条件、エスカレーションパスが厳格に管理されていれば、責任を持って実行できます。機密データや価値のあるデータを含む通常のマシンでは、権限をバイパスするモードを使用しないでください。
SKILL.mdに保存された再利用可能なプログラム指示、スクリプト、リソース。/goalの構文、評価動作、状態制御、要件に関するドキュメント。Claude Codeのループは単純なプロンプトの繰り返しではなく、トリガー、ツール、検証、権限、予算、停止条件が連携して機能する制御されたシステムです。
ラウンドベースのループは人間が後続の各ステップを管理し、目標ループは完了条件を評価器に委任し、定期ループはトリガーを委任します。プロアクティブループはこれらの基本要素を組み合わせて、繰り返し実行可能な無人ワークフローとします。
最も重要な改善点は、通常エージェントの数を増やすことではなく、既存のエージェントに信頼性の高い自己チェック機構を与え、完了基準を明確に定義し、進捗や予算が尽きたときにシステムを適切に停止させることです。
有用なループとは、永遠に実行できるものではなく、いつ停止すべきかを証明できるものなのです。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



