For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/claude-distillation-defenses-and-preserve-b64c5fd8.md.
Anthropicによると、新たな保護対策により、自社プラットフォーム上で蒸留実行者が収集するClaudeの推論量は約90〜99%削減されたといいます。10月12日の更新では、保護された推論の再利用制限、より強力な抽出分類器、反復的な試行のコストを高めるアカウント管理という3層の...
Anthropicによると、新たな保護対策により、自社プラットフォーム上で蒸留実行者が収集するClaudeの推論量は約90〜99%削減されたといいます。10月12日の更新では、保護された推論の再利用制限、より強力な抽出分類器、反復的な試行のコストを高めるアカウント管理という3層の防御を説明しています。
しかし、一般的な開発者にとっても実務上の影響があります。一部のインテグレーションでは会話履歴の再送方法を変更する必要があり、Claudeが応答する前にブロックされたリクエストでも料金が発生する場合があります。こうしたコストを理解するには、同社の不正利用対策の成果と、アプリケーションが実際に直面するAPIルールを分けて考える必要があります。
蒸留とは、別のモデルの出力を用いてモデルを訓練する手法です。これは正当な技術でもあります。開発者は自らのモデルを蒸留したり、利用許諾を得たデータを使用したりできます。Anthropicの報告は、すべての蒸留を不正利用として扱うのではなく、多くの場合で不正アカウントを伴う、無許可の抽出キャンペーンに焦点を当てています。
この文脈では、最終回答も有用な学習データですが、詳細な推論はさらに価値を持ち得ます。推論トランスクリプトは、中間的な判断、試行したアプローチ、修正の過程を明らかにします。これらは、生徒モデルがそれ以外では推測しなければならない情報です。
Anthropicは、事前学習済みのClaudeモデルをClaude Opus 4.8のトランスクリプトで訓練した実験を例示しています。得られたSWE-bench Verifiedスコアは次のとおりです。
| 学習素材 | 報告されたSWE-bench Verifiedスコア |
|---|---|
| 完全な推論を含むトランスクリプト | 80.4% |
| 要約された推論を含むトランスクリプト | 71.8% |
この実験では、差は8.6パーセントポイントです。この結果は、その訓練設定における推論トランスクリプトの価値を裏付けていますが、すべてのモデルやタスクで同じ規模の優位性があることを示すものではありません。
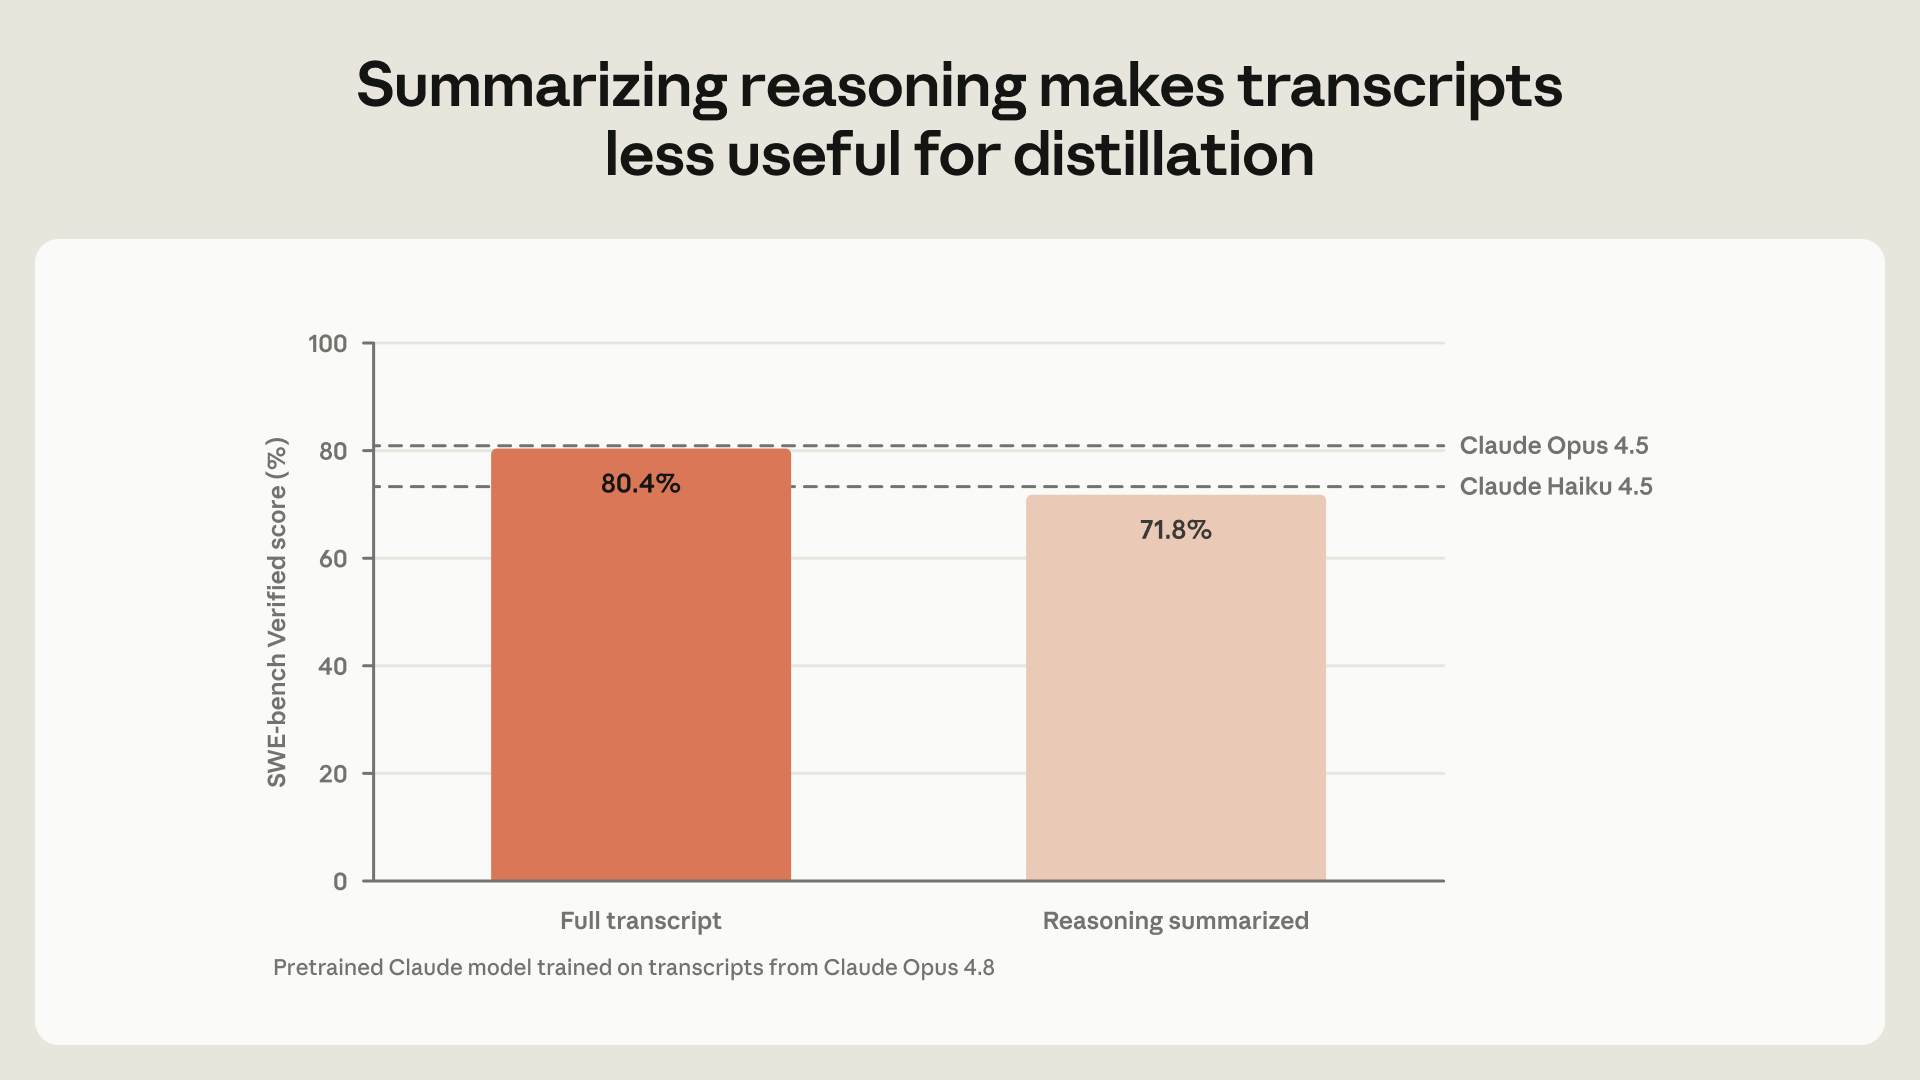
出典:Anthropic。棒グラフは、Opus 4.8のトランスクリプトで訓練された生徒モデルを示しており、参照線として表示された本番モデル同士の直接的なベンチマーク比較ではありません。
要約を表示することで受動的な収集は減少しますが、フォローアップリクエストを通じて隠された推論を引き出そうとする動機が生まれます。Anthropicによると、ある研究室は12,000種類の抽出リクエストを試験しました。また、20,000を超える不正アカウントを同時に管理していたと過去に報告されたネットワークを含め、大量のアカウントに活動を分散させるプロキシネットワークについても説明しています。
長時間に及ぶタスクでは、モデルは前のターンで生成した推論を引き継ぐ必要がある場合があります。APIは、その目的のために保護された思考ブロックを保持できますが、基礎となる推論を通常のユーザーが読めるテキストとして公開することはありません。
ここでアクセス制御の問題が生じます。Anthropicによれば、攻撃者は、推論を会話、モデル、またはアカウント間で移動させ、それを開示できる文脈を見つけようとしてきました。そのため、ブロックを保護するには、表示だけでなく再利用も制御する必要があります。
AnthropicはClaude Fable 5.1およびClaude Opus 5.5で保持された思考を導入しました。現在のドキュメントでは、主に次の2つの確認事項が説明されています。
プレフィックスチェックは、2026年8月31日00:00 UTC以降に作成されたアカウントではデフォルトで強制されます。より古いアカウントは、文書化されたコントロールを通じて強制を有効にできます。モデル互換性チェックはすべてのアカウントに適用されます。
研究発表では、Sonnet 5.5の推論に対する組織制限についても説明されています。現在のAPIドキュメントでは、より具体的なルールが示されています。Sonnet 5.5およびHaiku 5.5の思考ブロックは、文書化された強制が適用される場合、それを生成したアカウントまたはリンク済みアカウントでのみ機能します。開発者は、ルーティングやアカウント変更を実装する際、この互換性ドキュメントを参照すべきです。
一般的なアプリケーションの挙動によって、保護されたプレフィックスは変わる可能性があります。たとえば、新しいタイムスタンプでシステムプロンプトを再構築する、過去のツール出力を編集する、ツール説明を変更する、あるいは後続の思考ブロックを維持したまま以前のターンを要約するといった操作です。
デフォルトでは、無効なプレフィックスは400 invalid_request_errorを返す場合があります。文書化されたベータコントロールでは、thinking.block_binding.prefix_mismatch_behaviorをdrop_blockに設定することも可能です。この場合、そのリクエストでは無効な思考ブロックと後続の思考ブロックが破棄されます。これによりリクエスト自体は継続しますが、変更された履歴が修復されるわけではありません。
再送する履歴を安定させ、新しい情報はサポートされたパターンで追加してください。 会話の可視テキストを変更しつつ、その古い保護された推論をすべて再利用し続けられるという前提は、もはや安全ではありません。
Anthropicの第2層は、Constitutional Classifiersの研究を踏まえた2段階の分類器システムを用いています。社内および外部のレッドチームで抽出の試みを検証し、手法が成功した場合には防御を更新します。
同社によると、得られた蒸留対策は、その評価において0.1%未満の誤検知率を示しています。また、その堅牢性を生物兵器支援に対する防御と比較しています。これは同社の試験条件下での評価であり、特定ユーザーの正当なリクエストが決して拒否されないことを保証するものではありません。
システムは時間とともに変化します。Anthropicは、翻訳や特別に整形された出力を通じて保護された推論を明らかにしようとする手法にパッチを適用したと説明しています。公開された主張によれば、分類器は、同システムが対象とするモデルにおいて、9月の報告で説明された抽出技術を検出します。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
第3層は反復的な行動に対処します。抽出を執拗に試みるアカウントは、より厳しい利用制限を受ける可能性があり、関連アカウントが停止されることもあります。Anthropicは、キャンペーン開始から2時間以内の場合も含め、数万件のアカウントを停止したと報告しています。
Anthropicは9月24日以降、蒸留を含む、報告上の誤検知率が0.1%未満である一部のセーフガードカテゴリについて、モデル応答前にブロックされたリクエストへの課金も再開しました。出典では、生物学的な不正利用とフロンティアモデル開発のカテゴリも特定されています。この方針を、すべての拒否リクエストやあらゆる種類の安全フィルターに一般化すべきではありません。
Anthropicは、分類器の導入後、保持された思考の変更とあわせて、自社プラットフォームで抽出された推論トークンが10分の1から100分の1に減少したと推定しています。同社が測定するには抽出トークンが少なすぎる日もありました。
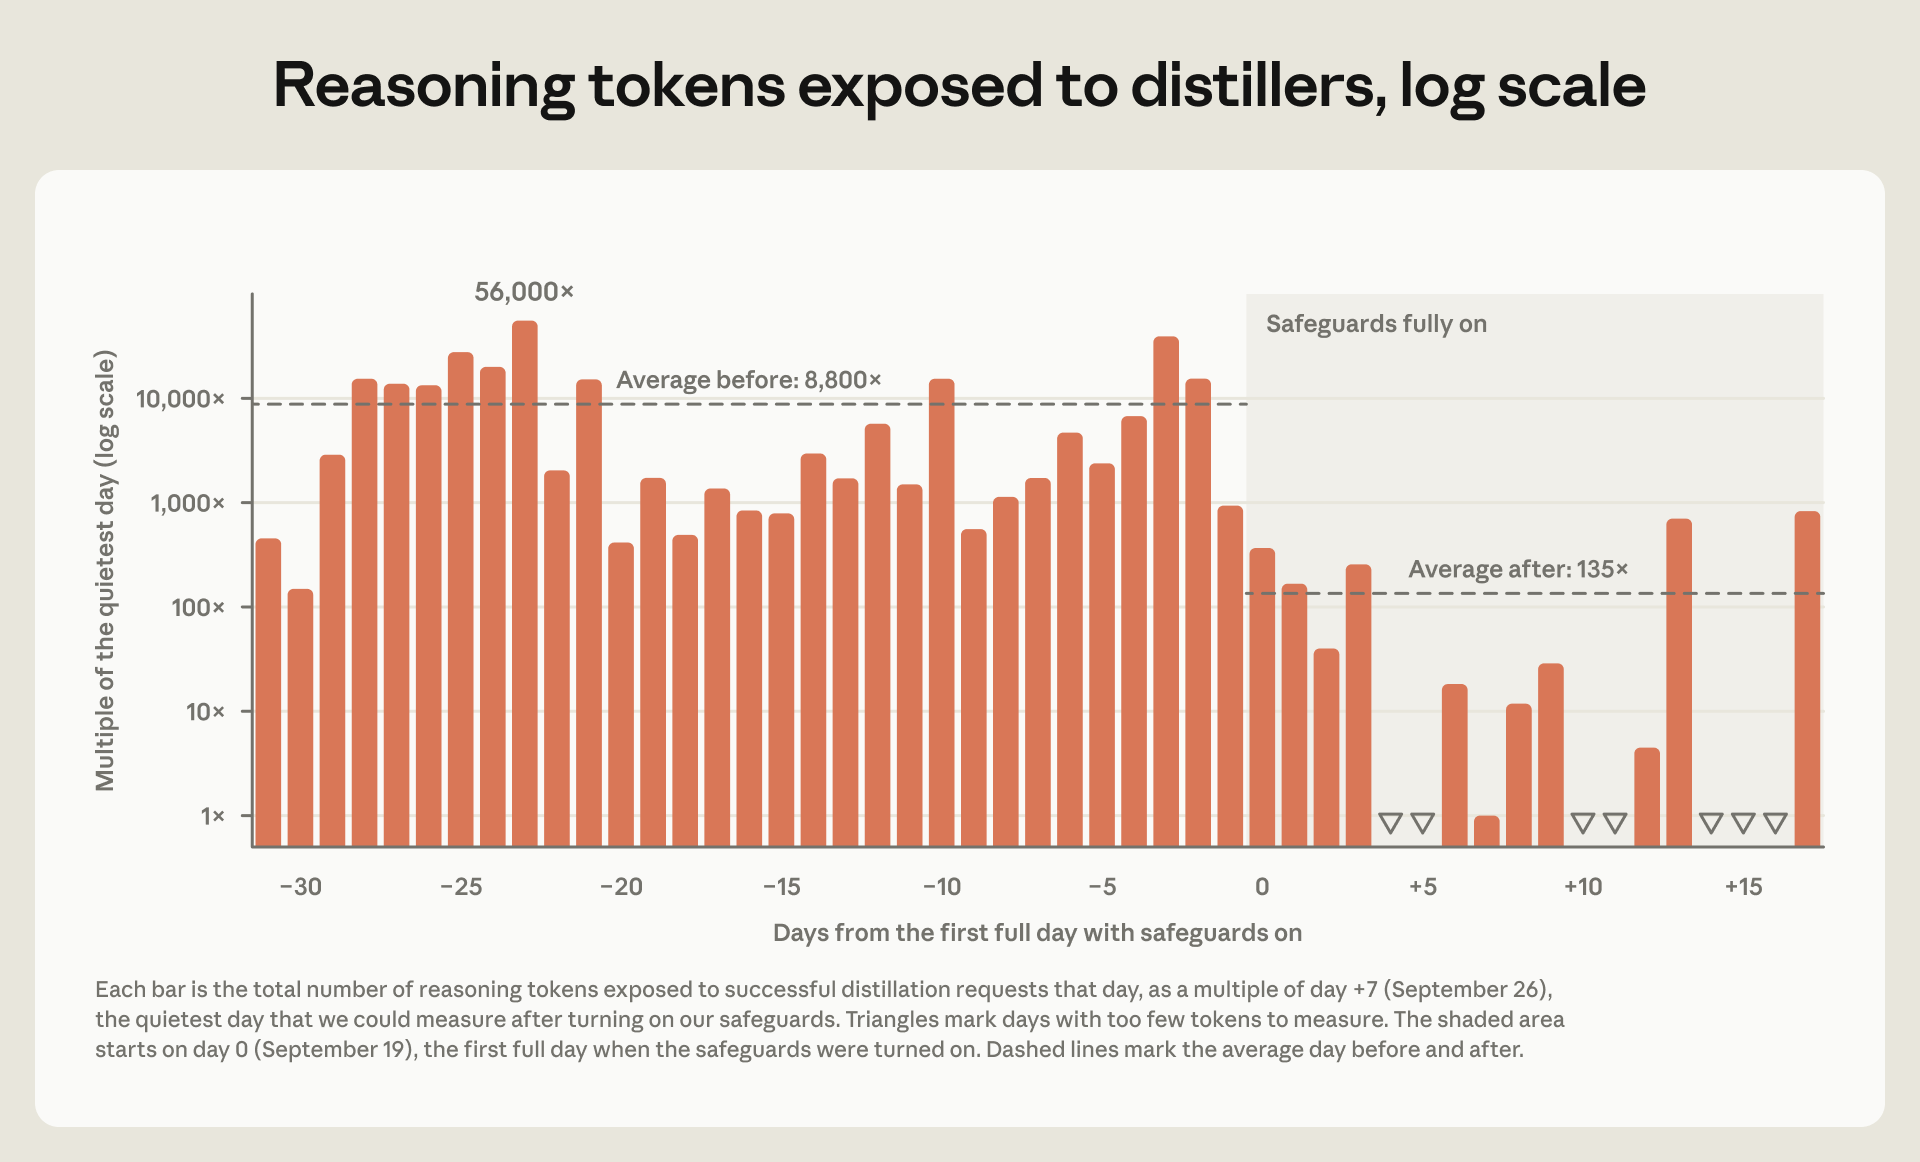
出典:Anthropic。縦軸は対数目盛であり、抽出量が少ない日を基準に正規化されているため、絶対トークン数ではありません。下向きの三角形は、測定に必要なトークン数が不足していた日を示します。
対象範囲が重要です。これらの数値は、Anthropicが自社プラットフォームについて推定したものであり、第三者の推論プロバイダー全体におけるすべての蒸留活動を測定したものではありません。同社はまた、完全に実装された防御を打破しようとする高度かつ持続的な試みはまだ観測しておらず、この効果がどの程度続くかは分からないとしています。
Anthropicは、この変更が一般ユーザーにとって完全に透明なものではなかったことを認めています。インテグレーションには更新が必要になる場合があり、正当なリクエストが誤分類される可能性もあります。また、そのような誤ったブロックであっても、影響を受けるカテゴリでは課金が発生するようになりました。
再利用可能な思考を失うことには別のコストもあります。モデルが作業を再構築しなければならない可能性があるためです。APIドキュメントで説明されているマルチターンのコーディングベンチマークでは、セッションごとに1回思考を破棄すると、最大エフォート時の出力トークンが20.1%増加しました。これは誤差範囲が大きい、特定ワークロードにおける推定であり、標準的な追加料金でも、すべてのアプリケーションに対する予測でもありません。
開発者にとって有用な区別は、読み取れない、または破棄された入力ブロックと、新たに生成された出力との違いです。破棄されたブロック自体には課金されませんが、推論の再構築によって追加の出力トークンが生成される可能性があります。プレフィックス不一致を監視し、アプリケーション固有のワークロードをテストすることは、成功した再試行にコストがないと仮定するよりも有益です。
Anthropicの用法では、別のモデルの訓練を目的として、Claudeの出力または保護された推論を収集する無許可のキャンペーンを指します。蒸留そのものは標準的な機械学習手法であり、開発者が必要な権利と許可を持つ場合には正当なものになり得ます。
いいえ。Anthropicは、保護対策の導入後に、自社プラットフォームで収集された推論が推定90〜99%減少したと報告しています。この数値は、すべてのプロバイダー、すべての攻撃、あるいは将来のあらゆる抽出手法を対象とするものではありません。
いいえ。アプリケーションが思考の再送と会話プレフィックスの保持に関する文書化されたルールに従う限り、妨げません。問題は、アプリケーションが元の文脈に紐付いた思考ブロックを送り続けながら、以前の文脈を変更したときに発生します。
文書化されたモデル互換性ルールで許可されている場合に限られます。ブロックを読めないモデルはそのブロックなしで実行されるため、より安価なモデルへ切り替えても、以前のモデルの推論が必ず保持されるわけではありません。
はい。Anthropicによると、選定されたセーフガードカテゴリでは、Claudeが応答する前にリクエストがブロックされた場合でも、9月24日から再び課金対象となりました。報告書は、これらのカテゴリにおける誤検知が正当な顧客に影響し得ることを明示的に認めています。
いいえ。これは、特定のマルチターンコーディング試験において、最大エフォート時にセッションごと1回思考を破棄した場合に報告された増加率です。影響は、エフォート、会話履歴、タスク、そしてインテグレーションがブロックを破棄する頻度によって異なります。
Anthropicの新しい防御は、保護された推論への制限、抽出分類器、反復的な不正利用への執行を組み合わせたものです。同社は、自社プラットフォームで収集された推論が大幅に減少したと報告する一方、攻撃者が適応する可能性も認めています。
Claude API開発者にとって直近の課題は、有効な会話履歴を維持し、ブロックされたリクエストや破棄された思考のコストを理解することです。報告されたセキュリティ上の成果は大きい一方で、安定したインテグレーションとワークロード固有のテストは依然として重要です。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



