Anthropicは、次世代の人工知能を構築する際に、人工知能がすでにどの程度関与しているのかについて、これまでで最も明確な社内スナップショットの一つを公開しました。
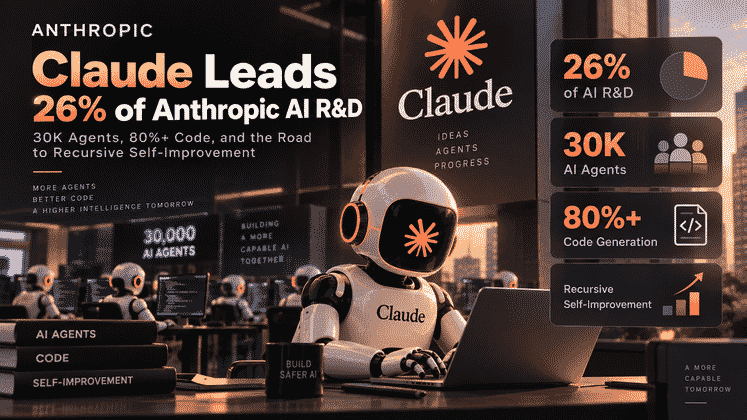
2026年8月時点で、AnthropicによるとClaudeは同社のAI研究開発業務の26%を主導しています。2026年初頭には、同じ指標は1%未満でした。
この見出しの数値は印象的ですが、誤って解釈されやすい数字でもあります。
「Claudeが研究開発の26%を主導する」という表現は、Claudeが人間なしで会社の4分の1を独立して運営していることを意味しません。Anthropicは6段階の自動化フレームワークを使用しており、26%という数字が示しているのは、**AL4(AIが主導)**と評価された業務です。つまり、人間が高レベルの目標を設定し、Claudeがタスクの大部分を最初から最後まで実行し、人間が監督と承認を担う段階を指します。
Anthropicはまた、測定対象となったAI研究開発業務の90%以上が、少なくとも**AL3(AIが協働)**に到達したと報告しています。
同時に同社は、大規模な社内エージェント基盤を運用しています。8月には、Anthropicで最も利用されている社内プラットフォーム上で、約3万のエージェントが常時、研究およびエンジニアリング業務を行っていました。またAnthropicは、その月にエージェントが行った10億件を超える意思決定を分析しました。
これらの数値は、「AIがAIを構築する」という議論が、理論から測定可能な現実へと移りつつある理由を示しています。
同時に、最後の但し書きが非常に重要であることも示しています。
Anthropicによると、測定された業務のうち、完全自律型のAL5に到達したものはありません。
同社は、AIによる支援およびAI主導の研究開発をさらに進めています。しかし、Claudeが人間の監督なしに、自らを設計、訓練、評価し、置き換えることができるとは主張していません。
Anthropicは、AI研究開発のどの程度がClaudeによって実行されているかを追跡するため、試験的な**研究開発自動化指標(R&D Automation Index)**を構築しました。
同社はまず、モデルの研究開発に含まれる業務の種類を整理し、その後、各カテゴリーに自動化レベルを割り当てています。この尺度はEpoch AIの研究に基づくもので、AL0からAL5までの段階で構成されています。
6段階の自動化レベル
| レベル | ラベル | 実務上の意味 |
|---|---|---|
| AL0 | 未使用 | AIはそのタスクに実質的に関与しない。 |
| AL1 | 限定的 | AIは時折の検索、ブレインストーミング、文章の推敲などを支援する可能性があるが、業務の進め方自体は変えない。 |
| AL2 | 支援 | AIはタスクの一部を大幅に高速化するが、人間が引き続き業務を主導し、レビューする。 |
| AL3 | 協働 | AIは人間の緊密な指示のもとで業務の大部分を処理するが、人間が重要な意思決定を行い、結果を統合する。 |
| AL4 | 主導 | AIは高レベルの依頼を受けて、タスクの大部分を最初から最後まで完了する。人間は監督、軌道修正、承認を行う。 |
| AL5 | 自律 | AIが人間の関与をほとんど、またはまったく必要とせず、業務を最初から最後まで実行する。 |
AL3とAL4の違いは特に重要です。
AL3では、人間が緊密に関与し続けます。人間はログを提供したり、仮説を提示したり、質問に答えたり、予期しない事態が発生したときの対応を決めたりします。
AL4では、人間は高レベルの目標を引き渡し、Claudeに実行の大部分を任せることができます。その人は引き続きタスクを監督しますが、各ステップを継続的に細かく指示する必要はありません。
Anthropicによる2026年8月のスナップショット
Anthropicは、主に3つの結果を報告しています。
| 測定項目 | Anthropicが報告した結果 |
|---|---|
| ClaudeがAL4「主導」に分類されたAI研究開発業務 | 26% |
| AL3「協働」以上に分類されたAI研究開発業務 | 90%以上 |
| AL5「自律」に分類されたAI研究開発業務 | 測定対象のサブセットでは0% |
したがって、26%という数字は次のように理解するのが最も適切です。
人間が高レベルの目標を設定
        ↓
Claudeがワークフローの大部分を処理
        ↓
人間が監督し、承認
これは、次のことを意味するわけではありません。
Claudeが研究アジェンダを独自に決め、
後継モデルを構築・検証・デプロイする
すべての作業を人間の関与なしに行う
この区別は、Anthropicが定義する再帰的自己改善の中心にあります。
Anthropicは自動化指標をどのように構築したのか
Anthropicは、従業員にClaudeをどの程度利用しているかを尋ねるだけで26%という数字を算出したわけではありません。
公開された方法論によると、同社はモデル研究開発のサイクルに関わるチームの業務記録をサンプリングし、2026年7月時点で約1万5,000件の詳細なタスクからなるボトムアップの業務一覧を作成しました。
その後、Claudeがこれらのタスクを階層構造に整理することを支援し、次の構成となりました。
- 合計542ノード。
- 378のリーフカテゴリー。
- モデル訓練、プロダクト業務、強化学習、評価インフラ、サービス障害、ネットワークポリシー、その他の研究開発業務を含むカテゴリー。
各カテゴリーについて、研究エージェントがそのタスクが実際にどのように実行されているか、またプロセスのどの程度をAIが担っているかを調査しました。その後、独立したClaudeの判定モデルが自動化レベルを割り当てました。
Anthropicは、関連する業務領域の人間の責任者にも、別途自動化レベルを評価してもらいました。
同社によると、モデルと人間がまったく同じ評価を付けた割合は59%、自動化レベルの差が1段階以内だった割合は97%でした。
これは有用な証拠ですが、完全な測定ではありません。
Anthropic自身も、境界的な事例には主観性が残ること、さらに判定モデルが評価対象のシステムと一部同じ誤りを共有する可能性があることを明示しています。
約3万の社内エージェントが同時に稼働
元記事では、Anthropicの社内エージェント基盤の規模も取り上げられています。
Anthropicによると、2026年8月時点で、最も利用されている社内プラットフォーム上では、約3万のエージェントが常時、研究およびエンジニアリング業務を行っていました。
ここで重要なのは、この数字が人間のような恒久的な従業員3万人を意味するものではなく、Anthropic社内のあらゆる場所で利用されているAIエージェントの総数でもないという点です。
これは、測定対象となった社内プラットフォーム上で、同時点にアクティブだったエージェントの数です。
これらのエージェントは、長時間にわたって半自律的に作業し、互いに業務を委任することができます。
Anthropicによると、同社の社内スキャフォールドはエージェントに個別のIDを付与し、オープンなメッセージングシステムを使用しています。これにより、エージェントは互いの主張を確認し、元の証拠にリンクし、情報を盲目的にチェーンで受け渡すのではなく、誤りを修正できます。
8月には10億件を超えるエージェントの意思決定を監視
数万のエージェントが並行して作業する場合、監督はシステム上の課題になります。
Anthropicは、2026年8月に研究およびエンジニアリングのエージェントが行った10億件を超える意思決定を分析したと説明しています。
測定対象の社内プラットフォーム上で行われるすべてのアクションは、実行前にオンラインモニターを通過します。
オンラインモニターは、次のことを実行できます。
- アクションを許可する。
- 危険なアクションをブロックする。
- 問題のある行動を方向転換させたり、誘導したりする。
Anthropicによると、10億件を超える意思決定のうち、ブロックされたのは0.002%、およそ4万7,000件に1件でした。
この低い割合を、そのまま「エージェントは99.998%の確率で安全」と解釈すべきではありません。ブロック率はあくまで一つの測定値です。モニターが何を検出できるか、行動がどのように分類されるか、そもそもどのようなリスクのあるアクションが発生するかによって変わります。
Anthropic自身も同じ点を指摘しています。この規模では、重要な行動がすべてモニタリングシステムから見えているかどうかを判断するのは困難です。
オンライン監視とオフライン監視の連携
Anthropicは、2層の監視について説明しています。
オンライン監視
オンラインモニターは、アクションが実行される前に検査します。
その役割は、認可されたシステムの外部へ機密性の高いモデル資産を移動しようとするなど、即時かつ元に戻しにくい損害を引き起こす可能性のある行動を阻止することです。
Anthropicによると、測定対象のプラットフォーム上におけるエージェントのアクションは100%この層を通過します。
オフライン監視
オフライン監視は、エージェントの活動を事後的に検査します。
これは、即時の損害を引き起こすのではなく、時間をかけて形成される可能性のあるパターンを検出するためのものです。
Anthropicによると、オフラインシステムはさらなる分類器によるレビューのため、週あたり約10万件のトランスクリプトにフラグを付けています。
その大半は自動的に処理されますが、最も優先度の高いケース、つまり週あたり約50件は人間にエスカレーションされます。
したがって、アーキテクチャは次のような構成に近いものです。
エージェントがアクションを提案
        ↓
オンラインモニターがアクションを確認
        ↓
アクションを実行、またはブロック/方向転換
        ↓
活動を記録
        ↓
オフライン監視がパターンをレビュー
        ↓
最優先のケースを人間のレビュアーに送る
この監視スタックはAnthropicの発表における最も重要な部分の一つです。自動化が進むほど、エージェントが何をしているのかを組織が理解し、必要に応じて介入できなければ、実用性を維持できないためです。
マージ済みコードの80%以上をClaudeが作成し、次世代モデルの開発に貢献
AIBaseの記事における2つ目の主要なポイントは、現在Anthropicのコードのどれほど多くをClaudeが記述しているかです。
ここでは、日付を正確に示す必要があります。
Anthropicの公式レポート**「When AI builds itself」**によると、2026年5月時点で、Anthropicのコードベースにマージされたコードの80%以上をClaudeが作成していました。
Claude Codeが2025年2月にリサーチプレビューに入る前、この割合は1桁台だったとAnthropicは説明しています。
これは、1年あまりで起きた劇的な変化です。
コードの80%という数字は、研究開発の26%という数字と同じではない
この2つの数字は、異なるものを測定しています。
数分で紹介サイトを作り、リード獲得を伸ばす
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
| 指標 | 日付 | 測定対象 |
|---|---|---|
| 80%以上 | 2026年5月 | Claudeが作成した、Anthropicのマージ済みコードの割合 |
| 26% | 2026年8月 | AL4「AIが主導」と評価された、重み付け後のAI研究開発業務の割合 |
| 90%以上 | 2026年8月 | AL3「協働」以上と評価された、重み付け後のAI研究開発業務の割合 |
ソフトウェアコードは、モデル研究開発の一部にすぎません。
AI研究には、次のような業務も含まれます。
- 研究の方向性を決める。
- 実験を設計する。
- どの証拠を信頼できるか判断する。
- 予期しない結果を評価する。
- 訓練ジョブを管理する。
- 失敗を解釈する。
- 安全性を研究する。
- インフラを運用する。
- モデルを評価する。
- プロダクトとデプロイに関する意思決定を行う。
そのため、マージ済みコードの80%をClaudeが作成していても、AI研究開発全体のうちAI主導に分類される割合は26%にとどまり得ます。
エンジニアのコード出力が大幅に増加
Anthropicはまた、2026年第2四半期の一般的なエンジニアが、2024年の1日あたりと比べて、およそ8倍のコードをマージしていたと報告しています。
同社は直ちに重要な但し書きを加えています。コード行数は、生産性を測るうえで不完全な指標だということです。
コード量が増えたからといって、自動的に8倍の価値が生まれるわけではありません。
大規模な変更には、次のようなものが含まれる可能性があります。
- 生成されたテストの増加。
- 生成された定型コードの増加。
- より大規模なリファクタリング。
- 実験の増加。
- 人間が自分で入力するのではなく、レビューするコードの増加。
それでもAnthropicは、この変化はエンジニアリングのスループットが実際に加速したことを示すほど大きいと主張しています。
特に注目されるのは、2021年から2024年にかけて出力が比較的横ばいだった後、Claudeが人間が貼り付けるためのコードスニペットを提案するだけでなく、コードを実行するようになってから増加し始めた点です。
Claudeは研究開発のループ内で何をしているのか
元記事では、Claudeの業務をモデル実験、コーディング、データ分析、結果検証に分類しています。
Anthropic自身の公開情報も、Claudeがモデル開発のサイクル全体にわたる業務にますます関与しているという、より広い状況を裏付けています。
具体的には、次のような業務が含まれます。
- インフラ障害の診断。
- 実験コードの実装。
- 評価の実行または支援。
- 実験結果の分析。
- モデルの挙動の調査。
- アラインメント研究の支援。
- 社内開発者向けインフラの保守。
これが、AIがより優れたAIの構築を支援していると表現される理由です。
しかし、後継モデルの開発に参加することと、その後継モデルを完全に自律して作成することには重要な違いがあります。
再帰的自己改善はすでに実現したのか
Anthropic独自の定義によれば、まだ実現していません。
Anthropicは、モデルが後継モデルを完全に自律して構築できる段階を、再帰的自己改善と説明しています。
8月の自動化データでは、AI研究開発の測定対象となったサブセットのうち、AL5に該当するものはないと明記されています。
したがって、現時点で最も正確な表現は次のとおりです。
Claudeは、将来のClaudeモデルを生み出す研究開発プロセスを大幅に加速しています。しかしAnthropicは、Claudeが後継モデルの開発サイクル全体を自律して運用できるとはまだ主張していません。
この区別は重要です。なぜなら、「再帰的自己改善」という言葉は、しばしば曖昧に使われているからです。
人々がこの言葉で指している可能性がある段階は、少なくとも次の3つあります。
段階1
AIが、次のモデルを構築する人間を支援する

段階2
AIが、人間の監督下で研究開発ワークフローの大部分を主導する

段階3
AIが、後継モデルを自律して設計・構築・評価・改善する
Anthropicが公開したデータは、業務の割合が増加している段階2を強く裏付けています。
しかし、段階3を示すものではありません。
Anthropicがこれらの指標を公開する理由
Anthropicは、これらの測定の目的は単に生産性を宣伝することではないと説明しています。
フロンティアモデルが自らの開発を加速し始めた場合、一般の人々や政府は、時間の経過に伴って追跡できる指標を必要とすると同社は主張しています。
同社が提案する測定は、主に次の3点に焦点を当てています。
- AIが実行するAI研究開発の量。
- エージェントのアクションがどの程度監視・制御されているか。
- 能力開発と安全性の研究の間で、計算資源がどのように配分されているか。
Anthropicは、この種の指標が将来的に独立検証され、より強固な安全要件を発動するトリガーとして使われる可能性があると説明しています。
例えば、AI主導の研究開発の割合が急激に上昇した場合、新しいモデルがさらなる研究開発に貢献することを認める前に、研究所に対して、より長いテスト期間や強力な外部評価を義務付けることが考えられます。
Anthropicは安全性への計算資源配分も報告
この点は短いAIBaseの記事の範囲外ですが、同じAnthropicの測定リリースに含まれており、同社のより広範なフレームワークを理解するのに役立ちます。
2026年7月の1週間を対象としたスナップショットで、Anthropicは次のように説明しています。
- **AI研究開発に使用された計算資源の約6%**が安全性に配分された。
- **AIによるAI研究開発に使用された計算資源の約12%**が安全性に配分された。
Anthropicは、これらを保守的な推定値と位置付け、安全性研究と能力研究を分類することには本質的な難しさがあると指摘しています。
したがって、これらの数字は普遍的または恒久的な比率ではなく、スナップショットとして扱うべきです。
測定システムには依然として限界がある
Anthropicは、方法論の限界について異例なほど明確に説明しています。
重要な但し書きには、次のようなものがあります。
- ClaudeがClaudeの支援を受けた業務を部分的に評価している。
- 自動化レベルの境界には主観性がある。
- タスクの集合は固定されたベースラインに基づいており、新たに生まれた業務カテゴリーを見落とす可能性がある。
- モニタリングシステムがこの規模で稼働している期間は数か月であり、数年ではない。
- 非常に低いブロック率は、有害な行動がすべて検出されていることを証明しない。
- コード量は生産性や品質と同じではない。
- AI主導の業務は、完全自律型の業務と同じではない。
これらの限界があるからといって、数値に意味がなくなるわけではありません。
絶対的な自律性の証明ではなく、トレンドを測る指標として解釈すると、数値はより有用になります。
よくある質問
ClaudeがAnthropicのAI研究開発の26%を主導するとは、どういう意味ですか?
Anthropicの重み付け後のAI研究開発業務の26%が現在AL4と評価されていることを意味します。AL4では、Claudeが高レベルの依頼を受けて、タスクの大部分を最初から最後まで完了できます。ただし、人間は引き続き業務を監督、レビュー、承認するため、完全自律型の研究を意味するものではありません。
AL4とAL5の違いは何ですか?
AL4は、人間が監督と承認の責任を持ちながら、AIがタスクの大部分を主導する段階です。AL5は、人間の関与をほとんど、またはまったく必要とせず、業務を最初から最後まで自律して処理する段階です。Anthropicによると、測定対象となったAI研究開発業務のうち、AL5に到達したものはありません。
Claudeは本当にAnthropicのコードの80%以上を書いているのですか?
Anthropicは、2026年5月時点で、同社のコードベースにマージされたコードの80%以上をClaudeが作成したと報告しています。この指標が示すのはマージ済みコードの割合であり、すべての研究、プロダクト上の意思決定、モデル開発業務の80%を意味するものではありません。
Anthropicは社内で何体のAIエージェントを運用していますか?
Anthropicによると、2026年8月時点で、最も利用されている社内プラットフォーム上では、約3万のエージェントが常時、研究およびエンジニアリング業務を行っていました。この数字は測定対象の社内プラットフォームに適用されるものであり、恒久的な人間相当の労働者数として解釈すべきではありません。
Anthropicはこれほど多くのエージェントをどのように監視していますか?
同社は、実行前のオンライン監視と、アクション実行後のオフライン監視を使用しています。Anthropicによると、測定対象のプラットフォーム上におけるアクションの100%がオンラインモニターを通過し、オフラインシステムはさらなる自動レビューおよび人間によるレビューのためにトランスクリプトへフラグを付けています。
ブロックされた意思決定が0.002%という数字は何を意味しますか?
Anthropicによると、2026年8月、オンラインモニターは10億件を超えるエージェントの意思決定の約0.002%、およそ4万7,000件に1件をブロックしました。これは監視に関する統計であり、ブロックされなかったすべての意思決定が安全または正確だったことを証明するものではありません。
Claudeは再帰的自己改善を達成しましたか?
Anthropic独自の定義では、まだ達成していません。Anthropicは、より強い意味での再帰的自己改善を、モデルが後継モデルを完全に自律して構築することと定義しています。一方、現在のデータによると、測定対象となったAI研究開発カテゴリーのいずれもAL5の自律性には到達していません。
Anthropicがこの自動化指標を公開する理由は何ですか?
Anthropicは、フロンティア研究所がモデル開発をどれほど速く自動化しているかについて、一般の人々、政府、独立評価機関が把握する必要があると主張しています。同社は、自動化、エージェントの監督、計算資源の配分に関する指標を追跡可能なシグナルにし、将来の安全要件に役立てたいと考えています。
関連ツール
- Claude Code:リポジトリ規模のソフトウェアエンジニアリング業務向けに設計された、Anthropicのエージェント型コーディング環境。
- Claude API:Claudeモデルを使ったアプリケーションやエージェントを構築するための公式開発者向けプラットフォーム。
- Claude:Claudeモデルを利用するためのAnthropicの主要インターフェース。
- Epoch AI:Anthropicの測定フレームワークで使われているAI研究開発自動化スケールを策定した独立研究組織。
- METR:フロンティアモデルの自律性を評価し、Anthropicの監視システムに対するレッドチームテストも行っている独立研究組織。
関連リンク
- Anthropic:AI開発のペースを理解するための測定:AI主導の研究開発26%、3万エージェントの規模、監視統計、計算資源配分の方法論に関する公式情報源。
- Anthropic:AIが自らを構築するとき:80%以上のマージ済みコード、エンジニアリング生産性の変化、再帰的自己改善のシナリオを説明する公式レポート。
- Epoch AI:AI研究開発のためのO*NETに向けて:Anthropicが使用するAL0からAL5までの6段階の自動化基準。
- Anthropicフロンティア安全性ロードマップ:自動化された研究開発能力が高まる中での、Anthropicの現在の安全対策ロードマップ。
- Anthropic透明性ハブ:モデルのリスクレポート、能力のしきい値、安全性に関する開示情報をまとめた公式ハブ。
- Anthropic Research:エージェント、アラインメント、科学、モデルの挙動に関するAnthropicの研究成果をまとめた公式インデックス。
まとめ
Anthropicが発表した最新の社内測定結果は、モデル開発がAI主導へ急速に移行していることを示しています。2026年8月時点で、Claudeは重み付け後のAI研究開発業務の26%を主導し、90%以上が人間とAIの協働以上に達していました。また、Anthropicで最も利用されている社内研究プラットフォームでは、約3万のエージェントが同時に稼働していました。
別の指標として、Anthropicは2026年5月時点で、同社のコードベースにマージされたコードの80%以上をClaudeが作成したと説明しています。この数字は、AIが将来のClaudeモデルとなるシステムの構築にすでに深く関与していることを示す強い証拠です。しかし、より広い研究開発の自動化率と混同すべきではありません。
最も重要なのは、Anthropicが現在も、AL5の完全自律に到達したAI研究開発カテゴリーは測定上ゼロだと報告している点です。同社はAI主導のAI開発に向けて明確に進んでいますが、完全自律型の再帰的自己改善が実現したとは宣言していません。
現時点で最も明確なシグナルは、「ClaudeがAnthropicの研究者に取って代わった」ということではありません。人間がAIの支援を受けて業務を行う状態から、人間がAI主導の研究開発ワークフローを監督する状態へ、重心が移りつつあるということです。