AIプログラミングコミュニティで急速に広がる新しいClaude Opus 5のプロンプトパターン。開発者はこれを使って、短い説明から驚くほど洗練されたブラウザゲームのプロトタイプを作り出している。
新しいClaude Opus 5のプロンプトパターンがAIプログラミングコミュニティで急速に広まっている。開発者たちが短い初期指示から驚くほど洗練されたブラウザゲームのプロトタイプを生み出すためにこれを活用しているのだ。
この手法は現在、「ガントレットループ」(Gauntlet Loop)と呼ばれている。
その核となる考え方はシンプルだ。同じエージェントに一度構築させ、自分で自分の仕事を評価して終わりにするのではなく、主導エージェントに高レベルの目標を与え、プロジェクトを小さな部分に分解させ、専門のビルダーを割り当て、独立したレビューエージェントに実際の出力を具体的な品質基準と比較させる。
生成された結果が比較を通過しなければ、さらに反復を重ねるために戻るのだ。
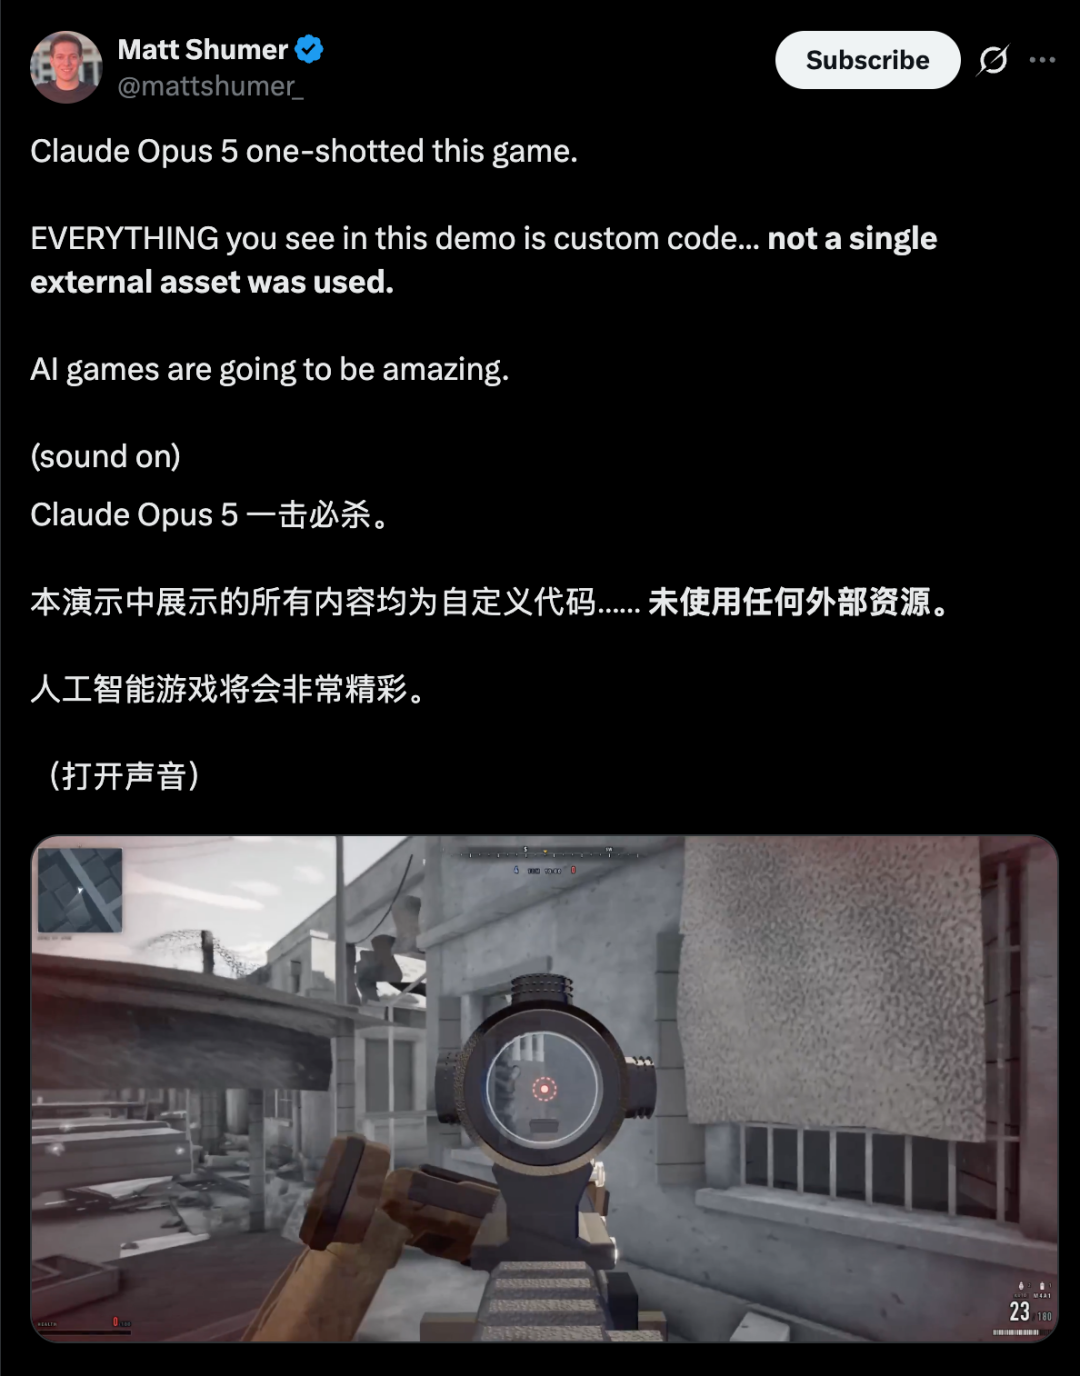
Matt Shumerは、Claude CodeとOpus 5を使って現代の『コール オブ デューティ』にインスパイアされたブラウザ向け一人称視点シューティングゲームを作成した後、この手法を広めた。彼はその後、プロンプト、ソースコード、ワークフローの説明を公開した。
別の開発者Anshu Chimalaは、同様のワークフローを採用して**『ザ・ロング・サイレンス』**(The Long Silence)を構築した。これはブラウザで動作するプロシージャル生成の宇宙探査ゲームだ。
これらのプロジェクトは正確に説明されるべきである。それらは、単一のプロンプトが即座に商業グレードのAAAゲームを生み出せることを示すものではない。強力なコーディングエージェントが、ツール、サブエージェント、長時間の実行、測定可能な品質基準、反復的な検証を与えられた場合、従来の一発型プロンプトが到達できる範囲をはるかに超えてプロトタイプを推し進めることができることを示しているのだ。
Shumerの当初のタスクは、意図的に極端な目標を設定していた。モダンなAAAタイトルに匹敵する視覚的野心を持つ一人称視点シューティングゲームを構築するというものだ。
重要な部分はゲームの種類ではなく、評価構造にある。
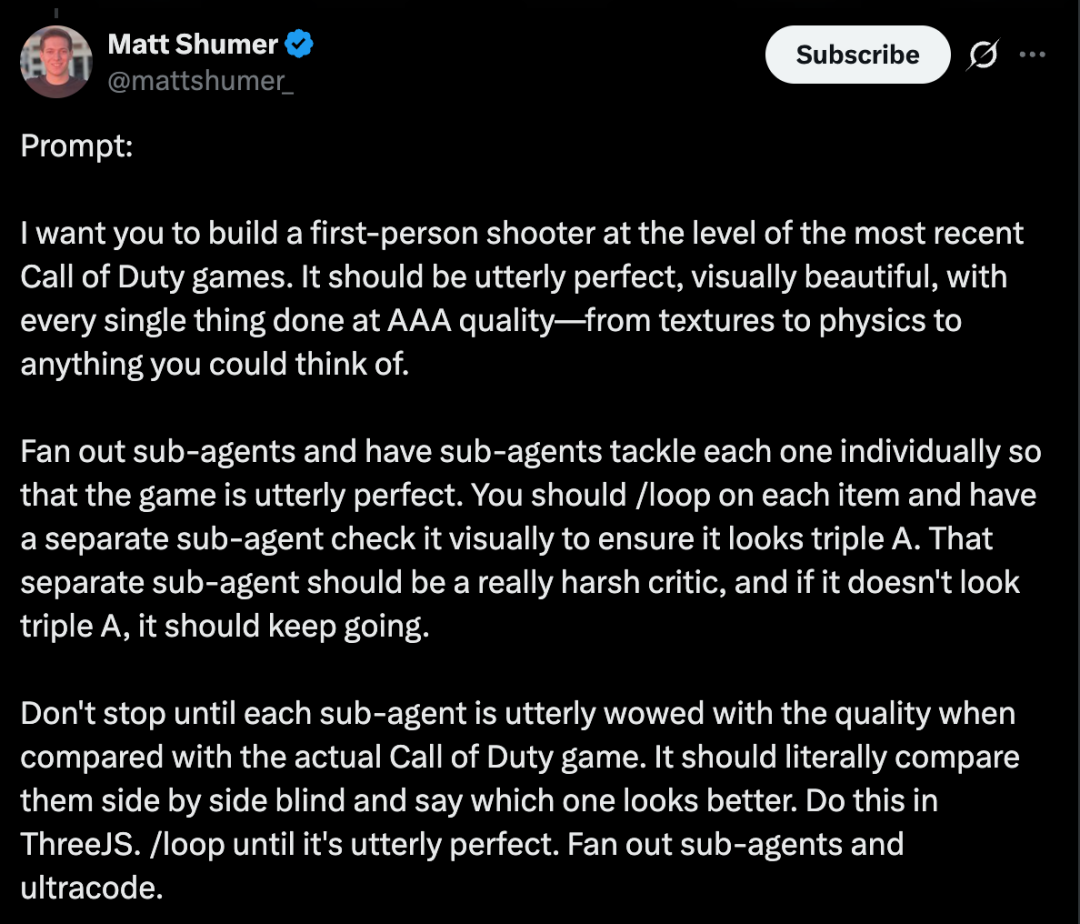
ワークフローはエージェントに以下のことを指示している:
Shumerは後にこの手法を**「ガントレットループ」**(Gauntlet Loop)として正式に確立した。
簡略化したバージョンは以下の通りである:
目標
  ↓
主導エージェント
  ↓
タスク分解
  ↓
ビルダーエージェント
  ↓
実際の出力
  ↓
独立レビュー
  ↓
リファレンスと比較
  ↓
合格? ── はい → 統合
  │
  いいえ
  ↓
最大のギャップを説明
  ↓
ビルダーが改善
  ↓
繰り返し
「もっと良くする」というフィードバックは弱い。なぜなら、モデルが自分で「より良い」とは何かを定義しなければならないからだ。
「ガントレットループ」は評価者に外部の参照物を与える。
ゲームの場合、確立された商業作品からのスクリーンショットがそれにあたる。
ウェブサイトの場合、同カテゴリーの主要サイト数件がそれにあたる。
バックエンドエンジニアリングの場合、以下のようなものが考えられる:
目標は完全に到達可能である必要は必ずしもない。その役割は、エージェントが時期尚早に成功を宣言するのを防ぐことにある。
二つ目の重要なルールは独立性である。
ビルダーは自分が各選択を行った理由を知っているため、自分の結果を擁護しやすい。一方、まったく新しい評価者は実際の成果物を受け取り、実装の経緯を知らない。
ビジュアル作業の場合、評価者はレンダリングされたピクセルを検査できる。
ソフトウェアの場合、評価者はテストと実行時動作を検査できる。
パフォーマンス作業の場合、評価者は実際の測定データを検査できる。
より広い原則は次の通りだ。生成と評価は別のものにすべきである。
Shumerの当初のデモは、Claude of Duty として公開されている。
そのGitHubリポジトリは、Three.jsとWebGL2に基づく一人称視点シューティングゲームで、約11のサブシステムにわたる55,000行のコードを含むと説明している。
リポジトリは、このゲームが外部のアートアセットを一切使用していないと述べている。テクスチャ、メッシュ、アニメーション、サウンドはすべてコードによってプロシージャルに生成されている。
そのシステムには以下が含まれる:
このプロジェクトを「一発で完成」と呼ぶことは、すべてが一度の応答に含まれていたことを意味しない。Shumerによると、高レベルのプロンプトが長時間実行されるClaude Codeセッションを起動し、その後セッションがサブエージェントを生成し、ファイルを書き、ツールを実行し、ゲームをレンダリングし、出力を検査し、絶えず修正していった。
リポジトリには以下のツールが含まれている:
そのREADMEは、バイラルな投稿の中には、最終プロジェクトが現代の『コール オブ デューティ』ゲームには及ばないことを明確に述べているものもあり、より慎重だ。
これこそが逆に実験をより価値あるものにしている。本当の結果は「AIがすでにAAAスタジオを置き換えた」ということではなく、次のようなものである。意図的に高い参照点を設定することで、普通のプロンプトがとうに止まってしまう場所から先へ、エージェントが長く働き続けることができるということだ。
その後、Anshu Chimalaは同様のワークフローをThe Long Silenceに適用した。これはClaude Opus 5を使用して構築されたプロシージャル生成のブラウザ宇宙探査ゲームである。

公開リポジトリによると、このゲームはWebGL2、Three.jsスタイルのブラウザレンダリング、およびカスタムGLSLを使用している。
また、従来のアセットライブラリをダウンロードするのではなく、シードベースのプロシージャルコンテンツ生成を採用している。
元記事では約24時間の開発プロセスが説明されており、主に3つのフェーズに分かれている。
最初のリクエストは、Three.jsを使用した宇宙探索ゲームの作成だった。
要件は意図的に高レベルに保たれた:
世界構築と技術アーキテクチャの大部分はエージェントの裁量に委ねられた。
これはこの手法の核心原則に従っている:
経路ではなく終点を明確にする。
元記事では、このプロセス中にClaude CodeがBlender関連のツールに接続されたことも言及されている。公開リポジトリにはBlenderのハードサーフェスモデリング用のClaudeスキルディレクトリが含まれており、再利用可能なBlender指示がプロジェクトの一部となっていることが確認できる。
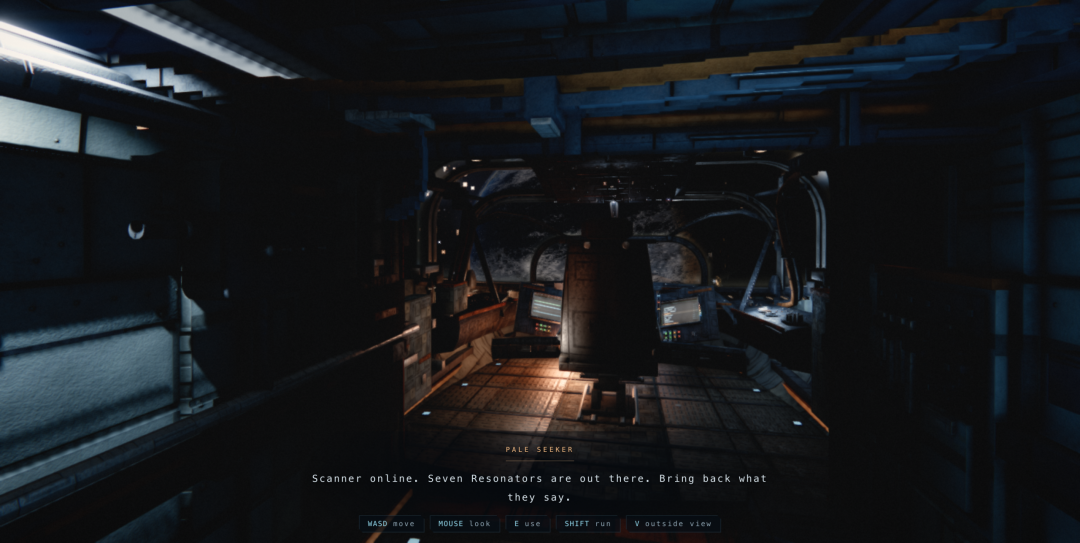
最初のプレイ可能なバージョンが完成した後、プロジェクトは長い視覚的洗練フェーズに入った。
複数のサブエージェントが各領域を個別に処理し、同時にレビューエージェントがスクリーンショットを高品質な宇宙ゲームの参照画像と比較した。
重要なのは、単にOpus 5に「ゲームをもっと見栄えよく」と指示することではない。レビューエージェントは可視的なギャップを特定し、弱点のある領域を再びイテレーションに戻す必要がある。
元記事では、Starfieldなどの作品が品質ベンチマークとして使用されたと述べられている。
長いループには停止条件も必要である。有用な停止ポイントには以下が含まれる:
ループはストレスメカニズムであり、出力が最終的に「完璧」になるという保証ではない。
このプロセスは完全に無人で行われたわけではない。
元記事によると、Chimalaはリモートで進捗を確認し、エージェントが特定の領域に過度に労力を投入している場合に介入した。
長時間の実行が終了した後、追加のClaudeセッションが以下のために使用された:
その後、モデルは再利用可能な教訓をスキルとしてまとめるように求められた。
公開リポジトリには以下が含まれている:
.claude/skills/blender-hardsurface
これは長時間実行されるエージェントワークにとって有用なパターンである。プロジェクトは成果物を生み出すだけでなく、再利用可能な運用知識を蓄積できる:どのツールが有効か、どのテストが重要か、何が失敗したか、そして将来のタスクがどのように構成されるべきか。
公開リポジトリの中で最も顕著な部分の1つは
検証ツールセットである。
READMEには以下のコマンドが記録されている:
node tools/play.mjs
node tools/survey.mjs
node tools/probe.mjs "" --shot out.png
node tools/sheet.mjs a.png b.png --out s.png
node tools/levels.mjs shots/*.png
node tools/judgeset.mjs
これらのコマンドの文書化された用途は以下の通り:
play.mjs:飛行、スキャン、フォールド、ジャンプを含む17項目のインタラクティブアサーションsurvey.mjs:主要シーンのスクリーンショットとパフォーマンスレポートprobe.mjs:単発のブラウザ式実行と単一スクリーンショットsheet.mjs:視覚比較用のサムネイルコンタクトシートlevels.mjs:トーンと露出の統計judgeset.mjs:視覚レビューセットの再構築
重要なのは、エージェントがゲーム自体だけでなく、ゲームを評価するためのメカニズムも作成したことだ。
これが、長時間実行されるエージェントが単純な「生成して終了」のワークフローよりも確実に改善できる理由の1つである。
READMEにはいくつかの実際のグラフィックス決定が記録されている:
リポジトリはまた、ブラウザ検証がGPUラスタライズを有効にした実際のChromiumインスタンス上で実行されたことを示している。
これらの詳細は重要である。なぜなら、モデルがパフォーマンス、精度、再現性、ブラウザの動作、視覚品質といった馴染みのあるエンジニアリング制約をどのように処理するかを示しているからだ。
『The Long Silence』はブラウザ上で公開プレイが可能である。
そのリポジトリは標準的な開発コマンドを提供している:
npm install
npm run dev
npm run build
ゲームには宇宙飛行、スキャン、プロシージャル環境、ナビゲーション、探索目標、複数のインターフェースシステムが含まれている。
これにより、単なる静的モデル以上のものとなっている。
しかし、大規模スタジオが数年かけて開発する商業AAAゲームと同等とは言えない。
AAA級の制作には通常、以下の分野を担当する大規模チームが必要である:
より妥当な結論は、1人の開発者が最先端のコーディングエージェントをオーケストレーションすることで、視覚的に野心的で技術的に非自明なプレイ可能なプロトタイプを、これまで実際に可能だった速度をはるかに超えて作成できるようになったということだ。
コミュニティ開発者がこのパターンを再利用し始めた
Shumerがプロンプトとコードを公開した後、このワークフローは急速に広まった。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
Ryan Campbellも同様のパターンを採用した
ブラウザベースのカートレーシングプロジェクトをループで推進し、レンダリング、操作、カメラ挙動、モバイルパフォーマンスを継続的に反復改善した。
Shumerが公開したGauntlet Loopディレクトリには、この手法で制作されたブラウザでプレイ可能なレーシング実験が後に掲載された。
デザイナーのYogi Suriaが、同じプロンプトパターンに着想を得たサイバーパンク風のThree.jsプロジェクトを共有した。
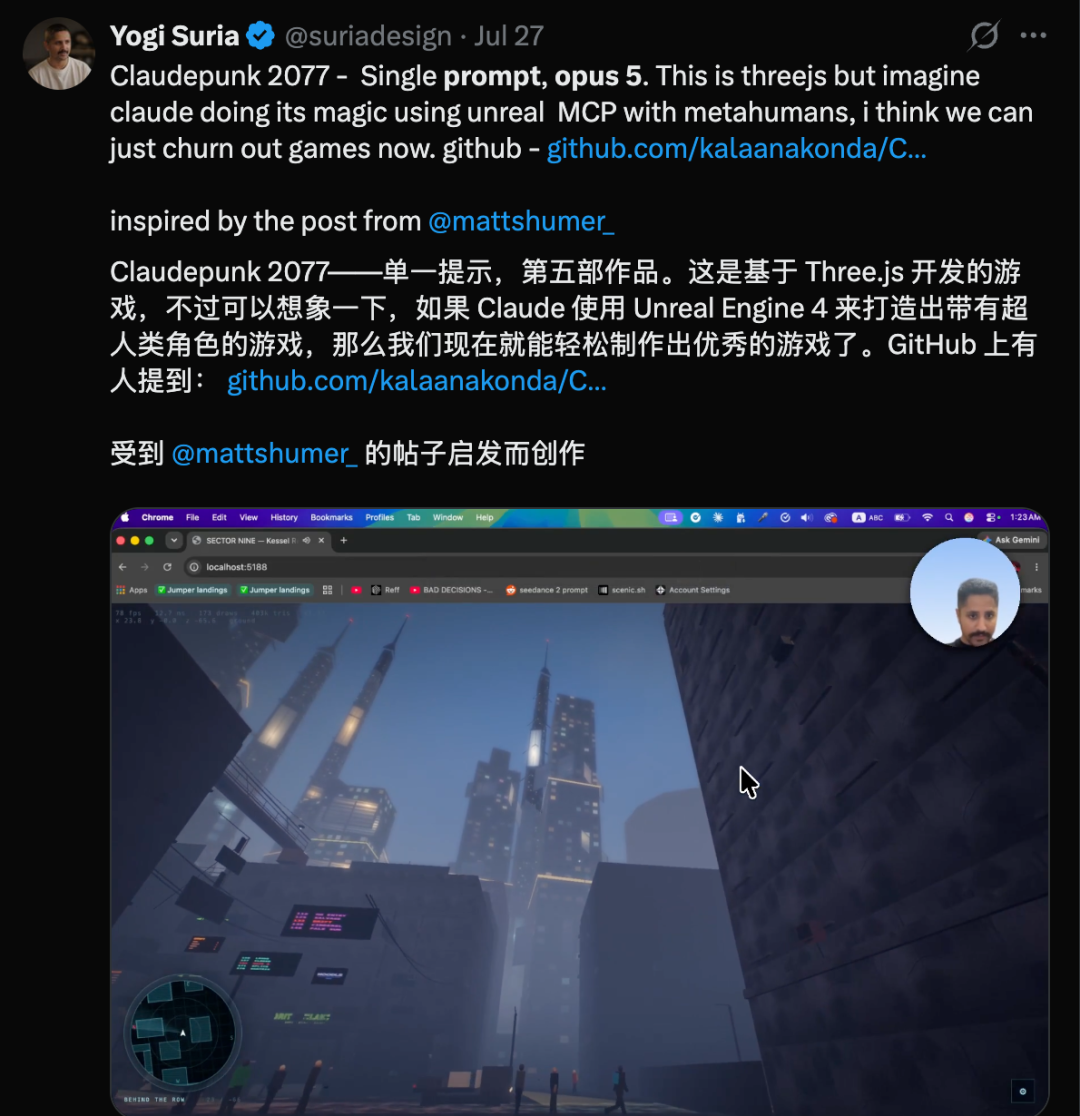
この例は、この手法が特定のゲームジャンルに限定されないことを示している。参照目標、アートの方向性、ツールチェーンは変更可能であり、「構築→批評→反復」という構造は不変である。
情報源はさらに、ある開発者がCodex上でGPT-5.6 Solを使用して同様のプロンプトを試した過程も示している。
この開発者は構築時間を約2時間と報告し、結果は良好だったが、Shumerのデモほど洗練されてはいないと評した。
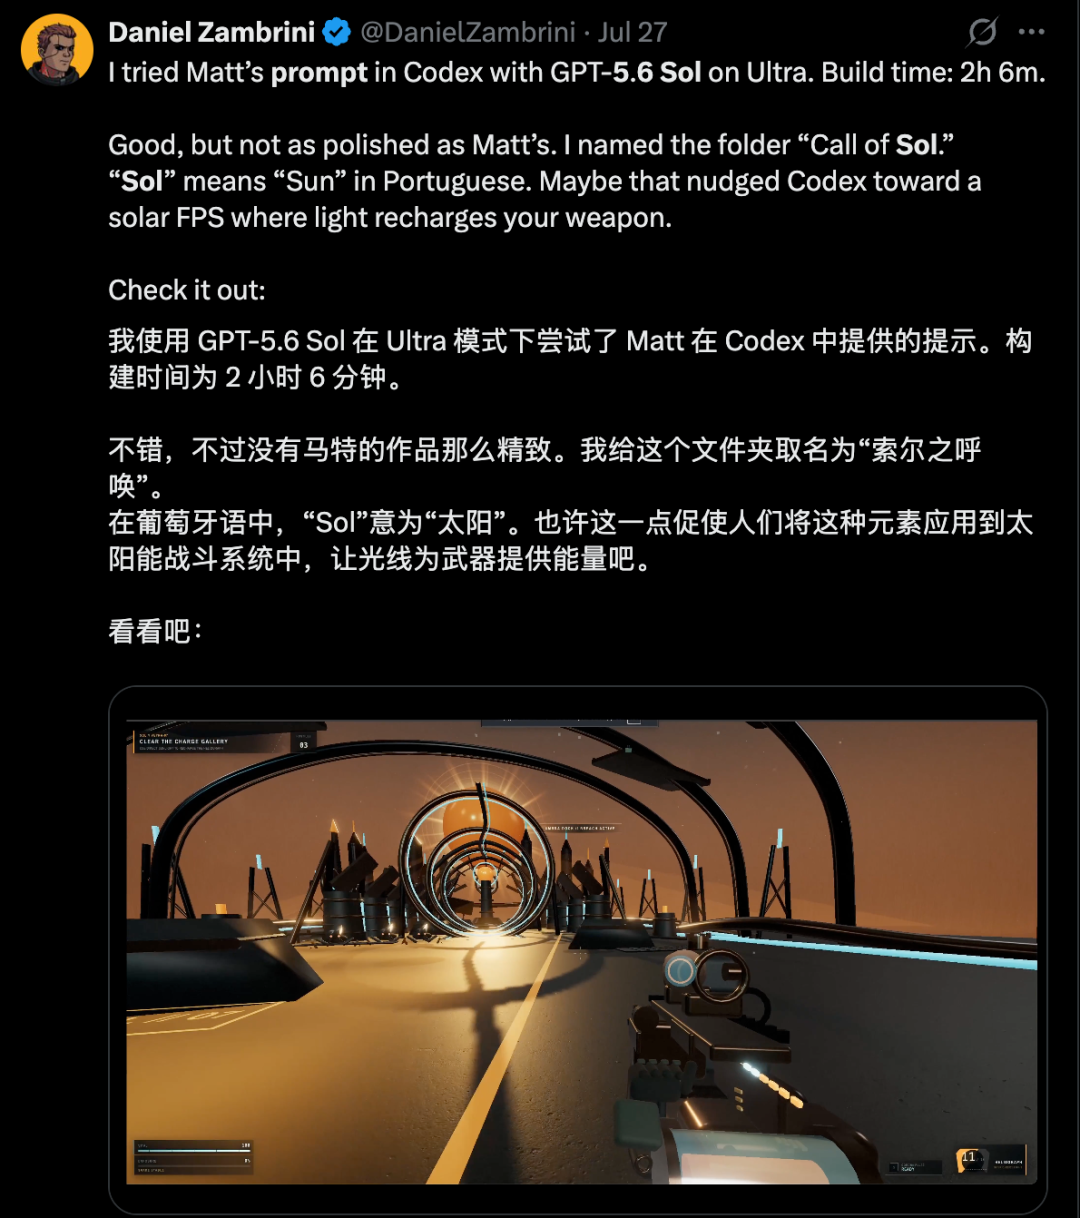
これは、Gauntlet Loopが本質的にClaude専用ではないことを示している。
このパターンは、以下の能力を備えたエージェント環境に依存する:
ループ内でのモデルの性能は異なる場合があるが、このアーキテクチャは移植可能である。
従来の生成フローは通常次のようなものである:
ユーザー → モデル → 出力 → ユーザー
Gauntlet Loopは評価レイヤーを追加する:
ユーザー
  ↓
メインエージェント
  ↓
ビルダー
  ↓
成果物
  ↓
独立した批評者
  ↓
ギャップの測定
  ↓
ビルダーによる修正
  ↓
新しい成果物
これにより、納品前に低品質な出力を発見する機会が増える。
エージェントが「ページは現在レスポンシブ対応になっているはず」と言うよりも、モバイル幅でページを開いて実際に確認する方がはるかに強力だ。
「ゲームはもっと速くなるはず」と言うよりも、フレームタイムを測定する方が強力だ。
「レンダリングは良くなったように見える」と言うよりも、スクリーンショットを比較する方が強力だ。
最良のフィードバックシグナルは、実際の成果物に根ざしたものである。
ビルダーは自分が行ったすべての妥協を覚えている。
これによりレビューが偏る可能性がある。
独立した批評者は、よりシンプルな問いを投げかけることができる:結果は本当に基準を満たしているか?
これは人間のワークフローを反映している。開発者はテストとコードレビューを使用する。デザイナーはビジュアルレビューとユーザーテストを使用する。作家は編集を使用する。
AIエージェントは、この分離をより高い頻度で再現できる。
Anthropicは2026年7月24日にClaude Opus 5をリリースした。
公式発表資料では、コーディング、長時間の多段階作業、検証、反復における性能向上が強調されている。
Anthropicは特に、Opus 5が以下の点で優れていると述べている:
これらの挙動はGauntlet Loopと高度に一致する。
このプロンプトはモデルに新しい能力を付与するものではない。既存の能力を繰り返し使用するよう強制する構造を作り出すのだ。
Anthropicはまた、Opus 5はOpus 4.8と比較して同じ基本価格でより効率的であると述べている:入力トークン100万あたり5ドル、出力トークン100万あたり25ドル。
長時間実行されるエージェントは依然として以下の問題に直面する可能性がある:
したがって、人間によるチェックポイントは依然として有用である。
最強のワークフローは「エージェントを二度と見ない」ことではなく、「価値の高い人間による介入の間により長くエージェントを働かせる」ことである。
この手法はゲーム以外の領域にも一般化できる。
すべての実装詳細を規定するのではなく、望ましい結果を記述する。
洗練されたブラウザベースの宇宙探査ゲームを構築する。スムーズな操作、
強い視覚的雰囲気、安定したパフォーマンスを備えたもの。
レビュアーが確認できる内容を使用する。
ビジュアル作業の場合:
ライティング、奥行き、構図、インターフェースの洗練度を、厳選した高品質な市販ゲームのスクリーンショット群と比較する。
ソフトウェアの場合は、テスト、ベンチマーク、またはリファレンス実装を使用する。
エージェントはコンポーネントを分割できる。例えば:
重要なコンポーネントには、以下を使用する:
レビュアーは曖昧な不満の長いリストを出すのではなく、最も大きな実行可能な差異を指摘すべきである。
品質、予算、または時間が停止点に達するまで反復を続ける。
並行エージェントは、局所的には良好でも全体的には一貫性のない作業を生み出す可能性がある。
最終的な統合エージェントは以下をチェックできる:
プロセス内の有用な部分を以下として保存する:
以降の実行は、以前の教訓から開始すべきである。
品質が繰り返し測定可能な場合、Gauntlet Loopは最も効果的である。
適切な候補には以下が含まれる:
しかし、レビュアーが信頼できるシグナルを持たない場合、このパターンの効果は弱まる。
スクリーンショット、テスト、ベンチマーク、参考資料、または実際のユーザーフィードバックを持たないレビュアーは、モデルにもう一つの「意見」を生成させるだけになる可能性がある。
長時間実行されるマルチエージェントワークフローは、多くの計算リソースを消費する可能性があります。
各レビューラウンドでは、以下の作業が必要になる場合があります:
実用的な予算管理手段には、以下のものがあります:
厳格な批評者は品質を向上させることができますが、残りの改善がもはやコストに見合わない場合でも、システムを長時間稼働させ続ける可能性があります。
Gauntlet Loopは、Matt Shumerによって普及したマルチエージェントプロンプト手法です。リードエージェントが目標をより小さなタスクに分解し、ビルダーエージェントが成果物を生成し、独立した批評エージェントが実際の出力を具体的な参照と比較し、基準に達しない結果は差し戻されてやり直しになります。
Shumerの説明によると、このプロジェクトは高レベルのプロンプトから始まりましたが、1回のモデル応答で生成されたわけではありません。Claude Codeはその後数時間にわたって動作し、サブエージェントを生成し、約55,000行のコードを作成し、ツールを使用し、出力を検査し、反復を行いました。
いいえ。これらのデモは技術的に印象的なブラウザゲームやプロトタイプですが、商業用の3Aタイトルと同等ではありません。Claude of Dutyのコードリポジトリ自体も、最終結果は品質の参照とした現代の『コール オブ デューティ』作品とは比較にならないと述べています。
The Long Silenceは、Anshu Chimalaによるブラウザベースのプロシージャル宇宙探査ゲームです。公開リポジトリによると、Claude Opus 5を使用して構築され、カスタムレンダリング、プロシージャル生成コンテンツ、ブラウザベースの検証ツールが含まれています。
新しい批評者は、ビルダー自身の実装判断を擁護する可能性が低いです。実際の成果物を検査し、再改訂を要求する前に、テスト、スクリーンショット、ベンチマーク、または参照例と比較することができます。
いいえ。このアーキテクチャは、ツール、ファイル編集、コード実行、視覚検査、反復作業をサポートする他のコーディングエージェントにも適用できます。元の文書にはGPT-5.6 SolとCodexの例が含まれています。
完全なワークフローには、通常のチャットインターフェースではなく、エージェント実行環境が必要です。Claude Codeは、ファイルを処理し、コマンドを実行し、ツールに接続し、長時間実行されるコーディングタスクを調整できるため、1つの選択肢です。
品質基準が曖昧または測定不能な場合、長時間実行されるループは時間と計算リソースを浪費する可能性があります。人間の所有者は依然として予算を設定し、進捗を確認し、必要に応じて優先順位を再調整し、さらなる反復が価値を失った時点を判断する必要があります。
Opus 5のコーディング、検証、反復、長周期タスク能力を網羅。
話題となったOpus 5ゲーム実験は、魔法のような「一回生成」ではなく、ワークフローのデモンストレーションとして理解されるべきです。Gauntlet Loopは、タスク分解、専門ビルダー、独立批評者、具体的な品質基準、反復的な改善を組み合わせたものです。
The Long Silenceは、このパターンが約1日程度のエージェントプロジェクトでどこまで到達できるかを示しています。公開リポジトリには、プレイ可能なゲームだけでなく、検証スクリプト、スクリーンショットツール、インタラクションアサーション、再利用可能なエージェント命令も含まれています。
この方法は依然として人間の判断、計算予算、優れた参照資料、エージェントワークベンチに依存しています。ブラウザプロトタイプがスタジオ品質の3Aタイトルに匹敵することを意味するものではありません。
本当の変革は、高レベルの目標が今や長期実行の「構築・測定・批評・改善」ループを開始でき、人間が介入する必要がある前に、はるかに多くの作業を完了できることです。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



