For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/claude-opus-5-vs-gpt-6-astra-200-game-ai-9a33a10d.md.
2つの最先端AIモデルに同じ目標を与え、数百局のチェスを指し、対局間でメモを保持することを許可し、それ以外では改善方法をほとんど教えなかった場合、何が起こるのでしょうか。

2つの最先端AIモデルに同じ目標を与え、数百局のチェスを指し、対局間でメモを保持することを許可し、それ以外では改善方法をほとんど教えなかった場合、何が起こるのでしょうか。
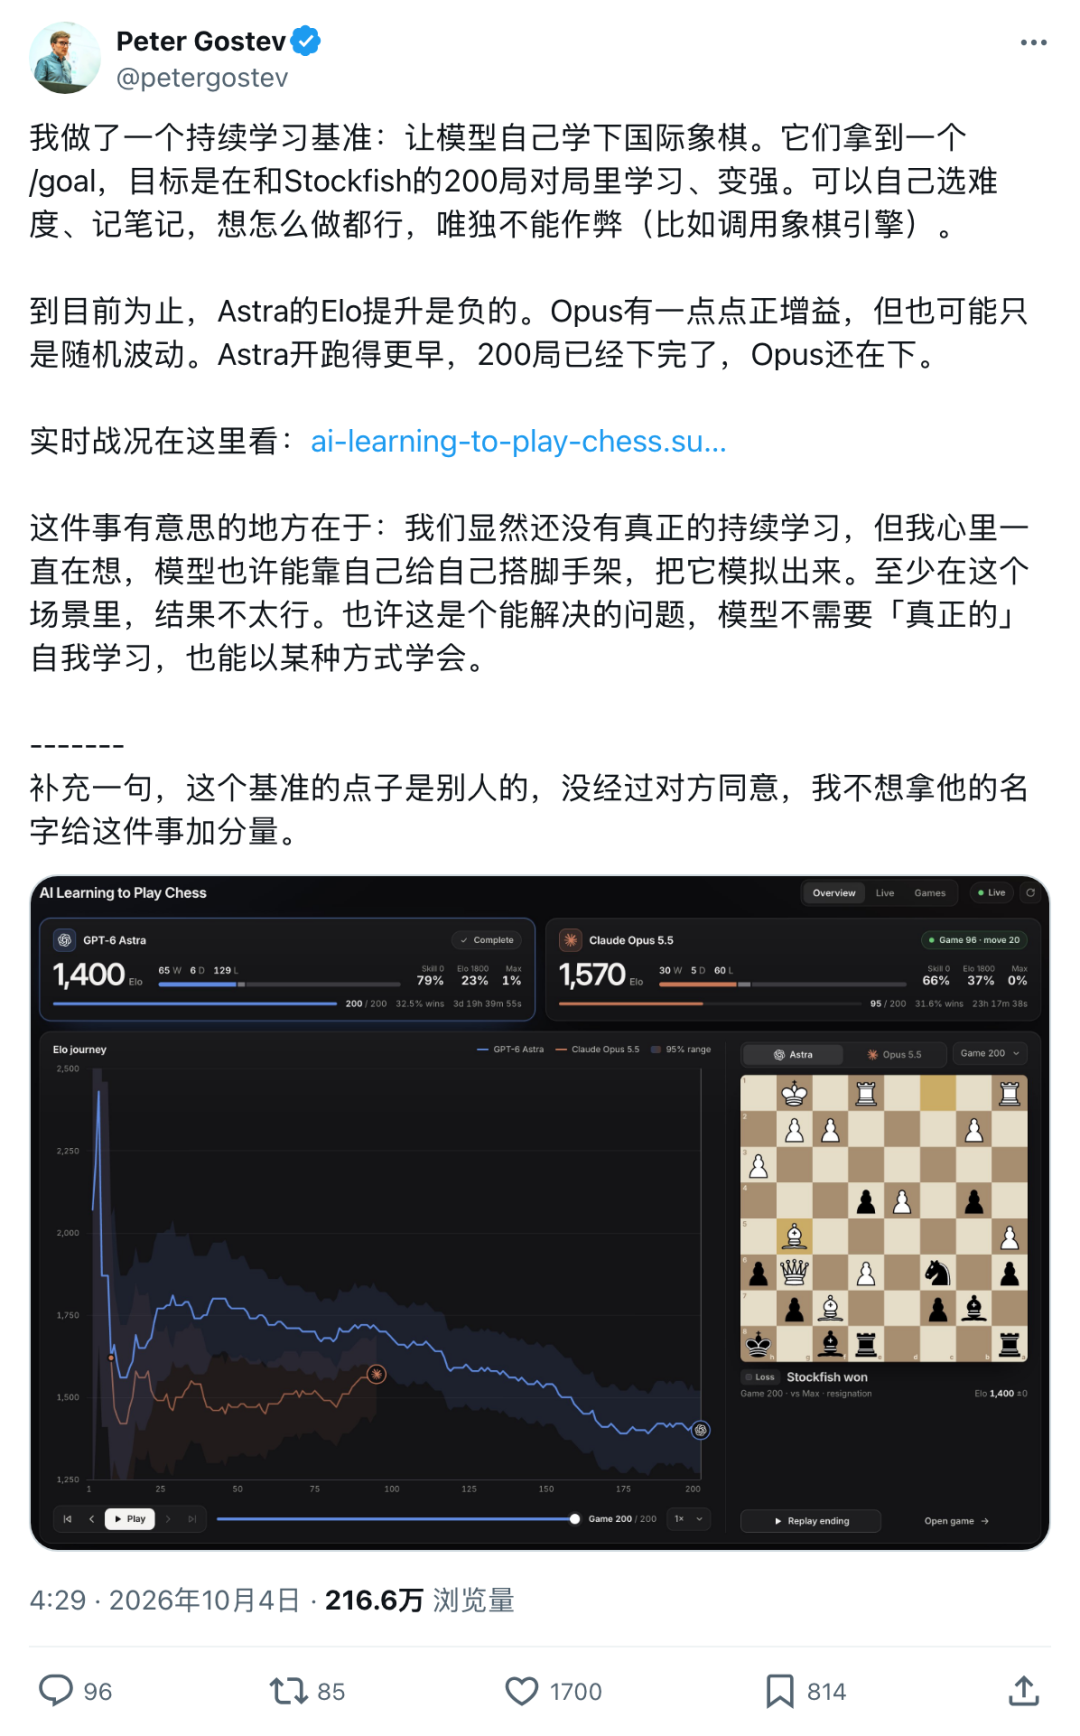
Peter Gostevは、まさにこの実験を実施しました。
Claude Opus 5.5とGPT-6 Astraには、それぞれ1つの目標が与えられました。Stockfishと最大200局対戦し、経験を通じてより強くなることです。
実行中にファインチューニングは行われませんでした。
モデルの重みも変更されていません。
途中で人間が設計したオープニング講座が追加されることもありませんでした。
モデルは、利用可能なStockfishの難易度のうちどれと対戦するか、メモに何を書くか、そのメモを後続の対局でどう使うかを自ら決められました。唯一の厳格な制約は明快です。
指し手を選ぶためにチェスエンジンを呼び出すことは許可されない。
2つの軌跡は、ほぼ正反対のものとなりました。
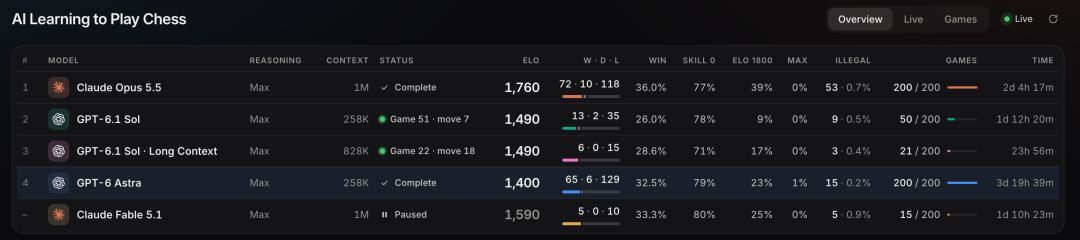
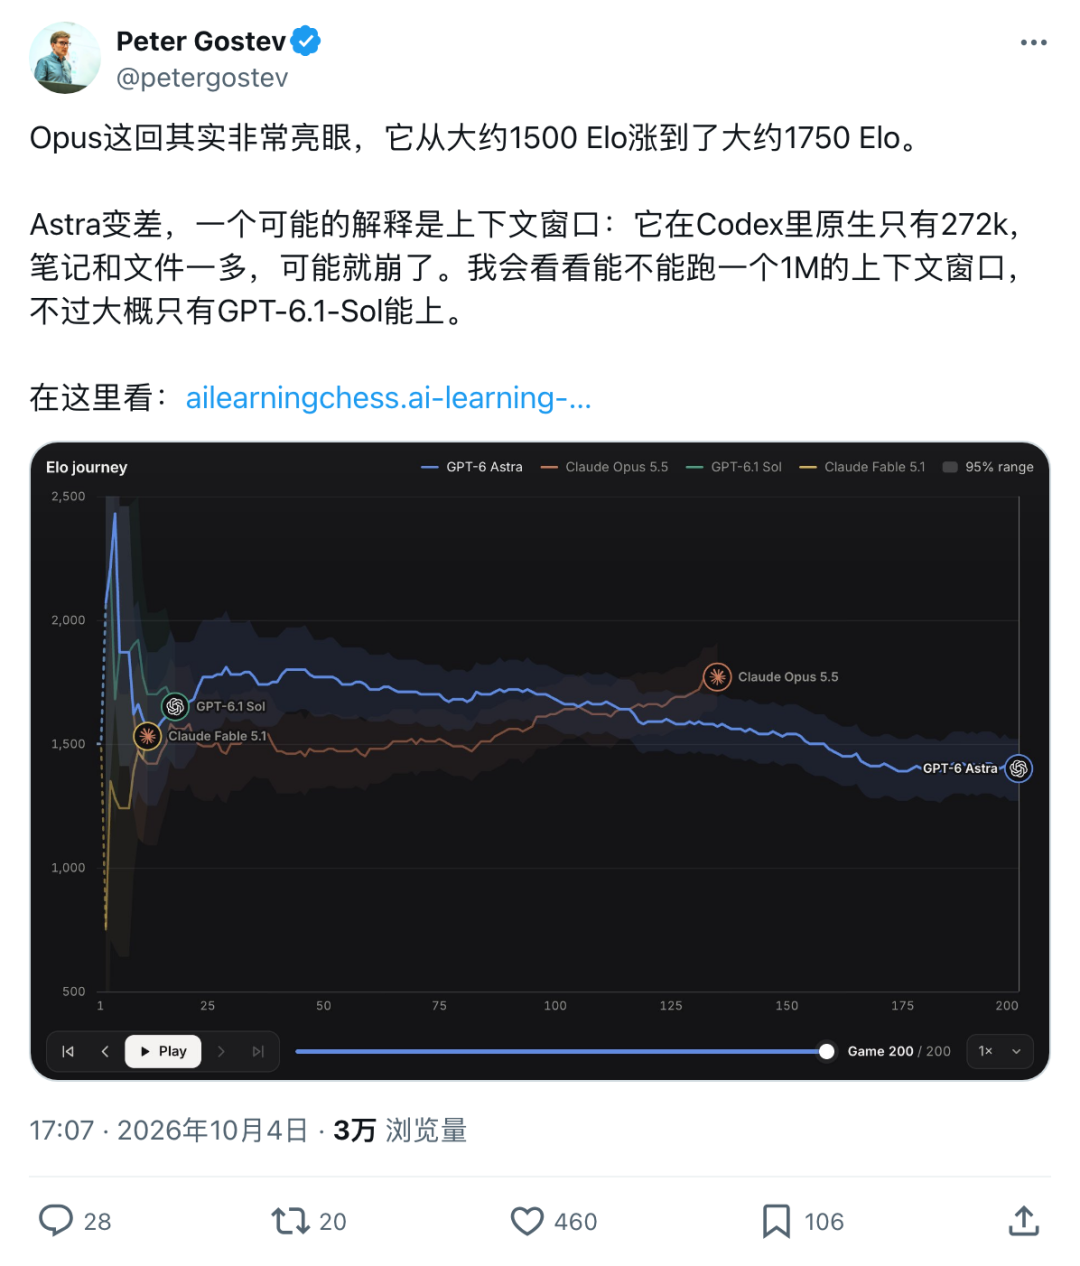
Claude Opus 5.5は序盤にはおおむね1400台半ばから1500台半ばを推移し、その後1700台後半へと上昇しました。GPT-6 Astraはより強くスタートし、第29局付近で一時1810に到達したものの、その後は低下を続け、第200局を1400で終えました。
この実験は、あるモデルがもう一方より普遍的に「賢い」ことを証明するものではありません。
より限定的で、そしておそらくより興味深い問いを投げかけています。
固定された重みを持つ言語モデルは、自身のコンテキスト内に蓄積された経験を通じて改善できるのか。
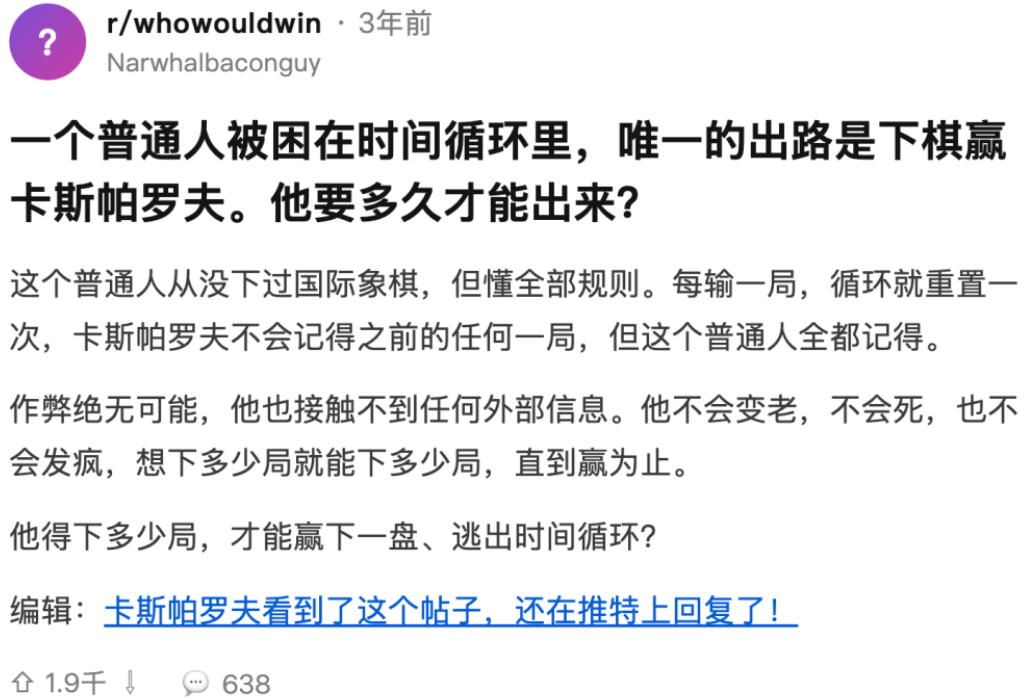
この設定は、古くからあるRedditの思考実験をすぐに想起させました。
シナリオは単純です。ある普通の人がチェスのルールは知っているものの、本格的に対局した経験はありません。この人物はタイムループに閉じ込められ、元世界チャンピオンのGarry Kasparovに勝利しなければ脱出できません。
その人物が負けるたびに、時間はリセットされます。
Kasparovは前の対局を忘れます。
挑戦者だけは、すべてを記憶しています。
問われているのは、総当たりによって最終的にチェスを列挙できるかどうかではありません。保持された経験を、繰り返しの試行をまたいで有用な改善へ変換できるかどうかです。
一部のコメント投稿者は、Kasparovの前回の手を記憶し、手番の色を変えた後に再利用するなど、巧妙な戦略を提案しました。
Gostevのベンチマークは、この思考実験を現代のAIエージェントで検証可能なものにしています。
Stockfishは前の対局から学習しません。
言語モデルも重みを更新しません。しかし、メモやファイルを保持し、後続の対局でそれらを読むことはできます。
これにより、このテストは永続的なインコンテキスト適応の一形態となります。
各モデルには、同じ高水準の目標が与えられました。
Stockfishと最大200局チェスを指すこと。
対局から学び、より強くなること。
難易度を自分で選び、有用であればメモを残すこと。
指し手を選ぶためにチェスエンジンを使用しないこと。
Gostevは、モデルに手作業で作成したチェスのカリキュラムを与えることを意図的に避けました。
コメント投稿者は特定のオープニングや戦略を教えることを提案しましたが、それでは検証する問い自体が変わってしまうため、彼はその方法を採用しませんでした。
彼が確認したかったのは、モデルが独自の改善プロセスを発見できるかどうかでした。
この実験では、3つの対戦相手設定が用意されました。
モデルは、どの対戦相手と指すかを選択できました。
Gostevによると、モデルは平均して対局の約3分の1で勝利しました。これは、毎回フル強度のStockfishに挑戦することを強制されていなかったため可能です。
実装はモデルファミリーごとに異なっていました。
両システムは、対局をまたいで永続ファイルまたはメモを利用できました。
モデルは過去の対局を分析し、リマインダーを書き、練習戦略を変更し、対戦相手の強さを決めることができました。
ただし、指し手の選択をチェスエンジンに外注することはできませんでした。
Gostevは、モデルがエンジンを使って代わりに指した場合はその実行を無効にすると述べ、コメント投稿者から可能性が指摘された後、Opus 5.5を手動で確認しました。
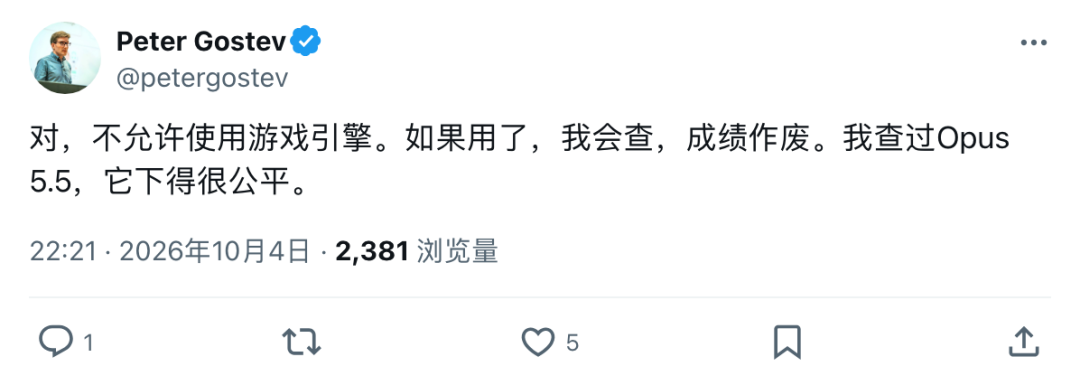
この制約は不可欠です。
これがなければ、テストはエージェントがStockfishの呼び出し方を発見できるかを主に測るものになり、経験から自身のチェス推論を改善できるかを測るものではなくなります。
表示されるEloは慎重に解釈する必要があります。
情報元のページによると、このベンチマークは、Skill 0およびおよそ1800強度のStockfish構成に対するモデルの直近50局からEloを推定しています。
フル強度のStockfishとの対局は、Elo計算に含まれていません。
つまり、次のようになります。
実験Elo ≠ 公式の人間チェスレーティング
1760という表示スコアは、Claude Opus 5.5が1760レーティングの人間のトーナメントプレーヤーと同等に指せることを意味するものではありません。
この値は、主に内部的なトレンド指標として有用です。
この実行は時間とともに改善しているか。
横ばいを維持しているか。
悪化しているか。
これは、OpusとAstraの分岐を興味深いものにするには十分です。
Claude Opus 5.5は、劇的な上昇曲線で始まったわけではありません。
最初のおよそ75局では、推定Eloは主に1450から1550の間で推移しました。第46局付近では、およそ1450まで下落しました。
その後、トレンドは変化しました。
情報元は、次の節目を報告しています。
| 実行中の時点 | およそのElo |
|---|---|
| 初期フェーズ | 1450~1550 |
| 第46局 | 1450 |
| 第100局 | 1620 |
| 第150局 | 1790 |
| 最高値 | 1840 |
| 第194局付近/最終スナップショット | 1760 |
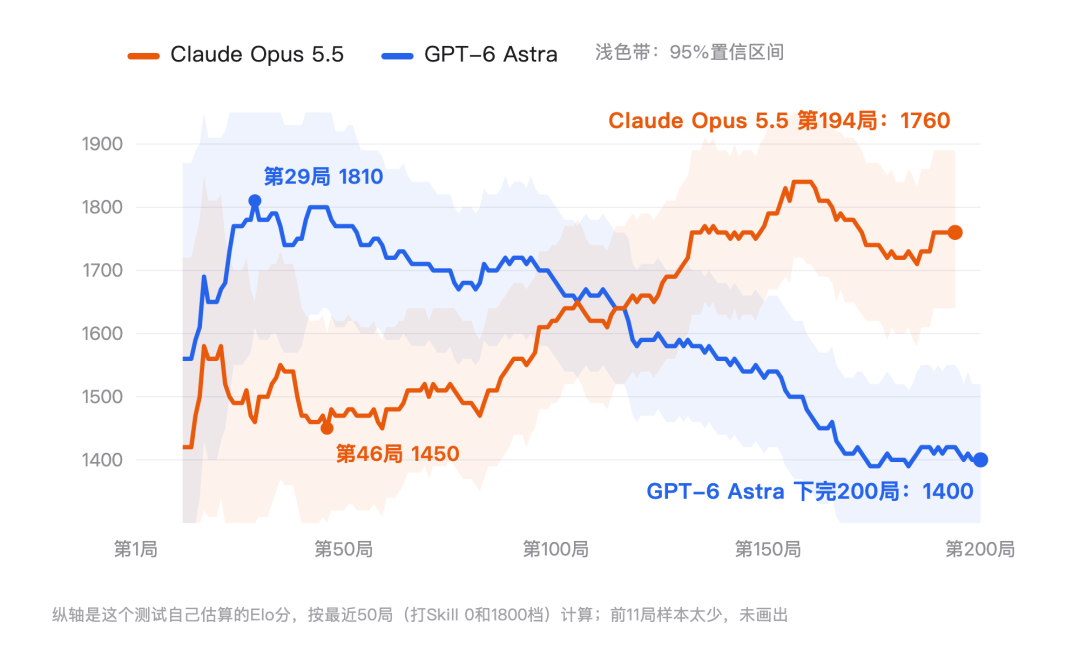
曲線は直線ではありません。
Opusは改善し、低下し、回復してより高いピークに達した後、そのピークを下回る水準で落ち着きました。
だからこそ、最後の1つの数値だけを見るより、軌跡を観察する方が多くの情報を得られます。
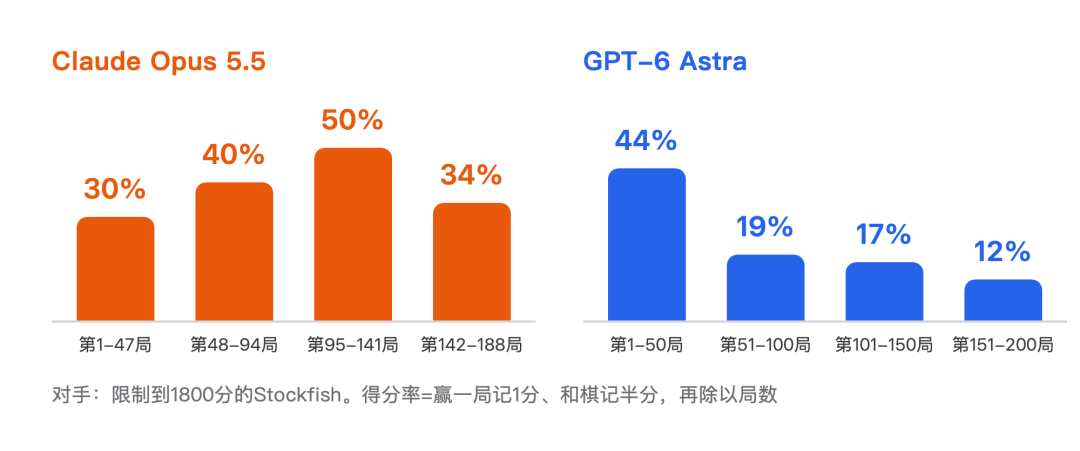
この実験では、およそ1800強度の対戦相手との対局を段階別にグループ化しました。
Opus 5.5について報告された得点率は、おおむね次のように推移しました。
30% → 40% → 50% → 34%
最後の区間はピークから低下したものの、開始時の区間を上回っていました。
Skill 0に対しては、情報元によると、Opusは実行初期の50%をやや上回る水準から、後半には約90%へと上昇しました。
Gostev自身の解釈も、時間とともに確信を増していきました。
当初、彼はOpusが小さなプラスの伸びを示しているが、まだランダムな変動である可能性があると述べていました。
その後、モデルがおよそ1500からおよそ1750へ上昇した時点で、彼は結果を非常に強力だと評価しました。
改善は、完全なルール処理を意味するものではありません。
このベンチマークは、試みられた違法手も追跡しました。
情報元によると、Opusは52回の違法手を試みており、そのうち37回は、経路を塞いでいる別の駒を飛び越えて駒を動かそうとした事例でした。
これはElo曲線に対する重要な反証材料です。
モデルは全体としてより効果的になりながらも、局所的には驚くほど基本的なミスを続けることがあります。
これは言語モデルエージェントで繰り返し見られるパターンです。個々の推論の失敗が目に見えて残っていても、集計されたタスク性能は改善し得ます。
最も重要な欠落部分は、内部の学習戦略です。
Gostevは、完全なメモ履歴や、Opusが対局ごとに練習行動をどのように変えたかについての詳細な分析を公開していません。
したがって、この実験は次のような結果を示しています。
固定された重み
+ 永続メモ
+ 繰り返し対局
→ 測定性能の向上
しかし、そのメカニズムをまだ完全には説明していません。
Opusはオープニングを学んでいたのでしょうか。
繰り返し起きる戦術上のミスを保存していたのでしょうか。
対戦相手の選択を変えていたのでしょうか。
盤面表現や着手確認を改善していたのでしょうか。
完全なメモと統制されたアブレーションがなければ、これらの問いは未解決のままです。
Astraの軌跡は、ほぼ逆でした。
スタートは好調でした。
第29局付近で、実験は推定Elo 1810を記録しました。
その後、曲線は下向きに動きました。
情報元は、次の数値を報告しています。
| 実行中の時点 | およそのElo |
|---|---|
| 第29局 | 1810 |
| 第100局 | 1680 |
| 第150局 | 1540 |
| 第200局 | 1400 |
およそ1800レベルのStockfishに対して、報告された得点率は4つの区間で低下しました。
44% → 19% → 17% → 12%
Skill 0に対してさえ、情報元によるとAstraの勝率は実行前半の90%超から、後半には約60%まで低下しました。
このモデルはOpusと同様に永続的な記録へアクセスできました。
しかし、より多くの経験の蓄積は、より良い結果を生み出しませんでした。
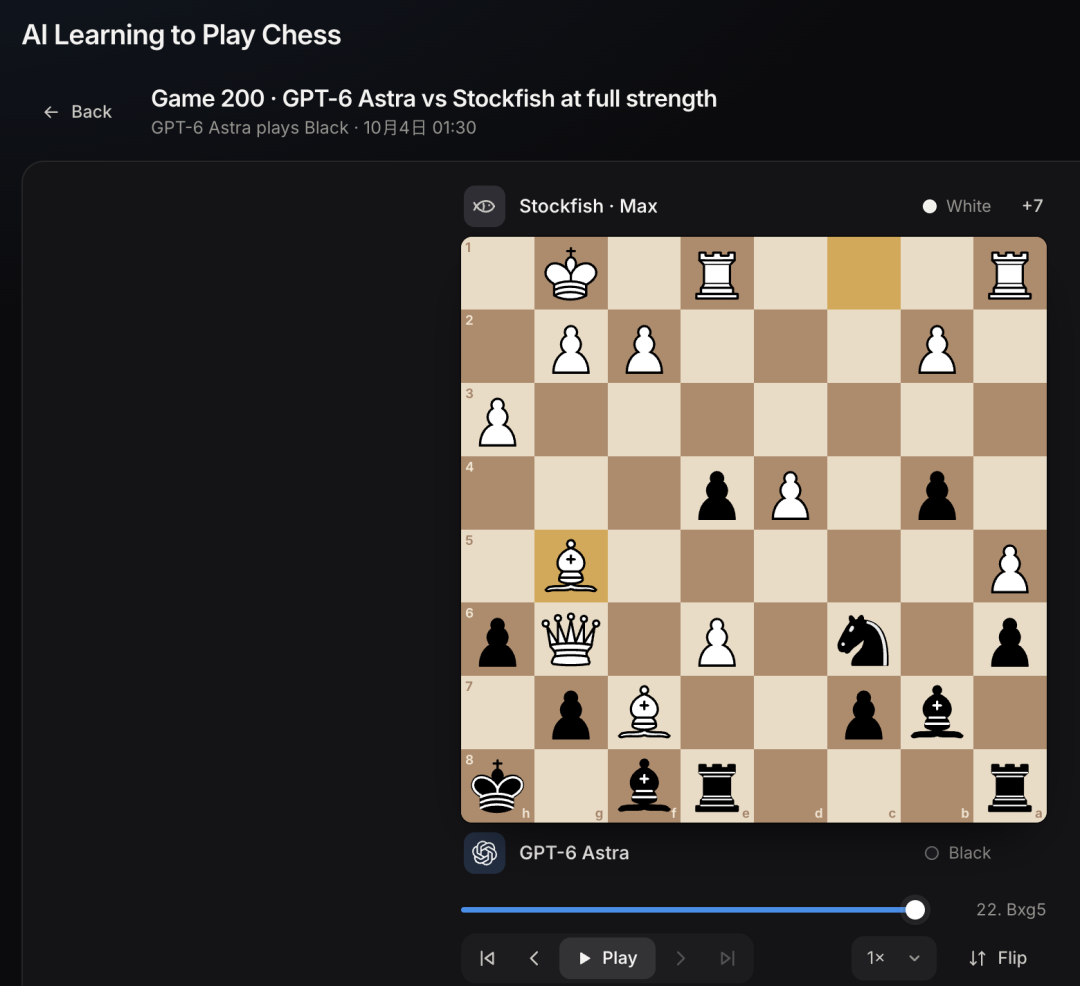
実験ダッシュボードは、Astraが推定Elo 1400で200局を完了したことを示しています。
情報元によると、Astraはフル強度のStockfishとも68局対戦し、勝利はありませんでした。
現代のStockfishが非常に強力であることを考えれば、これは驚くべきことではありません。しかし、ベンチマークで有用なシグナルが最大強度のStockfishを打ち負かそうとすることではなく、主に強さを制限した設定から得られる理由を補強しています。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
Gostevは、考え得る説明としてコンテキスト管理を提案しました。
実行をまたいでメモやファイルが蓄積されるにつれ、エージェントは処理すべき過去の素材をより多く抱えることになります。
彼は、Astraに使用されたCodex構成では実行におよそ272Kのコンテキスト予算が与えられており、蓄積メモがより大きくノイジーになるにつれて性能が低下する可能性があると示唆しました。
この仮説は、よく知られたユーザー体験と一致します。
より多くのコンテキスト
≠ 自動的により良いコンテキスト
長い履歴には、次のものが含まれ得ます。
言い換えれば、メモリは干渉要因になり得ます。
情報元はこの点で慎重であり、最終版も同様に扱うべきです。
この実験だけから、Astraの低下をコンテキスト長に帰することはできません。
因果関係を確立するには、例えば次のような統制比較が必要です。
同一モデル
同一対局
同一ツール
同一プロンプト

実行A:小規模/積極的に要約されたメモリ
実行B:大規模な生メモリ
または、次のような比較です。
同一モデル
同一の学習戦略
同一の対戦相手スケジュール

実行A:258Kコンテキスト構成
実行B:1Mコンテキスト構成
そうして初めて、コンテキストサイズを次のような他の要因から切り分けられます。
ここには、製品レベルで重要な補足もあります。
OpenAIの現行APIドキュメントでは、GPT-6 Astraは1,050,000トークンのコンテキストウィンドウを持つと記載されています。
ベンチマークのスクリーンショットではAstraの実行が約258Kで構成され、GostevはCodexでおよそ272Kと述べていました。
したがって、この実験はAstraを最大APIコンテキストサイズでテストしたものではありません。
この点は重要です。見出しとしての適切な解釈は、次のとおりです。
Astraは、この特定の永続メモリエージェント構成で低下した。
以下のような主張ではありません。
Astraのアーキテクチャは長大なコンテキストを扱えない。
この2つはまったく異なる主張です。
Gostevは、コンテキストに関する問いに対応して別のトラックを追加しました。
情報元によると、彼ははるかに大きなコンテキスト構成を備えたGPT-6.1 Sol実行を発表し、その直後、ベンチマークページにはおよそ828Kの専用長大コンテキストレーンが表示されました。
情報元の記事が執筆された時点では、GPT-6.1 SolとClaude Fable 5.1は200局のうちごく一部しか完了していませんでした。
ダッシュボードのスナップショットには、次の内容が含まれていました。
| モデル | 情報元スナップショット時点の対局数 | およそのElo | 状態 |
|---|---|---|---|
| Claude Opus 5.5 | 200 | 1760 | 完了 |
| GPT-6 Astra | 200 | 1400 | 完了 |
| GPT-6.1 Sol | 約50 | 約1490 | 実行中 |
| GPT-6.1 Sol Long Context | 約21 | 約1490 | 実行中 |
| Claude Fable 5.1 | 15 | 約1590 | 一時停止 |
これらの部分的な実行は、完了したOpusとAstraの実行と同種の軌跡分析を支持するには、まだ早すぎました。
OpenAIは現在、GPT-6.1 Solについて1.05Mトークンのコンテキストウィンドウを公式に文書化しています。そのため、長大コンテキストレーンは注目すべき有用な追試です。しかし、因果関係の問いに答えるには、十分な対局数と統制された分析がなお必要です。
これがチェス実験の背景にある、より大きな問いです。
従来のモデル訓練は、デプロイ前に終了します。
一度重みが固定されると、通常、モデルは会話のたびに自身を恒久的に書き換えることはありません。
しかし、別の種類の適応があります。
インコンテキスト学習です。
モデルは、新しい情報を読み、それを作業コンテキストまたは永続ファイル内に保持し、パラメータを変更せずに後から異なる振る舞いをすることができます。
チェスベンチマークは、この考え方を多数の反復試行にまたがって検証しています。
モデルは敗局を経験し、何かを書き留め、その教訓を後の対局に持ち込めます。
流れは次のようになります。
第1局
→ 負ける
→ 観察を記録する

第2局
→ 前のメモを読む
→ 別の試みをする
→ メモを更新する

第3局
→ 蓄積した経験を再利用する
→ 続ける
時間とともに性能が向上するなら、そのシステムはニューラルネットワークの重みが固定されたままであっても、実践的な学習の一形態を示していることになります。
Oriol Vinyalsもこの実験にコメントし、有望なインコンテキスト学習ベンチマークだと評しました。
この枠組みは、結果を過大に主張しないために有用です。
このベンチマークは、自律的な重み更新を実証しているわけではありません。
固定された重みの周囲に、モデルが独自の足場を構築できるかをテストしています。
メモ
+ ファイル
+ 繰り返しの試行
+ 自己反省
+ 環境フィードバック
そして、その足場を用いて改善できるかを検証しています。
Gostevの元の投稿も同じ区別をしています。
彼は、最も強い意味での真の継続学習はまだ実現していない一方、外部メモリを構築し、それを通じて学ぶことで、モデルがその振る舞いの一部を近似できる可能性があると述べました。
情報元は、モデルが人間による再訓練なしに繰り返しの経験を通じてより強くなれるかもしれない、という楽観的な見方で締めくくられています。
この実験は、その可能性を支持するいくつかの証拠を示しています。
ただし、この問題を解決したわけではありません。
いくつかの限界が残ります。
チェスは構造化され、決定論的で、明確なフィードバックを提供します。
繰り返しのチェス対局から学ぶことは、曖昧な現実世界の調査、コーディング、医療、またはビジネスタスクで改善することとは異なります。
これは実験の一部ですが、比較を難しくする要因でもあります。
OpusとAstraが異なるタイミングで異なる強さの対戦相手を選んだ場合、両者は同一の学習シーケンスにさらされていませんでした。
表示されるEloは実行を追跡するには有用ですが、標準化された人間のレーティングではありません。
メモが改善を引き起こしたかを知るには、次のような比較が求められます。
Opusは大幅に伸びながらも、違法手を試み続けました。
これは、「より良い」ことがすべての下位スキルにおける安定した熟達を意味しないことを示しています。
永続的なノートブックが自動的に有用になるわけではありません。
Astraの実行は、自己生成されたメモリには有用な教訓と同じくらい容易に誤りが蓄積し得ることを示しています。
将来の継続学習エージェントは、何を記憶すべきかだけでなく、次のことも学ぶ必要があるかもしれません。
これは、メモリ管理を長期間稼働するAIエージェントの中心的な課題の1つにする可能性があります。
両モデルが着実に改善していれば、結論は単純だったでしょう。永続メモは役立つ、ということです。
両モデルが着実に低下していれば、結論も同じく単純だったでしょう。統制されていないメモリの蓄積は有害である、ということです。
しかし、このベンチマークは2つの正反対の曲線を生み出しました。
これは、より科学的に興味深い結果です。
経験から利益を得る能力は、利用可能なコンテキスト長だけでは決まらないことを示唆しています。
モデルは、そのコンテキストの内部で有用な学習プロセスを構築しなければなりません。
強力な永続エージェントには、次のすべてが求められる可能性があります。
失敗を観察する
→ 正しい教訓を特定する
→ 簡潔に保存する
→ 後で取り出す
→ 1つの事例への過剰適合を避ける
→ 悪い記憶を修正する
→ 新しい状況で教訓を適用する
これは、重みが決して変わらないとしても、静的なチャットボットよりはるかに学習システムに近いものです。
Peter Gostevは、最先端AIエージェントに異なるStockfish難易度設定との対局を最大200局行わせ、対局間でメモを保持させました。実行中にモデルはファインチューニングされず、指し手の選択にチェスエンジンを使用することも許可されませんでした。
ベンチマーク独自の推定Elo指標の範囲では、はい。情報元は、Opusが約1500から約1760へ上昇し、最高値は約1840だったと報告しています。この数値は、強さを制限したStockfishとの直近の対局に基づく内部実験レーティングであり、公式の人間FIDEレーティングとして扱うべきではありません。
この実験は、確定した原因を示していません。Gostevは、Codexコンテキスト内にメモが蓄積したことが寄与した可能性を示唆しましたが、メモの質、対戦相手の選択、プロンプトドリフト、ランダム変動、その他の要因も影響し得ます。
いいえ。OpenAIは現在、GPT-6 Astraについて1.05Mトークンのコンテキストウィンドウを文書化しています。実験で議論された約258K/272Kという数値は、その実行に使われたCodexまたはベンチマーク構成を指しており、Astraの最大APIコンテキストではありません。
はい。Anthropicは2026年9月22日にClaude Opus 5.5を公式発表しました。同社はこれをOpus 5の大幅なアップグレードとして位置付け、コーディングおよびエージェント型ワークロード向けに文書化しています。
インコンテキスト学習とは、モデルがニューラルネットワークの重みを更新せず、コンテキストまたは永続ファイルに含まれる情報を使って振る舞いを変えることを指します。ここでは、チェスの対局とメモが、後続の対局に影響を与え得る蓄積経験として機能します。
このベンチマークは、言語モデルにとって測定可能な性能範囲を作るため、より弱いStockfish構成を使用しています。フル強度のStockfishは現在の言語モデルによるチェス対局をはるかに上回るため、これらの対局を実験Eloの推定に直接含めても、改善を追跡するうえでの情報量は少なくなります。
いいえ。少なくとも1つのモデル実行が、1つの構造化タスクにおいて、永続コンテキストと繰り返しの経験を通じて大幅に改善したことを示しています。堅牢な継続学習を実証するには、多数のタスク、メモリ戦略、モデル構成、反復試行にわたる統制実験が必要です。
Peter Gostevのチェス実験では、Claude Opus 5.5とGPT-6 Astraに、モデルの重みを変更せずに自身の対局から学ぶ機会が繰り返し与えられました。Opusの実験Eloはおよそ1500から1760まで上昇した一方、Astraは早期にピークを迎え、第200局までに1400へ低下しました。
この結果が興味深いのは、どちらのモデルが「チェスでより優れているか」を決着させるからではありません。メモ、ファイル、反復フィードバックを通じてモデルが有用な経験を構築できるか、そしてそのメモリがノイズや積極的に有害なものへ変わるのを防げるかという、永続エージェントに関するより深い問いを明らかにするからです。
Astraの低下は、依然として説明されていません。コンテキストの蓄積はもっともらしい仮説の1つですが、因果関係を主張するには、統制されたメモリおよびコンテキストウィンドウの実験が必要です。
このベンチマークから得られる最も強い教訓は、固定されたモデルの重みが固定された振る舞いを保証するわけではない、ということです。エージェントが何を記憶し、どのようにそのメモリを整理し、失敗からどう学ぶかによって、性能は時間とともに大きく上昇することも、下降することもあります。
ひとことから始めて、数分で完全なサイトを手に入れましょう。