Anthropicは、Claude Sonnet 5.5とHaiku 5.5がOpus 5.5に続いて「今後数週間以内」に登場すると説明していました。
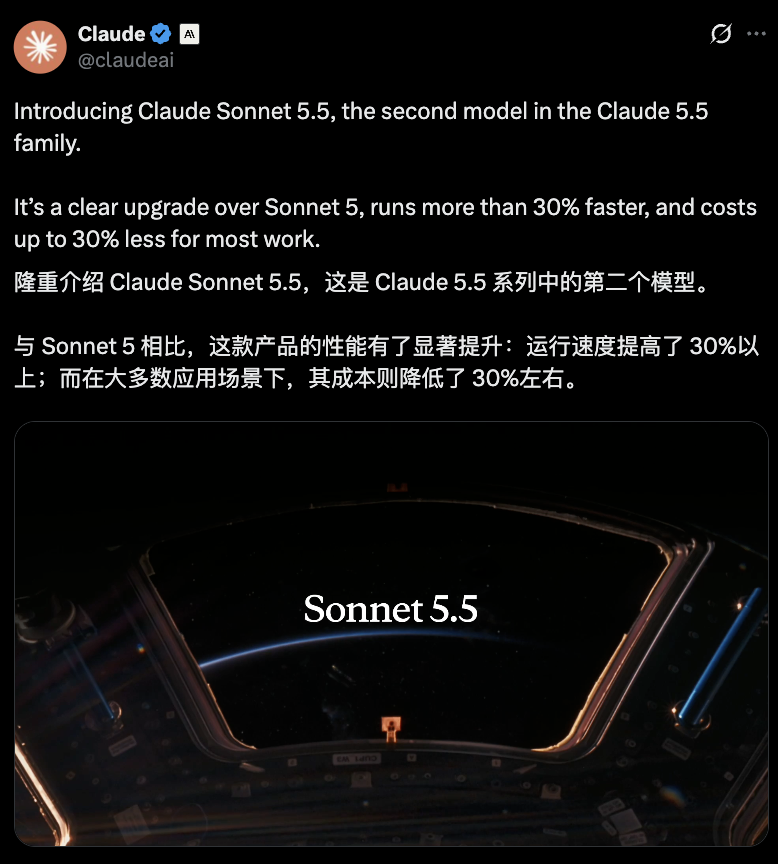
Sonnet 5.5は、わずか6日後にリリースされました。
新しい中位モデルのClaudeは、単にOpus 5.5を小型化したモデルではありません。一部のコーディングベンチマークでは、実際により高いスコアを記録しています。
最も注目を集める例が、Terminal-Bench 4.0です。
Claude Sonnet 5.5: 70.6%
Claude Opus 5.5:   66.4%
Claude Sonnet 5:   10.3%
ただし、より幅広い専門業務では、Opus 5.5が依然として僅差でリードしています。
Anthropicの報告値は次のとおりです。
GDPval-AA v2.1
Opus 5.5:   1846 Elo
Sonnet 5.5: 1844 Elo

OSWorld 2.1
Opus 5.5:   81.8%
Sonnet 5.5: 80.1%
この結果から、Sonnet 5.5は複数の測定可能なタスクでAnthropicのフラッグシップモデルに異例なほど近い性能を保ちながら、より低いSonnet価格帯を維持していることが分かります。
ただし、両モデルの違いは依然として重要です。
Anthropicによると、長時間にわたって継続的な判断が必要な複雑で自由度の高い業務では、Opus 5.5が依然として明確に優れています。一方、Sonnet 5.5は次のような、範囲が明確な日常業務により直接的に向けられています。
- コーディング
- バグ修正
- コードレビュー
- 文書作成
- スライド作成
- スプレッドシート作成
- 構造化されたエージェントタスク
- 高速な反復ワークフロー
したがって、実用的な結論は、Sonnet 5.5がOpusを「置き換えた」ということではありません。
多くの日常的かつコーディング中心のワークロードで、性能差が大幅に縮まったということです。
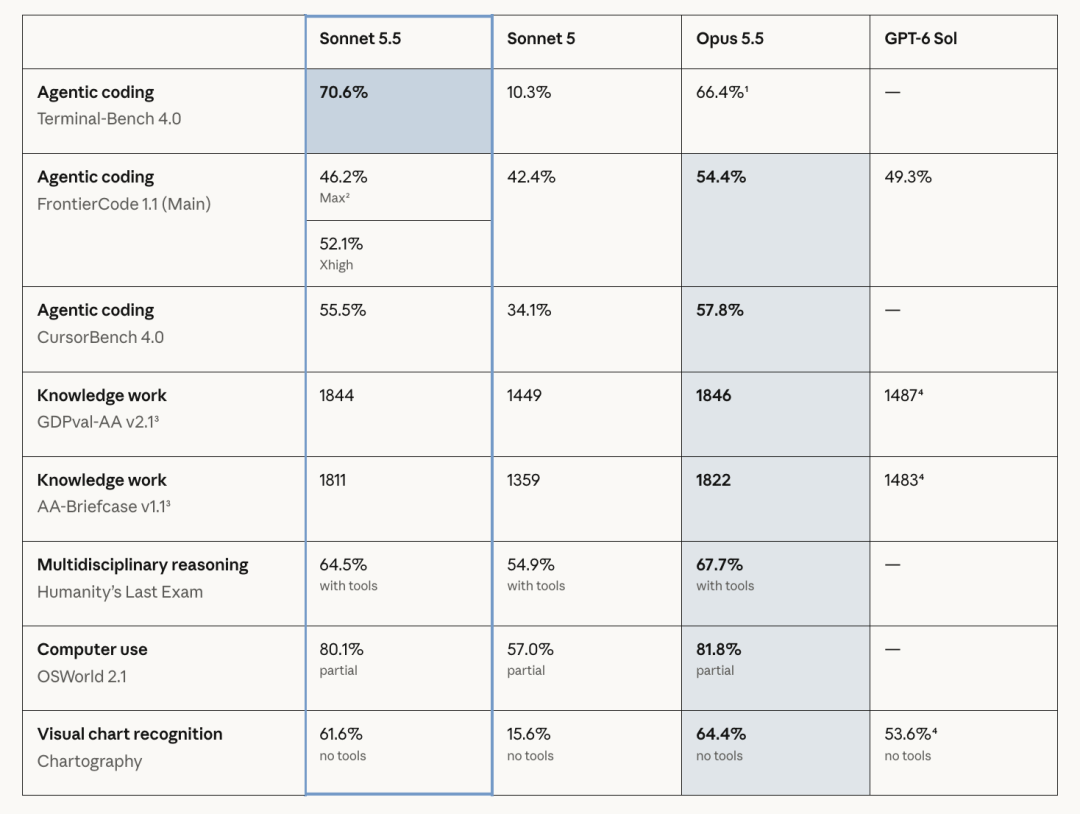
元の記事では、Sonnet 5.5を「大きなカップ」を追う「中くらいのカップ」と表現しています。
この比喩は、ベンチマーク表にも驚くほどよく当てはまります。
| 評価 | Sonnet 5.5 | Opus 5.5 | Sonnet 5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 66.4% | 10.3% | — |
| FrontierCode 1.1 Main | 52.1%(Xhigh) | 54.4% | 42.4% | 最大52.1% |
| CursorBench 4.0 | 55.5% | 57.8% | 34.1% | — |
| GDPval-AA v2.1 | 1844 | 1846 | 1449 | 1487 |
| Humanity's Last Exam | 64.5% | 67.7% | 54.9% | — |
| OSWorld 2.1 | 80.1% | 81.8% | 57.0% | — |
| Chartography | 61.6% | 64.4% | 15.6% | 53.6% |
この表から、実際の傾向が分かります。
Sonnet 5.5は重要なコーディングベンチマークの1つで明確に勝利し、複数の評価でも非常に近い結果を出しています。しかし、Opus 5.5をすべての評価で上回っているわけではありません。
Anthropic自身も同じ点を指摘しています。ベンチマークスコアはモデル品質を測る1つの視点にすぎず、タスクが曖昧で自由度が高い場合や、長時間にわたる継続的な判断が必要な場合には、Opusのほうが優れています。
Sonnet 5.5はツールをより効率的に利用
今回のアップグレードは、単なるスコアの向上にとどまりません。
初期のテスターは、Sonnet 5.5の作業方法そのものが変わっていることにも気づきました。
Sonnet 5と比較すると、タスクを並列実行できる場合、すべてを1つずつ処理するのではなく、ツール呼び出しをまとめて実行する傾向が強くなっています。
Anthropicが紹介した顧客フィードバックには、あるコーディング評価でSonnet 5.5が次のような実績で同種のタスクを完了した例があります。
ツール呼び出し:約3分の1減少
シェル実行:約半分
これはエージェントシステムにとって重要です。追加のツール呼び出しはそれぞれ、次の要素を増加させる可能性があるためです。
- レイテンシ
- トークン消費量
- インフラコスト
- 失敗リスク
- 管理が必要な追加状態
同じ回答に、より少ないツール操作で到達できるモデルは、表示上のトークン価格が変わらなくても、実質的に安くなる可能性があります。
Base44:反復回数を半分にして同等の結果
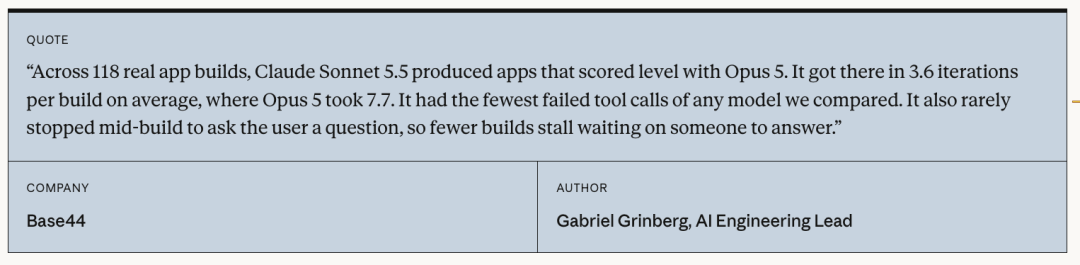
Base44は、118件の実際のアプリケーション構築タスクでSonnet 5.5をテストしました。
報告された結果は、特に実用的なものでした。
Sonnet 5.5はOpus 5と同じ水準のスコアを持つアプリを生成しながら、必要な反復回数は次のとおりでした。
Sonnet 5.5:
1ビルドあたり平均3.6回の反復

Opus 5:
1ビルドあたり平均7.7回の反復
Base44はさらに、比較対象のどのモデルよりもSonnet 5.5のツール呼び出し失敗が少なかったと説明しています。
これは、「モデルのコスト」が単に次の合計ではないことを示しています。
入力トークン価格
+
出力トークン価格
実際のエージェントワークフローでは、総コストは次の要素にも左右されます。
反復回数
ツール呼び出し回数
失敗した操作
再試行
人による中断
受け入れ可能な結果に到達するまでの時間
あるモデルが半分の反復回数で完了するなら、API料金表が示す価格差よりも、実効コストの差ははるかに大きくなる可能性があります。
Epic Gamesは大規模なコードベースでテスト
Epic Gamesは、より大規模なソフトウェアシステムでSonnet 5.5をテストしました。
Anthropicが公開した顧客フィードバックによると、このモデルは数万行に及ぶゲームプレイシステムのコードを扱い、次のようなタスクを実行しました。
- システム設計の監査
- データフローのレビュー
- 数時間にわたるコーディングタスク
Epic Gamesは、このモデルが通常は上位モデルに期待される品質基準に達しながら、より細かく指示するプロンプトを必要としなかったと説明しています。
これは、小型モデルが価値を持つ典型的なワークロードです。
開発者はアーキテクチャの定義や、最も難しく曖昧な問題の解決にはOpus 5.5を使いたいかもしれません。しかし、実装やレビューの大部分は、より低いコストのSonnet 5.5に任せることができます。
Unityはプロジェクトが実行できた場合にのみタスクを完了と判定
Unityは、より厳格な完了基準を採用しました。
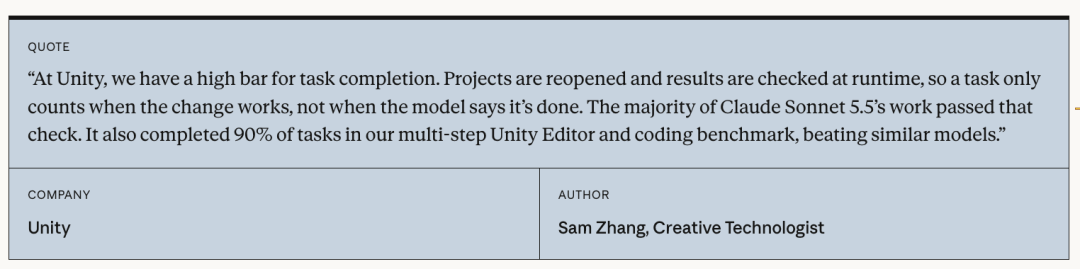
モデルが完了したと説明したという理由だけでコードパッチを受け入れるのではなく、Unityはプロジェクトを再度開き、結果が実行時に実際に機能するかを確認しました。
この評価で、Sonnet 5.5はUnityの複数ステップEditor・コーディングベンチマークにおいて、次の割合のタスクを完了しました。
90%
このようなテストは、コード生成の品質だけを見るよりも有益です。
パッチは正しそうに見えても、次の理由で失敗する可能性があります。
- 依存関係の不足
- 不正なプロジェクト状態
- ビルドエラー
- 実行時の想定違い
- ツール利用のミス
- 要求された範囲外の変更
Unityのベンチマークは、テキストによる回答だけでなく、実際のエンドツーエンドのタスクを測定しようとしています。
Sonnet 5.5はスクリーンショットだけでPokémon Redをクリア可能
Anthropicは、長期的なタスクを扱う定期的なデモンストレーションの1つも継続しました。
Sonnet 5.5は、スクリーンショットだけを見ながらPokémon Redをクリアした、Claudeファミリー初のSonnetモデルになりました。
このテストは、コーディングベンチマークとして直接役立つものではありません。
その価値は別のところにあります。
ゲームを進めるには、モデルは次の能力を必要とします。
- 視覚的な状態の解釈
- 長期目標の記憶
- 多数のステップにまたがる計画
- ミスからの回復
- 長い期間にわたる行動の継続
これらの特性は、コンピューター操作エージェントや長時間稼働するソフトウェアワークフローでも重要です。
デザインやオフィス業務も改善
元の記事では、Sonnet 5.5がコード以外の分野でも能力を高めている点が指摘されています。
Anthropicは、洗練された文書、スライド、スプレッドシート、ビジュアル作業にもこのモデルを位置づけています。
このモデルは、すべての成果物をゼロから作るのではなく、既存のビジュアル上の規則に従うよう設計されています。
たとえば既存のスライドテンプレートを渡すと、次の要素を同じように使い続けることができます。
- レイアウト
- 余白
- 視覚的な階層
- スタイルの規則
- デザイン言語
Anthropicによると、これにより生成後に必要となる手作業の修正を減らせます。
そのため、Sonnet 5.5は、業務が明確に定義されている一方で、視覚的な一貫性も必要なビジネスワークフローに特に適しています。
API価格は値上げされていない
性能が大幅に向上したにもかかわらず、Sonnet 5.5はSonnet 5と同じ基本API料金を維持しています。
Anthropicが現在提示している料金は次のとおりです。
| トークン種別 | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| 入力 | 100万あたり2ドル | 100万あたり4ドル |
| 出力 | 100万あたり10ドル | 100万あたり20ドル |
| キャッシュ読み取り | 100万あたり0.20ドル | 100万あたり0.20ドル |
| キャッシュ書き込み | 100万あたり2.50ドル | 100万あたり5ドル |
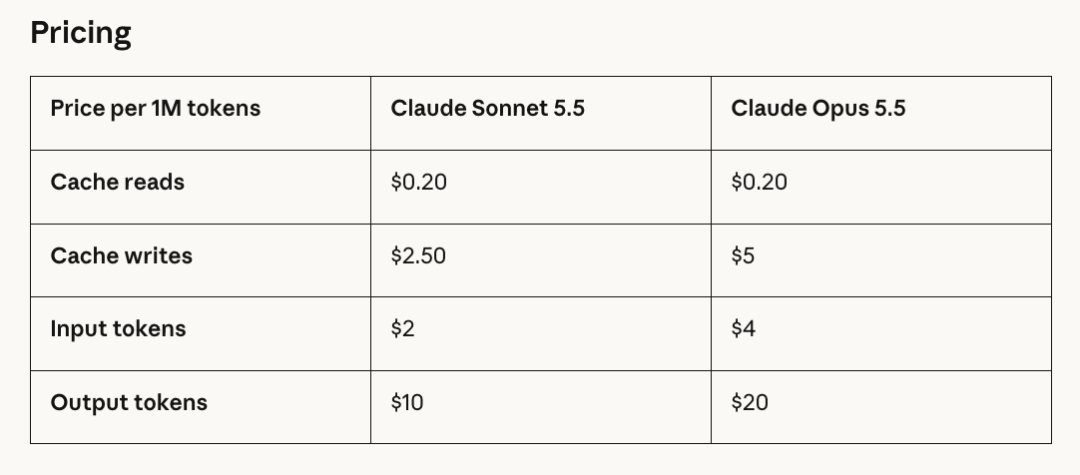
定価ベースでは、Sonnet 5.5の標準的な入力・出力トークンは、Opus 5.5のちょうど半額です。
しかし、Anthropicは現在、別の指標をより重視しています。
完了タスクあたりのコスト
トークン価格が同じでも、タスクあたりのコストは低下
Anthropicによると、Sonnet 5.5はSonnet 5より30%以上高速に出力を生成します。
また、同じ作業を完了するために必要なトークン数やステップ数も、通常は少ないと説明しています。
その結果、Anthropicの報告では、Sonnet 5.5は多くのワークロードでSonnet 5よりも次の割合だけ安くなる可能性があります。
タスクあたり最大30%低下
このため、2ドル/10ドルというトークン単価だけを見ると、今回のアップグレードの一部を見落とすことになります。
数分で紹介サイトを作り、リード獲得を伸ばす
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
名目上の料金は変わっていません。
タスク完了に必要なモデルの処理量が減少したのです。
Terminal-Bench:中程度の推論強度でSonnet 5を大幅に低いコストで上回る
Anthropicは現在、複数の推論強度レベルを提供しています。
高い推論強度では、モデルはより長く推論し、より多くの作業を確認できます。
低い推論強度では、より高速かつ低コストになります。
Claude CodeとAnthropicの一般向けアプリでは、デフォルトの推論強度はMediumです。Claude Platformでは、デフォルトはHighです。
Terminal-Bench 4.0において、Anthropicのコスト・性能チャートでは、MediumのSonnet 5.5が、Sonnet 5の最高結果をすでに上回りながら、1回の試行あたりのコストはおよそ10分の1となっています。
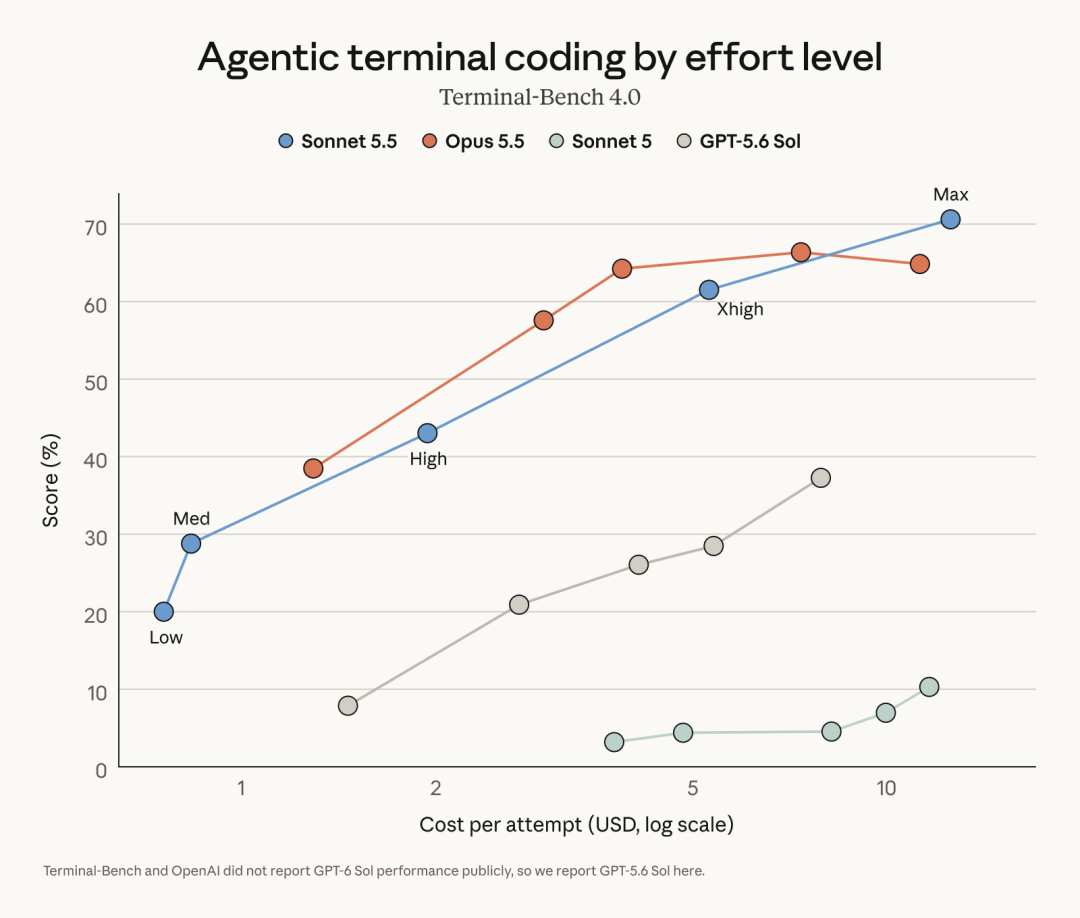
重要なのは、Mediumが常に正しい設定だということではありません。
開発者が品質とコストをより直接的に調整できるようになった点が重要です。
日常的なコーディングでは、低い推論強度でも十分な場合があります。
難しいタスクでは、推論強度を上げることで、Sonnetにより多くの推論時間を与えられます。
CursorBenchでも同様の傾向
CursorBench 4.0は、実際のCursorセッションに基づいてコーディング作業を評価します。
Sonnet 5.5のスコアは次のとおりです。
55.5%
一方、Opus 5.5は次のスコアです。
57.8%
Anthropicのコストチャートでは、比較的低い推論強度でも、Sonnet 5.5がSonnet 5の最高スコアを、タスクあたり約10分の1のコストで上回れることが示されています。
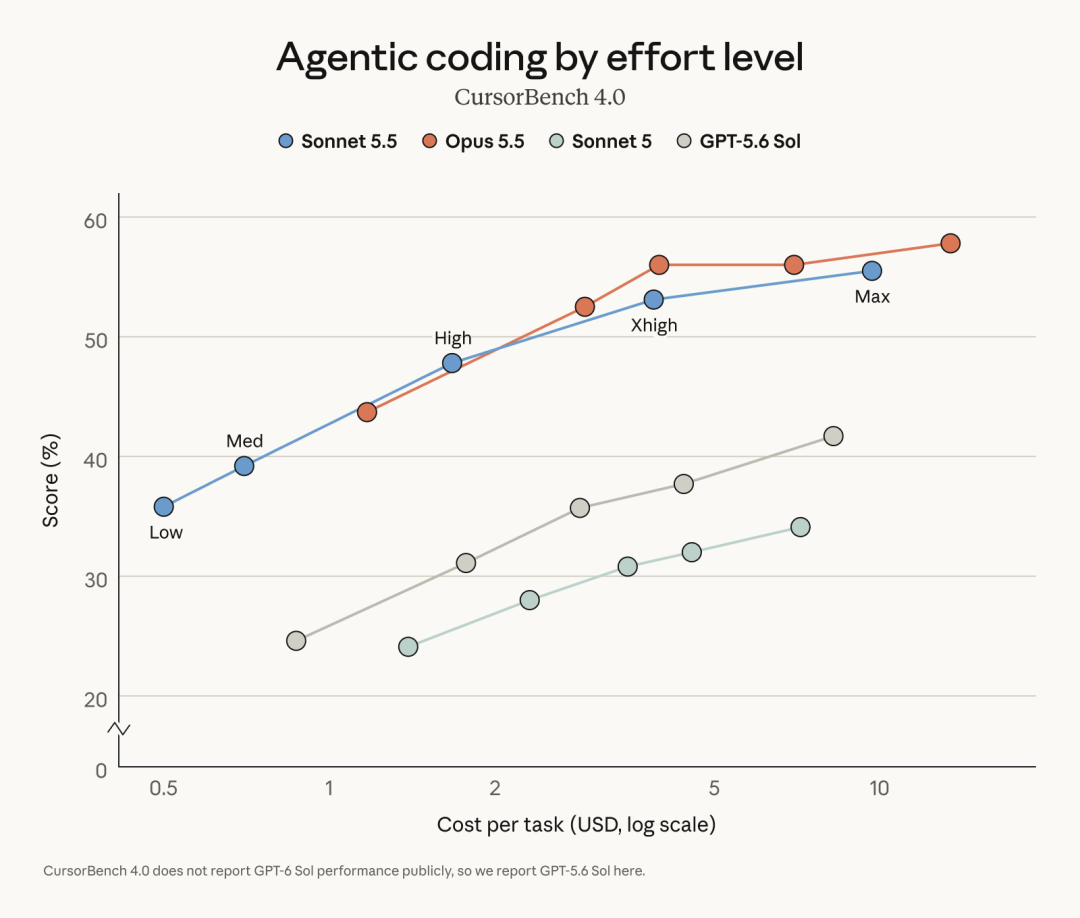
ここで、新しいSonnetの魅力が特に際立ちます。
Opusとのベンチマーク上の絶対的な差が十分に小さければ、大量のコーディングを本番運用する際には、低コストのモデルのほうが適した選択肢になることがあります。
FrontierCodeではSonnet 5.5をGPT-6 Solと比較
元の記事では、FrontierCode 1.1に特別な注目が集まっています。比較対象にGPT-6 Solが含まれているためです。
Anthropicが公開したチャートでは、Sonnet 5.5はXhighの推論強度でFrontierCodeの最高スコアに到達し、GPT-6 Solも設定によって同程度のスコア範囲に入っています。
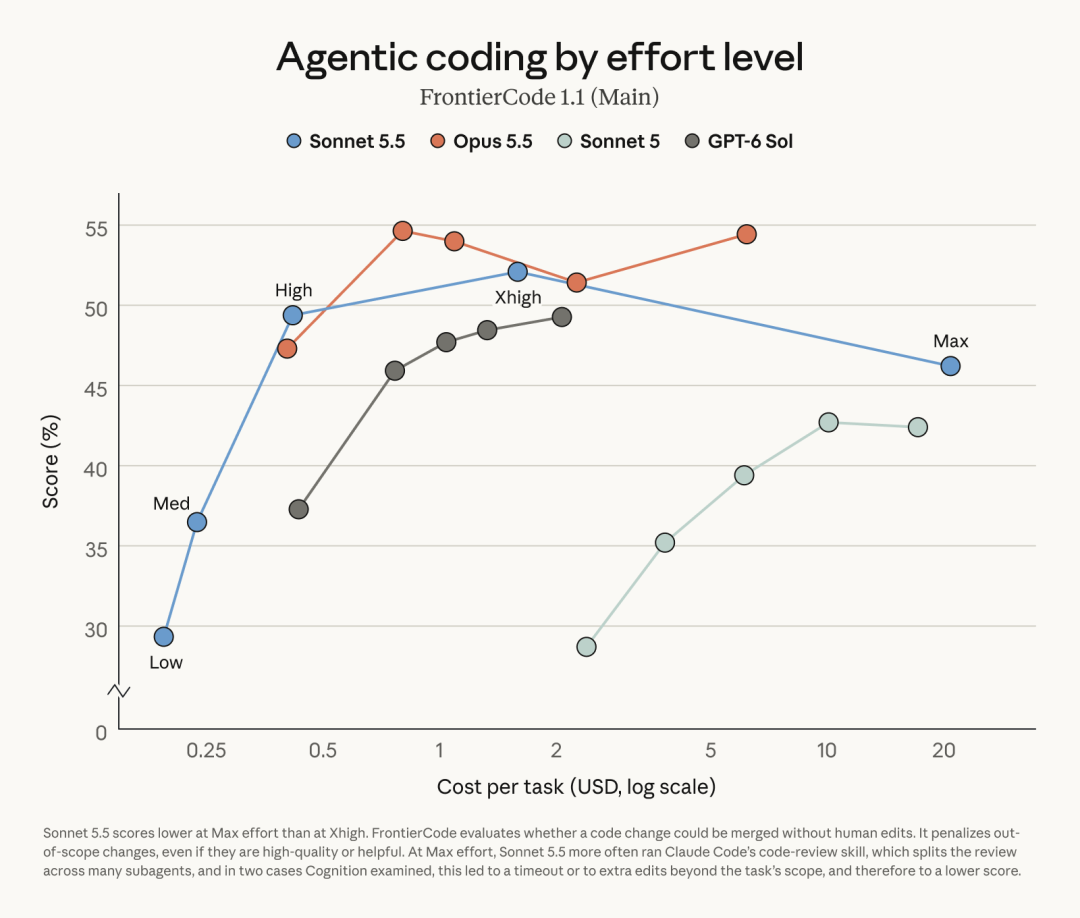
Highの推論強度では、Sonnet 5.5はGPT-6 Solのより強いテスト設定とすでに同程度のスコア範囲にあり、Anthropicはタスクあたりのコストが大幅に低いと推定しています。
元の記事では、Anthropicのチャートで強調された比較点について、差をおよそ次のようにまとめています。
Sonnet 5.5のタスクコスト:
GPT-6 Solの約5分の1
この数値は、特定のベンチマークにおけるタスクあたりのコスト比較として読む必要があり、普遍的なAPI料金比率ではありません。
両モデルには次の違いがあります。
- 料金体系が異なる
- 推論に使用する量が異なる
- 生成するトークン量が異なる
- 必要な再試行回数が異なる可能性がある
- 特定の推論強度設定で比較されている
したがって、Anthropicのベンチマークチャートでは、その設定においてSonnet 5.5が、はるかに低い測定タスクコストでFrontierCodeの同程度の品質に到達していると表現するのが安全です。
これは、SonnetのすべてのワークロードがGPT-6 Solより正確に80%安くなるという意味ではありません。
Sonnet 5.5はOpus 5.5を置き換えない
ベンチマークの見出しだけを見ると、低価格のSonnetモデルによってOpusが不要になったと結論づけたくなります。
Anthropicは、この解釈を明確に否定しています。
Anthropic自身のテストと顧客フィードバックでは、次のような作業ではOpus 5.5が依然として明らかに優れています。
- 自由度の高い推論
- 長時間にわたる継続的な判断
- より曖昧な計画立案
- アーキテクチャ上の意思決定
- 複雑な調査
- 重要度の高い複数ステップの意思決定
したがって、実際のモデル振り分け戦略は次のようになります。
Opus 5.5
→ アーキテクチャ
→ 難しい計画立案
→ 曖昧な調査
→ 最高難度のタスク

Sonnet 5.5
→ 実装
→ バグ修正
→ レビュー
→ 日常的なエージェントタスク
→ 文書・オフィス業務
→ 大量のコーディング
Anthropicのある顧客は、両者の関係を同様に説明しています。Opusにアーキテクチャを定義させ、その後Sonnetに実装させるという方法です。
これは、5.5ファミリーを理解するうえで、おそらく最も実用的な見方です。
コーディング能力の向上に伴い安全対策も強化
元の記事は主に性能とコストに焦点を当てていますが、公式情報の中には注目すべき点がもう1つあります。
Anthropicによると、Sonnet 5.5のサイバーセキュリティ能力は、最も高性能なモデル向けにAnthropicが採用しているものと同様のサイバー安全対策とフォールバック機構を備えてリリースされた、初のSonnetモデルとなる水準まで向上しました。
Anthropicはまた、安全対策が高リスクな要求の一部に限定して適用され、通常のソフトウェア開発を妨げることを目的としていないと説明しています。
これは、コーディングやツール利用の性能向上が、デュアルユースのセキュリティ能力も高める可能性があるため重要です。
Sonnet 5.5はClaudeの各プラットフォームで利用可能
Anthropicによると、Sonnet 5.5は次のサービスから利用できます。
- Claude.ai
- Claude Code
- Claude Platform/API
- Amazon Web Services
- Google Cloud
- Microsoft Foundry
APIのモデルIDは次のとおりです。
claude-sonnet-5-5
Anthropicは、対象となるAPI構成でSonnet 5.5のゼロデータ保持にも対応しています。
Sonnet 5から移行するチームに対して、Anthropicは新しい推論強度の設定を確認し、以前の実行時設定をそのまま複製すべきだと考えるのではなく、設定そのものを見直すよう推奨しています。
次はHaiku 5.5
元の記事は、Claude 5.5ファミリーの次のメンバーにも目を向けて締めくくっています。
Anthropicによると、Haiku 5.5は今後数週間以内に続いて登場します。
その位置づけはすでに明確です。
高スループット
+
コスト重視のワークロード
Sonnet 5.5が高速な汎用ワークホースであり、Opus 5.5が難しい自由度の高い判断を担うモデルだとすれば、Haiku 5.5は大量展開における経済性をさらに追求するモデルになると予想されます。
Claude 5.5ファミリーの方向性は明確になりつつあります。
Anthropicは、単にベンチマークスコアだけで競っているのではありません。
次の要素を組み合わせてモデルを提示する傾向が強まっています。
品質
+
速度
+
完了タスクあたりのコスト
開発者にとって、これはベンチマークスコアだけを見るよりも有用な導入指標になる可能性があります。
FAQ
Claude Sonnet 5.5とは何ですか?
Claude Sonnet 5.5は、Anthropicの最新Sonnetモデルであり、Claude 5.5ファミリーにおける2番目のリリースです。コーディング、エージェント、ナレッジワーク、文書、スライド、その他の範囲が明確なタスク向けに、より高速で低コストなOpus 5.5の補完モデルとして設計されています。
Sonnet 5.5はOpus 5.5より優れていますか?
一部のベンチマークでは優れています。Sonnet 5.5はTerminal-Bench 4.0で70.6%を記録し、Opus 5.5の66.4%を上回りました。ただし、より幅広い評価の大半ではOpusがリードしており、継続的な判断を必要とする複雑で自由度の高い業務では、依然としてOpusのほうが優れています。
Claude Sonnet 5.5の料金はいくらですか?
Anthropicが提示する標準API料金は、入力100万トークンあたり2ドル、出力100万トークンあたり10ドルです。キャッシュ読み取りは100万トークンあたり0.20ドル、キャッシュ書き込みは100万トークンあたり2.50ドルです。
Sonnet 5.5はSonnet 5より安いですか?
トークン単価は同じですが、Anthropicによると、Sonnet 5.5は通常、より少ないトークンで効率的に処理を完了します。Anthropicのテストでは、多くのワークロードでタスクあたりのコストが最大30%削減されました。
Sonnet 5.5はどのくらい高速ですか?
Anthropicによると、出力生成はSonnet 5より30%以上高速です。外部テスターからも、多くのコーディングタスクでツール呼び出し、シェル実行、反復回数が少ないという報告があります。
Sonnet 5.5はGPT-6 Solと比べてどうですか?
AnthropicのFrontierCodeのコスト・性能チャートでは、Sonnet 5.5は、テストされたGPT-6 Solの設定と同程度の品質範囲に、より大幅に低い測定タスクコストで到達しています。ただし、これは普遍的なコスト比率ではなく、Sonnetがすべてのコーディングまたは推論ワークロードで勝つことを示すものでもありません。
開発者はどのモデルIDを使うべきですか?
公式Claude APIのモデルIDは次のとおりです。
claude-sonnet-5-5
Anthropicによると、このモデルはAWS、Google Cloud、Microsoft Foundryからも利用できます。
Claude Haiku 5.5はいつリリースされますか?
Anthropicは、Haiku 5.5が今後数週間以内に登場すると説明しています。高スループットかつコスト重視のアプリケーション向けに位置づけられています。
関連ツール
- Claude:Claudeモデルを利用するためのAnthropicの一般向けインターフェース。
- Claude Code:リポジトリ規模のソフトウェア開発に対応するAnthropicのエージェント型コーディング環境。
- Claude API:
claude-sonnet-5-5をアプリケーションに統合するための公式APIドキュメント。 - Amazon Bedrock:エンタープライズアプリケーション向けにClaudeモデルを提供するAWSのプラットフォーム。
- Google Vertex AI:Claudeモデルへのアクセスを提供するGoogle Cloudのプラットフォーム。
- Microsoft Foundry:Claudeモデルを利用できるMicrosoftのAI開発プラットフォーム。
関連リンク
- BAAI Hubの元記事:本記事で翻案し、事実確認を行ったQbitAIの記事。
- Anthropic — Claude Sonnet 5.5の紹介:ベンチマーク、顧客評価、料金、タスクあたりのコストチャート、安全性に関する注記を含む公式発表。
- Claude Sonnet製品ページ:Sonnet 5.5のユースケース、提供状況、料金に関する公式概要。
- Claude Opus 5.5:Anthropicのフラッグシップモデルと比較するためのOpus 5.5公式発表。
- Anthropic APIドキュメント:公式APIドキュメントとモデル統合に関するガイダンス。
- Anthropicの料金:Claudeモデルと製品プランの最新料金情報。
概要
Claude Sonnet 5.5は、Anthropicの中位モデルとフラッグシップモデルの差を、名称から想像される以上に縮めました。Terminal-Bench 4.0ではOpus 5.5を上回り、GDPval-AAでは2 Elo差に迫り、OSWorldとCursorBenchでもOpusにほぼ並んでいます。
より大きな導入上のポイントは効率性です。Sonnet 5.5はSonnet 5と同じ2ドル/10ドルのトークン料金を維持しながら、Anthropicによると30%以上高速に動作し、完了タスクあたりのコストを最大30%削減できます。外部テスターからも、ツール呼び出し、シェル実行、反復回数が大幅に少ないという報告があります。
Opus 5.5は、継続的な判断を必要とする難しく自由度の高い業務では、依然としてより強い選択肢です。Sonnet 5.5は、範囲が明確なタスクが増える中で、フラッグシップ級の品質に到達する大量処理向けのワークホースと捉えるのが適切です。
Sonnet 5.5で最も重要なアップグレードは、単一のベンチマークで勝利したことではありません。Sonnetレベルの価格と、完了タスクあたりの大幅に低いコストを維持しながら、フラッグシップ品質にどれだけ近づいたかという点です。