計算時代の大部分において、発展の傾向は明白に見えた:チップの性能は向上し続け、クラウドインフラは拡大を続け、計算の実効価格は下がり続けた。しかし、AIがこの傾向を変える可能性がある。
コンピュータ時代の大部分において、発展の方向性は明白に見えた。チップの性能は向上し続け、クラウドインフラは拡大を続け、計算の実効価格は下がり続けた。
AIはこのパターンを打ち破るかもしれない。
2026年7月29日の記事で、テクノロジーインタビュアー兼作家のDwarkesh Patel氏は、意図的に過激なシナリオを提示した。フロンティアAIが計算を経済的価値に変換する能力は大幅に向上する一方、先進的な計算能力の物理的供給の拡大ペースははるかに遅い、というものだ。
このシナリオでは、ハイエンドAI計算能力の市場価格は、最終的に長期的なコスト低下の軌道に戻るまでに、10倍以上上昇する可能性がある。
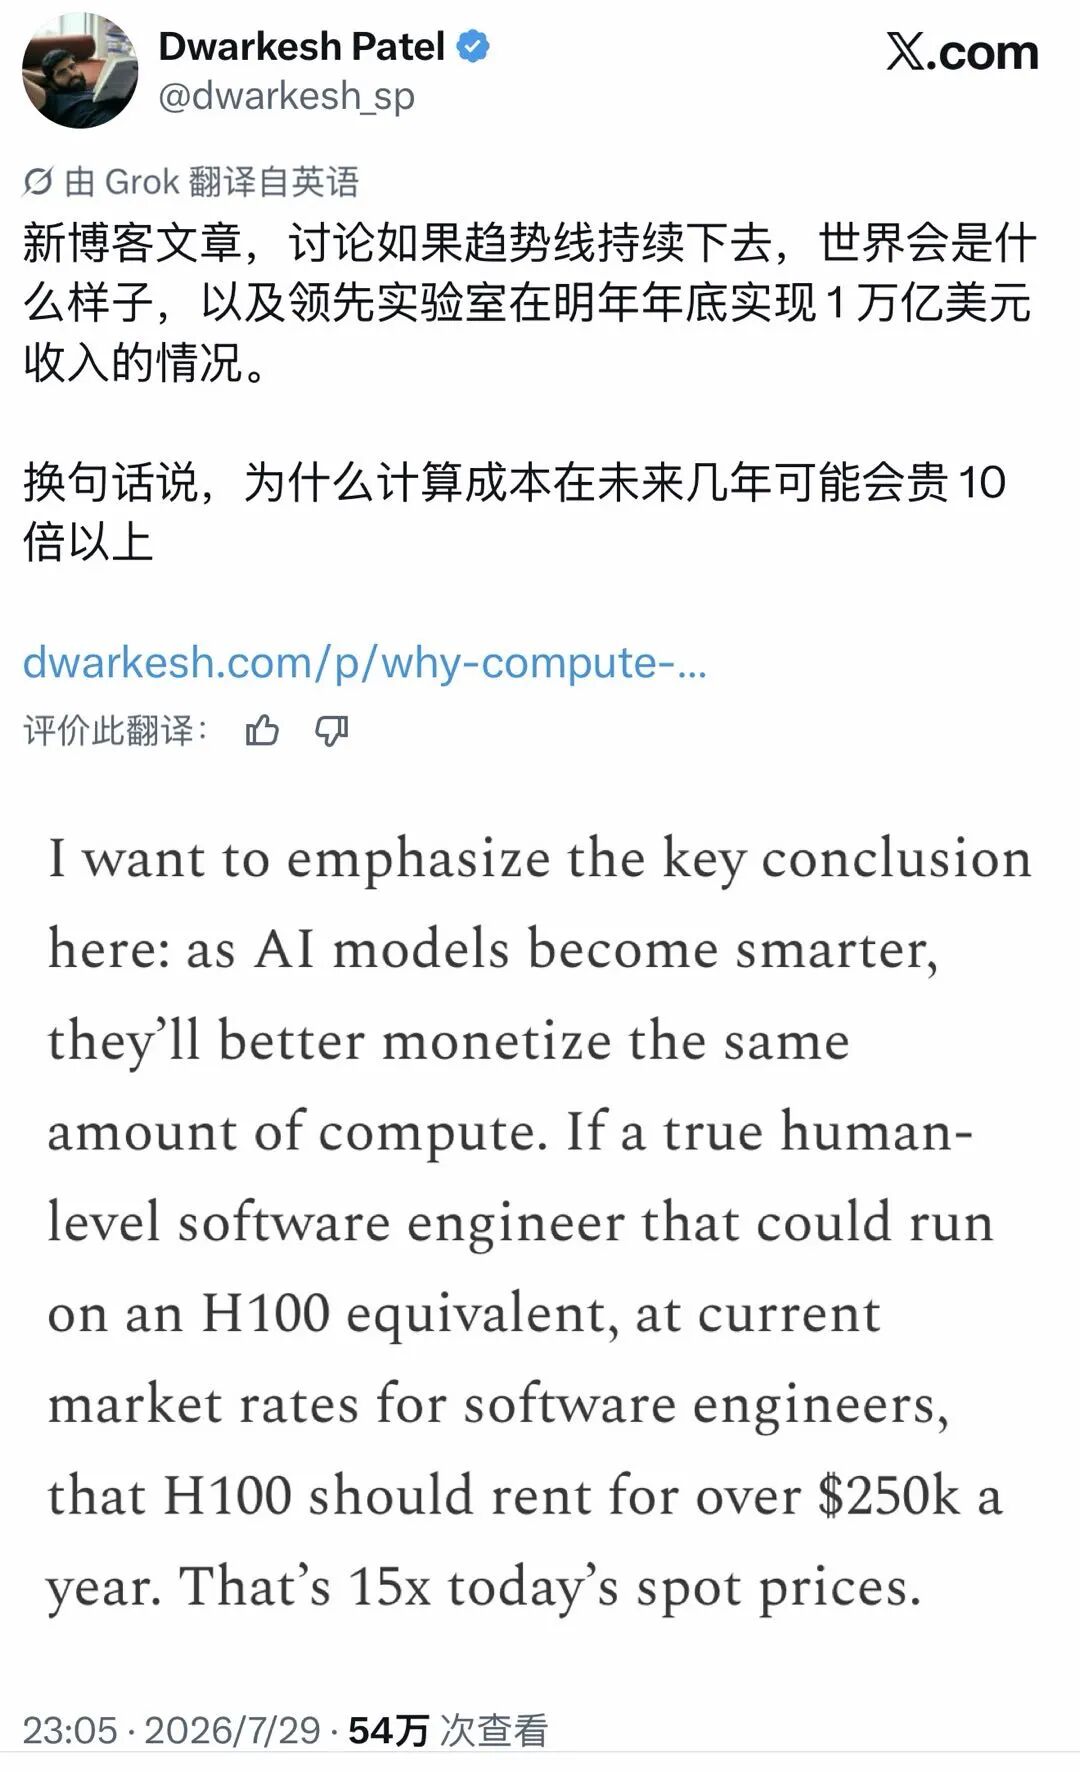
議論は挑発的な対比から始まる。
NVIDIA H100 1枚分の計算能力で動作するAIエージェントが、高給のソフトウェアエンジニアの仕事を遂行できるのであれば、なぜこのGPUのレンタル価格は、依然としてハードウェアの減価償却とクラウド競争によって主に決定されるのか?
なぜその価格は、それが代替または増強する人間の労働の経済的価値に、より近づかないのか?
原文はこの思考実験を、AIラボ、データセンター、先進半導体の生産能力、そして世界が深刻な計算能力インフレの時期に突入する可能性についての、より広範な予測へと拡張している。
最初から明確にすべき重要な境界条件がいくつかある:
上記の前提条件のもとで、この思考実験が価値を持つのは、業界がしばしば回避する問いを提起するからだ:
AIが生み出す経済的価値の成長速度が、世界がそれを支えるインフラを製造する速度を上回ったら、何が起こるのか?
議論は比較単位を変えることから始まる。
現在、計算能力は通常、インフラとして価格設定される:
Patel氏が提起する問いはこうだ:同じハードウェアが自律的労働力の容器になったとき、何が起こるのか?
以下のことができるAIソフトウェアエンジニアを想像してみてほしい:
そのエージェントが実行時に約H100 1枚分の計算能力を必要とするならば、GPUはもはや単なる
サーバー部品ではない。それはデジタル生産システムの一部なのだ。
Patel氏は、シリコンバレーの有力ソフトウェアエンジニアの市場価値として年額25万ドルという概数を用いる。
次に、それをH100の年間換算スポットレンタル推定値(約1.6万ドル)と比較する。
暗黙のギャップは以下の通り:
250,000 / 16,000 ≈ 15.6倍
この単純化された思考実験では、同等のデジタル労働力を搭載できるGPUは、生み出すことができる労働価値に対して大幅に過小評価されているように見える。
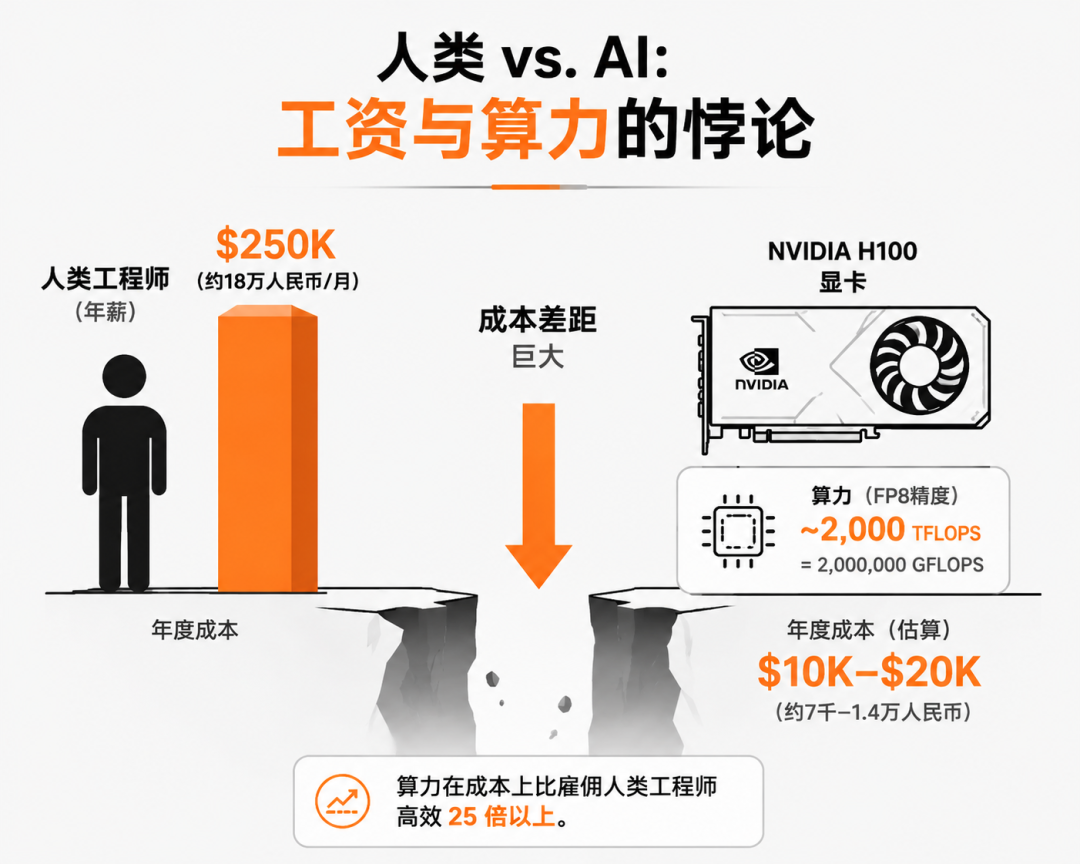
この計算は、H100 1枚あたりが25万ドルでレンタルされるという直接的な予測ではない。
以下の重要な要素を無視している:
Patel氏のより限定的な主張は、計算能力がより価値の高い成果を生み出せるようになったとき、計算能力に対して支払う意欲が急激に上昇する可能性がある、というものだ。
自然な反論は、AIソフトウェアエンジニアが数百万人生まれれば、ソフトウェアエンジニアリング労働の市場価値は低下する、というものだ。
ソフトウェアが豊富になれば、デジタルエンジニア1人が25万ドルの価値を持たなくなるかもしれない。
Patel氏はこの可能性を認めつつも、自動的にそうなるわけではないと主張する。
標準的な経済学の推論は、「有用な仕事の量は固定されている」という見方を通常拒否する。追加の熟練労働者は、新製品、新企業、新専門分野、新たな需要を生み出すことができる。
この観点からすれば、有能な労働者の大幅な増加は、既存の仕事をより多くの参加者間で分割するだけではない。それは経済的に可能な範囲を拡大するのだ。
AIは異常に急速な労働供給ショックをもたらす可能性があるため、歴史的な比較は当てはまらないかもしれない。それでもなお、新たなソフトウェアとサービスが実現可能になるにつれて、AI計算能力の限界価値が高水準を維持することは合理的だとPatel氏は考える。
Patel氏の記事の下の議論で有用な反論の一つは、タスク全体がデジタル環境で完了できる場合に、労働価値の比較が最も強力になるというものだ。
ソフトウェアエンジニアリングはこの理想状態に近い:
物理的なボトルネックが支配的になると、この比較は弱くなる。
AIシステムが
薬剤を迅速に設計できるかもしれないが、臨床試験には依然として患者、規制、製造、そして時間が必要だ。工場を最適化できるかもしれないが、建設、許認可、サプライチェーン、設備は依然として物理的制約を受ける。
これらの分野では、計算能力が代替される人的労働の全価値を十分に引き受けることができるようになる前に、知能が最初のボトルネックではなくなる可能性がある。
議論の第二部は、単一GPUからフロンティアAIラボの財務状況へと移る。
Anthropicは、その最近の収益成長が異常に急激であるため、主要な例証となっている。
Anthropicが公式に報告したデータは以下の通り:
これらは年換算実行率データであり、通年の監査済み収益ではない。
それらは、特定時点の収益が示唆する成長速度を記述している。
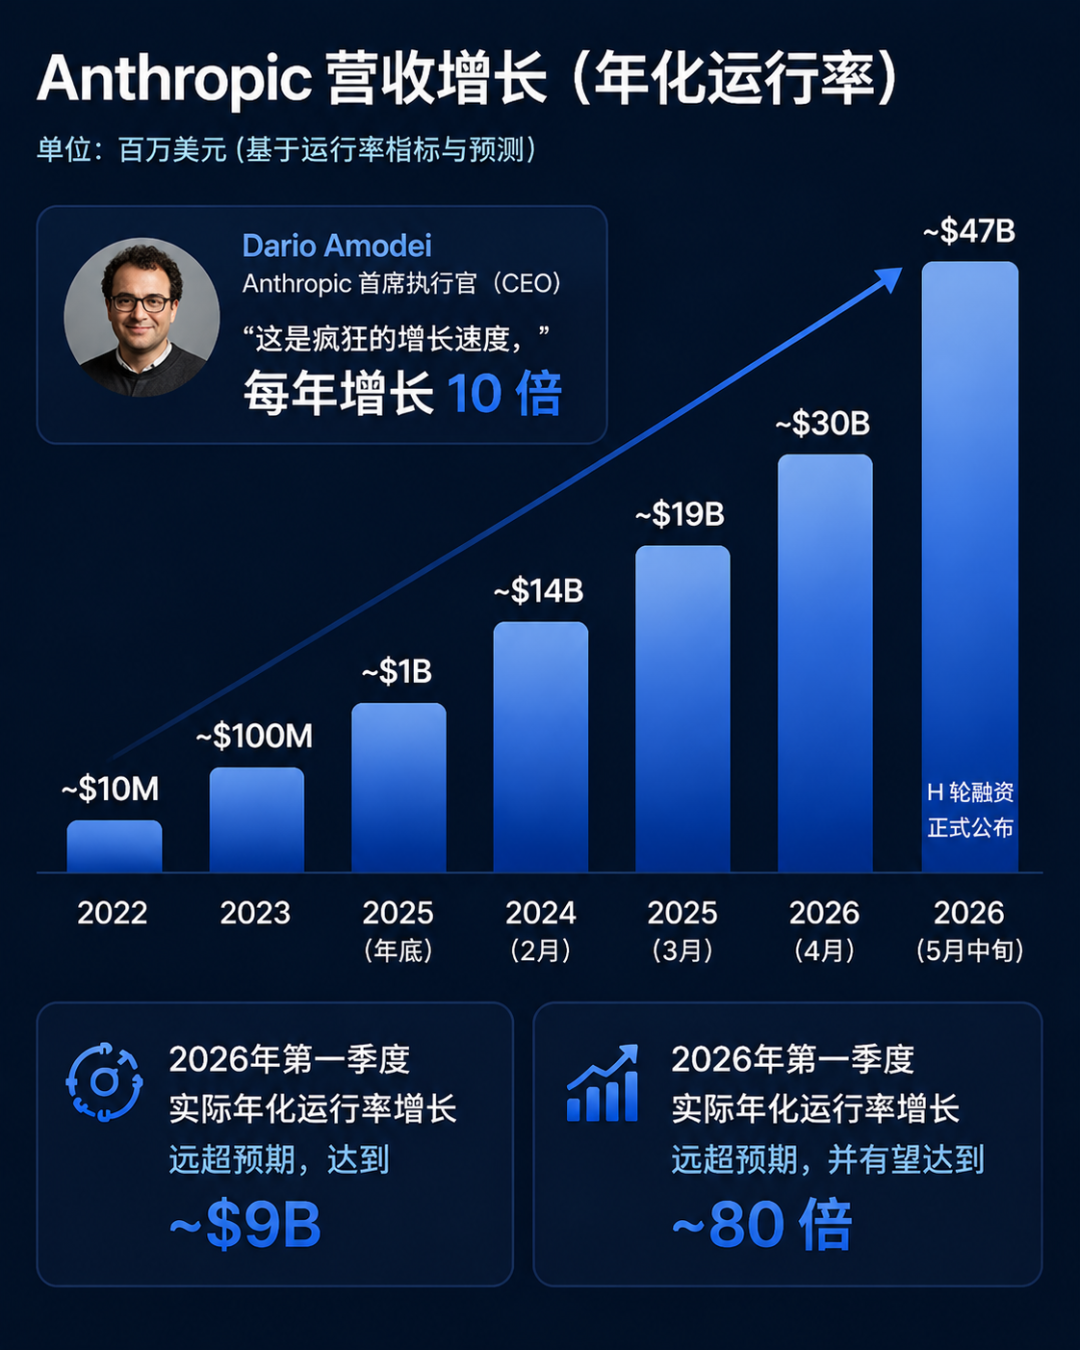
Patel氏の出発点は一つの観察である:Anthropicの収益は前年同期比で約1桁増加している。
その後、彼は意図的に極端な推測シナリオを構築した:
Patel氏は明確に、この軌道は必然的に続くわけではなく、深い理由はないと指摘している。それは将来のAI能力、製品の採用率、価格設定、競争状況に依存する。
このシナリオの目的は、Anthropicが1兆ドルの収益を予測したと主張することではなく、もしAI企業が本当にそのような速度で成長するならば、他にどのような条件が成立する必要があるのかを問うことである。
Patel氏は仮説上の10倍の収益成長を、推定されたAI計算能力の年間3倍拡大と比較している。
Epoch AIは、2025年の世界のAI計算能力ストックがH100換算で約2倍(つまり3倍)に増加したと推定しているが、同機関は企業レベルおよび将来に関する推定には依然として不確実性が存在すると強調している。
これにより生じるミスマッチはおよそ以下の通りである:
AIビジネス需要の成長:10倍
物理的な計算能力の成長:3倍
ギャップ:約3.3倍
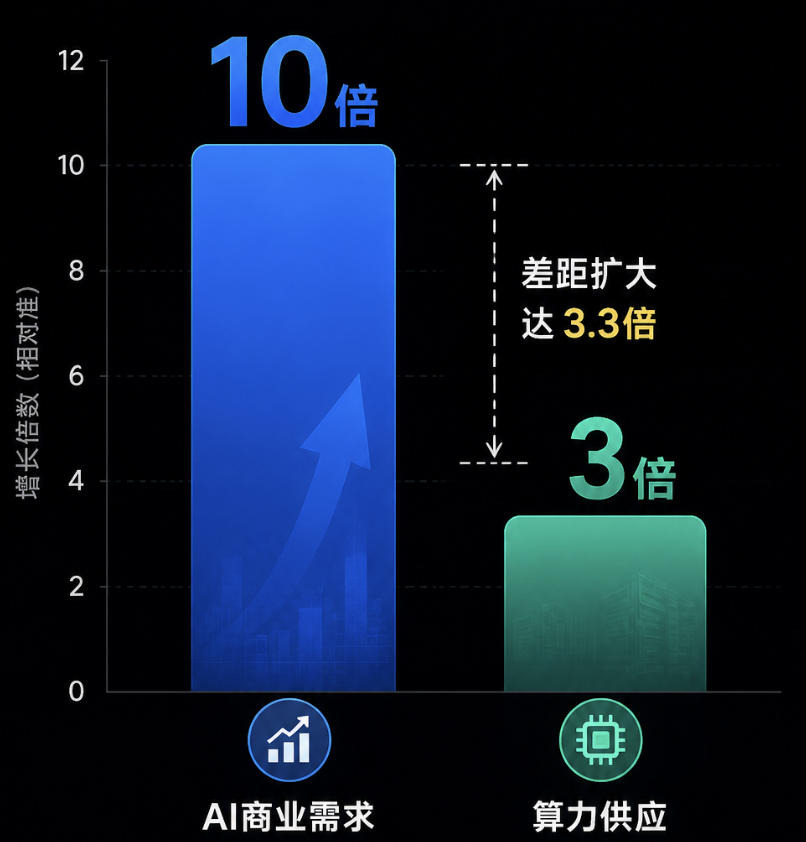
もし先端ラボの収益成長率が利用可能な計算能力の成長率を大幅に上回るならば、以下の3つのうち何らかの組み合わせが変化しなければならない:
Patel氏は、これら3つはそれぞれ一定程度すでに変化し始めていると考えている。
モデルプロバイダーは高い固定費を投じてモデルをトレーニングし、その後、多数の顧客に学習済みの能力を提供する。
これにより、潜在的な規模の経済効果が生まれる。
同じ学習済みの能力は以下のチャネルを通じて販売できる:
1回の追加リクエストの限界コストは、そのリクエストが生み出す価値をはるかに下回る可能性がある。
Patel氏は、先端ラボの推論利益率が大幅に改善していると指摘している。ただし、AnthropicのFable推論サービスに関する具体的な利益率データは、検証された企業開示ではなく、概算として明示的に提示されている。
高い利益率は、収益成長と計算能力成長の間のギャップの一部を吸収できる。
難点は規模である。
Patel氏が提示した1兆ドルシナリオでは、価格と計算能力の配分が十分に調整されない場合、利益率は95%前後の中高水準まで引き上げる必要がある。彼は、これを先端テクノロジープラットフォームにとっても異常に高い水準だと考えている。
必要な正確な利益率は多くの変数に依存するが、より核心的な見解は依然として成立する:利益率だけでは、爆発的な需要と制約のあるインフラの間の矛盾を調和させることはできないかもしれない。
2つ目の選択肢は、より大きな割合の計算能力を顧客サービスに割り当てることである。
Epoch AIの推定によると、OpenAIは2024年に推論計算能力に約18億ドルを費やし、研究開発用計算能力には約50億ドルを費やした。これに基づくと、推論支出は報告されている総計算支出の約4分の1を占めると推定される。
商業利用の規模が拡大するにつれて、推論の割合はさらに高めることができる。
これは収益を支えるのに役立つが、先端ラボは戦略的なジレンマに直面する。
推論サービスは現在の請求書を支払う。
トレーニングと実験は、次世代製品を定義する可能性のあるモデルを生み出す。
計算能力の大部分を現在のモデルのサービスに費やすラボは、より直接的な収益を生み出せるかもしれないが、以下のために利用できるインフラは減少する:
Patel氏はシリコンバレーのフライホイール効果を説明している:現在の推論収益は資金調達を支え、資金調達はより多くの計算能力を購入し、計算能力はより強力なモデルをトレーニングし、より強力なモデルはより多くの収益をもたらす。
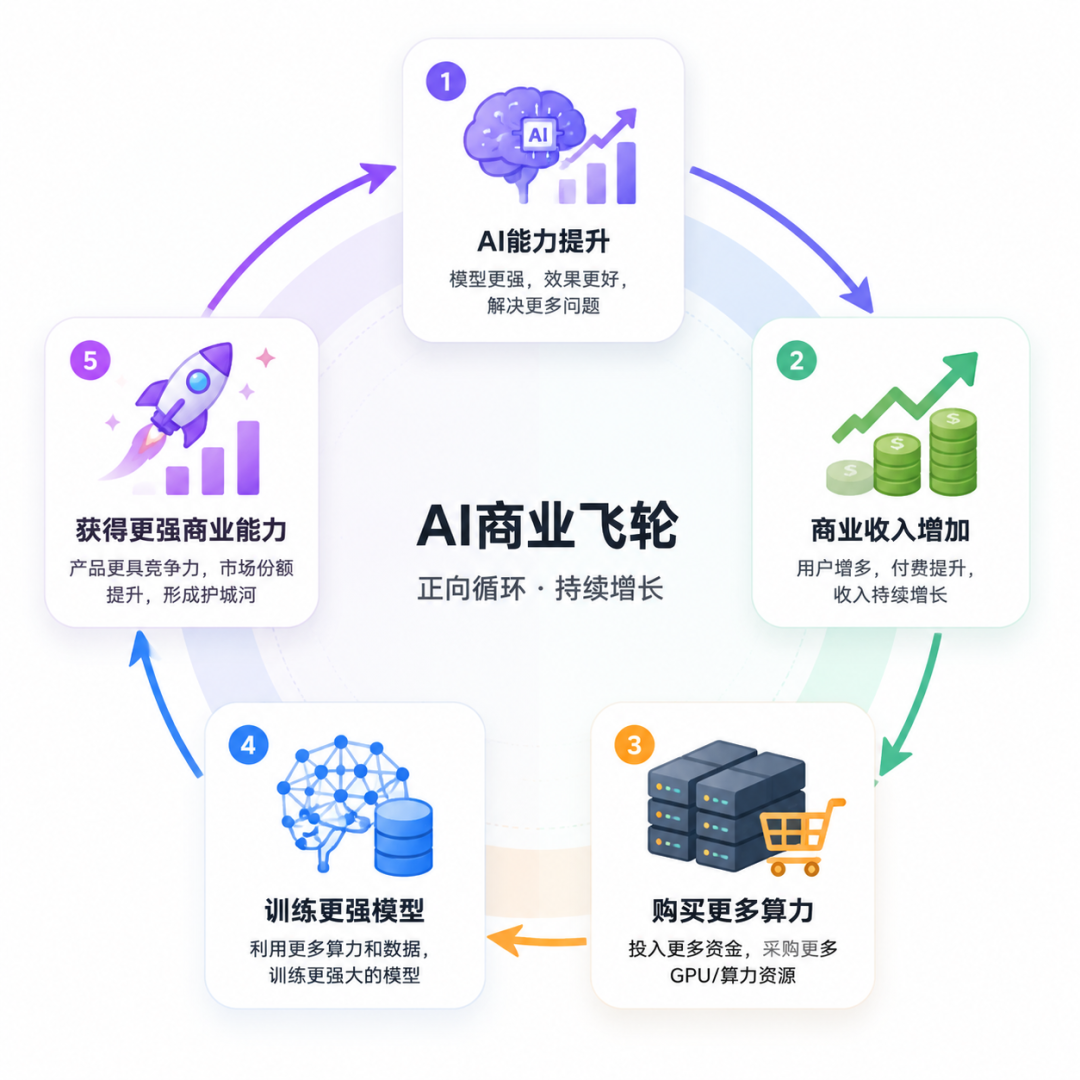
これらのラボは通常、今日のモデルを最終地点とは見なしていない。現在の先端システムはすぐに追い越されると予想している。
そのため、静的なモデル世代にサービスを提供する高利益率のクラウドサービスプロバイダーに完全に転換することには消極的である。
残る調整は価格である。
AIラボとその顧客が単位計算能力あたりからより多くの経済的価値を生み出せるならば、希少なインフラを巡ってより積極的な入札を行う余裕が生まれる。
これは、GPU1時間あたりの価格が一律に上昇することを意味するわけではない。
先端ラボは専門的な計算能力を必要とする:
オープンマーケットのスポットインスタンスは、安全な複数年・複数ギガワット級のインフラ契約を完全に代替することはできない。
最近の契約は、即時のキャパシティに対するプレミアムを反映している。
AnthropicはSpaceXAIとのColossus 1へのアクセスに関する契約を正式に確認し、その後Colossus 1とColossus 2のキャパシティを拡大したと発表した。
SpaceXAIはColossus 1を、H100、H200、GB200システムを含む22万基以上のNVIDIA GPUで構成されていると説明している。
Axiosは、Anthropicが2029年まで月額約12.5億ドルでこの契約を結ぶことに合意したと報じた。
TechCrunchが後に報じた規制文書によると、Googleは2026年10月から2029年6月まで、約11万基のGPUおよび関連コンポーネントへのアクセスに対し、月額約9.2億ドルをSpaceXに支払う予定である。
これらは通常のオンデマンドクラウド調達ではない。
これらは、新しいデータセンター、電力網への接続、チップの納品に数年かかる可能性がある状況において、大規模で即時のインフラを確保する価値を反映している。
Patel氏は、Google取引に含まれるGPU1時間あたりの価格が、現在の関連する混合ハードウェアのスポット価格の約2倍だと推定している。
この比較は概算である。なぜなら、契約にはベアGPU以外も含まれており、ハードウェア構成は異なる世代のアクセラレータを包含しているからである。
元記事では産業の類推が用いられている。
インターネット時代、企業は以下を巡って競争していた:
ユーザー
最先端AI競争は、より物理的な次元を新たに加えた:
最先端GPUクラスターは、普通のレンタルサーバーの集合というよりは、工業生産ラインに近い。
その産出物は物理的な製品ではなく、経済的価値を持つ知性である:
最も強力なモデルと最も信頼性の高い計算資源を掌握する企業は、こうしたデジタル労働をより多く生み出す可能性がある。
スポット容量は最先端ワークロードにとって複数の欠点を持つ:
トレーニングまたは推論を実行中のラボ
最前線モデルの買い手は、短期的なバッチ処理タスクを実行する買い手よりも、保証された計算能力を重視する。
これは、パブリッククラウドの提示価格がより安く見えても、契約ベースの計算能力がプレミアム価格を維持できる理由を説明するのに役立つ。
パテルの見解は、計算能力の供給が大きな需要ショックに十分迅速に反応できないという主張に依存している。
彼は年間の計算能力成長を、3つの広範な乗数の積として要約している:
年間AI計算能力成長 ≈
1.4× ハードウェア改良
× 1.2× 新規ウェーハ生産能力
× 1.8× 最先端プロセスウェーハのAIへの再配分
≈ 3.0×
これらの数字は推計値であり、不変の物理定数ではない。
それらは近年の成長の源泉を示すことを意図している。
半導体技術の改良により、ワット当たり、チップ当たり、ドル当たりの実効計算量が向上する。
潜在的な利得は以下から生じる:
進歩の速度に上限がないわけではない。
新しいプロセス世代ごとに、より困難で高価になる。消費電力密度、リーク、歩留まり、メモリ転送、パッケージングが、実効性能の決定要因としてますます重要になっている。
AIシステムはまた、モデルとソフトウェアレベルの改良を通じて効率を高めることができ、これはハードウェア不足の影響をある程度相殺する可能性がある。したがって、いかなる計算価格予測も、需要成長に対する効率向上の速度に依存する。
新しい半導体生産能力は、計画、資金調達、建設、装置設置、検証、生産立ち上げに数年を要する。
サプライチェーンは極紫外リソグラフィ装置などの専用システムに高度に依存している。
最先端ファブにはさらに以下が必要である:
パテルは、少なくともこの10年の終わりまでは、EUV装置の利用可能性が生産能力の急速な拡大を制約すると考えている。
価格上昇は投資を刺激することはできても、完全に検証された最先端工場を即座に生み出すことはできない。
最近のAIチップ成長の大部分は、他の製品から最先端製造能力を移行することによるものである。
スマートフォン、PC、ネットワークチップ、その他のデバイスが、同じ最先端プロセスとパッケージング資源をめぐって競合している。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
パテルは、2027年末までにTSMCのN3生産能力に占めるAIの割合が約60%から86%に上昇する可能性があるという推計を引用している。
これは供給モデルの推計であり、TSMCが公表する生産能力ガイダンスではない。
その意味は明快だ:非AI需要が依然として移転可能な生産能力を占有している場合にのみ、再配分というレバレッジは有効である。
AIが関連ノードの生産能力の大部分をすでに消費してしまえば、この成長レバレッジは大幅に弱まる。
ウェーハ供給が拡大しても、システム全体は以下によって制約される可能性がある:
計算能力の供給は依然として
したがって、これは単一工場の産出ではなく、一連の連鎖である。
実効容量は最も遅い重要なボトルネックによって制約される。
情報源はその後、直感に反する議論を提示している:計算能力がより高価になっても、買い手が必ずしも弱いモデルに移行するとは限らない。
彼らはむしろ最強モデルをより好む可能性さえある。
パテルはこれをアルキアン=アレン効果と関連付けている。
固定費用が異なる品質の財に加算される場合、高品質バージョンの相対的な魅力が高まる可能性がある。なぜなら、品質プレミアムが総価格に占める割合が小さくなるからである。
基盤となる計算能力のコストが1時間あたり20ドルだと仮定する。
強いモデルは1時間でタスクを完了し、5ドルのモデルプレミアムが付く:
強いモデル:
20ドル(計算)+ 5ドル(プレミアム)= 25ドル
弱いモデルはプレミアムがないが、再試行と非効率な推論のため2時間かかる:
弱いモデル:
2 × 20ドル(計算)= 40ドル
表面的には無料に見えるモデルも、完了したタスク1件あたりで計算すると、むしろ高価になる。
重要な指標はトークン当たりの価格やモデルライセンス料ではなく、成功した結果1件あたりのコストである。
より強力なモデルは以下の方法でコストを削減できる:
計算能力が安ければ、非効率な試行の代償は許容できるかもしれない。
計算能力が高価になれば、計算資源の浪費はより痛手となる。
希少なGPU時間ごとに最大の有用な産出を引き出せるラボは、かなりのプレミアムを請求できる可能性がある。
情報源記事の最も急進的なバージョンは、凡庸なモデルには未来がないかもしれないと主張している。
この結論は広すぎる。
小規模で専用のモデルは、以下の状況で依然として魅力的である:
軽量な分類器は、最前線のプログラミングエージェントである必要はない。
アルキアン=アレンの議論は、両方のモデルが同様に高価なインフラを消費し、弱いモデルが同じ結果に到達するために著しく多くの作業を必要とする場合に当てはまる。
小規模モデルがそのタスクに対して本当により効率的である場合、この議論の力は弱まる。
パテルは、計算能力の価格上昇が低価値の用途から生産能力を移行させる可能性があると主張している。
1つのGPUが高価値のソフトウェアやビジネス成果を生み出すエージェントを実行できるなら、同じハードウェアを一回限りのメディアコンテンツに使う機会費用ははるかに高くなる。
これは以下のアプリケーションに影響を与える可能性がある:
市場はコンテンツ自体を必ずしも排除しない。
その代わりに、以下の方向へ押しやる可能性がある:
重要なのは資源配分である。
希少な
最先端の計算能力は、最も支払意欲の高いワークロードへと流れる傾向がある。
情報源記事はまた、いくつかの反対意見も提示している。
これらの意見は重要である。なぜなら、資源の恒久的希少性に関する予測はしばしば誤りであることが証明されているからである。
25万ドルのエンジニアとの比較は、GPUがエンジニアの現在の経済的価値に近い収益を獲得できることを前提としている。
この前提は以下の理由で崩れる可能性がある:
あるコメンテーターは、デジタル労働者の初期価値は高いかもしれないが、AI労働力が豊富になれば最終的に5万ドル程度に落ち着く可能性があると指摘している。
この仮定の下では、計算の価値は依然として上昇するかもしれないが、必ずしも15倍にはならない。
トークン価格は計算価格と同一ではない。
モデルとサービスシステムは継続的に以下の方法で改善されている:
キャッシュ
将来、低価値の動画やチャット返信は、現在の計算量のごく一部しか必要としなくなる可能性がある。
たとえフロンティアエージェントの計算コストが高くなっても、一般的なAIサービスはより効率的なモデルとハードウェアに移行するため、価格が下がり続ける可能性がある。
オープンウェイトモデルはフロンティアAPIの価格設定に圧力をかける可能性がある。
複数のモデルが同様の能力を提供する場合、ユーザーは以下の選択肢の間で切り替えることができる:
これにより、単一のラボが極めて高い利益率を確保する能力が制限される。
計算リソースの希少性が基盤インフラのコストを押し上げる可能性はあるが、モデル間の競争がラボが保持できる価値を決定する。
希少性への古典的な対応は投資である。
より高い計算価格は以下を促進する:
パテルも計算リソースが最終的に再び安くなることを認めている。
彼の主張は、需要の伸びが長周期の物理的インフラの対応よりも速い可能性がある現在の移行期に向けられている。
ソースは、計算予測を生物学者ポール・エールリッヒと経済学者ジュリアン・サイモンの間の有名な賭けと比較している。
1980年、エールリッヒは5種類の金属のバスケットを選び、今後10年間で実質価格が上昇すると賭けた。
1990年までに、そのバスケットのインフレ調整後価格は下落し、エールリッヒはサイモンに賭け金を支払った。
この賭けは、希少性予測がイノベーション、代替、供給対応を過小評価することが多いことを示す議論としてよく使われる。
歴史的な解釈は
より複雑である。分析によると、異なる開始10年間では異なる勝者が生まれた可能性がある。
パテルは、彼の計算に関する主張が、しばしば誤りであることが証明されてきた希少性予測に類似していることを認めている。
彼は、計算リソースは短期の供給弾力性が低いため、金属採掘とは異なる可能性があると主張する:
したがって、主な相違点は時間の問題である。
AI需要が現在の建設を圧倒する前に、価格シグナルとイノベーションが効果的な計算供給を拡大できるか?
「10倍」を固定予測として扱う代わりに、この主張を測定可能な変数のセットに変換することができる。
10倍の価格上昇は以下の場合に可能性が高い:
以下の場合は可能性が低い:
たとえ計算コストが10倍にならなくても、この主張には実用的な意味がある。
追跡事項:
より安価なモデルが繰り返し失敗する場合、実際には安価ではない。
高価なフロンティアモデルは、本当に恩恵を受けるタスクにのみ使用する。
小規模モデルを以下に使用する:
困難なケースのみをエスカレーションする。
製品全体を単一のモデルや単一のGPUプロバイダーに縛り付けることを避ける。
有用な抽象化には以下が含まれる:
長時間実行されるエージェントループは、繰り返しのコンテキストや過度に大きなツール出力によって計算を浪費する可能性がある。
改善の方向性:
需要が予測可能な企業は以下から利益を得る可能性がある:
適切な戦略は利用率に依存する。予約ハードウェアはアイドル時にコストがかかる。
この主張はまた、モデルベンチマークからインフラへと焦点を移す。
重要な領域には以下が含まれる:
知能が主要な経済投入物になる場合、これらのレイヤーへの支配は戦略的になる。
結果は集中化である可能性がある。
最良のモデルと最も強力な収益を持つラボは、新規参入者よりも希少な計算リソースに高い入札を行う可能性がある。これらの計算リソースはモデルの改善に役立ち、収益を強化し、次の入札を容易にする。
これは強化ループである:
より良いモデル
    ↓
より価値のある製品
    ↓
より多くの収益
    ↓
より多くの計算リソースの獲得
    ↓
より多くのトレーニングと推論
    ↓
より良いモデル
リスクは、知能の生産が巨額のインフラ投資を負担できる少数の企業に集中する可能性があることだ。
パテルは、より賢いAIモデルが計算単位あたりにより多くの収益を生み出す可能性がある一方で、先進的な計算の実際の供給成長ははるかに遅いと考えている。需要と支払い意欲がチップ、電力、データセンターの供給成長よりも速く伸びる場合、市場価格は急騰する可能性がある。
いいえ。Anthropicは公式に2026年5月に年率換算収益が470億ドルを突破したと報告している。年末の1000億〜1500億ドル、翌年の1兆ドルという数字はパテルの思考実験における仮定であり、会社のガイダンスではない。
この比較は、H100に相当するシステムが高給エンジニアと同等の仕事を担うAIエージェントを実行できる場合に、計算リソースがどのように価格設定されるかを探るものである。これは仮説的な価値ベンチマークであり、現在のエージェントがH100一台でエンジニア一人を代替できるという証拠ではない。
Epoch AIは、2025年の世界の総AI計算量がH100換算で約3倍に増加したと推定している。将来の成長は不確実であり、チップ性能、製造、パッケージング、電力、建設、資本支出に依存する。
フロンティアラボは、セキュリティ、信頼性、大規模性、高速ネットワーク、予測可能なパフォーマンスを備えたクラスタを必要とする。
長期可用性。公共のスポットインスタンスは、数十万枚の連携アクセラレータを含む専用の複数年にわたるデプロイとは異なる。
そうとは限らない。最強モデルがより少ないトークン、より少ないリトライ回数、またはより短い時間で同じ結果を達成できる場合、高価な計算は確かに有利である。しかし、狭い領域、低遅延、プライベート、またはエッジのワークロードでは、小規模な専用モデルが依然として経済的である可能性がある。
パテルは計算リソースが永久に高価なままであるとは主張していない。
彼の論点は、AI需要が半導体・データセンターのサプライチェーン拡張能力を上回る可能性がある移行期を含んでいる。長期的に見れば、ハードウェアと自動化が再び計算能力をより安価にし得る。
AI収益の成長鈍化、モデル能力の天井到達、オープンソースモデルがほぼ同等の代替品となること、サービス効率の向上が需要増加を上回る速度で進むこと、あるいは半導体と電力供給の拡張が予想より速く進む場合、この論点は弱まる。
ドワーケシュ・パテルの「計算能力10倍価格」論点は、単純なアイデアから始まる——1つのGPUが高価値の知識労働を実行するAIエージェントを搭載できるなら、そのGPUに支払う意欲はサーバーの歴史的コストではなく、その作業の価値へと向かうかもしれない。
Anthropicの急速な収益成長と、世界のAI計算能力が年間約3倍の速度で拡張しているという推計を組み合わせると、この論点はさらに説得力を持つ。AIの商業需要がより速く成長するなら、調整は必然的に利益率、計算能力の配分、インフラ価格の上昇、またはこれら3つの何らかの組み合わせを通じて行われる。
この予測は決して確実ではない。エネルギー効率の向上、オープンソースモデル、より小型の専用システム、新規の半導体工場、新しいアクセラレータ、能力成長の鈍化はすべて、10倍の成長を阻止し得る。歴史的に資源希少性の予測は、適応的調整の能力を過小評価することが多かった。
真に永続的な洞察は、計算能力が正確に10倍に増加しなければならないということではなく、より賢いAIが1つのGPUあたりの経済的価値を、物理世界が新しいGPUを製造・電力供給する速度を超えて引き上げる能力を持つということにある。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



