DeepSeek V4 Flash 0731 が公開ベータ版に入り、おなじみの約束を携えて登場しました。それは、極めて低いAPI価格でより強力なコーディングとエージェント能力を提供するというものです。開発者たちはすぐにこの主張を試しました。

DeepSeek V4 Flash 0731がパブリックベータに登場した。そこにはおなじみの約束があった:極めて低いAPI価格で、より強力なコーディング能力とエージェント能力を提供するというものだ。
開発者たちはすぐにこの主張を実際の実験に移し替えた。
最も広く共有された事例の一つは、Hermes Agentの実行におけるものだ。DeepSeek V4 Flashは、たった一つの初期プロンプトだけで、プレイ可能な一人称視点の3Dシューティングゲームを生成した。このプロジェクトは32分を要し、モデル使用コストはわずか0.07ドルだったと報告されている。
最終的な成果物には以下が含まれる:
DeepSeek V4は100万トークンのコンテキストウィンドウをサポートしています。
従来のアテンションシステムはこの規模では非常に高コストになります。新しいトークンごとに大量の以前のコンテキストをチェックし、大きなKVキャッシュを維持する必要があるためです。
DeepSeekの技術レポートでは、以下を組み合わせたハイブリッドアテンション設計が説明されています:
全体的な戦略は、各ステップで履歴全体に対して完全で高価なアテンション計算を実行することを避けることです。
システムはコンテキストを圧縮およびフィルタリングし、モデルが最も有用な情報に計算を集中できるようにします。
DeepSeekは、100万トークンのコンテキスト環境でV4 Proが必要とすることを報告しています:
DeepSeek V3.2の単一トークン推論FLOPsの27%。
これらの正確な割合は、技術論文でV4 Proについて報告されたものであり、Flash単独の監査データではありません。
V4 Flashは同じアーキテクチャファミリーを使用しているため、同じ長コンテキスト設計原則の恩恵を受けています。
実際の効果には以下の削減が含まれます:
およびメモリトラフィック
公開されたV4 Flashモデルは、混合低精度重みを使用しています。
DeepSeekは以下を明記しています:
FP4 + FP8 混合精度
低精度により、推論中に保存、メモリからの読み込み、デバイス間の転送、および処理が必要なデータ量が削減されます。
これは、現代の言語モデル推論が生の算術演算能力だけでなく、メモリ帯域幅によって制約されることが多いため重要です。
ハードウェアとカーネルがこの形式を効率的に実行するように設計されている場合、より小さなデータ表現はスループットを向上させることができます。
低精度は当然ながら無料ではありません。
質の悪い量子化はモデルの品質を低下させます。
DeepSeekのリリースは、事後的なコミュニティ量子化に依存するのではなく、選択された精度スキームを中心に設計およびトレーニングされています。
DeepSeekは、公式の0731リリースがV4 Flashプレビュー版と同じモデルアーキテクチャと規模を維持していると述べています。
同社は今回のアップデートのために完全な事前トレーニングを再度行っていません。
代わりに、ポストトレーニングプロセスを作り直しました。
ソース記事では、変更点を次のようにまとめています:
DeepSeekの技術レポートでは、より広範なV4ポストトレーニングプロセスを次のように説明しています:
0731アップデートは、実際のエージェントワークフローにおけるこれらの能力のパフォーマンス向上に焦点を当てています。
DeepSeek-V4-Flash-0731には、DSpark投機的復号化モジュールが付属しています。
投機的復号化では、より小さいまたはより安価なドラフトパスを使用して、複数の将来トークンを提案します。
メインモデルはこれらの提案を一括で検証します。
簡略化されたフローは次のとおりです:
ドラフトモジュールがトークンを提案
→ メインモデルが同時に検証
→ 受け入れられたトークンが出力
→ 拒否されたパスは修正される
ドラフトの予測が正確な場合、システムはメインモデルの高コストな順次推論を減らしながら、複数の受け入れられたトークンを生成できます。
DeepSeekはvLLMとSGLangの両方でDSparkをサポートしています。
vLLMの場合、公式モデルカードは以下を使用します:
--speculative-config '{"method":"dspark","num_speculative_tokens":7,"draft_sample_method":"greedy"}'
SGLangの場合、対応するオプションは:
--speculative-algorithm DSPARK
DeepSeekによると、ターゲットモデルとドラフトモデルの重みは同じチェックポイントに保存されているため、SGLangは別個のドラフトモデルパスを必要としません。
投機的復号化は主にサービスの速度とスループットを向上させます。
それ自体がモデルの推論能力の向上を説明するものではありません。
これらの向上は、更新されたポストトレーニングプロセスによるものです。
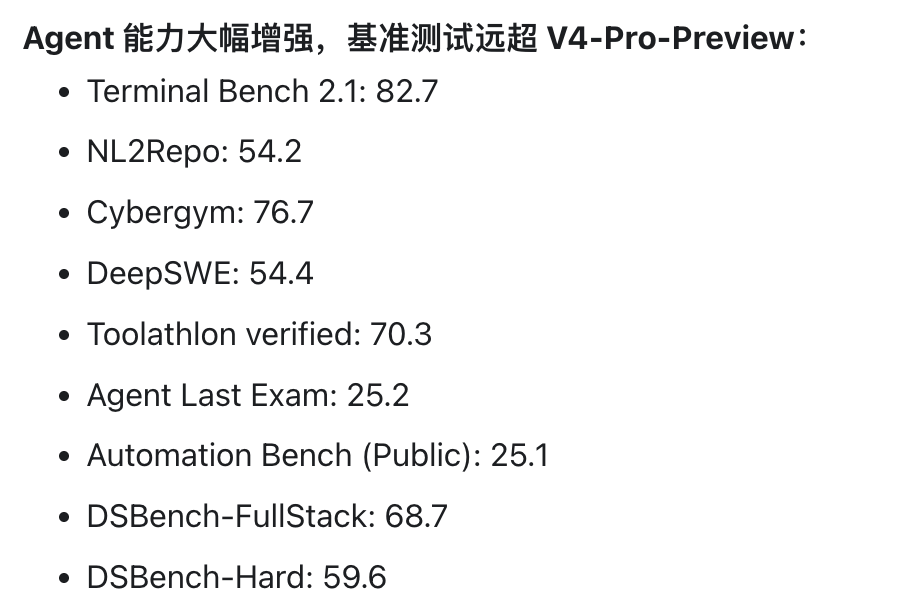
DeepSeekは、V4 Flashプレビュー版と比較して、複数のエージェント重視のテストで大幅な改善を報告しています。
| ベンチマーク | V4 Flash 0731 | V4 Flash プレビュー版 | V4 Pro プレビュー版 |
|---|---|---|---|
| Terminal Bench 2.1 | 82.7 | 61.8 | 72.1 |
| NL2Repo | 54.2 | 39.4 | 38.5 |
| CyberGym | 76.7 | 38.7 | 52.7 |
| DeepSWE | 54.4 | 7.3 |
12.8 |
| Toolathlon-Verified | 70.3 | 49.7 | 55.9 |
| Agents' Last Exam | 25.2 | 15.8 | 16.5 |
| AutomationBench Public | 25.1 | 10.8 | 12.8 |
| DSBench-FullStack | 68.7 | 37.0 | 41.8 |
| DSBench-Hard | 59.6 | 25.8 | 31.1 |
DeepSeekによると、公開コードエージェントベンチマークは次の構成で実行されました:
DeepSeek Harness最小モード
reasoning_effort = max
top_p = 0.95
temperature = 1.0
公式アップデート時点で、このテストフレームワークはまだ公開されていません。
DSBench-FullStackおよびDSBench-Hardは、DeepSeekの内部ベンチマークです。
つまり、それらのスコアは会社が報告した参考証拠として機能しますが、完全に公開されたベンチマークスイートのように独立して検証することはできません。
Terminal Benchは、エージェントがターミナル環境でタスクを完了する能力を評価します。
モデルは、ファイルの検査、コマンドの実行、依存関係のインストール、障害のデバッグ、コードの修正、完了の検証を行う必要がある場合があります。
高いスコアは、モデル、エージェントフレームワーク、ツール戦略、推論予算、ランタイム環境の複合的なパフォーマンスを反映しています。
Toolathlonは、複数のソフトウェアアプリケーションとツールにわたる長周期のタスクを評価します。
このベンチマークには、カレンダー、ファイルシステム、Notion、WooCommerce、Kubernetes、BigQueryを含むシナリオが含まれます。
タスクには複数のツールインタラクションが必要であり、実行ベースの評価器を通じて検証されます。
DeepSeekが報告した70.3点は、プレビューモデルから大幅な向上です。
ただし、これはすべての実際のビジネス自動化で70.3%の成功が保証されることを意味すると解釈すべきではありません。
情報源のゲーム例は、ベンチマークパフォーマンスと創造的コーディングの間の重要な違いを明らかにしています。
V4 Flashは公式エージェント評価で強力なパフォーマンスを示しましたが、ゲームの比較では依然として3回の反復が必要でした。
ベンチマークは、明確に定義されたタスクセットと既知の評価ルールの下での成功率を測定できます。
一方、創造的プロジェクトには、曖昧なビジュアル要件、ブラウザ互換性の問題、物理エンジンのバグ、リソースの欠落、主観的な品質評価が含まれる可能性があり、成功を定義する単一のテストスイートはありません。
このようなシナリオでは、ワークフローが複数回の反復に耐えられるため、低コストモデルは特に有用です。
その価値は、必ずしも初回生成が完璧であることにあるわけではありません。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
それは次の可能性があります:
許容可能な品質
×
大量の手頃な試行回数
DeepSeekは以下の方法でモデルを公開しています:
OpenAI互換のBase URLは次のとおりです:
https://api.deepseek.com
Anthropic互換のベースURLは次のとおりです:
https://api.deepseek.com/anthropic
DeepSeekは、V4 Flashが現在Responses APIをサポートする唯一のV4 APIモデルであると述べています。
V4 Proのサポートは別途計画されます。
Responses APIの互換性により、このモデルはDeepSeekの文書化された設定を通じてCodexでも使用できます。
DeepSeek V4 Flashは思考モードと非思考モードをサポートしています。
思考モードがデフォルトモードです。
ローカル推論の場合、公式モデルカードは3つの推論努力レベルをサポートしています:
low
high
max
DeepSeekは以下を推奨しています:
temperature = 1.0
top_p = 0.95
エージェントシナリオ向けに。
highおよびmaxの推論努力レベルでは、最大出力長を384Kトークンまで許可することを推奨しています。
より高い推論設定は困難なタスクのパフォーマンスを改善できますが、遅延、出力量、APIコスト、およびエージェントループの所要時間も増加させる可能性があります。
本番システムは、タスク要件を確実に満たす最小の努力レベルを評価する必要があります。
DeepSeekはHugging Face上でV4 Flash 0731の重みをMITライセンスで公開しました。
これにより、このモデルは多くの大規模な商用リリースと比較して異常に寛容なライセンスとなっています。
開発者は公式モデルリポジトリをサポート対象エンジンとともに使用できます。その中には以下が含まれます:
このモデルはかなり大規模です。
コアモデルは284Bパラメータを持ち、0731チェックポイントには別のDSparkコンポーネントも含まれています。
実用的な速度で実行するには、大量のメモリとハードウェアリソースが必要です。
重みがダウンロード可能であることは、フルモデルが一般的なコンシューマー向けノートPCでスムーズに実行できることを意味するものではありません。
コミュニティの量子化バージョンはメモリ要件を削減できますが、精度、スループット、コンテキスト容量、DSparkの動作、ツール呼び出しの信頼性を変える可能性があります。
情報源のまとめでは、V4 Flashは毎回の比較で最良の結果を生むわけではないが、コストパフォーマンスの面では打ち負かすのが難しいと結論付けています。
これは例として妥当な要約ですが、重要な前提があります:
コストパフォーマンスは完全なワークフローに依存します。
V4 Flashは以下の状況で特に魅力的です:
一方、以下の状況では、より高価なフロンティアモデルが総合的には依然として経済的な場合があります:
正しい比較は次のとおりではありません:
トークンあたりの価格
ではなく:
検証済みの成功タスクあたりのコスト
磨き上げたデモだけをテストしないでください。
本番ワークロードに一致するタスクを使用し、困難で複雑なシナリオも含めてください。
モデル間でプロンプト、ツール、時間制限、再試行戦略、フレームワーク、サンドボックス、テストスイート、推論設定の一貫性を保ってください。
キャッシュミス入力、キャッシュヒット入力、出力トークン、ツール呼び出し、再試行回数、実行時間、人的レビュー、失敗した試行を追跡してください。
コードの場合、テストを実行し、保守性を確認してください。
ゲームの場合、コントロール、衝突、パフォーマンス、ブラウザ互換性を確認してください。
安定したコンテキストが複数のエージェントステップで繰り返し再利用される場合、キャッシュヒット価格が非常に低いモデルはより価値が高まります。
3回の安価な試行の後に成功するモデルは、高価格で1回成功するモデルよりもコストパフォーマンスに優れている可能性があります。
再試行が遅い、またはリスクがある場合、状況は逆になる可能性もあります。
DeepSeek V4 Flash 0731は、DeepSeekの小規模V4混合専門家モデルの公式なポストトレーニングバージョンです。プレビューバージョンに取って代わり、DSpark投機デコードモジュールが追加され、コーディングおよびツール使用型エージェントタスクに重点を置いています。
DeepSeekが現在発表している通常価格は、キャッシュヒット入力トークン100万個あたり0.0028ドル、キャッシュミス入力トークン100万個あたり0.14ドル、出力トークン100万個あたり0.28ドルです。同社は将来のポリシーとして、指定されたピーク時間帯に価格を2倍にすることを発表しました。
ある開発者は、Hermes Agentの1回の実行が32分で0.07ドルのコストでプレイ可能なファーストパーソンシューティングゲームを生成したと報告しました。これは標準化されたベンチマークではなくソーシャルメディアのケーススタディであるため、他のタスクではコストが高くなったり低くなったりする可能性があります。
V4技術レポートでは、コアFlashモデルの総パラメータ数は2840億、トークンあたりのアクティブパラメータ数は130億と記載されています。完全な0731バージョンのリポジトリには、付随するDSpark投機デコードコンポーネントが含まれているため、約3040億パラメータと表示される場合があります。
その低コストは、スパース混合専門家アクティベーション、圧縮された長いコンテキストアテンション、FP4/FP8混合精度、プロンプトキャッシュ、投機デコード、高並行サービスに由来しています。各トークンは総専門家のごく一部のみをアクティブ化します。
現在のAPI価格でははるかに安価であり、複数のコミュニティデモで競争力のあるパフォーマンスを示しています。Opus 5とGPT-5.6は一部のタスクで依然としてより強い初回通過の信頼性や品質を提供する可能性があり、それらのバイラルな比較は管理されたベンチマークではありません。
はい。DeepSeekはMITライセンスで重みを公開し、vLLMとSGLangの使用ガイダンスを提供しています。フルモデルは非常に巨大であるため、実際のローカル展開には大量のアクセラレータメモリまたは積極的なコミュニティ量子化スキームが必要です。
はい。DeepSeekは、公式FlashバージョンがResponses APIをネイティブにサポートし、Codexでの使用に適合されていると述べています。現在のV4 Pro APIはResponses APIをサポートしていません。
0731](https://huggingface.co/deepseek-ai/DeepSeek-V4-Flash-0731):公式モデルリポジトリ。重み、ベンチマーク、ライセンス、デプロイガイドを含む。
DeepSeek V4 Flash 0731は、開発者がわずか数セントで完全なインタラクティブなデモを構築できると報告したことで大きな注目を集めた。一人称視点シューティングゲームはわずか0.07ドルで構築されたと報告され、他のソーシャルメディア上の比較では、タスクコストがClaude Opus 5やGPT-5.6より数十倍低いことが示されている。
これらの例は管理されたベンチマークテストではないが、公式API価格はその中心的な主張を裏付けている。V4 Flashは、キャッシュされていない入力トークン100万個あたり0.14ドル、出力トークン100万個あたり0.28ドル、キャッシュヒット時は驚くほど低い0.0028ドルを請求する。
その経済性はシステム全体に由来する:トークンごとに13Bパラメータを活性化する284B MoEコア、圧縮された長コンテキストアテンション、FP4/FP8重み、100万トークンのコンテキストウィンドウ、効率的なサービング機能、そしてDSpark投機的デコーディング。0731アップデートはプレビューアーキテクチャを維持しつつ、新しいポストトレーニングを通じてエージェントの動作を改善した。
最も強力な公式証拠はベンチマークの向上である。Terminal Bench 2.1は61.8から82.7へ、Toolathlon-Verifiedは49.7から70.3へ上昇し、同時にモデルはFlash価格層を維持している。
V4 Flashの強みは、あらゆる比較で勝つことではなく、その極めて低い限界コストにより、
多くの最先端の価格設定モデルでは実現が困難な規模で、反復的なエージェント実験を実践的に可能にすることにある。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



