NVIDIAのCUDAの堀が消滅したと宣言される回数は非常に多く、そのフレーズはほとんど業界の儀式となっている。新しいアクセラレータが登場する。コンパイラがベータ版に入る。クラウドプロバイダーが…
NVIDIAのCUDA堀が終焉を迎えたと宣言される回数は、もはや業界の儀式と化している。
新しいアクセラレータが登場する。コンパイラがパブリックベータに入る。クラウド事業者が自社のAIチップを宣伝する。プログラミング抽象がポータブルなカーネルを約束する。開発者がもはやCUDAを手書きする必要はないと誰かが宣言する。
それでもCUDAは、次世代AIインフラストラクチャの中核に依然として君臨している。
最新の挑戦がより興味深いのは、それがAI自身から来ているからだ。
元Google Brain研究員のJeremy Nixonが設立したAIインフラストラクチャ新興企業Infinityは、そのIgnitionエージェントが、推論ソフトウェアスタックの重要部分を、馴染みのないd-Matrix Corsairアクセラレータに、従来のエンジニアリングプロセスをはるかに上回る速度で移行したと主張している。
最も注目すべき結果はこれだ:約10時間で、Ignitionは全32個の計算ユニットでテンソル並列の行列乗算を実現し、このチップの実測計算上限の92%に達した。
これは意味のある結果だ。しかし、これは10時間でCUDAを再構築したことを意味するわけではない。
Infinity自身のケーススタディは、完全なエンドツーエンドのQwen3推論パスには約10日を要し、必要な各操作が新しいハードウェア向けに書き直されたことを指摘している。そしてCUDAは、行列乗算の実装やモデルランタイムではない。それは、コンパイラ、ランタイム、ライブラリ、パフォーマンス分析・デバッグツール、通信システム、フレームワーク統合、ドキュメント、そして約20年にわたる本番運用の経験を含む、成熟したプラットフォームなのだ。
より良い問いは、AIが一夜でCUDAを複製したかどうかではない。
コーディングエージェントが、新しいAIチップを実用化するまでの時間を大幅に短縮できるかどうかだ。
その答えはますます「イエス」に傾いている。
NVIDIAが最もよく知られているのはハードウェアだ:H100、Blackwell、Rubin、そしてそれらを中心に構築された大規模システム。
その最も永続的な優位性は、ハードウェアを中心に構築されたソフトウェアにある。
CUDAの正式名称は**Compute Unified Device Architecture(計算統一デバイスアーキテクチャ)**である。NVIDIAはこれを、単なるプログラミング言語ではなく、アクセラレーテッド・コンピューティング・プラットフォームと表現している。
CUDAプラットフォームには以下が含まれる:
最下層では、CUDAによりエンジニアはNVIDIA GPU上で直接実行されるカーネルを記述できる。
その上にはcuBLAS、cuDNN、cuFFT、NCCL、TensorRT、TensorRT-LLMなどのライブラリがある。ライブラリの上にはPyTorch、TensorFlow、JAX、推論サーバー、研究コード、そして社内システムがある。
簡略化したビューは次のようになる:
アプリケーションとAIフレームワーク
↓
最適化ライブラリと分散システム
↓
コンパイラ、ランタイム、プロファイラ、デバッガ、カーネル
↓
NVIDIA GPUとインターコネクト技術
企業がNVIDIAエコシステムに留まるのは、CUDAの構文に慣れているからだけではない。モデル、テスト、デプロイシステム、パフォーマンス期待値、デバッグプロセス、そして本番チームのすべてが、スタック全体に依存しているからだ。
ハードウェアの変更は、ソースコードの翻訳以上のものを意味する——信頼の再構築が必要かもしれないのだ。
Infinityの公式ケーススタディは、広く拡散された見出しよりもはるかに厳密だ。
同社は、生成AI推論ハードウェアに特化した新興企業であるd-Matrixと協力した。そのCorsairアクセラレータは、NVIDIA GPUとは異なるアーキテクチャと命令セットを採用している。Infinityによれば、このチップには、一般的なプログラミングモデルがトレーニングデータから直接再現できるような公開ソフトウェアの歴史がほぼ存在しないという。
Ignitionはハードウェア情報を取得し、AIワークロードを実行するために必要な低レベルソフトウェアの生成を開始した。
Infinityの報告によれば、約10時間で同システムは以下を達成した:
Infinityは「光速」を、生成されたカーネルが達成するチップの到達可能な計算ピークに対する比率と定義している。公開されたケーススタディにおける経験的上限自体が、理論ピークの約90%である。
これは優れたカーネル迅速立ち上げの結果だが、完全なCUDA相当のプラットフォームではない。
行列乗算はTransformer推論の中核だが、これは操作カテゴリの一つにすぎない。
完全なモデルには、アテンション機構、正規化、活性化関数、ルーティング、量子化、KVキャッシュ管理、サンプリング、テンソル移動、状態処理、モデルサービングなどの追加作業が必要となる。
Infinityは、約10日以内にQwen3がCorsair上でエンドツーエンドに動作したと報告している。その後の資金調達発表では、その期間内に3つのフロンティアモデルがエンドツーエンドで動作し、カーネルはゼロから書かれたと述べられている。
このより長いタイムラインも依然として印象的だ。
馴染みのないアクセラレータを基本操作から実行可能なモデルランタイムまで引き上げることを、数ヶ月から数日に短縮できれば、新しいハードウェアを市場に出す際の経済性を根本的に変える可能性がある。
| 主張 | より正確な解釈 |
|---|---|
| 「AIが10時間でCUDAを再発明した」 | 誇張 |
| 行列乗算が10時間で動作 | Infinityの報告 |
| 経験的上限の92%のパフォーマンス | Infinityの報告 |
| Qwen3が約10日でエンドツーエンドに動作 | Infinityの報告 |
| Infinityが汎用推論ライブラリを構築中 | Infinityが確認 |
| 完全なCUDAエコシステムが再現された | 否 |
InfinityはIgnitionをAI研究エージェントと呼んでいる。
その目的は、モデル演算を特定のチップ上の効率的なワークに変換する低レベルソフトウェアを生成し、改善することだ。
このサイクルは、自動化されたパフォーマンスエンジニアリングプロセスに似ている:
コード生成
→ コンパイル
→ ハードウェア上で実行
→ 正確性のテスト
→ パフォーマンス測定
→ ボトルネック診断
→ 実装の修正
→ 繰り返し
人間のエンジニアは依然として、目標、ハードウェア情報、制約条件、受け入れ基準、高レベルの方向性を提供します。Ignitionは、反復的な探索と最適化の膨大な作業を実行します。
この種のタスクは、環境が非常に明確なフィードバックを生成するため、エージェントによる処理に最適です。
生成されたカーネル関数は、具体的な問題に基づいて評価できます:
ハードウェアとテストは客観的な事実に基づく根拠を提供します。
多くのソフトウェアタスクの受け入れ基準には曖昧さがあります。カーネル最適化は困難ですが、その一部のプロセスは定量化可能です。
有効な実装は、2つの独立した基準を満たす必要があります。
カーネルは、許容可能な数値許容差の範囲内で出力を生成しなければなりません。
カーネルは、既存の実装を置き換えることを正当化するために、ターゲットハードウェアを十分に効率的に活用しなければなりません。
エージェントは数百の候補を生成し、不正なものを拒否し、生き残ったものをベンチマークし、最も強い経路を継続的に最適化できます。
同じパターンは、NVIDIAのCUDAに特化したエージェント、INT21のPTX Kernel Factory、DeepSeekのTileKernelsの取り組み、そしてTritonやTileLangカーネルを生成する研究システムにも見られます。
最近の変化は、基礎モデルが数行の構文コードを埋めるだけでなく、より完全なループに参加できるようになったことです。
Infinityの技術ストーリーは投資家を魅了しました。
同社は2026年7月に1500万ドルのシードラウンドを完了したと発表し、調達後評価額は1億ドルとされています。Touring CapitalとPrincipal Venture Partnersが参加し、その他にも半導体業界の幹部や主要なAIラボに関連する研究者が参加しました。
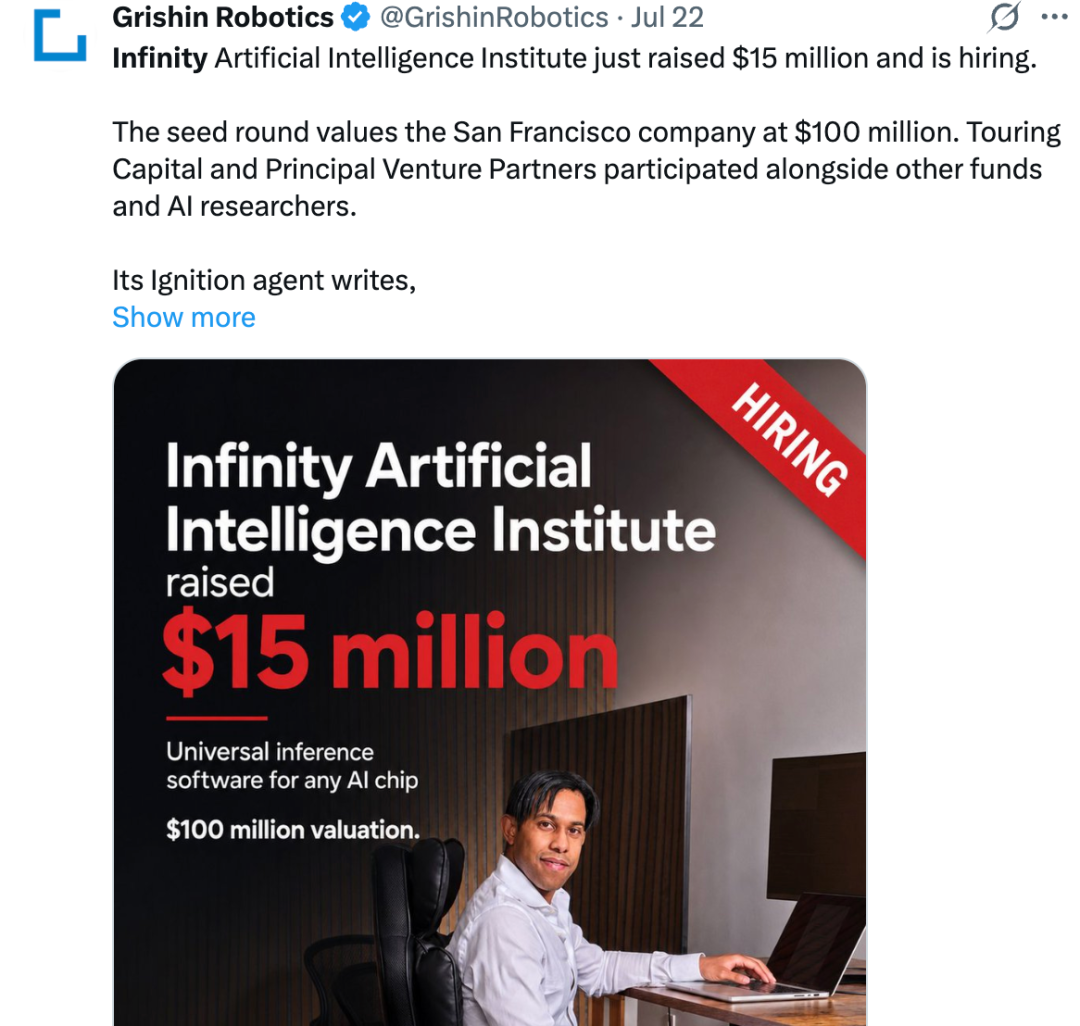
Infinityは、ハードウェアベンダーと推論サービスプロバイダー向けに、モデルを認識する推論ソフトウェア層を構築しています。同社の確立されたワークフローは、実際には次のとおりです:
ハードウェア仕様
→ 生成された本番グレードの推論ソフトウェア
Infinityはまた、NVIDIAの推論エンジンをゼロから構築し、Qwen3-8B上で設定が一致するvLLM実装よりも最大34.3%高いパフォーマンスを達成したと報告されています。
この結果は同社による自己報告であり、ハードウェア、バッチ設定、モデル構成、測定方法に依存しています。それでもなお、Infinityの野心が単なる基本的なチップ起動をはるかに超えていることを示しています。
元の記事では、DeepSeekのTileKernelsリポジトリについても言及されていました。
TileKernelsは、TileLangを使用して書かれた最適化されたGPUカーネルライブラリです。TileLangは、高性能カーネル開発のためのPythonベースのドメイン固有言語です。
このリポジトリには以下の操作が含まれています:
DeepSeekは、多くのカーネルが計算強度またはメモリ帯域幅の点でハードウェアの限界に近づいており、一部のカーネルはすでに社内で使用されていると述べています。
TileLangは、エンジニアが手動で記述しなければならない低レベルのCUDA C++コードの量を削減します。
現在の形式では、DeepSeekがNVIDIAの技術スタックへの依存を排除したことを示すものではありません。
公式のTileKernelsの現在の要件は次のとおりです:
NVIDIA SM90またはSM100 GPU
CUDA Toolkit 13.1以降
PyTorch 2.10以降
TileLang 0.1.9以降
現在のライブラリは、最新のNVIDIAアーキテクチャ向けに設計されています。手書きのCUDAソースコードへの依存は弱めますが、NVIDIAハードウェアやCUDAツールキットへの依存は弱めません。
TileLang自体には、より広範な野心があります。
このプロジェクトは、TVMコンパイラ基盤に基づき、Pythonスタイルの構文を使用してGPU、CPU、アクセラレータカーネル向けに設計されたタイル型プログラミングモデルを説明しています。
その目標は、エンジニアが望むデータフローと、効率的な実行に必要な低レベルのスケジューリングを分離することです。
TileLangは、マルチバックエンド言語サポートと、CUDA、ROCm、Metalを含むハードウェアパスを継続的に追加しています。
この移植性により、ベンダー間の切り替えコストを削減できます。ただし、生成された結果が正確で、安定しており、デバッグ可能で、ベンダーライブラリと競争力がある場合に限ります。
どこでも実行できるがパフォーマンスが低いカーネルは、本番環境のCUDAパスを置き換えることはできません。
2026年7月の研究論文では、TritonとTileLangにおけるカーネルの正確性と代替品質のギャップが調査されました。
著者らは、カーネルが数値的正確性テストに合格しても、最適化されたベースラインよりもはるかに低いパフォーマンスしか発揮しないことを発見しました。報告によると、TileLangのLayerNorm実装は、正確性チェックに合格したにもかかわらず、PyTorchベースラインよりも300倍以上遅く実行されました。
この論文はTileLangに反対するものではなく、生成されたカーネルを2つの次元で評価することを主張しています:
正確性
+
ハードウェア効率
コード生成はますます高速化しています。しかし、生成されたコードが成熟した本番ソフトウェアを置き換えるのに十分であることを証明することは依然として困難です。
CUDAへの挑戦は、最先端モデルのトレーニングよりも推論分野でより信頼性があります。
大規模なトレーニング実行には、数千から数万のアクセラレータが数週間から数か月にわたって連携して動作することがあります。
トレーニングプラットフォームは、多数のデバイスにわたる分散通信、チェックポイント、障害復旧、メモリ管理、並列性、再現性、デバッグを処理する必要があります。
一度のハードウェアまたはソフトウェアの障害で、多大な計算リソースが無駄になる可能性があります。そのため、各機関は重要なトレーニング負荷を成熟したシステムから移行する際に非常に慎重です。
CUDA、CUDA-X ライブラリ、NCCL、PyTorchサポート、およびNVIDIAの統合ネットワーク機能により、同社はこの分野で強力な立場を築いています。
推論は、モデルのトレーニングが完了した後にサービスを提供する段階です。
関連するビジネス指標は通常、次のものに近くなります:
許容可能な出力品質
÷
総サービスコスト
推論は、単一のアクセラレータ、小規模クラスタ、大規模フリート、専用ハードウェアに分散できます。
新しいチップは、すべてのシナリオでNVIDIAを置き換える必要はありません。特定のモデルまたは負荷について、コスト削減、高速化、低消費電力、高スループット、またはより予測可能なレイテンシーにおいて優位性を証明するだけでよいかもしれません。
このより狭い目標が、専用ハードウェアに現実的な参入ポイントを提供します。
d-Matrix は2019年に設立され、推論アクセラレーションに特化しています。同社のCorsairプラットフォームは大量のオンチップSRAMを活用し、生成モデルを実行するコストとエネルギー消費を削減することを目的としています。
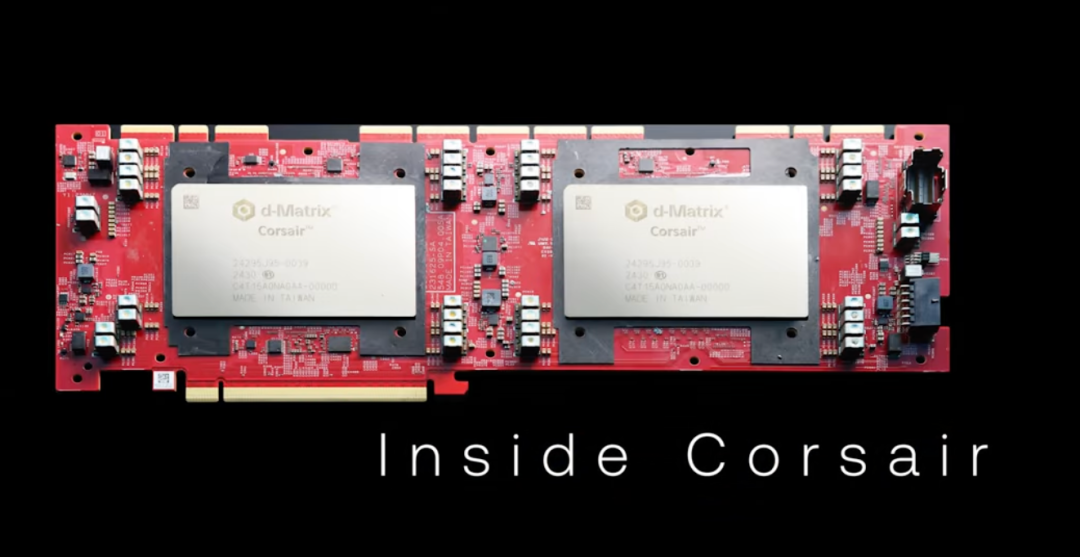
Infinityの取り組みは、新しいアクセラレータが直面する古典的な問題の一つを解決する。
あるチップが有望なハードウェアを備えていても、カーネル、モデル実行、メモリ処理、量子化、サービスロジック、統合ソリューションが整うまでは、顧客はそれを効率的に使用できない。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
エージェントがこの立ち上げプロセスを数か月から数日に短縮できれば、ハードウェア新興企業はモデルリリースに近い時期にサポートを提供でき、ハードウェアの能力をより早く示すことができる。
これにより、NVIDIAのソフトウェア優位性の一部は弱まるが、すべてが消えるわけではない。
推論市場には複数の挑戦者が存在する:
| ベンダーまたはプラットフォーム | 全体的な位置付け |
|---|---|
| Rebellions | 専用AI推論アクセラレータおよびシステム |
| Cerebras | トレーニングと推論のためのウェーハスケールシステム |
| AWS Inferentia | アマゾン設計の推論チップ、Neuron SDKを使用 |
| Google TPU | XLAおよび主要フレームワークでサポートされるGoogleアクセラレータ |
| AMD Instinct | ROCmプラットフォームを使用するデータセンターGPU |
| d-Matrix | SRAMを中心とした生成AI推論加速 |
| NVIDIA | GPUおよびCUDAアクセラレーテッドコンピューティングスタック |
圧力は、ユーザーがすべての操作を手動で書き直すことなくモデルをデプロイできるようにするソフトウェア層から来ている。これにはAWS Neuron、Google XLA、AMD ROCm、Modular MAXおよびMojo、TileLang、Triton、AI生成カーネルシステムが含まれる。
これらのソフトウェア層が自動化する内容が多ければ多いほど、アプリケーション開発者が手動で介入する回数は少なくなる。
CUDAに直接関わる内容。
アプリケーションとその最適化カーネルがNVIDIAハードウェアに緊密に結びついているとき、CUDAのロックイン効果は最も強くなる。
ポータブルな推論層は、次のワークフローを実現することを目指している:
モデル
→ ポータブル実行層
→ ハードウェアカーネルの生成または選択
→ ターゲットアクセラレータ
現実の世界はより複雑である。なぜなら、チップごとにメモリ階層、数値形式、相互接続方法、スケジューリング動作、サポートされる操作が異なるからだ。
高性能を実現するには、依然として特定のハードウェアに特化した作業が必要なことが多い。
Infinityの核心的な見解は、エージェントがこのような特化作業を自動生成できるというものだ。
10時間の結果では、CUDAを置き換えにくくしている資産を再現することはできない。
これらの資産には以下が含まれる:
多くの組織は、カーネルを直接記述する代わりにベンダーライブラリを使用している。cuBLAS、cuDNN、TensorRT、NCCLなどのライブラリには、長年の最適化経験が詰まっている。
NVIDIA Nsightおよび関連ツールは、エンジニアが正確性、メモリ動作、タイムライン、通信、パフォーマンスを理解するのに役立つ。
新しいモデル機能は、通常、NVIDIAハードウェア向けに早期に統合および最適化される。
本番チームは、負荷がかかった状態でのNVIDIAシステムの動作を理解している。
このエコシステムには、サンプル、コース、カンファレンスでの講演、コミュニティの回答、専門家向けリソースが含まれている。
企業は、数百万行のコード、テスト、調達プロセス、従業員のスキルをこのプラットフォームに結び付けている。
AIは移行コストを削減するかもしれないが、組織レベルの切り替えコストを自動的に排除するわけではない。
INT21の創業者であり、NVIDIAが買収したHippoMLの創業者でもあるBing Xu氏は、検証が主要なボトルネックであると考えている。
エージェントはコードを迅速に生成できる。しかし、本番チームは以下の証拠を依然として必要とする:
NVIDIAはすでに、多数の適合性テスト、パフォーマンステスト、リファレンス実装、シミュレータ、パフォーマンスアナライザ、コンパイラ診断、本番ワークロード、過去のエラーデータを保有している。
これらの資産により、エージェントはより有用になる。
したがって、AIは堀をコード生成から検証環境の品質へと移行させる可能性がある。
CUDAに挑戦する技術は、NVIDIAにも同様に適用される。
Business Insiderは、NVIDIAの開発者エコシステム担当バイスプレジデントであるAnkit Patel氏の言葉として、同社がAIコーディングエージェントを使用してCUDAの開発をより迅速に、そしてより大規模な検証を行っていると報じている。
NVIDIAはすでに
さらに、既存のCUDA知識、最適化の専門知識、クラウド上のパフォーマンスプロファイリング、Nsightツール、ベンチマーク、MCPベースのサービスを組み合わせた CUDAスマート戦略も提案している。
NVIDIAは、AI生成によるCUDAおよびCUDAコア計算ライブラリコードのためのオープンベンチマークである ComputeEval を維持している。
このベンチマークは、テンソルコア、共有メモリ、ワープレベルプリミティブ、CUDAグラフ、ストリーム、イベントに関するタスクをカバーしている。
したがって、この競争は相対的なものである:
挑戦者ソフトウェアが追いつく速度
対
NVIDIAソフトウェアの改善速度
Modularの共同創業者兼CEOであるChris Lattner氏は、より慎重な見方を示している。
同氏は、コーディングエージェントはCUDAの優位性を即座に破壊するものではなく、漸進的な改善をもたらすものだと述べている。
元の記事は3つの理由をまとめている。
本番環境での最適化が、チップの経済的実用性を決定する。パフォーマンスの最後の数パーセントには、多大な専門家の作業が必要になる場合がある。
アプリケーションコードはオンライン上に豊富に存在する。
高度なカーネルおよびコンパイラエンジニアリングは比較的小規模な分野であり、最も強力な取り組みの多くは今でも非公開のままである。
技術的実現可能性は、認証コスト、運用リスク、従業員の再教育、契約、信頼性要件、機会費用を排除するものではない。
これらの見解は、エージェント型カーネルエンジニアリングが重要でないことを意味するものではない。強力なデモが直ちに市場での置き換えにつながらない理由を説明しているに過ぎない。
最も強力な解釈は「CUDAは死んだ」ではない。
CUDAの歴史的優位性のうち、ある層が複製されやすくなっている、というのが正しい読み方である。
エージェント、DSL、自動化コンパイラは、新しいチップ向けのカーネル、ランタイム、モデルサポートを構築するために必要な時間を短縮できる。
最も露出度が高い層は、初期推論の迅速な適応である。
最も保護されている層は、依然として大規模トレーニング、成熟した生成ライブラリ、検証、デバッグ、クラスタオーケストレーション、フレームワーク統合、既存顧客ワークフロー、継続的最適化である。
戦略的問いは、次のようなものから変化する可能性がある:
誰が最大量の手書きカーネルコードを所有しているか?
次のようなものへ:
誰が最良の自動生成、測定、
検証、最適化のクローズドループを所有しているか?
NVIDIAは、すでにハードウェア、ツール、ライブラリ、ワークロード、フィードバックデータを所有しているため、有利な立場にある。挑戦者たちは、エージェントが参入障壁を引き下げることで恩恵を受ける。
この両方は同時に成立し得る。
Infinityの結果は、ハードウェア新興企業の期待を変えた。
新しいアクセラレータは、有用なカーネルはすべて少人数の専門家チームが手書きする必要があるという前提を、もはや必須とはしなくなった。
エージェントは以下のことを実行できる:
これにより、チップの初回テープアウトから実用的なモデル推論の実現までの時間を短縮できる。
この短縮により、チップベンダーはより早期にハードウェアをデモンストレーションし、新モデルをより迅速にサポートし、ソフトウェア要員の負担を軽減し、より多くのアイデアをテストし、より細分化された推論市場で競争できるようになる。
この結果はCUDAを消し去るものではないが、CUDAと競争するための第一歩を踏み出すことを以前ほど困難なものではなくする。
Infinityが公表した結果は、同社およびそのハードウェアパートナーによるものである。外部ベンチマークがより強力なエビデンスを提供するだろう。
汎用推論層は、多様なアーキテクチャ、モダリティ、量子化フォーマット、サービスパターンをサポートしなければならない。
エンドツーエンドで実行されるデモと、顧客トラフィック下で数ヶ月間継続的に稼働するソフトウェアは別物である。
重要な問いは、エージェントシステムが膨大なテスト空間において正確性と性能をどのように証明するかである。
ある実装がNVIDIA、AMD、Apple、その他のアクセラレータ上でも優れた結果を出せるならば、TileLangおよびその他のDSLはより戦略的重要性を増す。
NVIDIAは、エージェント、ベンチマーク、コンパイラインテリジェンス、新しいCUDA抽象化を積極的に構築している。既存の巨人は立ち止まっていない。
いいえ。Infinityは、Ignitionが10時間でd-Matrix Corsair向けのテンソル並列行列乗算ソフトウェアを生成し、同チップの経験的计算上限の92%に達したと述べている。エンドツーエンドのQwen3推論には約10日を要し、このプロジェクトはCUDAの完全なエコシステムを再現したわけではない。
Ignitionは、InfinityのAI研究・エンジニアリングエージェントであり、低レベル推論ソフトウェアの生成、テスト、デバッグ、最適化を行う。実ハードウェアからのフィードバックを利用して、カーネルとモデルランタイムを反復的に改善する。
Corsairは、d-Matrixが提供する生成AI推論プラットフォームである。Infinityはこれを、テンソル並列オペレーションと完全なモデル推論スタックを自動生成するためのターゲットプラットフォームとした。
いいえ。TileKernelsはTileLangを使用して手書きの低レベルCUDAカーネルの必要性を減らすが、現時点での要件にはNVIDIA SM90またはSM100ハードウェア、およびCUDA Toolkit 13.1以降が含まれる。
推論はより小規模なシステムで実行でき、通常は単一モデルのコスト、消費電力、スループット、レイテンシで評価される。最先端のトレーニングには、より大規模なクラスタ、成熟した通信システム、障害回復力、実証済みの安定性が必要である。
CUDAの堀には、成熟したライブラリ、フレームワーク統合、デバッグおよびパフォーマンス分析ツール、分散システム、ドキュメント、本番稼働実績、既存の顧客コードが含まれる。検証と継続的最適化は、コード生成コストがますます低くなるにつれて、さらに重要性を増す可能性がある。
あり得る。研究によれば、カーネルは数値的正確性テストに合格しても、その性能は最適化されたライブラリ実装に大幅に及ばない場合がある。本番環境での評価には、正確性チェックとハードウェア効率チェックの両方が必要である。
はい。NVIDIAはCUDA開発と検証を加速するためにエージェントを使用していると述べており、CUDA向けエージェントワークフロー、パフォーマンス分析統合、ComputeEvalベンチマークを公開デモンストレーションしている。
inc/research): d-Matrix、生成系推論ソフトウェア、および同社のOMEGAリサーチシステムに関する公式ケーススタディを網羅。
InfinityのIgnitionエージェントは、10時間以内にNVIDIA CUDAを再発明したわけではない。未知のアーキテクチャを対象に、高性能なテンソル並列行列乗算を生成したのである。
当時のd-Matrixアクセラレータは、チップの経験的な計算上限の92%に達したとされる。約10日後には、完全なQwen3推論パスが実装された。
この成果は今でも意義深い。エージェントが新興AIチップのソフトウェア立ち上げ初期段階、特に推論領域を加速できることを示しているからだ。推論領域では、顧客は回答あたりのコストを重視し、より狭いワークロードに専用ハードウェアを採用することができる。
DeepSeekのTileKernelsとTileLangも同じ方向を指し示している。より多くのカーネル作業を、より高水準のシステムで表現し、自動最適化できるということだ。現在のTileKernelsバージョンは依然として最新のNVIDIA GPUとCUDAに依存しているため、手書きCUDAの作業を減らすものであり、そのプラットフォームを排除するものではない。
CUDAの堀は依然として深い。なぜなら、それは単なるソースコード以上のものを含んでいるからだ。ライブラリ、検証、性能分析、フレームワークサポート、分散トレーニング、本番環境での実績、そして既存の組織的投資は、いずれも複製が困難である。
AIは10時間でCUDAの堀全体を越えたわけではない——しかし、最初の防壁に到達するコストを引き下げ、長期的な競争をコード所有権から、自動生成・検証・最適化へと移行させた可能性はある。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



