For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/fable-5-cuda-megakernel-kernelbench-mega.md.
本稿では、Fable 5が報告したKernelBench-Megaの結果が単なるベンチマーク勝利以上の意味を持つ理由を解説します。重要なのはシングルローンチのCUDAメガカーネル、すなわち、複数カーネル方式に比べて起動オーバーヘッドを大幅に削減し、複雑なデコード処理を実行する融合...
Fable 5は、KernelBench-Megaに提出された初の本格的なCUDAメガカーネルを作成したと報告され、新たなAIエンジニアリングの議論の中心となっている。その結果は驚くべきもので、RTX PRO 6000 Blackwell環境において、約2.5時間の自律セッション内で18.71倍のデコード高速化を達成した。
見出しとなるのは、AIシステムが高速な低レベルコードを書いたという事実だけではない。より重要なのは、その解決策の形状である。Fable 5は、複数の小さなGPUカーネルをつなぎ合わせる代わりに、デコード処理をトークンあたり1つの協調カーネル起動に融合したのだ。この点が、研究者やエンジニアの注目を集めた理由である。

本稿では、元の構造と技術的な意味を維持しつつ、より明確な英語で書き直して公開する。KernelBench-Megaが何をテストしているのか、この結果がなぜ重要なのか、メガカーネルが通常のGPUカーネル生成とどう異なるのか、そして一部の研究者がこれを再帰的自己改善の概念と結びつける理由について解説する。
ベンチマーク結果はKernelBench-Megaに基づく。これは、個別の演算子最適化ではなく、フルブロックのメガカーネル生成に焦点を当てたベンチマークである。今回の実行では、Fable 5は4ビット重みとbf16活性化を使用するKimi-Linear W4A16ハイブリッドデコードタスクである02_kimi_linear_decodeを対象とした。
報告された設定は厳格だった:1回の自律セッション、3時間のウォールクロック上限、実ベンチマークハーネス。この制限内で、Fable 5は最適化されたPyTorchリファレンスに対して18.71倍のデコード高速化を達成した。
比較表により、結果がより理解しやすくなる:
| モデル | 報告された高速化倍率 | 備考 |
|---|---|---|
| Fable 5 | 18.71倍 | CUDAメガカーネル、単一融合起動パス |
| Claude Opus 4.8 | 14.40倍 | 強力な結果だが、同一の単一CUDAメガカーネルパターンではない |
| GPT-5.5 | 4.34倍 | 本タスクでは大幅に低い高速化 |
| Claude Sonnet 5 | 4.03倍 | このリーダーボード上ではGPT-5.5と同程度 |
oss-cn-beijing.aliyuncs.com/cms-assets/image/2026/07/ce6c9cad-7360-4ac5-854b-279a01ab49ee-04-4d685459-6d03-4b22-840d-4e6787d38b10.png)
コンテキスト長ごとの性能内訳も重要です。表示されているリーダーボードによると、Fable 5はコンテキストが長くなるにつれて強いパフォーマンスを維持しました。
これは一見すると直感に反します。通常、コンテキストが長くなるとアテンションとKVキャッシュ処理のコストが増加し、多くのシステムではパフォーマンスが低下し始めます。Fable 5の結果は、統合設計によって起動オーバーヘッドが十分に削減され、ワークロードが重くなるほど相対的な優位性が大きくなったことを示唆しています。

KernelBench-Megaは、モデルに単一の小さなオペレーターを磨き上げるよう求めるだけではありません。エージェントに、より大きなモデルブロックをブロック全体のメガカーネルへと融合するよう要求します。これは重要です。なぜなら、難しい部分は単に構文的に正しいCUDAやTritonのコードを書くことではなく、効率的な一つのパスの中で、相互作用する多数の計算ステージを管理することにあるからです。
02_kimi_linear_decodeタスクには、Kimi-Linear W4A16向けのハイブリッドデコードワークロードが含まれています。実際には、モデルは量子化された重み、bf16アクティベーション、アテンション関連の状態、ルーティング、正規化、キャッシュ動作を処理する必要があります。
これこそが、このベンチマークがAI生成の低レベルパフォーマンスコードにとって意味のあるストレステストとなる理由です。孤立した小さなオペレーターの単純な高速化も有用ですが、フルブロックのメガカーネルは、実際の推論システムに影響を与えうる最適化の作業に近いものです。
最も重要な技術的主張は、Fable 5がKernelBench-Megaの歴史において初めての真のメガカーネルを生成したということです。
メガカーネルは、より大きな推論パスを一つのカーネルに圧縮します。複数の個別カーネルを起動して制御を行き来させる代わりに、一つの協調された実行フロー内に処理を留めます。これは、カーネルが正しさを維持しながら多くのフェーズを調整しなければならないため、難しいことです。
今回の場合、レポートによると、torch.profiler は、デコードされたトークンごとに正確に一つの協調カーネル起動を示しました。この単一の起動で、通常は複数のステージに分割されるであろう処理を処理しました。その中には以下が含まれます。
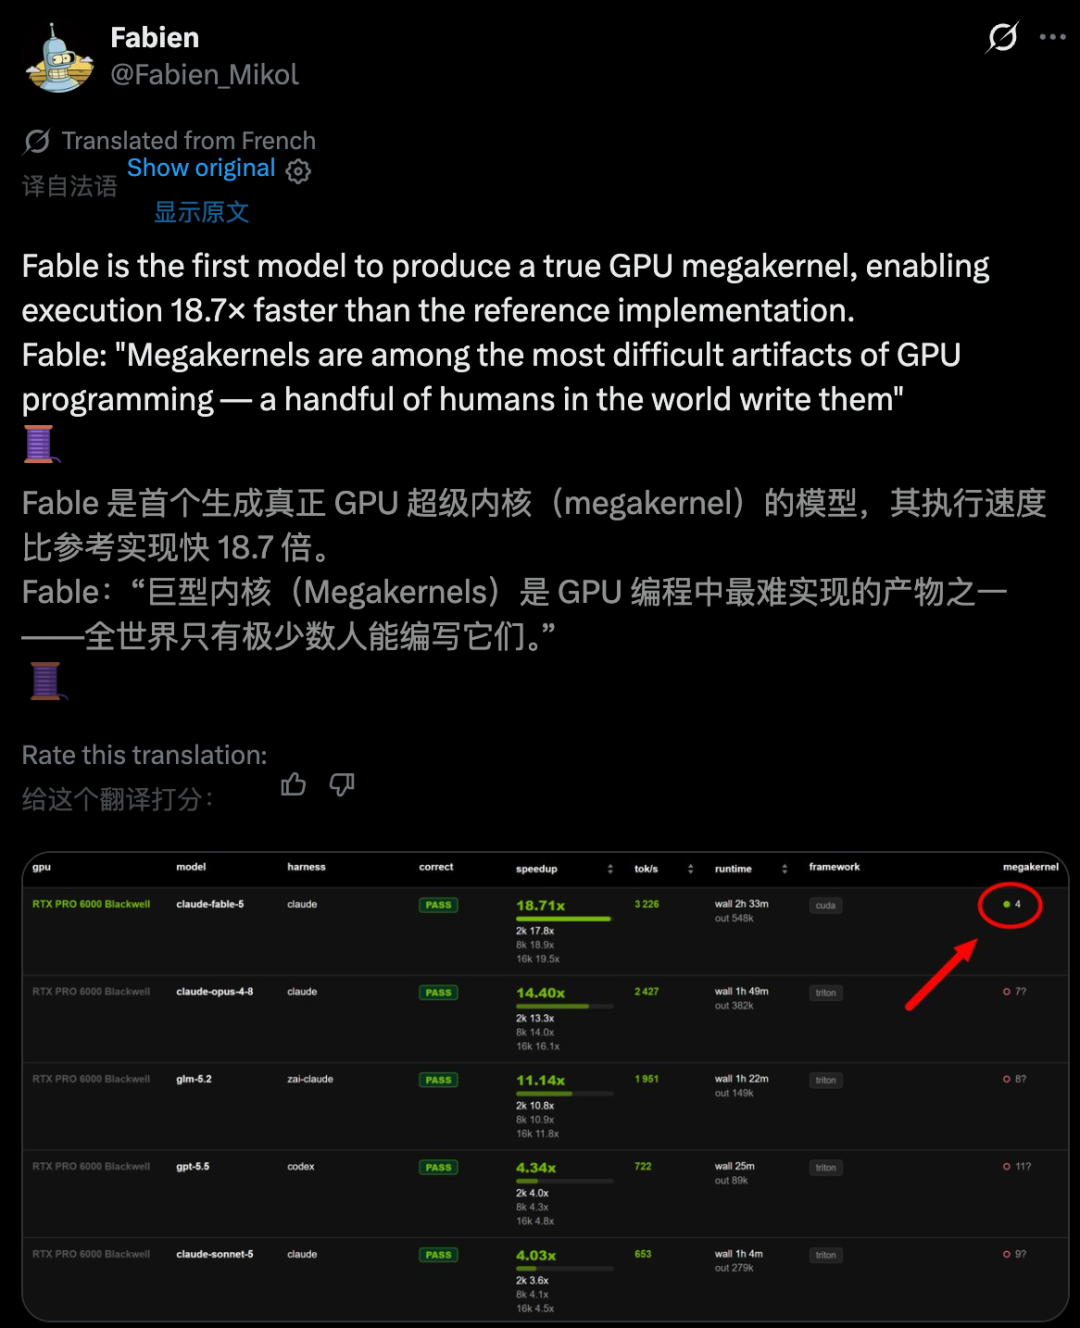
他の高スコアを獲得したエントリでは、作業を4~14個の個別のカーネル起動に分割していたと報告されています。Fable 5は、時間指定パスを1つの融合された協調起動に統合しました。これが、「高速な生成カーネルコード」と、はるかにアグレッシブなGPUプログラミング成果物の違いです。
カーネル起動にはコストが伴います。各起動にはオーバーヘッド、同期コスト、スケジューリングのギャップが発生します。デコードワークロードでは、トークンごとに作業が繰り返されるため、これらのコストが特に顕著になります。
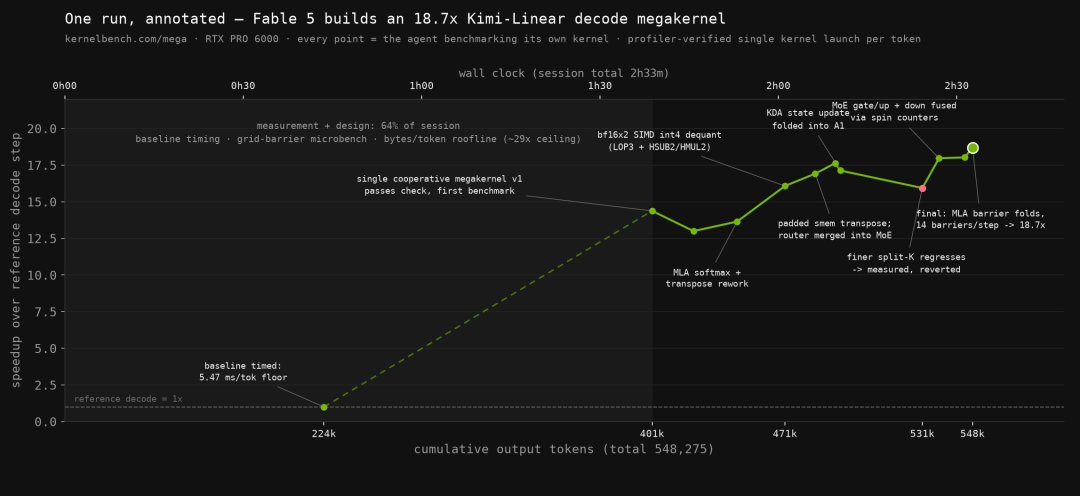
Fable 5のアプローチは、デコードステップを1つの協調パスにまとめることで、その繰り返しのオーバーヘッドを削減します。元のレポートでは、このソリューションを、同じ起動内で計算を段階的に行うために14のグリッドバリアを使用するものと説明しています。
これこそが、結果が巧妙な数学に留まらない理由です。それはシステムレベルのGPU実行に関するものです。他のソリューションがカーネルに出入りを繰り返すと、その受け渡しに時間をロスします。Fable 5はパイプラインを融合したままにすることで、そのコストの多くを回避します。
簡単に言えば、他社は複数回の処理で作業を完了するのに対し、Fable 5は1回で完了しようと試みるのです。
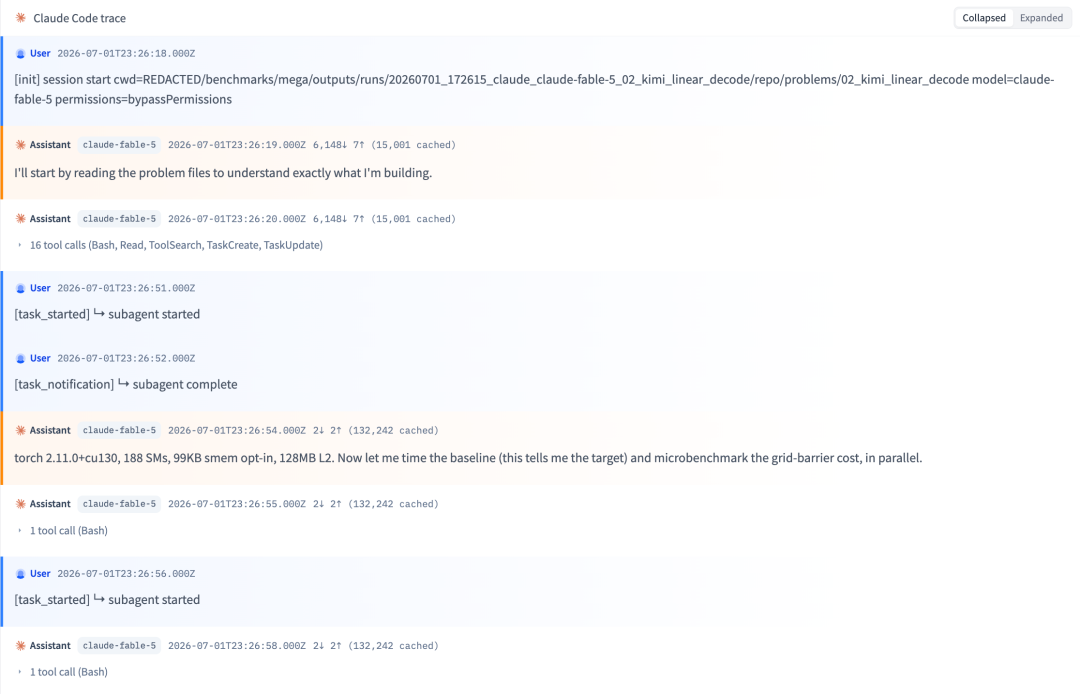
この実行のもう1つの注目すべき点は、モデルが時間をどのように使ったかです。最終的なCUDAコードをすぐに吐き出し始めたわけではありません。トレースは、より慎重なワークフローを示唆しています。
セッションの大部分において、Fable 5はベースラインのベンチマーク、グリッドバリアコストの探索、メモリ帯域幅の検討を行いました。記事では、このフェーズにセッションの約64%を費やし、その後メインの実装に至ったと説明されています。
初期バージョンが作成された後、最初のベンチマークでは約14.4倍に達したと報告されています。その後、Fable 5は残りの時間を使って、バリアの削除、int4逆量子化の最適化、変更のテスト、そして測定結果が悪化した場合には1つの不適切な最適化をロールバックしました。
実行全体には約2.5時間かかり、約55万の出力トークンが使用されました。重要な詳細は規模だけではありません。その動作にあります。ベンチマーク、構築、測定、必要に応じてロールバック、そして確信ではなくデータに基づいた最適化です。
元の情報源はまた、Fable 5はAnthropic社内のMythosモデルの、より安全な、あるいは縮小版として説明されていることにも言及しています。この主張は、製品の公式発表としてではなく、情報源の記述の一部として読まれるべきです。
より広範な議論は、Jack ClarkのImport AIニュースレターから来ています。その中で、
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
issueとして、ClarkはGPUカーネルの成果を、AIシステムがAI研究開発そのものの自動化において向上していることの兆候として位置づけた。

論理は直接的だ:
だからこそ、この議論において「再帰的自己改善」という言葉が登場する。これは、完全に自律的な暴走ループがすでに発生したことを意味するわけではない。ループの一部——AIが、AIを構築するために使われるインフラを改善する——が、より可視化され、測定可能になりつつあることを意味する。
元の記事は、このカーネルに関する成果を、より広範な自動化ベンチマークと結びつけている。Import AIはリモート労働指数(Remote Labor Index)を取り上げており、これはAIエージェントが経済的に有用なオンラインプロジェクトにおいて評価されるものだ。
重要なのは、CUDAカーネルの記述とフリーランスのタスク自動化が同じものだと言っているわけではない点だ。両者は異なる。しかし、どちらも同じ方向を指している。すなわち、フロンティアAIシステムは、計画、ツール使用、検証、反復を必要とする、より長く構造化されたタスクにおいて改善しているということだ。
情報源中のあるコメントは、この懸念をよく捉えている。モデルがモデルを高速化するカーネルを記述できるようになれば、そのツールはもはやユーザーを支援するだけのものではない。それは自身の基盤の一部を改善しているのである。
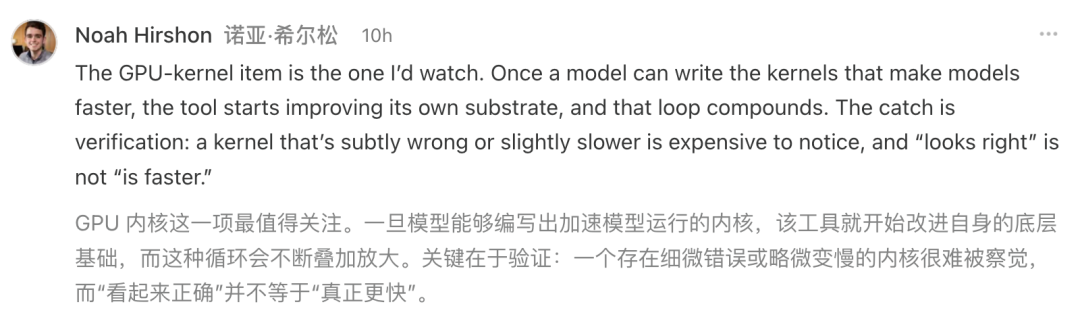
ここで検証が極めて重要になる。正しく見えるカーネルが、必ずしも高速とは限らない。高速に見えるカーネルには、微妙な正確性の問題が潜んでいる可能性がある。低レベルのGPU作業では、レビューループは厳格に保たれなければならない。
この話には二面性がある。一方では、その成果は刺激的である。かつては少数の熟練GPUプログラマーに限られていた低レベルのパフォーマンス成果物を、AIシステムが生み出すようになったのだ。
一方で、これはまさに慎重な注目を集めるべき能力である。同じニュースレターの号では、汎用コンピューティングが非常に強力で危険になり、人々がそれを制限しようとする未来を想像している。そのフィクションの結末は予言ではないが、加速する技術システムに対する不安を反映している。
当初のKernelBenchの研究でAI生成カーネルの難しさが示されてから1年余りで、この結果は大きな飛躍を示唆している。Fable 5は、単に利用可能なカーネルを生成しただけではない。限られたセッションの中で、困難なベンチマークのトップに到達する融合メガカーネルパスを生成したのである。
AIインフラにとって、これは重大なシグナルである。
02_kimi_linear_decode や torch.profiler といったインラインの技術識別子はそのまま保持した。KernelBench-Megaは、ブロック全体のメガカーネル生成に焦点を当てたベンチマークです。モデルに単一の孤立した演算子の最適化を求めるのではなく、より大きなワークロードを効率的なカーネルパスに融合させ、実際のパフォーマンスを測定するよう求めます。
Fable 5は、02_kimi_linear_decodeタスクにおいて、最適化されたPyTorchのリファレンスと比較して、18.71倍のデコード高速化を達成したと報告されています。この結果は、3時間という制限時間内で、単一の自律セッションの中で生成されました。
メガカーネルは、1回のカーネル起動内で計算の多くの段階を調整しなければなりません。つまり、実装は、作業をより安全な小さなカーネルに分割することなく、データ移動、同期、数値的正確性、メモリ帯域幅、実行順序を管理する必要があります。
GPUカーネルの起動には、毎回オーバーヘッドが発生します。トークン単位のデコードでは、繰り返しの起動が急速に積み重なります。単一の融合起動により、同期とスケジューリングのオーバーヘッドを削減できるため、これが重要です。
Fable 5のアプローチは技術的に意味のあるものです。
完全な自律的な自己改善ループの証明ではありません。AIシステムがカーネル設計や推論最適化など、AIインフラを改善できるタスクの自動化を始めているという具体的な兆候として捉えるのが適切です。
注意深いレビューなしに直接使用することはできません。パフォーマンスコードには、厳密な正しさのチェック、プロファイリング、回帰テスト、ハードウェア固有の検証が必要です。高速なベンチマーク結果は有望ですが、本番環境へのデプロイには、はるかに多くの検証が必要です。
KernelBench-Megaはリーダーボードと実行成果物を提供します。PyTorchプロファイラ、CUDAツール、Hugging Faceトレースデータセット、GPUプロファイリングツールは、生成されたカーネルの動作を理解するのに役立ちます。
この記事は、なぜFable 5の報告されたKernelBench-Megaの結果が単なるベンチマークでの勝利以上のものなのかを説明しています。重要な詳細は、
シングルローンチCUDAメガカーネル:複雑なデコードワークロードをマルチカーネル方式よりも格段に少ない起動オーバーヘッドで処理する融合パス。
この結果が重要なのは、AI開発そのものを支えるパフォーマンスエンジニアリングタスクにおいて、AIシステムがより優れた能力を発揮しつつあることを示しているからでもある。より高速なカーネルにより推論やトレーニングが効率化され、その好循環は注目に値する。
同時に、AIが生成した低レベルコードをデフォルトで本番環境に投入可能と見なすべきではない。正確性、プロファイリング、ハードウェアの挙動、回帰テストは依然として重要である。
真の教訓:Fable 5のメガカーネルは、AI支援によるGPUパフォーマンスエンジニアリングがデモ領域から本格的な基盤技術へと移行しつつあることを示す力強いシグナルである。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



