For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/fable-5-pxpipe-image-context-token-savings.md.
pxpipeは、Fable 5の入力コストを削減する巧妙な方法を示しています。トークンを大量に消費するコンテキストをコンパクトな画像としてレンダリングし、モデルの視覚機能でその画像を読み取らせるのです。高密度なコーディング作業では、これによりリクエスト側のトークン使用量を大幅に減...
意外なほど昔ながらの手法が、Fable 5コミュニティで注目を集め始めています。長いテキストのコンテキストを高密度な画像に変換し、その画像をモデルの視覚機能で再び読み取らせる、というものです。
まるで試験用の小さなカンニングペーパーを作るような話に聞こえるかもしれません。ただし、この場合の「カンニングペーパー」は人のためのものではありません。スクリーンショットを読めるマルチモーダルモデルのためのものです。ある開発者は、Claude Codeのコンテキストを高密度に詰めたPNG画像へ変換することで、テストしたワークロードにおいて入力トークン料金をおよそ59%から70%削減できたと報告しています。
シンプルな発想です。システムプロンプト、ツールドキュメント、コマンド出力、ログ、過去の会話履歴は、しばしば非常に多くのトークンを消費します。こうしたブロックを画像としてレンダリングすれば、画像トークンのコストは主に画像の寸法に依存し、画像内にどれだけ多くの文字が詰め込まれているかにはあまり左右されません。
本記事では、pxpipeが何をするのか、なぜこの方法でコストを削減できるのか、どこで限界があるのか、そしてCLIPPOのような先行研究や、DeepSeek-OCRのような新しい光学的コンテキスト圧縮の研究とどうつながるのかを見ていきます。
本記事は、BAAI Hubに掲載された中国語の原文記事に基づいています。同記事によれば、情報源はWeChat上のQbitAIです。元の参照リンクには、pxpipeのGitHubリポジトリとCLIPPOの論文が含まれています。以下に残している画像は、記事に関連するスクリーンショット、デモ、図表、ソーシャル上の議論のスクリーンショットです。QRコード、フォローを促す宣伝、エンゲージメント目的のCTA、無関係なプラットフォーム装飾は削除しています。
話題になった手法は pxpipe と呼ばれています。これは、リクエストがあなたのマシンを離れる前に、膨大なClaude Code入力コンテキストを書き換えるオープンソースのローカルプロキシです。
プロジェクトの説明によれば、pxpipeは大きなテキストブロックを画像としてレンダリングすることで、トークン使用量を削減します。同じシステムプロンプト、ツールドキュメント、ツール出力、過去の履歴でも、モデルが高密度に描画された文字を十分に読み取れるなら、はるかに小さなトークン量に収めることができます。
ある例では、約48,000文字のシステムプロンプトとツールドキュメントは、プレーンテキストのままだと約25,000トークンかかります。これを1573×1248の画像にレンダリングすると、同じ内容が約2,700画像トークンで済んだとされています。
この差こそが、コスト削減の源です。
おおまかな
考え方は次のとおりです。
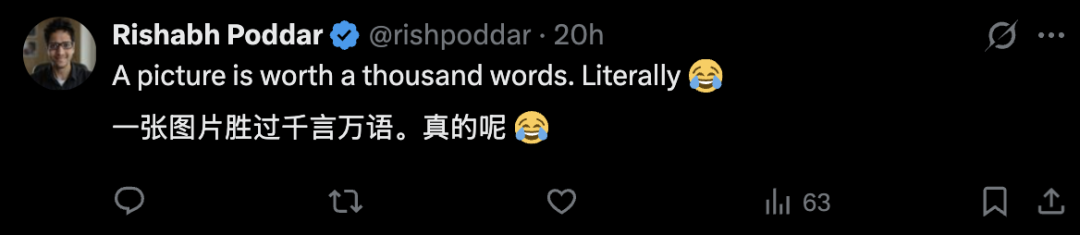
一部の開発者は、これは文字どおり「百聞は一見にしかず」のケースだと冗談を言っていました。この場合、その冗談は技術的な現実にかなり近いものです。

pxpipe は新しいモデルではなく、従来型の OCR エンジンでもありません。Claude Code とモデル API の間で動作するローカルプロキシです。
リクエストが送信される前に、pxpipe は圧縮に適した大きなブロックを探します。次に、それらのブロックをコンパクトな PNG ページにレンダリングし、画像入力としてリクエスト内に戻します。モデルは通常のビジョンチャネルを使ってそれらのページを読み取ります。
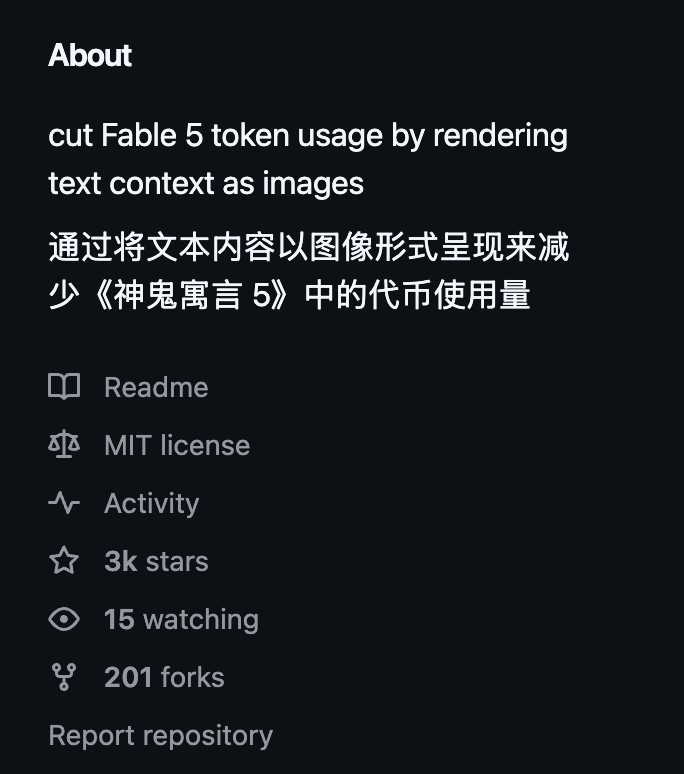
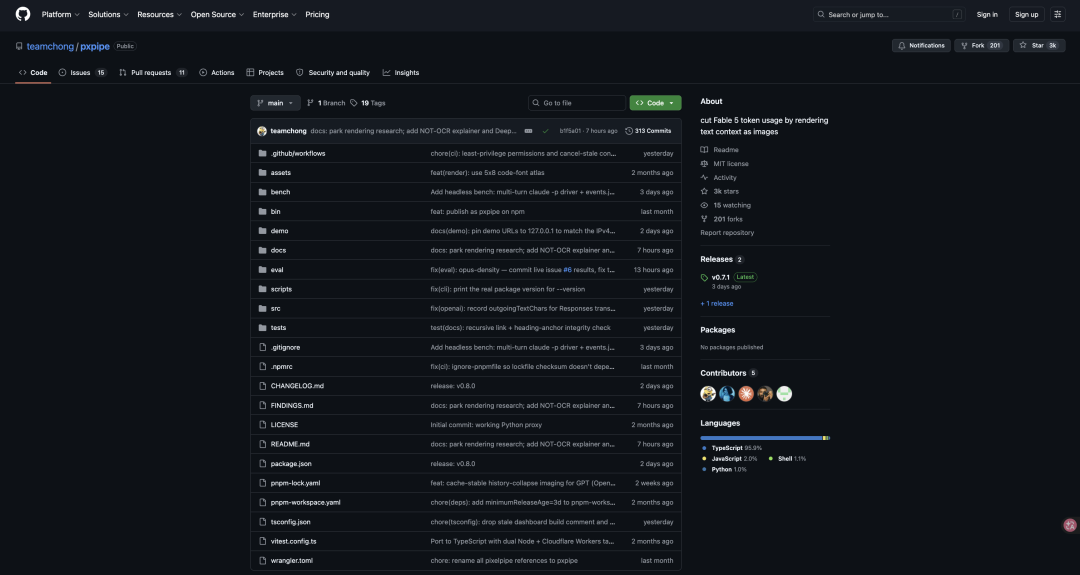
平たく言えば、pxpipe は長いコンテキストに対する自動マイクロプリンターのように振る舞います。厳密な工学的意味でモデルにテキストを「OCR」させているわけではありません。代わりに、スクリーンショットのような視覚入力を読み取るモデルの内蔵能力に依存しています。
pxpipe の README では、主に次のようなかさばる入力コンテキストを対象にしていると説明されています。
tool_result 本文意図的にすべてを変換するわけではありません。直近のターン、ユーザーメッセージ、正確な識別子、小さなブロック、疎な散文、モデル出力はテキストのまま残されます。
価格設定における根本的なミスマッチは、画像入力とテキスト
入力は異なる形で計測されます。
テキスト量の多い開発者向けワークフローでは、元データはトークン密度が高いことがよくあります。コード、ログ、JSON、スタックトレース、ツールスキーマは、プレーンテキストとして送るとコストが高くなりがちです。pxpipe の作者によれば、実際の Claude Code のトラフィックでは、高密度なコンテンツは画像トークン 1 つあたりおよそ 3.1 文字を詰め込める一方、テキストトークン 1 つあたりは約 1 文字だと見積もられています。
この比率により、テキストの密度が十分に高い場合、pxpipe にはコストを削減する余地があります。
作者は比較デモも共有しています。元のテキスト版では、あるテスト実行の最終請求額が 42.21 ドルで、コンテキストウィンドウもほぼ満杯になったと報告されています。pxpipe 版では、同じタスクが 6.06 ドルで完了し、コンテキストにもはるかに多くの空きが残っていました。
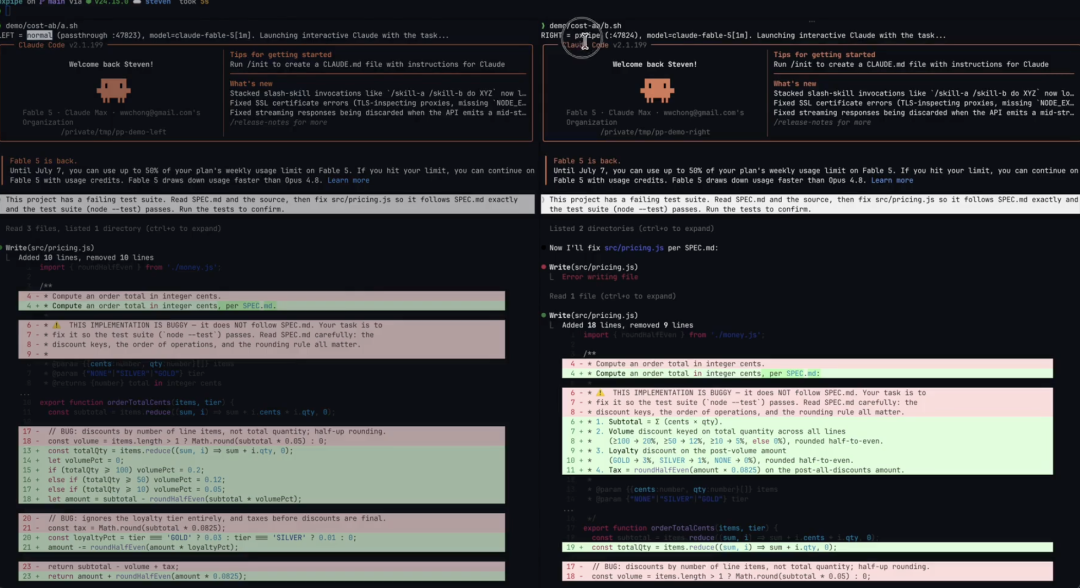
重要なのは、pxpipe が圧縮するのはリクエスト側だけだという点です。モデルの応答は引き続き通常どおりテキストとしてストリーミングで返ってきます。出力トークンは圧縮しません。
この手法は印象的ですが、可逆ではありません。高密度な画像コンテキストは、モデルの視覚的な読み取り能力に大きく依存します。
pxpipe のベンチマークのスクリーンショットでは、Fable 5 が新規算術、要旨想起、状態追跡、そして一部の高密度レンダリング想起テストを含む複数の画像コンテキスト課題で良好な性能を示しています。しかし、正確な文字列の想起は弱点であり、特に高密度テキストの読み取りが得意でないモデルではその傾向が強くなります。
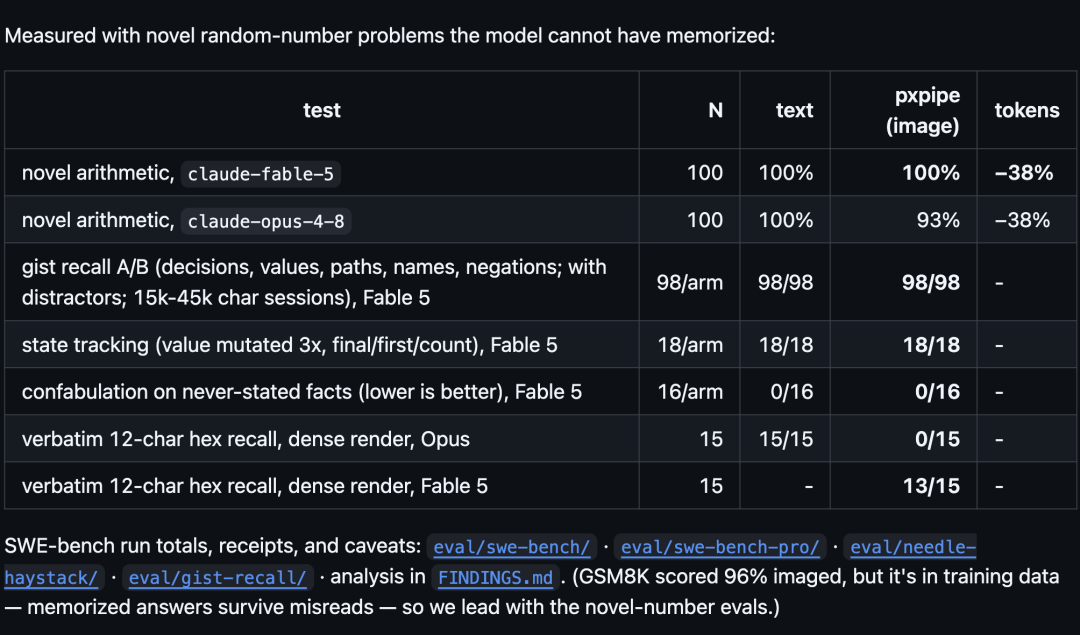
報告されたベンチマーク表を簡略化すると、次のようになります。
| Test | N | Text | pxpipe Image | Token Change |
|---|---|---|---|---|
Novel arithmetic, claude-fable-5 | 100 | 100% | 100% | -38% |
Novel arithmetic, claude-opus-4-8 | 100 | 100% | 93% | -38% |
| Gist recall A/B, Fable 5 | 各群 98 | 98/98 | 98/98 | — |
| State tracking, Fable 5 | 各群 18 | 18/18 | 18/18 | — |
| Confabulation on never-stated facts, Fable 5 | 各群 16 | 0/16 | 0/16 | — |
| Verbatim 12-char hex recall, Opus | 15 | 15/15 | 0/15 | — |
| Verbatim 12-char hex recall, Fable 5 | 15 | — | 13/15 | — |
危険性は明らかです。画像ベースのコンテキストは、大まかな意味理解、状態追跡、多くのコーディング作業には十分有効な場合がありますが、正確な文字列を気づかないうちに誤読する可能性があります。
ID、ハッシュ、シークレット、固定された数値、その他のバイト単位で正確である必要のある値は、高密度画像に押し込むべきではありません。pxpipe 自身の注記もこの点を強調しています。つまり、このトレードオフは重大であり、失敗時には明白なエラーではなく、自信満々だが誤った回答になる可能性があるのです。
以下のツイートには、@sanixdarker が返信しており、このやり方は目新しいものではなく、『Opus』のリリース以来ずっとそうしてきたのであり、『Fable』シリーズとは直接関係がないと述べている。画像は文脈と密接に関係しており、特定のデータを高密度画像に押し込むことで生じうるリスクについての議論を直感的に示している。](https://we0-cms.oss-cn-beijing.aliyuncs.com/cms-assets/image/2026/07/8d83ec15-fc8e-4019-8909-2d441f51f258-10-af6628e8-7211-4ee2-8a25-33b3a4e2a529.png)
圧縮は非可逆であるため、pxpipe はすべての入力ブロックを無条件に画像としてレンダリングするわけではない。機密性が高い内容や、精度が重要な内容はテキスト形式のまま保持する。
通常のテキストとして残すべき例は次のとおり。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
このため、このプロジェクトでは節約効果をワークロード依存として位置づけている。リクエストの大半が長い自然言語の文章であれば、圧縮は採算に合わない可能性がある。一方、コード、JSON、ログ、ツール出力が多く詰め込まれている場合は、節約効果がはるかに大きくなることがある。
作者は非常に簡潔な起動手順を示している。まずローカルでプロキシを起動し、その後 Claude Code からそのプロキシを参照する。
npx pxpipe-proxy                                  # 127.0.0.1:47821 でプロキシを起動
ANTHROPIC_BASE_URL=http://127.0.0.1:47821 claude  # Claude Code からそのプロキシを使う
起動後、pxpipe はローカルダッシュボードも公開する。
http://127.0.0.1:47821/
このダッシュボードでは、トークン節約量、テキストから画像への変換の比較表示、キルスイッチ、ライブのモデルタグなどを確認できる。これにより、何が圧縮され、何がそのまま通過しているのかを正確に把握しやすくなる。
pxpipe が広まり始めた後、一部の研究者は、この中核的な発想は完全に新しいものではないと指摘した。
関連する研究の流れは、Google の 2022 年の論文 CLIPPO: Image-and-Language Understanding from Pixels Only にすでに見られる。CLIPPO の中心的なアイデアは、テキストを独立したトークン化済みテキスト列としてではなく、ピクセルとして扱うことにある。
従来の CLIP スタイルのモデルは、画像用とテキスト用の 2 つのタワーを使うことが多い。CLIPPO はこの分離をなくし、テキストを RGB 画像としてレンダリングし、画像とレンダリング済みテキストの両方を共有の Vision Transformer に通す。
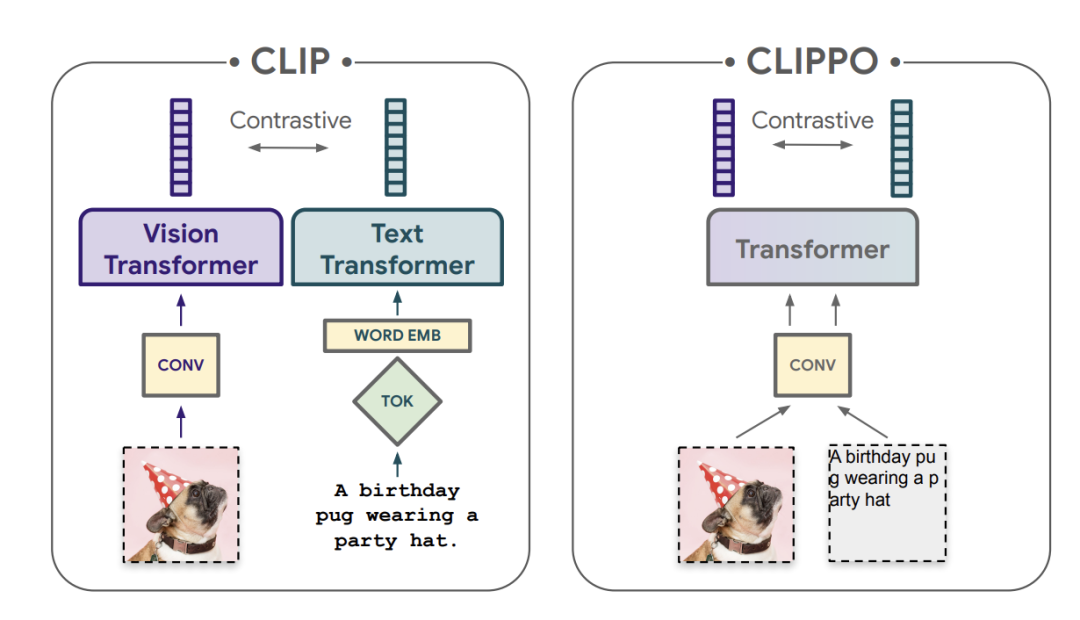
重要なポイントはこうだ。テキストは必ずしも離散的なテキストトークンとしてモデルに入力される必要はない。ピクセルへ変換し、視覚系の経路を通して処理することもできる。
この議論はまた
DeepSeek-OCRにも言及しており、これは長いコンテキストに対する光学的圧縮に焦点を当てています。そのリポジトリでは、このプロジェクトを「Contexts Optical Compression」と説明しています。
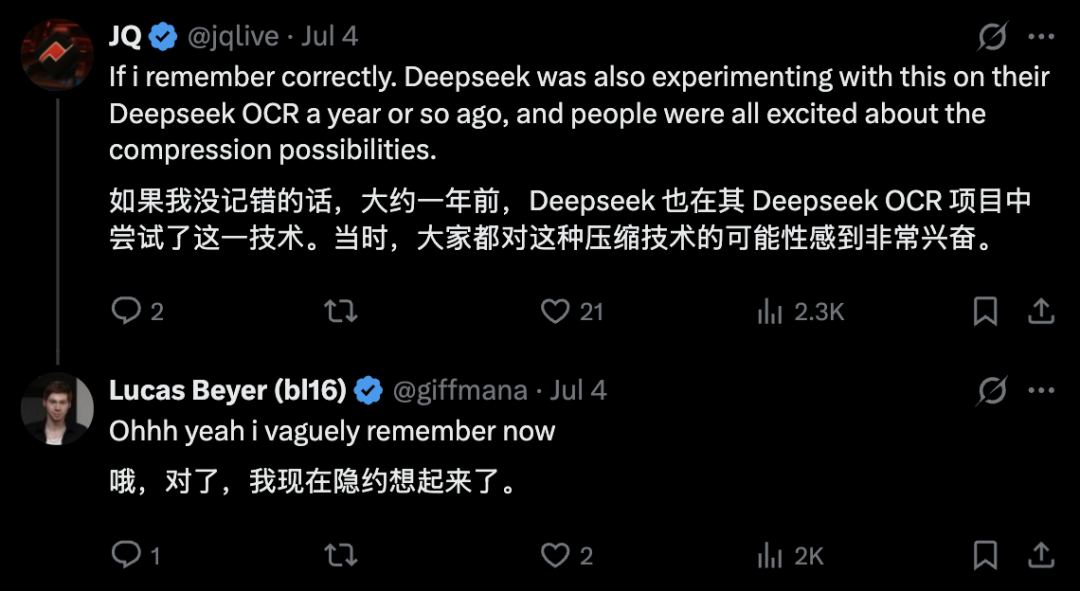
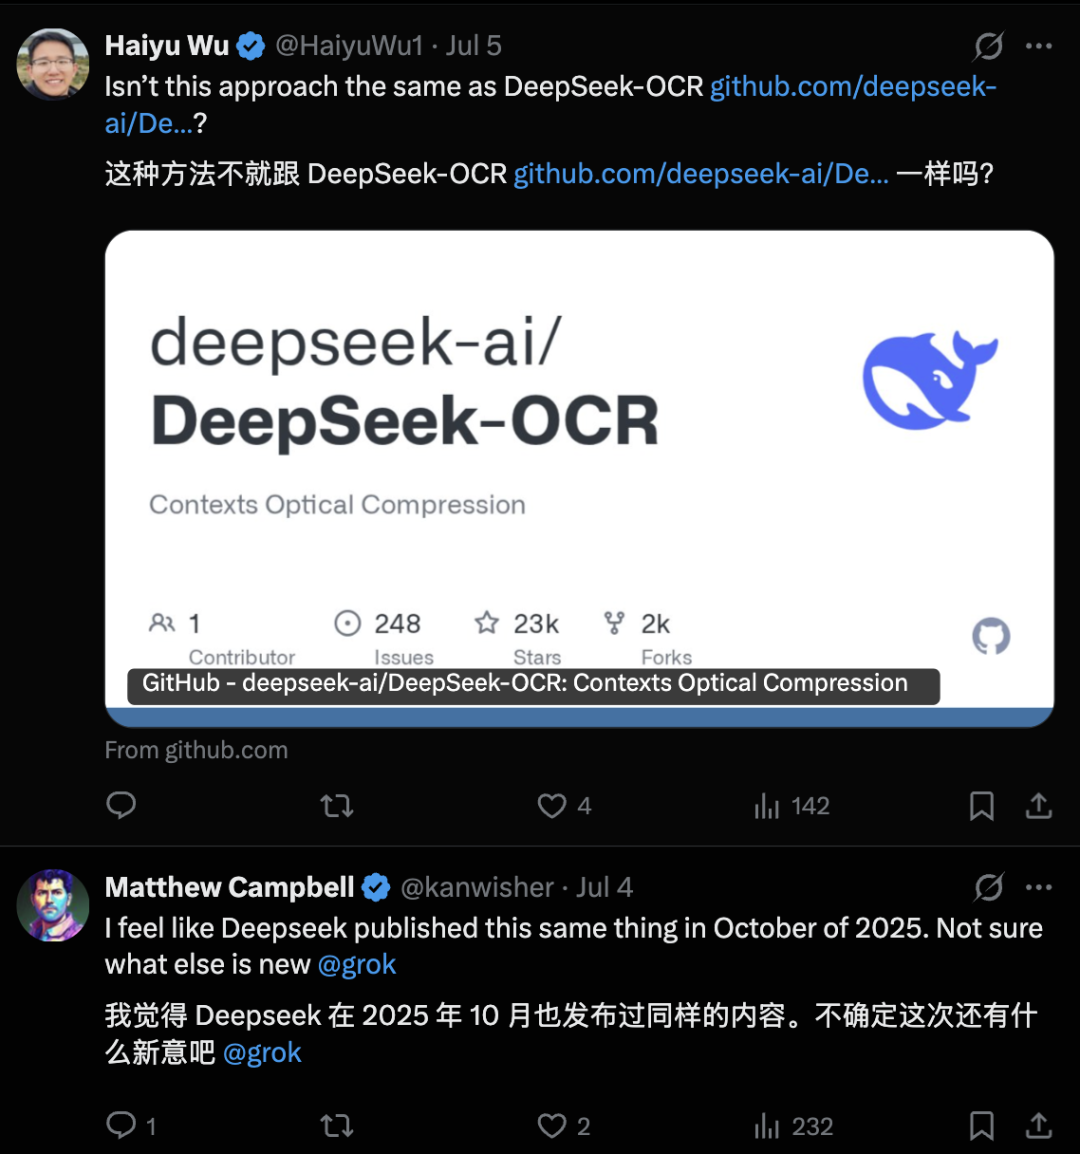
その意味で、pxpipeは単なる一発限りのコスト削減の小技ではありません。いくつかのトレンドを結びつけています。
ただし、依然として大きな制約があります。それは、文字列を厳密に一致させる信頼性です。一部のコメント投稿者は、この問題はより強力な視覚言語モデルを単純にスケールアップすることで改善する可能性があると示唆していました。
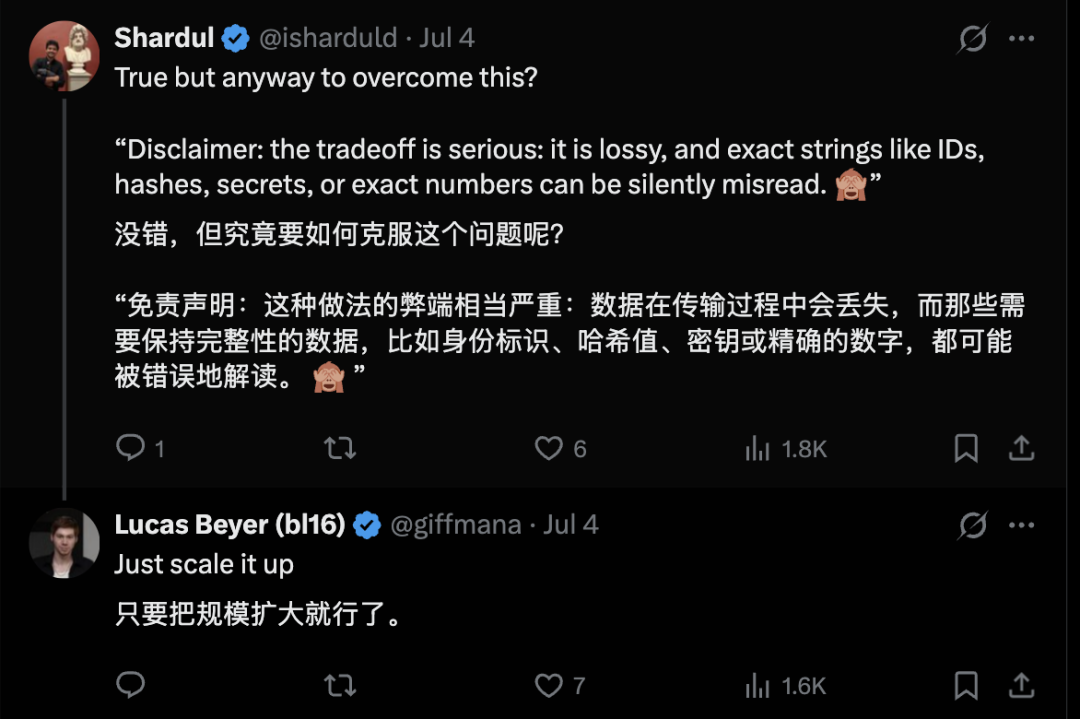
pxpipeが最も有用なのは、コンテキストが大きく、高密度で、かつ精密さが決定的ではない場合です。コーディングセッションは自然に適した用途です。というのも、エージェントは編集前にファイルを何度も読み返すことが多く、誤って読んだ画像ブロックに基づいて動作してしまうリスクを下げられるからです。
一方で、文字単位での正確な再現が重要なワークフローにはあまり向いていません。タスクが識別子、ハッシュ、認証情報、正確な法的文言、金融上の数値、あるいはそれに類する精度に敏感な内容に依存する場合、画像ベースの圧縮は慎重に扱うべきです。
pxpipeの賢明な使い方は、信頼境界ではなく最適化レイヤーとして位置づけることです。計算上メリットがある箇所では巨大なコンテキストを圧縮させつつ、重要な値はテキストのまま保持し、モデルの挙動がおかしいときにはダッシュボードを確認するようにします。
pxpipeは、かさばるClaude Codeの入力コンテキストをコンパクトなPNG画像にレンダリングすることで、トークン使用量を削減するローカルプロキシです。ツール出力、ログ、コード、システムプロンプト、古い会話履歴のような高密度なコンテキスト向けに設計されています。
これは、画像トークンのコストが主にピクセル寸法に依存する一方、テキストトークンのコストはテキスト量に応じて増えるという事実を利用しています。モデルが高密度にレンダリングされたテキストを信頼できる形で読めるなら、大きなブロックはプレーンテキストよりも画像のほうが安くなる場合があります。
いいえ。pxpipeが圧縮するのは、リクエスト送信前の選択された入力ブロックだけです。モデルの
レスポンスは通常どおりテキストとしてストリーミングされるため、出力トークンは削減されません。
いいえ。これは非可逆圧縮です。広い文脈の把握、状態追跡、多くのコーディング作業ではうまく機能しますが、ID、ハッシュ、シークレット、正確な数値のような厳密な文字列は誤読される可能性があります。
安全とはいえません。pxpipe 自身のドキュメントでも、モデル対応は限定的でワークロード依存であるとされています。高密度にレンダリングされたテキストを読む能力はモデルによって大きく異なるため、未対応または性能の弱いモデルでは、明示的に有効化しない限りテキストのまま通すべきです。
ID、ハッシュ、シークレット、正確な数値、ユーザーメッセージ、直近のやり取り、およびその他の精度が重要なブロックは、テキストのままにしておくべきです。pxpipe は、ログ、ツールドキュメント、古い履歴のような、長く高密度で、バイト単位の正確さへの依存が比較的低い素材により適しています。
npx pxpipe-proxy でプロキシを起動し、その後 ANTHROPIC_BASE_URL=http://127.0.0.1:47821 claude で Claude Code を実行します。ローカルダッシュボードは http://127.0.0.1:47821/ で利用できます。
pxpipe は、Fable 5 の入力コストを削減する巧妙な方法を示しています。すなわち、トークンを多く消費するコンテキストをコンパクトな画像にレンダリングし、モデルの視覚機能を通じてそれらの画像を読ませるという方法です。高密度なコーディング作業では、これによりリクエスト側のコストを大幅に削減できる可能性があります。
トークン使用量とエンドツーエンドのコストを低減できます。
その代わり、この手法には情報の欠落があります。多くのコーディングや状態追跡のワークフローにおいては、十分な意味を保持できますが、ID、ハッシュ、シークレット、あるいは正確な数値をバイト単位で厳密に再現する用途には信頼すべきではありません。
より広い観点で言えば、AIシステムの内部では、テキストが常にテキストのままである必要はありません。CLIPPO、DeepSeek-OCR、pxpipeはいずれも同じ考え方を示しています。つまり、ピクセルは長いコンテキストのための実用的な圧縮レイヤーになり得るということです。
最も適したユースケースは明確です。かさばる低精度のコンテキストは圧縮し、重要な正確値は通常のテキストのまま保持することです。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



