For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/gemini-4-argon-arc-agi-3-97-5-score-cost-f02ba71b.md.
ARC Prizeは、Gemini 4 ArgonがARC-AGI-3で97.5%の検証済みスコアを獲得したと発表しました。主催者によると、Google DeepMindはこのベンチマークで95%を超えた2番目のフロンティアAI研究機関です。
ARC Prizeは、Gemini 4 ArgonがARC-AGI-3で97.5%の検証済みスコアを獲得したと発表しました。主催者によると、Google DeepMindはこのベンチマークで95%を超えた2番目のフロンティアAI研究機関です。
この結果と同じくらい重要なのが、比較対象となる数値です。同じモデルファミリーは、Standardハーネスでは**49.8%**だったのに対し、Provider Adapterでは97.5%を記録しました。報告された評価コストは、それぞれ約5,800ドルと約4,800ドルです。
これらは、特定の設定を施したシステムの評価結果です。見出しの数値から結論を導く前に、ベンチマーク、推論レベル、ハーネス、未完了の実行について理解する必要があります。
ARC Prizeの発表には、次の数値が示されています。
| ベンチマークと設定 | 報告スコア | 報告された評価コスト |
|---|---|---|
| ARC-AGI-1、報告された最高設定 | 98.5% | 1タスクあたり約0.16ドル |
| ARC-AGI-2、報告された最高設定 | 91.3% | 1タスクあたり約0.32ドル |
| ARC-AGI-3、Provider Adapter、低推論 | 97.5% | 評価全体で約4,800ドル |
| ARC-AGI-3、Standard、低推論 | 49.8% | 評価全体で約5,800ドル |
コストの単位は異なります。 ARC-AGI-1とARC-AGI-2の金額は1タスクあたりですが、ARC-AGI-3の金額は評価実行全体を示しています。この違いを踏まえずに、同じコスト基準で比較すべきではありません。
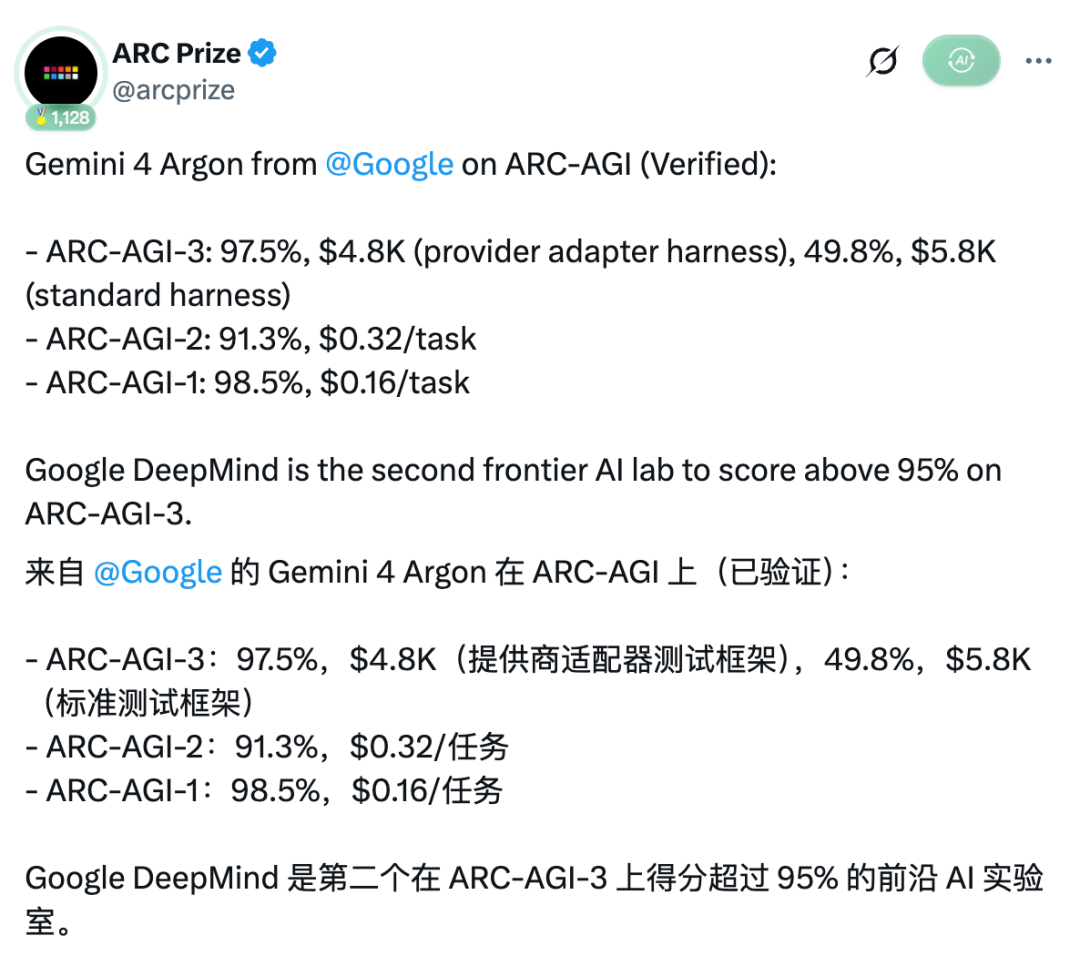
出典レポートに掲載された、ARC Prizeの検証済みスコアに関する発表。
ライブの結果表には、最高設定でのより正確なコストとして、ARC-AGI-1は1タスクあたり0.162ドル、ARC-AGI-2は0.325ドルと記載されています。ARC-AGI-2のスコアは91.3%で、発表の数値と一致しますが、同じ結果ページにある説明文では91.2%とされています。本記事では、発表と表に記載された数値を採用しつつ、この不一致を明記しています。
ARC-AGI-3は、最初の2世代とは異なります。静的な例から出力グリッドを推測するのではなく、エージェントは未知のインタラクティブな環境を探索し、行動の仕組みを発見し、ゲームを説明する自然言語の指示がない状態で目標達成の方法を学びます。
ARC Prizeは、このテストがスキル獲得の効率、適応力、時間経過に伴う計画能力を測るものだと説明しています。そのため、スコアは単純に「ゲームに勝った割合」を表すものではありません。ベンチマークの説明では、100%のスコアは人間の参照基準と同等の効率でゲームを完了することに結び付けられています。
出典では、ARC-AGI-3が3月に公開された頃のフロンティアモデルのスコアが1%未満だったところから、同年後半には上限に近い結果に至るまでの変化をたどっています。先行するOpenAIのGPT-6 Astraの結果に続き、Geminiが95%を超えたことも取り上げています。
この評価において、大きな変化であることは確かです。しかし、主催者が考え得るあらゆる種類の推論をテストしたことや、どちらかのシステムが人間と同じようにあらゆる新しいタスクを学習できると立証したことを意味するわけではありません。
また、レポートでは公開ゲーム25件における高い行動効率について、次のように述べています。人間のベースラインより行動数が62%少なく、3件のゲームではスピードラン記録と同等以上の速度を達成し、さらに6件では記録との差が10%以内でした。これらの比較は、出典で報告された公開セット上の観察結果です。評価対象の全55タスクや、任意のゲームに一般化すべきではありません。
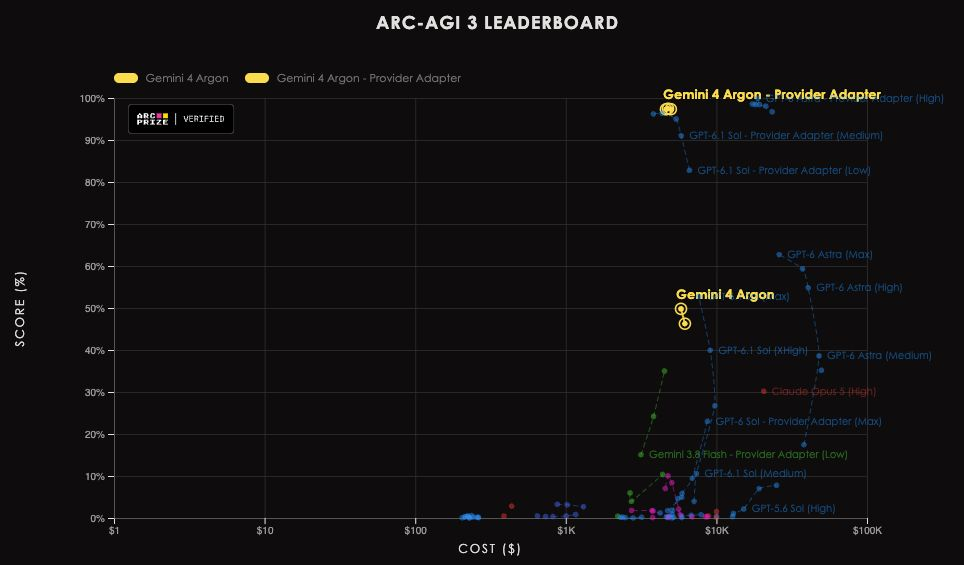
レポートに掲載されたリーダーボードのスクリーンショット。最新の設定詳細は、現在の結果ページを参照してください。
エージェントのハーネスは、モデルを取り巻く対話の仕組みを制御します。たとえば、観察結果の受け渡し方、アクションの送信方法、保持されるコンテキスト、会話が長くなった場合の処理などです。
ARC Prizeは、2つの条件をそれぞれ次のように定義しています。
Gemini 4 Argonについて、現在の結果には次のように示されています。
| 推論レベル | Standardハーネス | Provider Adapterハーネス |
|---|---|---|
| 低 | 49.8% | 97.5% |
| 中 | 46.3% | 97.3% |
| 高 | 比較可能な完了結果なし | 97.3% |
低推論での差は47.7パーセントポイントです。この結果は、設定された対話システムが測定結果に大きく影響することを示していますが、単一の原因を特定するものではありません。ハーネスの種類だけでなく、コンテキスト管理、実行条件、APIの信頼性、その他の設定も考慮する必要があります。
特に、ARC PrizeはAPIの問題によりStandardでの評価を完了できなかったと報告しています。低・中・高の各実行で完了したタスクは、55件中それぞれ42件、46件、19件でした。報告された集計スコアは55件すべてを対象とし、未完了の実行から得られた部分点も含みます。完了件数は、42件または46件のゲームが必ず完全に解けたことを意味するわけではありません。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
Standardの高推論では比較可能な完了結果が得られず、グラフから除外されました。そのため、今回の評価では、推論努力を増やすことで結果が一貫して向上するという、完了済みのStandard結果の系列は得られていません。
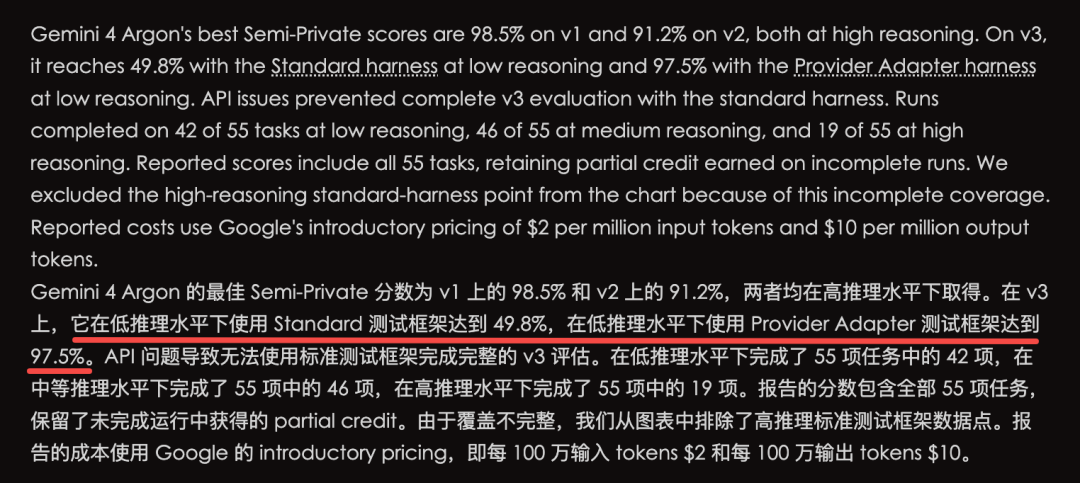
出典レポートに掲載された設定と評価範囲に関する注記。最新情報については、現在の結果ページを確認してください。
ARC Prizeによると、コストの推定にはGoogleの導入価格である入力トークン100万個あたり2ドル、出力トークン100万個あたり10ドルが使われています。これは現実世界の新しいタスクを解決する固定料金ではなく、価格や設定によって変わる可能性があります。
出典が示す実務上の主な教訓は妥当です。モデル名と単一のパーセンテージだけでは、評価対象のシステムの多くが分かりません。コンテキスト管理インターフェースが異なれば、同じモデル名が付いた2つのスコアでも、答えている問いは異なる場合があります。
ARC Prizeの方針では、異なる評価上の問いに対応するため、2種類のハーネスの結果を分けて報告すると明記されています。検証済みの結果は、公開された方法論に基づき主催者が実施した評価です。根拠の示されていないベンダー資料より強い証拠ではありますが、テストされたタスクの分布と条件の範囲内にとどまります。
これらの結果を比較する際は、ベンチマークのバージョン、正確なモデル設定、推論レベル、ハーネス、タスクの評価範囲、採点ルール、コストの単位の順に確認するとよいでしょう。こうすることで、実質的な改善と、異なる実験同士の比較を区別しやすくなります。
上限に近い性能は、テストにどれほどの伸びしろが残っているかという研究上の問いも提起します。しかし、残された限界がなくなるわけでも、「AGIベンチマーク」という言葉が汎用人工知能の証明になるわけでもありません。
ARC Prizeによると、低推論のProvider Adapterハーネスで97.5%を記録しました。低推論のStandardハーネスでは、未完了の実行を含む別の評価条件で49.8%でした。
いいえ。ARC-AGI-3は効率を基準とする採点システムで性能を測定し、部分点を付与する場合があります。スコアを、完全に完了したゲームの件数にそのまま置き換えることはできません。
Standardハーネスは、モデルが選んだメモを保持する、最小限のプロバイダー中立インターフェースです。Provider Adapterは、推論状態の保持や会話の圧縮など、プロバイダー固有のコンテキスト管理を利用できます。
発表された低推論の実行では、Provider Adapterが約4,800ドル、Standardハーネスが約5,800ドルでした。ARC Prizeによると、これらの推定には導入時のトークン価格が使われています。金額は評価全体の費用であり、1タスクあたりの価格ではありません。
ARC Prizeは結果を検証済みと表示し、テスト方針とモデル別の結果ページを公開しています。本記事ではそれらの記録を確認していますが、評価を再実行したり、スコアを独立して再現したりはしていません。
いいえ。単一のベンチマークでその結論を確立することはできません。この結果は、指定されたシステム設定でARC-AGI-3において高い性能を示したものですが、その条件を超えた信頼性や汎化能力については、さらなる証拠が必要です。
Gemini 4 Argonの検証済みARC-AGIの結果は、静的テストとインタラクティブテストの両方で高い性能を示しています。ARC-AGI-3の97.5%という見出しの数値は、特定の低推論Provider Adapter設定に基づくもので、報告された評価コストは約4,800ドルです。
Standardの結果、未完了の実行、コンテキスト管理の違いは、比較を正しく解釈するうえで欠かせません。パーセンテージだけで判断せず、モデル、ハーネス、評価条件をあわせて確認してください。この数値だけでAGIが立証されるわけではありません。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



