For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/glm-5-3-highspeed-in-zcode-490-tps-test-1-df8d564e.md.
新しいZ.aiのモデル名である**GLM-5.3 Highspeed**が、ZCode内にひっそりと登場しました。
新しいZ.aiのモデル名であるGLM-5.3 Highspeedが、ZCode内にひっそりと登場しました。
このモデルはZCode 3.15.1で確認され、一部のサブスクライバーがランダムにHighSpeedトライアルへ選ばれています。ユーザーの@leo114119は、出力速度が毎秒490トークン近くに達した実行結果を投稿しており、別のスクリーンショットでは約493 tok/sと表示されています。
これは目を引く数字です。
モデルが毎秒490出力トークンを維持できる場合、10,000出力トークンの生成にかかる時間は、およそ次のようになります。
10,000 / 490 ≈ 20.4秒
この計算にはトークン生成フェーズのみが含まれます。最初のトークンが出るまでの時間、可視出力前の推論、ツール呼び出し、ネットワークのオーバーヘッド、エージェントワークフロー内の停止時間は含まれていません。
さらに重要なのは、490 TPSという結果は現時点ではコミュニティによる観測であり、Z.aiが公式に保証するスループットではないことです。
確認されているのは、ZCode 3.15.1がサブスクライバー向けにランダムなGLM HighSpeedトライアルを導入したこと、そしてglm-5.3-highspeedという識別子がすでにPiの公開モデルカタログに掲載されていることです。
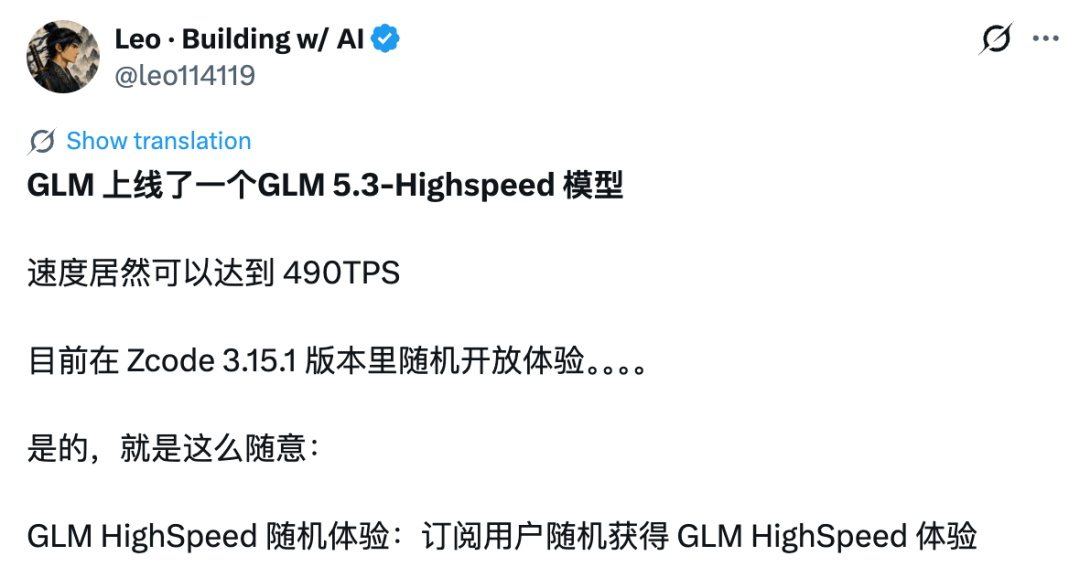
最初の手がかりは、単なるソーシャルメディアのスクリーンショットではありません。
ZCodeのバージョン3.15.1に関する公式リリースノートには、次のように記されています。
サブスクライバーは、GLM HighSpeedトライアルにランダムに選ばれるようになりました。
この文言は重要です。アカウントごとにアクセス状況が異なる理由を説明しているからです。
元記事によると、執筆者はGLM-5.3 Highspeedを手動で追加して切り替えようとしましたが、Liteサブスクリプションでは利用できませんでした。
UI上ではモデルの存在が表示されていたものの、現在のプランにはアクセス権が含まれていませんでした。
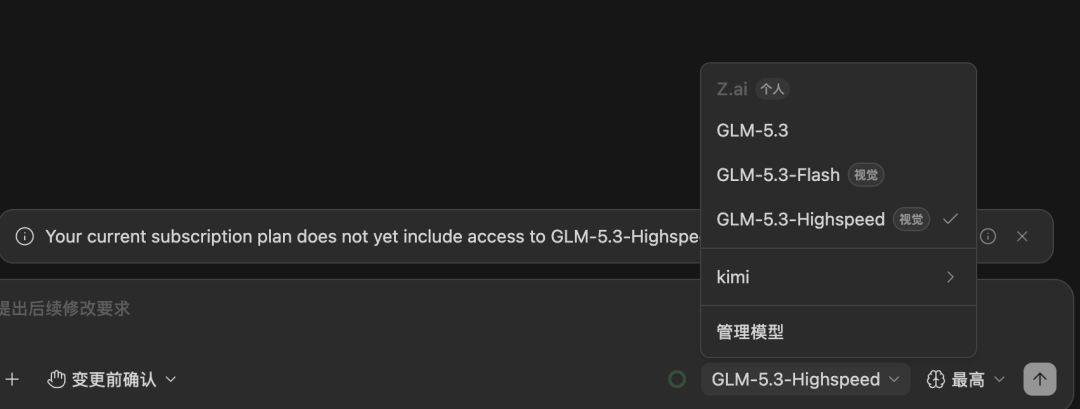
これは、ZCodeの現在のロールアウト戦略と整合しています。
ZCode 3.15.1へ更新
        ↓
サブスクライバーアカウント
        ↓
ランダムなHighSpeedトライアルの対象判定
        ↓
選ばれた場合、クライアント内にトライアルアクセスが表示される
現時点では、すべての有料プランで自動的に利用できる機能とは説明されていません。
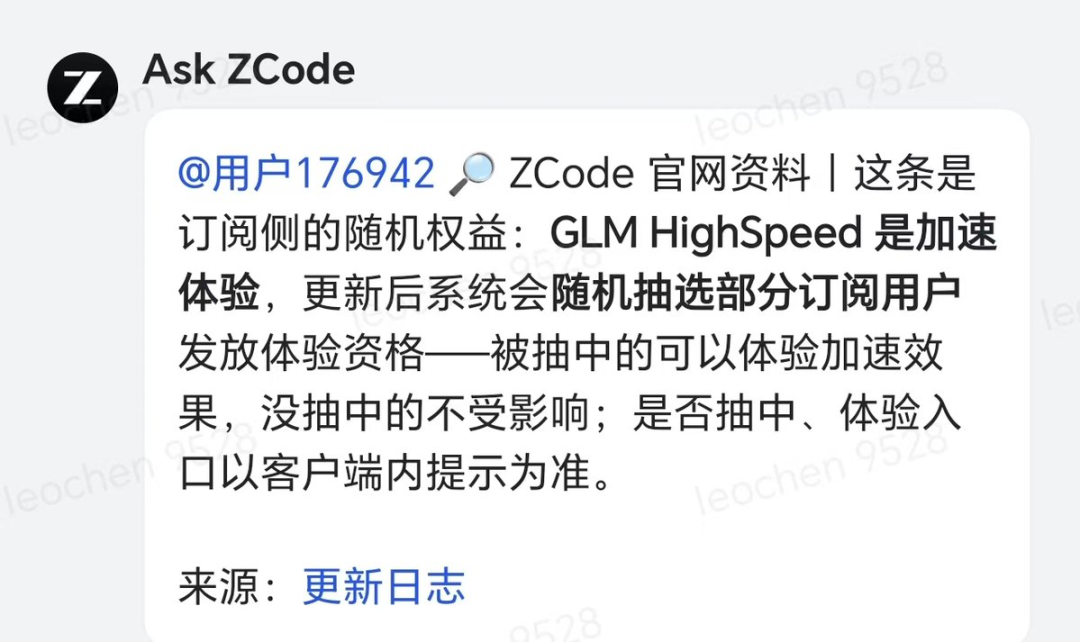
ZCode自身の文言を要約したコミュニティのスクリーンショットも同じ点を示しています。HighSpeed体験はランダムに割り当てられるサブスクライバー特典であり、特定のアカウントが選ばれたかどうかはクライアントが判断の基準になります。
このモデルが注目を集めた最大の理由は、速度を示すスクリーンショットです。
元の投稿者は、約493 tok/sを示す実行結果を投稿しました。
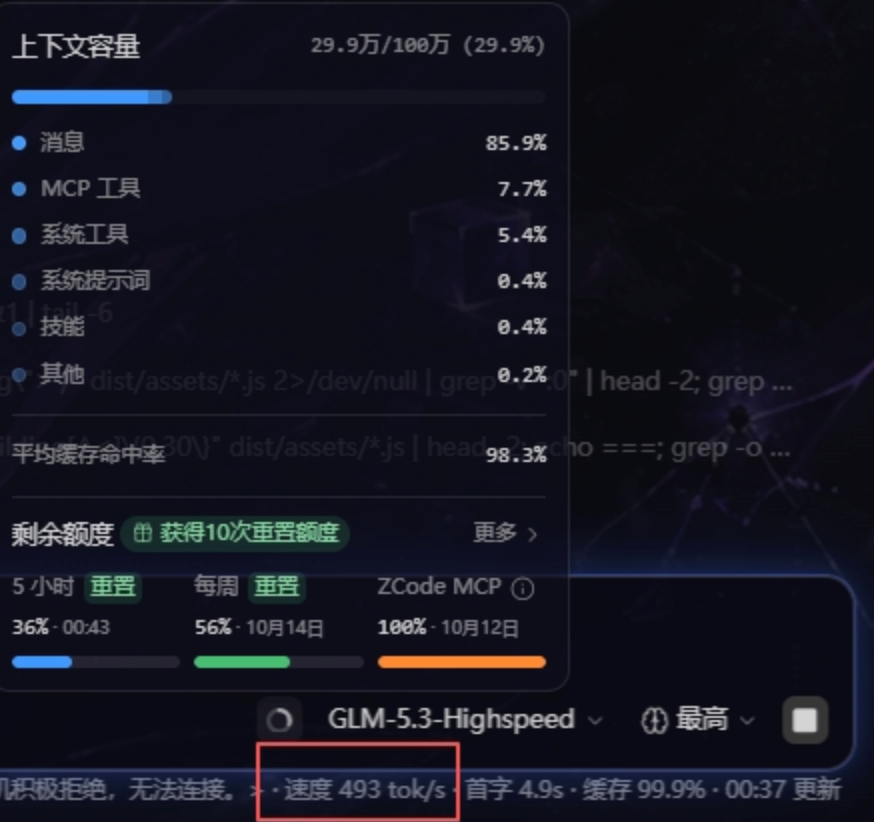
これは記事見出しの490 TPSに十分近く、その差に実質的な意味はありません。
ただし、このスクリーンショットが示すことと、示していないことを正確に理解することは有用です。
GLM-5.3-Highspeedと表示されたZCodeセッション。スループットは次の要素に大きく依存する可能性があります。
したがって、現時点での適切な結論は次のとおりです。
GLM-5.3 Highspeedは、少なくとも1件の公開ZCodeテストで非常に高い出力スループットを示しましたが、Z.aiは正式な490 TPS仕様をまだ公開していません。
GLMファミリーには、すでに複数の速度重視の配信オプションがあるため、この数値は際立っています。
Z.aiのドキュメントによれば、GLM-5.3-FlashXは最大毎秒200トークンに達します。FlashXは、GLM-5.3-Flashの高速配信バリアントです。
PiおよびZ.aiのドキュメントでは、GLM-5.3-Flashは100万トークンのコンテキストウィンドウと128Kクラスの最大出力を備える一方、FlashXはより低い配信レイテンシと高速な生成に注力しているとされています。
元記事は、執筆時点でZ.aiのファーストパーティAPI上のGLM-5.3-Flashについて、Artificial Analysisが約毎秒60トークンと測定したことにも言及しています。
独立系のスループット測定値は時間とともに変化し、後のスナップショットではプロバイダーや日付により大きな幅がありました。そのため、単一の数値を恒久的なものとして扱うべきではありません。
したがって、比較としては次が有用です。
| モデル/配信パス | 報告または文書化された速度 | ステータス |
|---|---|---|
| ZCode内のGLM-5.3 Highspeed | ユーザースクリーンショットで約490~493 tok/s | コミュニティ観測/ランダムトライアル |
| GLM-5.3-FlashX | 最大200 tok/s | 公開文書で説明された速度重視バリアント |
| Z.ai API上のGLM-5.3-Flash | 独立したファーストパーティのスナップショットでは大幅に低い | 独立測定は日付・プロバイダーにより変動 |
この差は大きく、「Highspeed」が実際に何を意味するのかを知りたいと考えるのは自然なことです。
glm-5.3-highspeedが掲載されているこのモデル名はZCodeだけに登場したわけではありません。
Piの公開モデルカタログには、すでにGLM-5.3 Highspeedのページがあります。
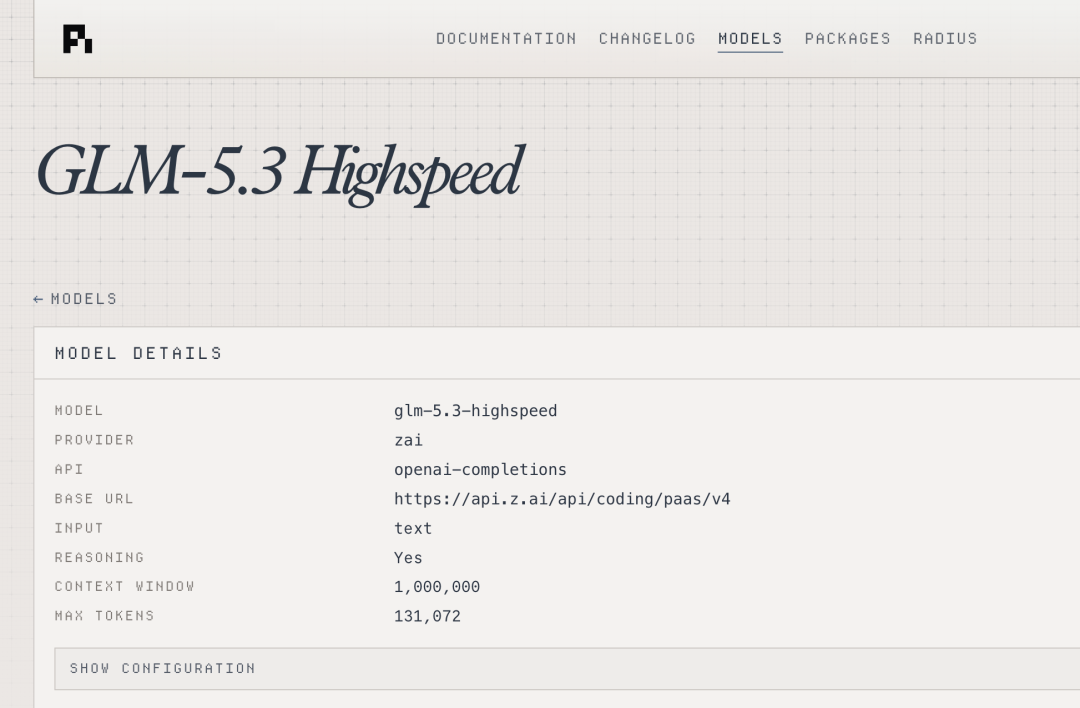
掲載されている構成は次のとおりです。
| 項目 | 値 |
|---|---|
| モデルID | glm-5.3-highspeed |
| プロバイダー | zai |
| API形式 | OpenAI互換のcompletions |
| 入力 | テキスト |
| 推論 | はい |
| コンテキストウィンドウ | 1,000,000トークン |
| 最大出力 | 131,072トークン |
| 推論レベル | low / high / max |
Piが表示するエンドポイントは次のとおりです。
https://api.z.ai/api/coding/paas/v4
PiはこのモデルをZ.aiのコーディングAPI形式にマッピングしています。
特に注目すべき点は2つあります。
これは、現行のGLM-5.3ファミリーのツール群に見られる長大なコンテキスト構成と一致します。
コーディングエージェントでは、100万トークンのコンテキストは次の用途に役立つ可能性があります。
これはおよそ128Kトークンです。
これも、複数のGLM-5.3ファミリーエントリーに見られる現在の長大出力構成と一致しています。
したがって、Piの掲載内容は、通常のGLM-5.3系統と明らかに異なるコンテキストアーキテクチャを示唆しているわけではありません。
主に、Highspeedという識別子が構造化されたプロバイダー設定を持つほど実在性があることを確認しています。
Piは、次の3つの有効な推論設定をマッピングしています。
low
high
max
元記事は、これらの設定が通常のGLM-5.3構成でも馴染みのあるものであると指摘しています。
このことも、Highspeedがまったく新しいベースモデルだと決めつけるべきではない理由になります。
考えられるのは次のような可能性です。
Z.aiのモデルカードがなければ、これらの可能性を確信をもって区別することはまだできません。
名称だけでは不十分です。
ここからは推測の領域に入ります。
ZCodeのスクリーンショットが登場する前から、RedditのユーザーはPiのカタログ内にあるglm-5.3-highspeedに気づき、Omen Alphaとの関連を尋ねていました。
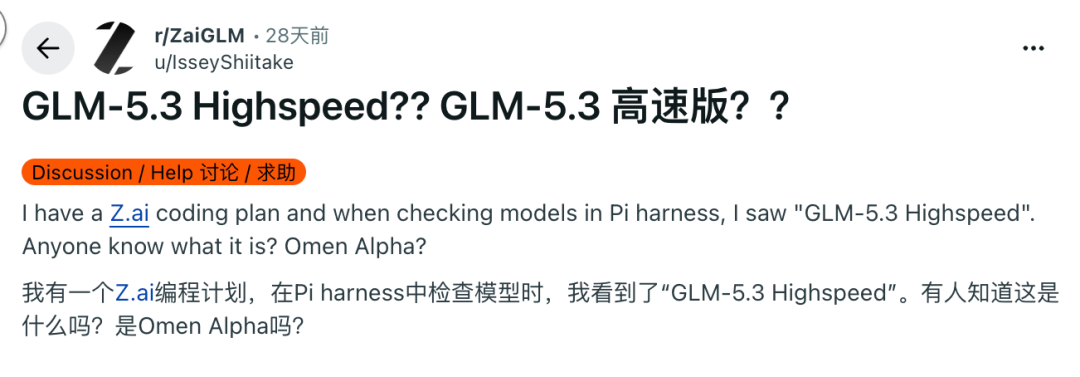
Omen Alphaは、OpenCodeのテストに登場した匿名モデルです。
コミュニティメンバーは、観測された挙動やインフラ上の手がかりに基づき、すでにこれをZhipu/Z.aiと関連付けていました。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
Redditのある返信では、GLM-5.3-Flashに近い品質を保ちながら、はるかに高いスループットを持つ新しい高速GLMバリアントかもしれないと推測されています。
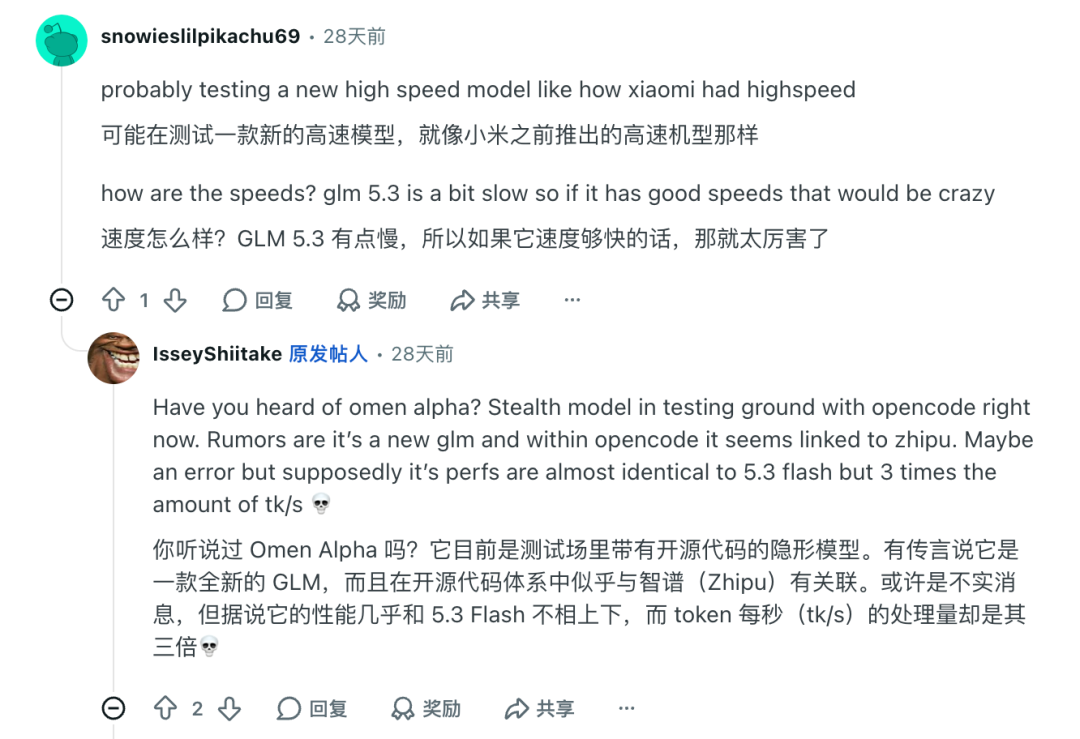
別のソーススクリーンショットには、Zhipu関連のプロバイダーラベルに接続されたomen-alphaモデルエントリーが表示されており、この説をさらに後押ししました。
ただし、これらはいずれも同一性を決定的に証明するものではありません。
元記事は複数の推測を挙げています。
これらの名称は、Z.aiが公式の対応関係を公開するまで、コミュニティの推測として扱うべきです。
2つのエンドポイントは、同じモデルでなくても非常によく似た挙動を示すことがあります。
観測される挙動は、次の要因から影響を受ける可能性があります。
したがって、挙動の類似性は根拠にはなりますが、証明にはなりません。
Zhipuにとって、この名称自体は珍しいものではありません。
同社はこれまでにもGLMモデルの高速版を提供してきました。
元記事はGLM-5.1-highspeedに言及しており、このモデルは2026年5月に毎秒約400トークンの出力速度で紹介されました。
より新しいGLM-5.3ファミリーにも、最大200 tok/sと公開文書で説明された速度重視バリアントのFlashXがあります。
これは、より広い製品パターンを示唆しています。
ベースモデルまたはフラッグシップモデル
        ↓
高速配信パス
        ↓
対話型ワークロード向けの低レイテンシ/高スループット
このパターンに照らせば、新しいモデル重みを前提としなくてもGLM-5.3 Highspeedという製品は技術的に十分あり得ます。
ただし、これは公式な製品説明ではなく推論です。
そもそも、なぜ490 TPSを気にするのでしょうか。
200トークンの短い回答では、100 TPSと500 TPSの差は数秒に過ぎません。
長いエージェント出力、コード生成、詳細な推論では、その差ははるかに大きくなります。
たとえば次のとおりです。
| 出力長 | 100 tok/s | 200 tok/s | 490 tok/s |
|---|---|---|---|
| 1,000トークン | 10.0秒 | 5.0秒 | 約2.0秒 |
| 5,000トークン | 50.0秒 | 25.0秒 | 約10.2秒 |
| 10,000トークン | 100.0秒 | 50.0秒 | 約20.4秒 |
これらはデコード時間のみを単純化して計算したものです。
実際のエージェントタスクには、次の要素も含まれます。
それでも、高速なデコードは、長く反復的なワークフローの応答性を大きく向上させる可能性があります。
これは特にZCodeのようなコーディングエージェントで重要です。ユーザーからの1つの要求が、最終回答1回ではなく複数回のモデル呼び出しを生成することがあるためです。
約493 tok/sのスクリーンショットには、非常に高いキャッシュヒット率も表示されています。
これは注目に値します。
高いキャッシュヒット率は、長いエージェントセッションで必要になる繰り返しのプロンプト処理を減らす可能性があります。
一般的なコーディングセッションでは、次のようなコンテキストが繰り返し引き継がれます。
システム指示
+ リポジトリコンテキスト
+ ツール定義
+ 以前の会話
+ 直近の差分
そのコンテキストの大部分が効率的に再利用される場合、システムは各ターンの入力側を再計算する時間を短縮できます。
ただし、表示されるtok/sの数値は、通常、プロンプトキャッシュのスループットだけではなく、出力生成スループットを指します。
キャッシュの数値は依然として重要です。プロンプト再利用と高速デコードの両方が適切に機能すると、セッション全体のレイテンシは非常に良く見える可能性があるためです。
これも、1枚のスクリーンショットだけではモデルを十分に特徴付けられない理由の一つです。
GLM-5.3-FlashXは、Z.aiのドキュメントがすでに速度重視モデルとして説明しているため、最も明確な公開比較対象です。
FlashXについて現在公開されている情報には、次が含まれます。
glm-5.3-flashx。したがってFlashXは、Z.aiが完全に新しい知能世代として提示せずとも、専用の高スループットバリアントを作る意思があることを示しています。
GLM-5.3 Highspeedも、さらに高速な配信ティアとして同様の製品ロジックに従う可能性があります。
これは依然として推論であり、公式な製品説明ではありません。
現在の根拠は、3つの確度レベルに分けられます。
glm-5.3-highspeedが掲載されています。この区別が、現在のロールアウトを読む上で最も安全な方法です。
GLM-5.3 Highspeedは、ZCodeとPiの公開モデルカタログに登場したZ.aiのモデル識別子です。ZCode 3.15.1は、サブスクライバー向けのランダムなGLM HighSpeedトライアルを公式に確認していますが、ここで確認したソースでは、Z.aiはGLM-5.3 Highspeedに関する完全な単独モデルカードをまだ公開していません。
公開されたユーザースクリーンショットには、1回のZCode実行で約493 tok/sが表示されており、これが490 TPSという見出しの根拠です。これは有用な観測ですが、公式の持続スループット保証ではなく、ワークロード、キャッシュ挙動、地域、サーバー条件によって変動する可能性があります。
Piは現在、glm-5.3-highspeedについて100万トークンのコンテキストウィンドウと131,072トークンの最大出力を掲載しています。これらの値は、ほかの現行GLM-5.3ファミリーモデルの長文コンテキスト構成と似ています。
いいえ。ZCodeの公式v3.15.1変更履歴には、サブスクライバーがGLM HighSpeedトライアルにランダムに選ばれると記載されています。アカウントが選ばれていない場合、モデル名が表示されていても実行できるとは限りません。
両者が同じ製品であるという公式確認はありません。FlashXは最大200 tok/sと文書化されたGLM-5.3-Flashの公開高速バリアントである一方、GLM-5.3 Highspeedは現在、ZCodeのトライアルとPiのコーディングプロバイダーカタログを通じて登場しています。
それは依然として推測にとどまります。RedditやOpenCodeのユーザーはOmen AlphaをZhipu/Z.aiと結び付けていますが、Omen Alphaがglm-5.3-highspeedに対応することを確認する公式ソースはありません。
コーディングエージェントは、ファイルの読み取り、パッチの作成、ツールの実行、結果のレビューを行う間に、複数回の長いモデル呼び出しを実行することがよくあります。特にモデルが呼び出しごとに数千トークンを出力する場合、より高いデコードスループットは各ステップ間の待機時間を短縮できます。
トライアルを含むバージョンに更新した後、最新のZCodeクライアントを使用してください。ZCode自身のリリースノートでは、アクセスはサブスクライバーにランダムに割り当てられると説明されているため、対象かどうかを確認する実用的な情報源はアカウントとクライアントUIです。
glm-5.3-highspeedのプロバイダー構成を公開しているモデルおよびエージェントツールのカタログ。GLM-5.3 Highspeedは、もはや単なる散発的なモデル名ではありません。ZCode 3.15.1はサブスクライバー向けのランダムなGLM HighSpeedトライアルを公式に確認しており、Piはすでに100万トークンのコンテキストウィンドウと131,072トークンの出力上限を持つ、構造化されたglm-5.3-highspeed構成を公開しています。
注目を集める490~493 tok/sという数値は、実在する公開スクリーンショットに基づいています。しかし、これはZ.aiによる正式なスループット保証ではなく、ユーザー観測にとどまります。最も安全な解釈は、Z.aiが非常に高速なコーディング向け配信パスをテストしており、完全な製品仕様はまだ公開していないというものです。
Omen Alphaとの関係も未解決です。関連がある可能性はありますが、現在の根拠は公式情報ではなく、状況証拠とコミュニティ主導の推測に基づいています。
現在確認されているのはロールアウトとモデル識別子です。一方、正確なアーキテクチャ、公開価格、持続スループット、Omen Alphaが同じモデルかどうかは、まだ確認されていません。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



