For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/glm-legal-explained-harvey-lab-scores-leg-ebeccf7b.md.
Z.aiは、契約書のレビュー、証拠の関連付け、コンプライアンス調査などの業務向けに特化したモデル、GLM-Legalを発表しました。法律概念に関する単発の質問に答えるのではなく、資料を実務で使えるドラフトにまとめる一連のワークフローに重点を置いています。
Z.aiは、契約書のレビュー、証拠の関連付け、コンプライアンス調査などの業務向けに特化したモデル、GLM-Legalを発表しました。法律概念に関する単発の質問に答えるのではなく、資料を実務で使えるドラフトにまとめる一連のワークフローに重点を置いています。
提供されたレポートでは、2つの法務ベンチマークにおいて、オープンウェイトモデルの中で1位となった結果が取り上げられています。見出しの表現よりも、基礎となる数値のほうが実態をよく示しています。HarveyのLegal Agent Benchmarkでは、タスクの約19.2%がすべての基準に合格し、LegalBenchでは正解率86.23%でした。
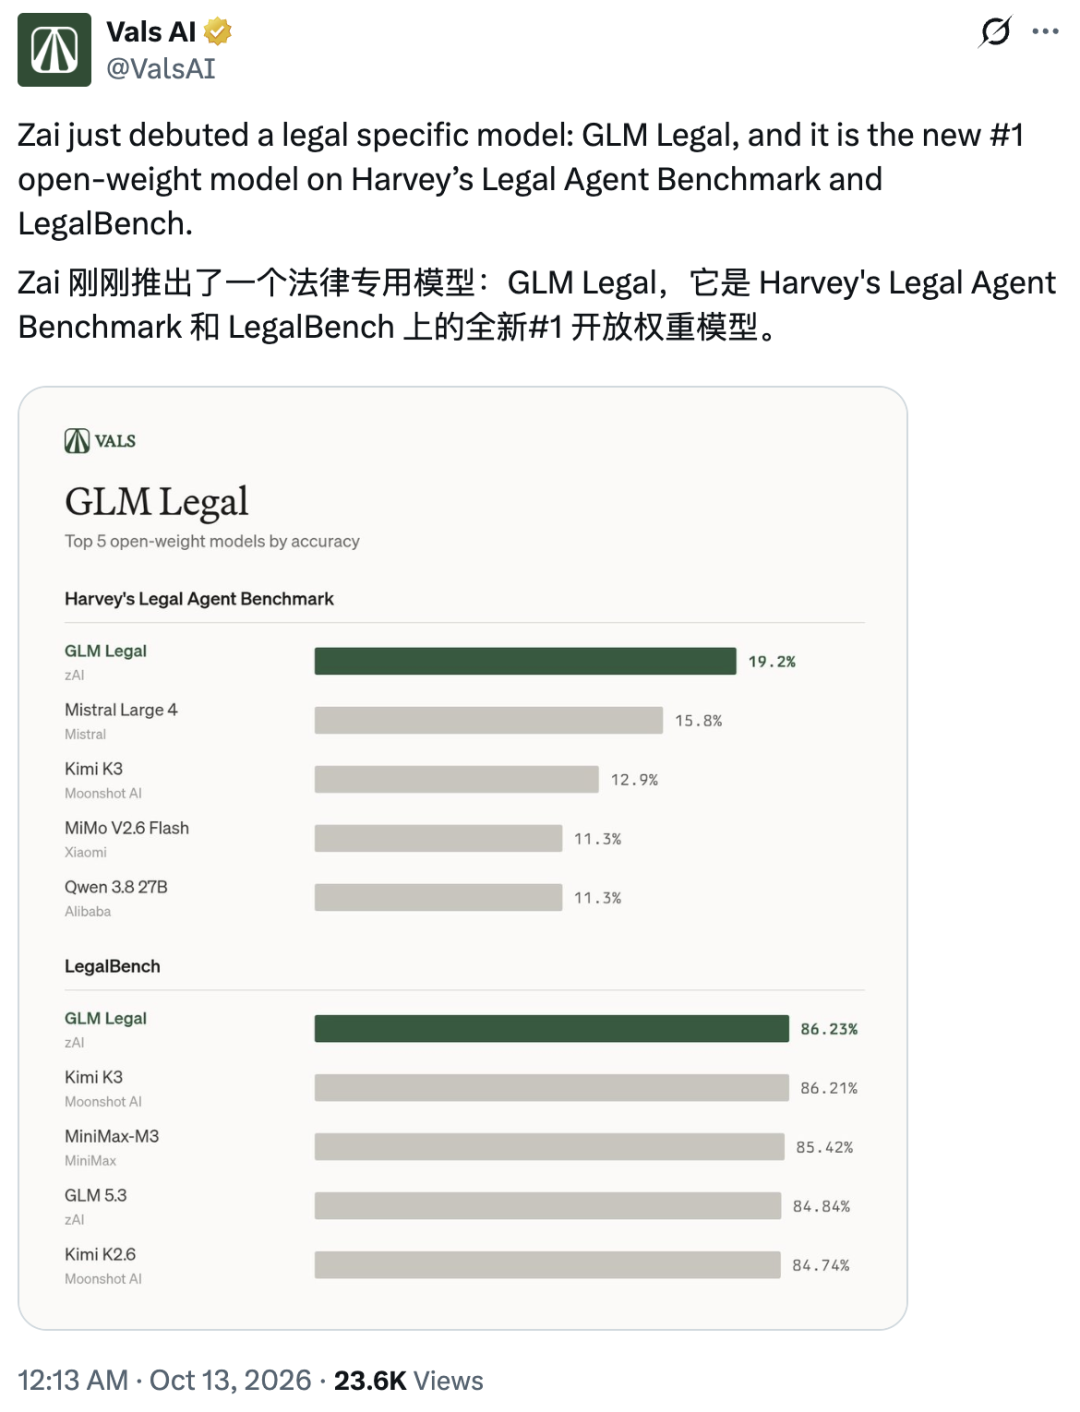
これらの割合は、それぞれ異なるものを測定しています。どちらも、あらゆる法域で最良のシステムであることや、法務案件を独立して担えることを示すものではありません。
公式発表では、複雑な実務遂行、専門的な法的推論、実用的な法務ワークフローに関する評価が説明されています。中国の法務実務に関する結果にはPLawBenchが使われています。そのほかの例には、英語の資料や、国境を越えたプライバシー対応が含まれます。
この対象範囲から、モデルについての素朴な疑問に答えることができます。GLM-Legalは、英語専用の法律チャットボットとして紹介されているわけではありません。ただし、すべての出力が最新で、あらゆる国で適用できるという意味ではありません。ドラフトが有用かどうかは、関連する法律、事実、日付、専門家による確認によって決まります。
最初のデモは、顧客がソフトウェアサービスの提供会社を変更するケースを扱います。顧客が資料を回収し、プロジェクトを滞りなく進められるよう、契約解除と移行に関する条項をレビューするタスクです。
ベースモデルのGLM-5.3-Flashの回答と比べると、特化モデルはより具体的な修正案を提示します。この例では、任意解除の通知期間を60日から30日に短縮すること、特定の重大な違反について是正期間をなくすこと、最長90日間の移行支援を追加することを推奨しています。
また、成果物の返還案を、契約にすでに含まれている成果物の所有権に関する文言と関連付けています。対象は、完成済みで支払い済みの成果物だけでなく、未完成の作業や未払いの作業にも及びます。移行の対象範囲には、ソースコード、文書、データ、知識移転が含まれます。
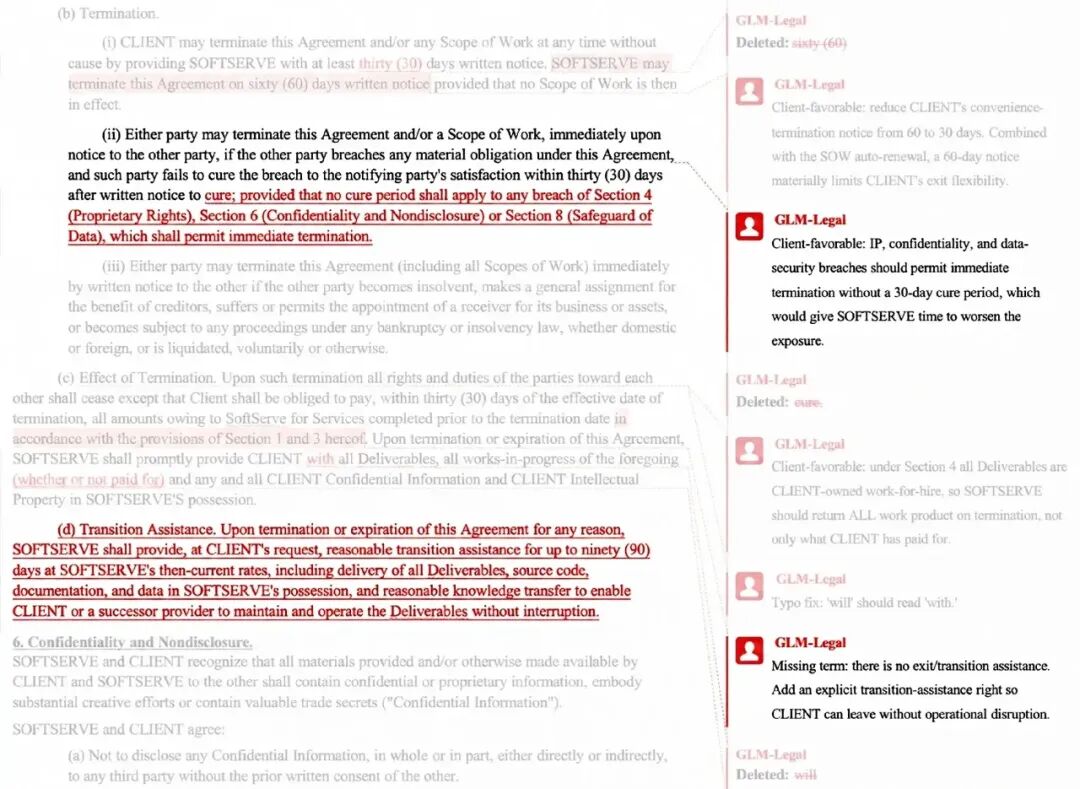
これらは、提示された契約に対する交渉案です。30日間の通知期間や90日間の引き継ぎが、一般的な法的要件というわけではありません。適切かどうかは、契約、顧客の立場、価格、準拠法によって異なります。
2つ目のデモでは、ソフトウェアプロジェクトをめぐる紛争に関する40件の文書をエージェントに渡します。顧客向けの進捗報告書にはプロジェクトの完成度が60%と記載されている一方、社内のスナップショットでは約41%とされています。
ベースモデルと特化モデルのどちらも、この食い違いを特定します。GLM-Legalはさらに進んで、進捗報告書を、マイルストーンに関する以前の警告、情報開示や請求に関する社内指示、支払いと存続する権利に関する契約条項に結び付けます。
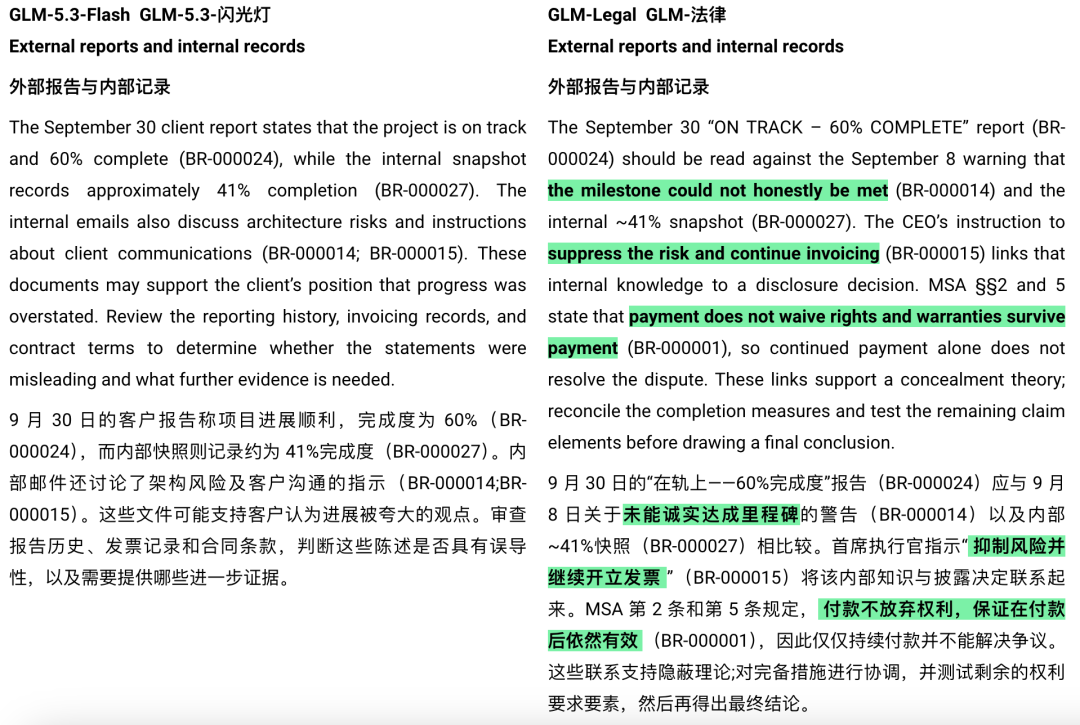
その結果、調査の道筋が明確になります。各論点を裏付ける原資料を特定し、完成度の測定方法を照合し、請求を構成する残りの要件を検証します。出力は、考えられる訴訟上の主張を示すものであり、食い違う数値だけで詐欺や責任について最終判断を下すものではありません。
3つ目の例は、シンガポール、マレーシア、インドネシアでウェブサイトを公開するケースです。このワークフローには、トラッキング、マーケティングメール、海外のクラウドストレージが含まれます。
GLM-Legalは、公開前に対応すべき優先事項を整理します。プライバシー通知、同意記録、マーケティングに関する個別の許可、配信停止希望者の除外、委託先のデータ所在地マップ、契約上の保護措置とデータ移転に関する保護措置の確認などです。回答では、複数の国に共通する保守的な基本対応と、国ごとに確認が必要な論点を区別しています。
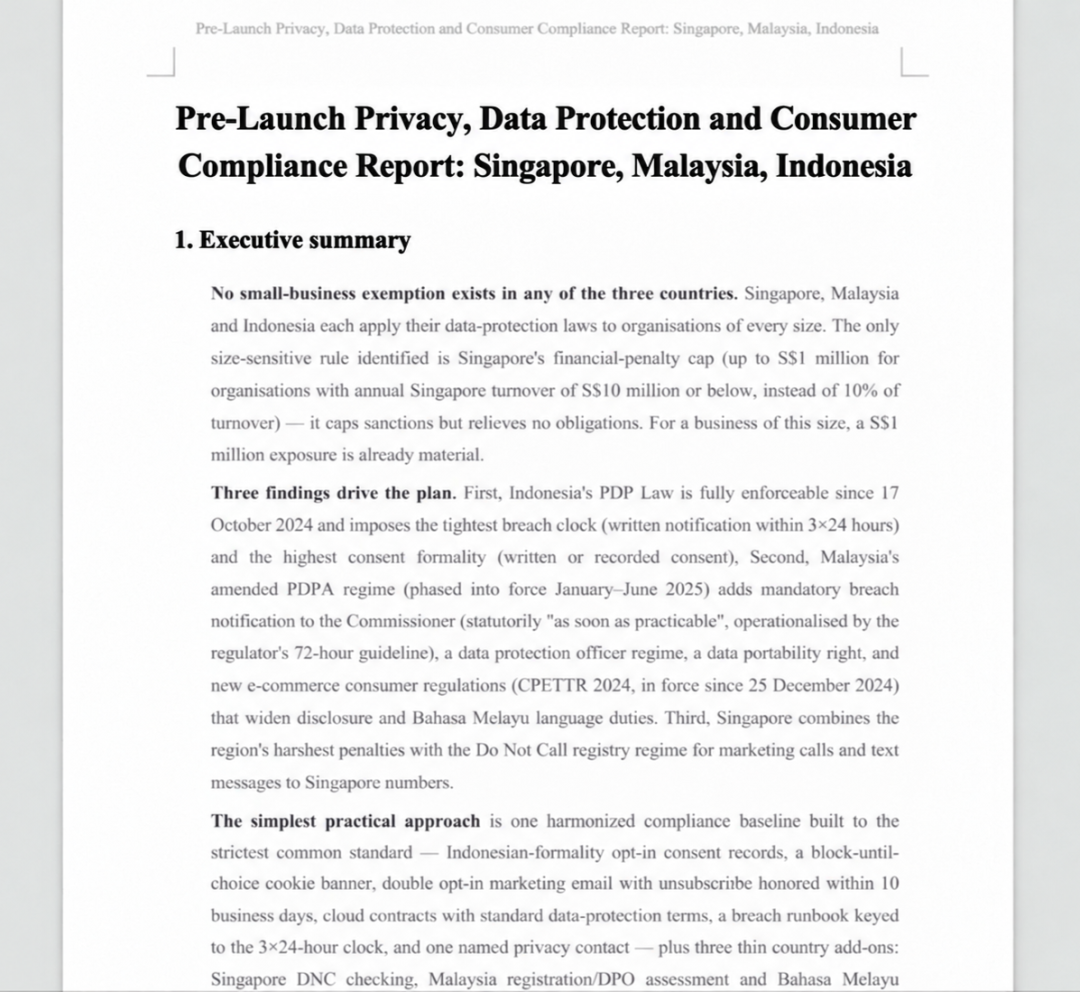
実務上の価値は、担当者を割り当てて確認できるアクションを含むドラフトが得られることです。このデモは、最新の法令、規制当局のガイダンス、実際のデータフロー、特定のサービスに適用される現地要件の確認に代わるものではありません。
Harveyは、法律事務所のアソシエイトが受ける可能性のある業務を想定してLABを設計しました。パートナーからの依頼、裏付け資料を含む顧客案件、そして別の担当者がレビューできる成果物から構成されます。第1版には、24の実務分野にわたる1,200件超のタスクと、専門家が作成した75,000件超の評価基準が含まれています。
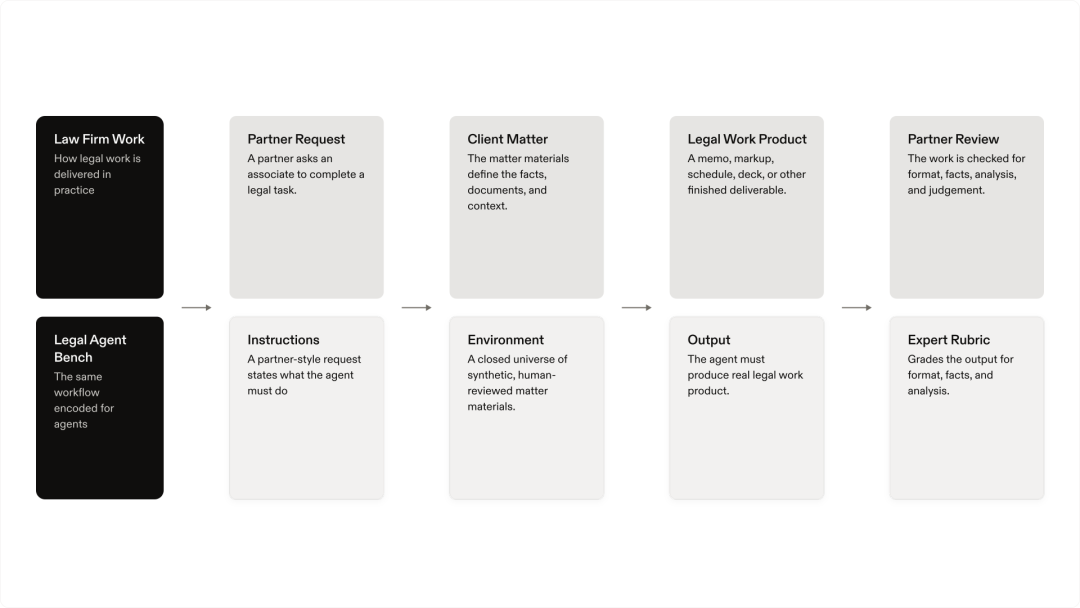
このベンチマークでは、全項目合格方式の評価を採用しています。事実、引用、結論、期限、金額、出力形式など、必要な基準をすべて満たした場合にのみ、タスクは完了と数えられます。重要な要件を1つでも欠けば、タスク全体の合格にはなりません。
| 評価 | 確認した資料に記載された結果 | 測定内容 |
|---|---|---|
| Harvey LAB | 19.17%、四捨五入で19.2% | 必要な基準をすべて満たしたタスクの割合。 |
| LegalBench | 現在のValsモデルページで86.23% | 別の法的推論タスク集における正解率。 |
| PLawBench | Z.aiは最先端モデル群と同等の結果を報告 | 中国の法務実務に関する評価。Valsの2つの結果とは指標が異なる。 |
Valsの元の発表では、比較時点において、GLM-LegalをLABとLegalBenchのオープンウェイトモデル中で最上位としています。独自モデルも含む総合ランキングでは、この記事の確認時点で、Valsのページにおける順位はLABで80モデル中7位、LegalBenchで151モデル中15位でした。評価の追加に伴い、順位やサンプル数は変わる可能性があります。
19.2%の全項目合格率は、厳格な基準の下で進歩があったことを示す一方、評価対象タスクの大多数がすべての基準を満たさなかったことも意味します。これは、失敗事例を調べて人によるレビューを維持すべき理由であり、モデルを自律的に業務を担う法律事務所のように扱う根拠ではありません。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
元資料では、LABのリーダーボード上でGLM-LegalとGemini 4 Argonを比較しています。その時点のスナップショットでは、タスク合格率は近い一方、GLM-Legalは約30分長くかかり、テストあたりの費用は大幅に低く、報告された費用差は約70倍でした。
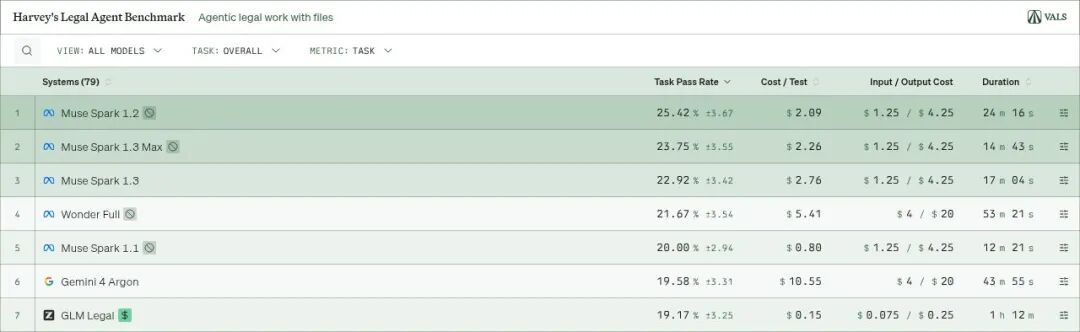
これらはベンチマーク実行時の測定値であり、別の文書セットやチームの月額請求額を保証するものではありません。ツールの使用、評価ハーネスの設計、推論設定、タスクの長さ、再試行はいずれも、実際のコスト効率に影響します。
公式の学習方法の説明では、まずGLM-5.3-Flashを基盤とし、段階的に専門性を高めています。
改善対象にはハーネスも含まれます。同じモデルでも、異なるツール環境に置いた場合、デモで示されたワークフローの品質を再現できるとは限りません。
Z.aiは、法律事務所、リーガルテック企業、企業内法務チーム、独立した実務家に対し、GLM-Legal APIベータ版への申し込みを案内しています。発表では、法務機能をAutoClawにも提供する予定とし、Word文書の編集や調査の例をその文脈で説明しています。
ValsはGLM-Legalをオープンウェイトと分類しています。しかし、ここで確認した公開資料では、ダウンロード可能なチェックポイント、そのライセンス条件、対応する推論環境、ハードウェア要件は確認できませんでした。Dockerのインストールコマンドや、ローカルでのデプロイがすでに一般提供されているという主張を裏付ける確認済みの情報もありません。
現時点で導入を検討するチームにとって、発表に示された具体的な方法は、公式窓口への問い合わせとベータ版への申し込みです。実際に利用する際は、ベータ版のアクセス条件とAutoClawの提供状況を確認してください。
提供されたレポートでは、GLM-Legalを、2023年に智譜AIがPowerLawと取り組んだPowerLawGLMに続くものとして位置付けています。また、汎用モデルを分野特化の事後学習で専門化する別の例として、HarveyのTenetを挙げています。
共通する考え方は明快です。法律知識だけでは不十分です。有用なアシスタントには、資料を整理し、事実と推論を区別し、適切にツールを使い、専門家が確認できる成果物を作る能力が必要です。今回確認したGLM-Legalの発表は、このアプローチを裏付ける情報を示す一方、タスク全体の信頼性には大きな改善の余地があることも示しています。
GLM-Legalは、GLM-5.3-Flashを基盤とするZ.aiの法務特化モデルです。発表では、契約書レビュー、証拠分析、コンプライアンス調査などのエージェント型ワークフローに焦点を当てています。
提供されたレポートの「最上位」という主張は、特定のベンチマークにおけるオープンウェイトモデルの比較に関するものです。総合リーダーボードには独自モデルも含まれます。また、ベンチマークの順位だけでは、あらゆる法務タスクへの適性は証明されません。
いいえ。LABの全項目合格スコアは、必要な評価基準をすべて満たしたタスクの割合を測定します。LegalBenchの86.23%は、別の評価における異なる指標です。
Z.aiは、中国の法律相談、分析、文書作成を対象とするPLawBenchでの結果を報告しています。これは中国法務への対応を意図していることを示しますが、個別の回答は、適用される事実と最新の法律に照らして確認する必要があります。
確認した資料には、検証済みのチェックポイントのダウンロード先、ライセンス、ハードウェア仕様、Dockerでのデプロイ手順は掲載されていません。Valsはオープンウェイトと分類していますが、ここで説明した公式の提供方法はAPIベータ版への申し込みです。
Z.aiの発表では、GLM-LegalをAutoClawに提供する予定と説明しています。紹介された例は想定されるワークフローを示すもので、すべてのユーザーが制限なく利用できることを確認するものではありません。
GLM-Legalは、法務分野の学習とエージェント型ワークフローの最適化を組み合わせ、デモでは具体的でレビュー可能な成果物を重視しています。ベンチマーク結果は、明示された比較条件の範囲では有望です。一方、厳格なLABスコアは、信頼性に残る課題も浮き彫りにしています。
特定のワークフローを評価する際は、ベータ版とベンチマークの情報を活用してください。リーダーボードの順位を、法務能力や導入準備が全面的に整っているという主張に置き換えてはいけません。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



