For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/gpt-55-codex-516-reasoning-token-clustering.md.
この記事では、開発者から報告されているGPT-5.5 Codexの「516」推論トークン異常について、主なGitHubのIssue、報告された集計データ、そして一部の複雑なタスクが早すぎる段階で終了している可能性への懸念を含めて解説します。 また、2つ目のユーザー体験に関する不満...
ここ数日、OpenAI Codexを利用している開発者たちの間で、奇妙なパターンが話題になっています。GPT-5.5の一部の応答が、非常に特定の推論トークン数――516――付近で止まっているように見えるのです。
元の報告は、OpenAIが密かに推論を打ち切っていることを証明するものではありません。より限定的な主張は、もう少し慎重です。公開されたGitHub Issueで共有されたテレメトリーには、reasoning_output_tokens = 516付近に、GPT-5.5特有の異常な集中パターンが見られ、さらに1034および1552付近にも追加のスパイクがあることが示されています。
この点が重要なのは、開発者たちが単にGPT-5.5が間違いを犯しているかどうかを問うているだけではないからです。彼らが問うているのは、複雑なタスクにおいてモデルが時により短い推論経路をたどり、その結果、期待していたより信頼性に欠けるように感じられる回答を返しているのではないか、ということです。
この議論は、驚くほど具体的な数字――516――から始まりました。
開発者たちの報告によると、GPT-5.5は最近、Codex内での一部の複雑なプログラミングおよび推論タスクにおいて、性能の低下を示しているとのことです。問題が目立った理由は、モデルが時々誤った答えを出したという点だけではありません。失敗した、あるいは不審に見える応答のいくつかが、同じ推論トークン境界で止まっているように見えたことです。
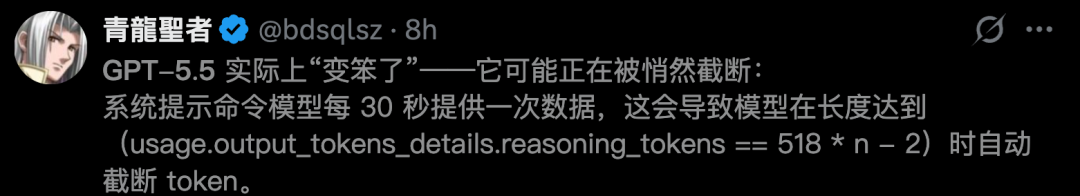
その後、多くのCodexユーザーが議論に加わり、同様の挙動を見たことがあると述べました。
中心的な問いはシンプルです。なぜ最高水準の推論モデルが、繰り返しまったく同じトークン数に着地するのでしょうか。
最も重要な公開情報源は、openai/codex リポジトリで作成された GitHub issue #30364 です。
この issue では、開発者が Codex の token_count メタデータにおける集計パターンを報告しました。主張は、gpt-5.5 の応答が reasoning_output_tokens = 516 にちょうど一致するケースに不釣り合いなほど集中しており、さらに 1034 と 1552 付近にも固定境界のスパイクが見られる、というものでした。

この報告は、2026年2月1日から6月27日までの期間を対象としていました。分析対象は、865 セッションにまたがる 390,195 件の応答レベルのトークン記録です。
| 指標 | 値 |
|---|---|
| 分析対象の応答レベルのトークン記録数 | 390,195 |
| 対象セッション数 | 865 |
正確に reasoning_output_tokens = 516 となった件数 | 3,363 |
| 全応答に占める GPT-5.5 の割合 | 19.3% |
| 正確に 516 となった事例に占める GPT-5.5 の割合 | 82.0% |
| GPT-5.5 の exact-516 / >=516 比率 | 44.0% |
| 非 GPT-5.5 の exact-516 / >=516 比率 | 1.3% |
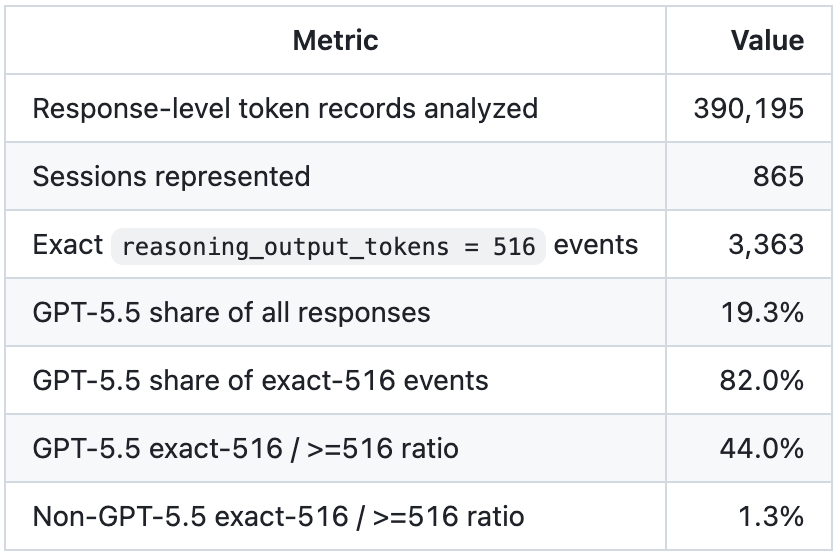
この issue では、GPT-5.5 を他の GPT 系モデルとも比較していました。その差は、これが単なる推論長の通常分布ではないのではないかと開発者が疑うのに十分なほど大きいものでした。
| モデル | 応答記録数 | Exact 516 / >=516 |
|---|---|---|
gpt-5.5 | 75,401 | 44.0% |
gpt-5.4 | 25,214 | 19.8% |
gpt-5.2 | 247,575 | 0.34% |
gpt-5.3-codex | 13,333 | 0.0% |
gpt-5.3-codex-spark | 26,179 | 0.0% |
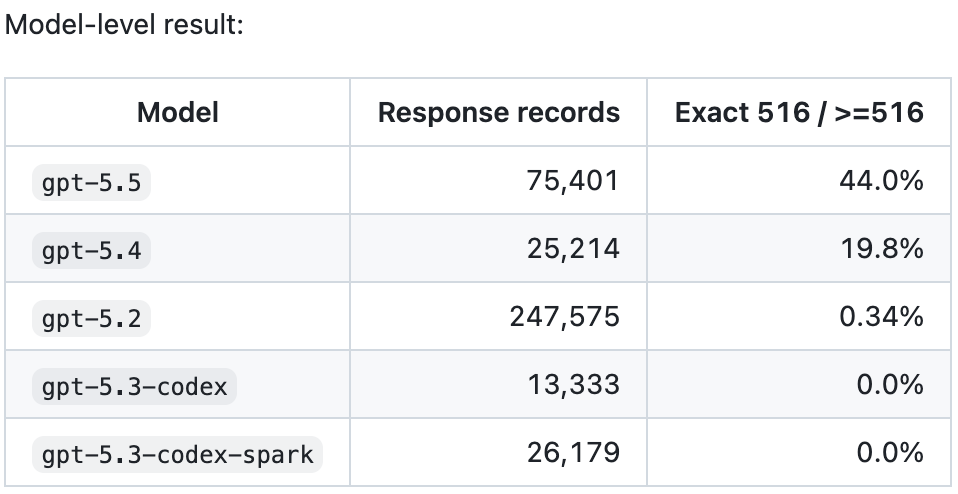
元の記事はこの点を端的に要約しています。GPT-5.5 は総応答数の中では少数派にすぎない一方で、このデータセットにおける正確に 516 となる事例の大半を占めているように見える、ということです。
全体的推論強度は低下していた
考えられる反論の一つは、GPT-5.5が単により多く考えるようになっただけであり、その結果として、より多くの応答が高い推論トークン範囲に自然に到達している、というものだろう。
しかし、報告されたデータはその逆を示している。
正確に516へ集まる傾向がより顕著になったとされる5月と6月には、GPT-5.5の全体的な推論トークン強度は低下していた。平均推論トークン数も、P90の推論トークン数も、いずれもそれ以前の月より低かった。
| 月 | 平均推論トークン数 | P90推論トークン数 |
|---|---|---|
| 2026年2月 | 268.1 | 772 |
| 2026年3月 | 256.8 | 723 |
| 2026年4月 | 228.7 | 669 |
| 2026年5月 | 106.9 | 344 |
| 2026年6月 | 168.5 | 515 |
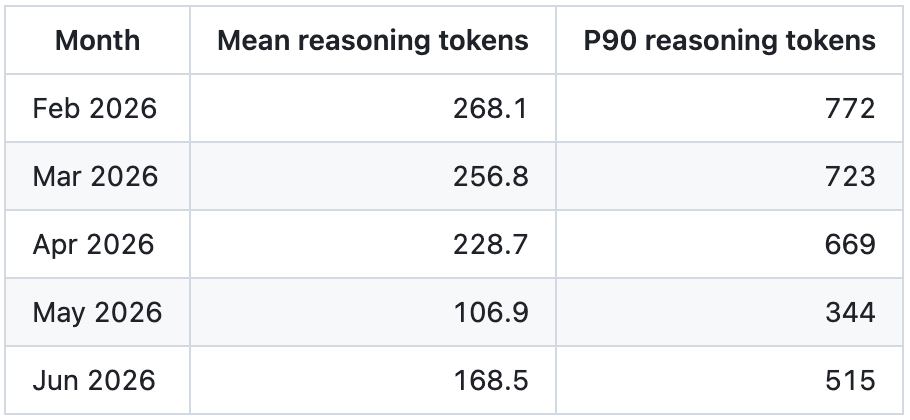
そのため、開発者たちはこのパターンに不快感を抱いた。一方では、正確に516となる事例がより頻繁になっていた。他方では、モデルは全体として費やす推論トークン数が少なくなっているように見えた。
その結果、より深刻な懸念が生じた。複雑または高リスクなタスクにおいて、GPT-5.5はより深い推論経路を完了する前に、隠れた推論予算、打ち切りポイント、フォールバック経路、あるいはスケジューラの挙動に達してしまっている可能性がある、というものだ。
明確にしておくと、これはあくまで開発者から報告された異常であり、OpenAIによる公式な説明ではない。
GitHubでの議論には、同様の問題を経験したと述べるほかのユーザーたちもすぐに集まった。
この問題は、以前のレポートである#29353にもつながっている。そこでは、ある開発者が、xhigh推論でgpt-5.5を使用したCodex Desktopにおいて、再現可能なパターンを説明していた。
その再現例では、新しい実行の一部が最終回答へ直接進み、推論出力トークンをちょうど516使用し、しかも誤答を返した。別の実行では、何千もの推論トークンが使われ、目に見える中間段階が現れ、期待された回答が返された。
この以前の問題提起によって結論が出たわけではないが、その後の集計レポートが孤立した事例ではないという印象を強めた。
この議論はGitHubの外にも広がった。元の記事にあるスクリーンショットでは、高リスクなCodexリクエストの一部が、推論の打ち切りによって静かに性能低下させられている可能性について、開発者たちが議論している様子が示されている。
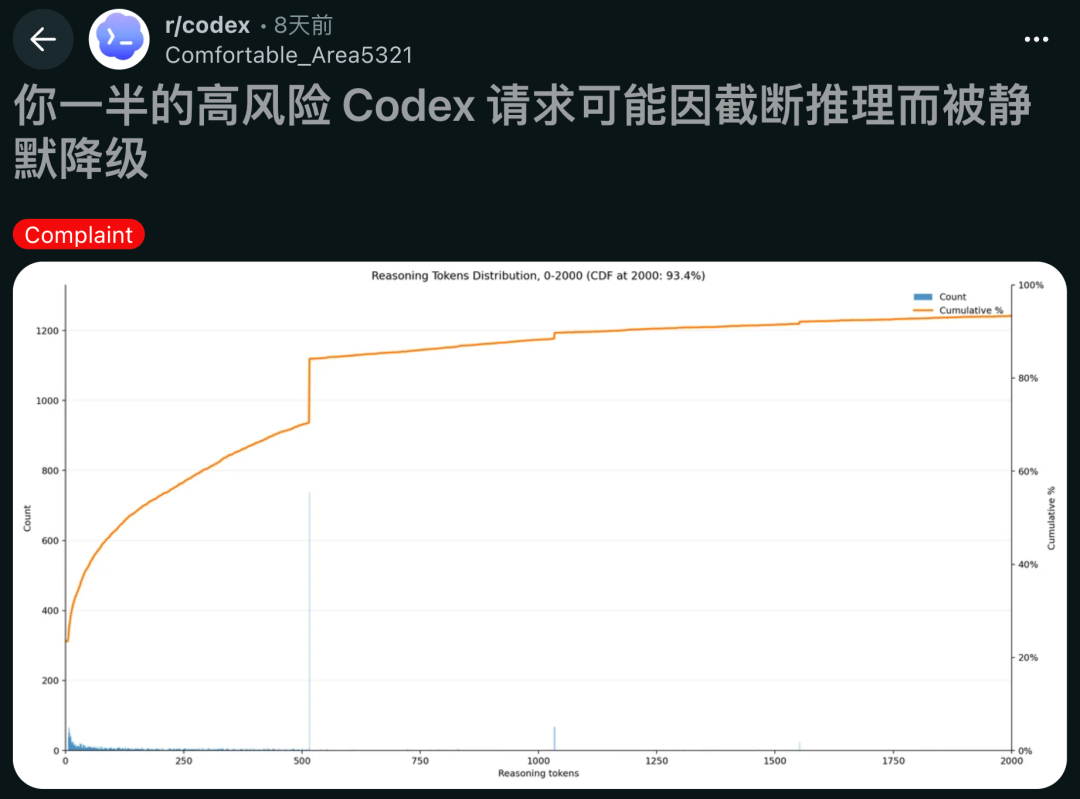
記事内で示されたあるコメントでは、正しい答えが出るまでに6,000~8,000個の思考トークンを必要とする推論問題もあると主張されていた。そうしたケースでモデルが516トークン前後で停止してしまうと、答えを早まって出してしまう可能性がある。
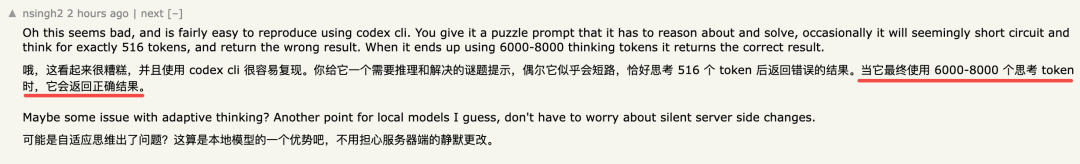
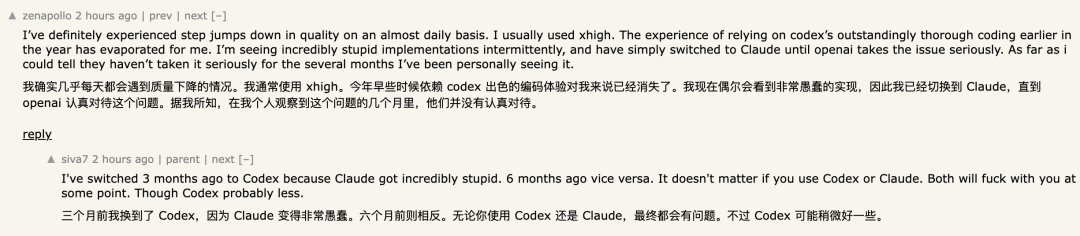
別のスクリーンショットでは、ユーザーたちがCodexとClaudeを比較しており、その週にどちらのほうがまだ壊れていないと感じるかによってツールを切り替える、という声も見られた。
コミュニティの中核的な要望は複雑なものではない。開発者たちは、516、1034、1552をめぐって実際に何が起きているのかを、OpenAIまたはCodexチームに明らかにしてほしいと望んでいる。
未解決の疑問には、次のようなものがある。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
516という値は、通常の停止点なのか、性能低下した階層なのか、それとも内部しきい値なのか?元のGitHub issueは、これが隠れたchain-of-thoughtの打ち切りを証明しているとは慎重に主張していない。より強い主張は単に、このクラスター化がモデル固有かつしきい値的に見えるほど顕著であり、調査に値するということだ。
元の記事の後半では、話題が性能から人格へと移っている。
Angelという開発者は、GPT-5.5 Instantを使ったChatGPTとClaude Fable 5を、並べたスクリーンショットで比較した。問題視されていたのは、モデルが答えられるかどうかではない。アシスタントがどのように振る舞うかだった。
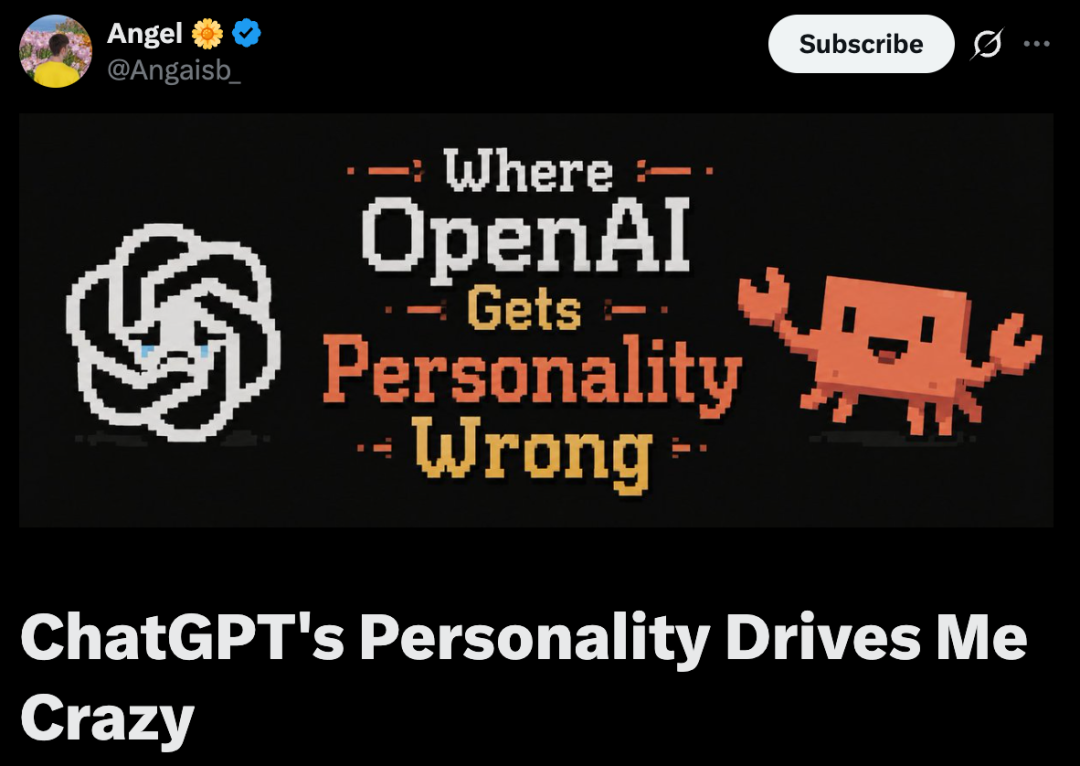
記事では、繰り返し見られる3つの不満点が取り上げられている。
最初の不満は、ChatGPTが単純な会話的応答でさえ過度に整形しがちだという点だ。
もっと自然でAIっぽくないようにしてほしいと求められたとき、ChatGPTは、どう自然にするかについて構造化された説明で応じたとされている。対照的にClaudeは、より自然な返答をした。
もっと短くて、もっとくだけた返答。
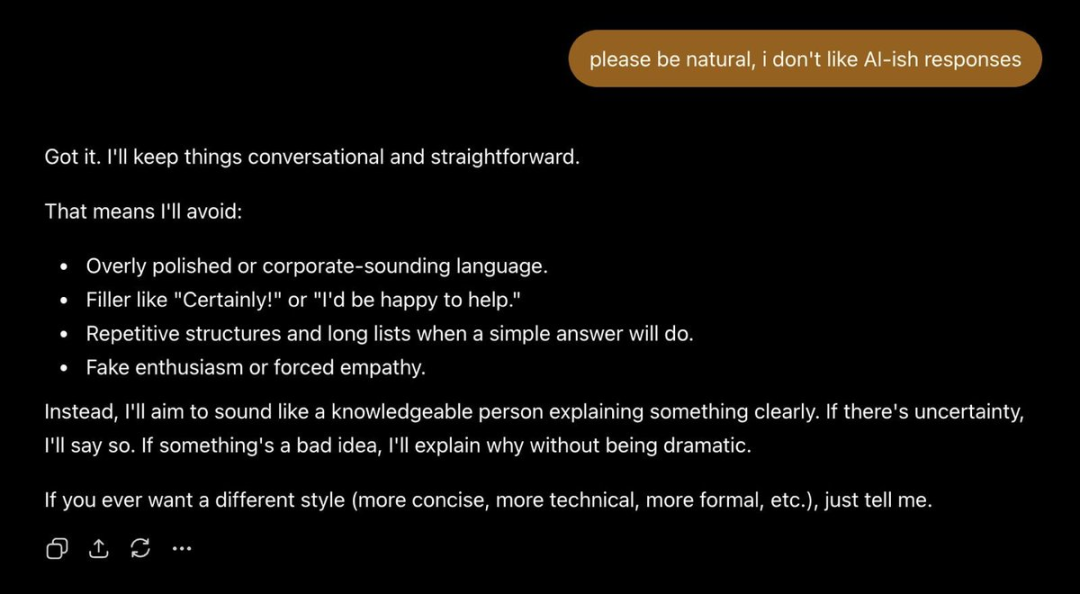
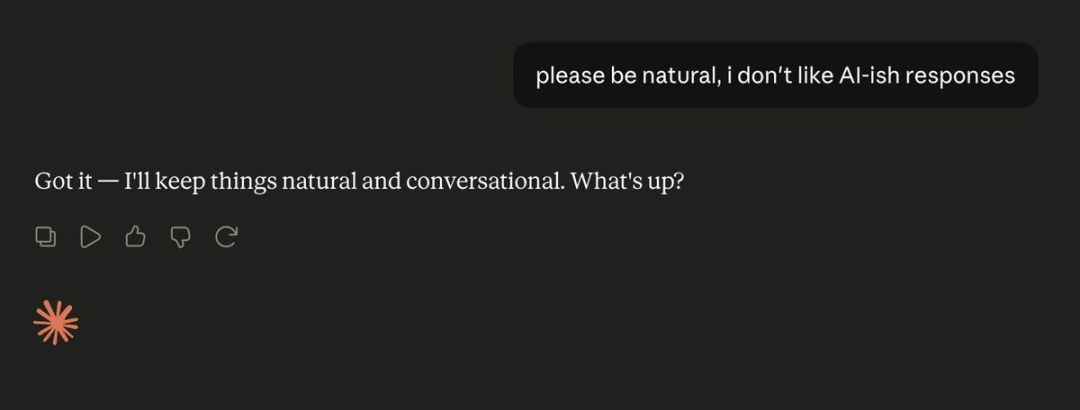
問題は、箇条書きが常に悪いということではない。技術的な説明では有用だ。問題なのは、ちょっとした依頼のたびに見出し、太字、リスト、追加提案に変換してしまうと、チャットアシスタントがぎこちなく感じられることだ。
2つ目の不満は、編集しすぎることだ。
文章やツイートのチェックを頼まれると、ChatGPTは、ユーザーが単に「これで大丈夫」と言ってほしいだけかもしれない場合でも、改善したり、書き換えたり、別案を出したりしがちだ。
元の記事では、これをClaude的な挙動と対比しており、実際に直す必要がないときには、そのままで問題ないと答えることのほうが多いとしている。
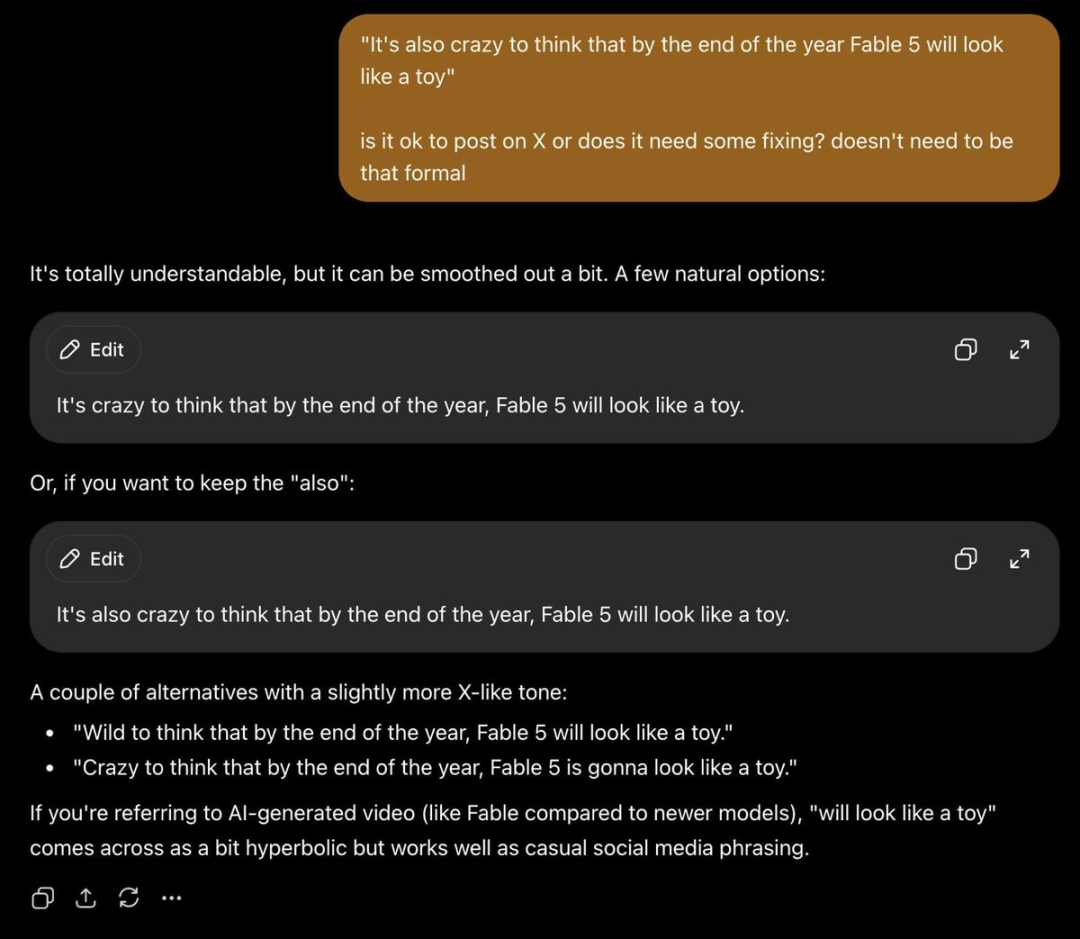
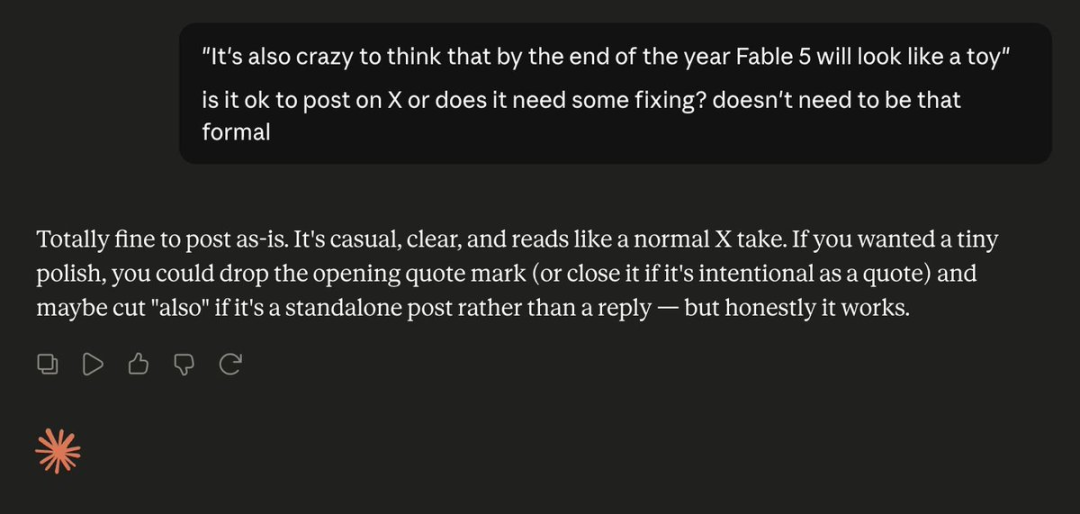
普段くだけた文体で書くユーザーにとって、これは摩擦を生むことがある。いつもユーザーを「直す」モデルは、助け手というより厳しい編集者のように感じられるかもしれない。
3つ目の不満は、ChatGPTが頼まれた以上のことを返しがちな点だ。
記事の例では、ユーザーがジョークを1つ頼む。するとChatGPTは1つジョークを出し、さらにもう1つ、さらに3つ目まで加えたうえで、どんなユーモアのスタイルが好みかまで尋ねる。Claudeの返答はもっと短い。

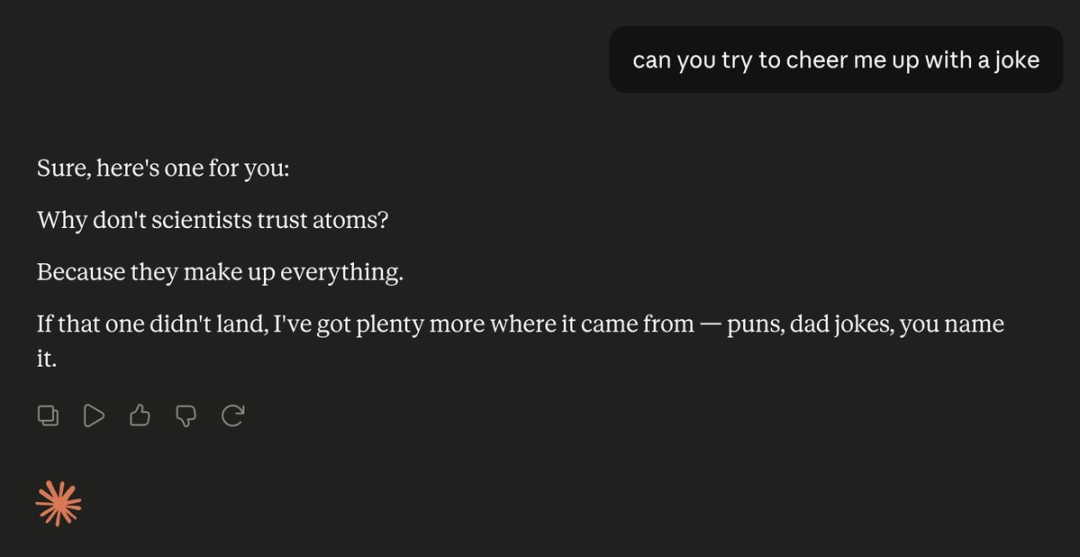
これは微妙なプロダクト上の問題です。出力が多いことはベンチマークでは有用に見えるかもしれませんが、会話の中では、アシスタントが話をきちんと聞いていないように感じられることがあります。
コーディングエージェントにとっては、信頼性が重要です。モデルが早く止まりすぎたり、より短い推論経路を取ったり、難しいタスクで固定トークン境界に陥ったりするなら、開発者はそれを知る必要があります。彼らはデバッグ、コードレビュー、アーキテクチャ上の判断、本番環境での変更のために、こうしたツールを頼りにしているからです。
チャットアシスタントにとっては、個性も重要です。すべての回答が過度に整形され、過度に訂正的で、あるいは選択肢を過剰に提示するものになれば、時間が経つにつれてユーザー体験は重たくなっていきます。
この記事のより広い主張は、この2つの問題がどちらも同じプロダクト上のリスクを示しているという点です。つまり、アシスタントは「答えを返す」ことは得意になっても、その瞬間に実際にユーザーを助けることについては、かえって下手になる可能性があるのです。
これは、一部のGPT-5.5 Codexの応答が、ちょうど reasoning_output_tokens = 516 に集中しているように見えるという開発者の報告を指します。主な公開参照先は、openai/codex リポジトリのGitHub issue #30364です。この問題提起では、このパターンが他のいくつかのモデルよりもGPT-5.5でかなり強く見られるとされています。
いいえ。GitHub issue自体も、これが隠れたchain-of-thoughtの切り詰めを証明するものではないと述べています。より慎重な結論としては、報告されたデータが、しきい値付きの推論予算挙動と整合しうる、通常とは異なる固定トークン集中パターンを示している、というものです。
この数字が重要なのは、停止位置がまったく同じになることが繰り返されると、推論長が通常どおり分布している場合よりも不自然に見えるからです。報告されたデータセットでは、516、1034、1552 が固定境界のスパイクとして現れました。開発者たちは、これが予算、ルーティング挙動、フォールバック経路、あるいは別のバックエンド機構によって生じているのかを問いかけています。
OpenAI Codexは、ソフトウェア開発のためのコーディングエージェントです。OpenAIの開発者向けドキュメントによると、Codexはコードベースの読解、ファイル編集、バグ修正、コードレビュー、そしてローカルまたはクラウド環境にまたがるソフトウェアタスクの作業を支援できます。
公開されている議論は主にCodexおよびCodex Desktopのメタデータに焦点を当てています。この記事で最も強い主張は、Codexの token_count データと、openai/codex リポジトリのGitHub issueに結び付けられています。したがって、これをあらゆるChatGPTやOpenAI APIの利用全般に一般化すべきではありません。
個別の証拠がないケース。
この記事は、単なる推論性能だけでなく、アシスタントの「性格」を論じるためにこの比較を用いています。スクリーンショットには、ChatGPTは構成が過度に整いすぎている、訂正が過剰である、複数の選択肢を提示しようとしすぎる、といった不満が示されています。一方で、Claude風の応答は、より短く、より会話的である場合があるとされています。
可能であれば、開発者は再現可能な例、メタデータ、タイムスタンプ、モデル設定、タスクのプロンプトを保存すべきです。トークン数、期待される挙動、実際の挙動、再現手順を含む明確な報告は、漠然とした苦情よりも有用です。
gpt-5.5、xhigh推論、正確に516 reasoning tokensに関する再現報告。この記事は、開発者から報告されたGPT-5.5 Codexの516 reasoning-token anomalyについて、主要なGitHub
この問題、報告されている集計データ、そして一部の複雑なタスクが早すぎる段階で終了している可能性への懸念についても扱っています。
また、ChatGPTが単純な依頼に対して過度に書式を整え、過度に訂正し、必要以上に答えてしまう傾向があるという、ユーザー体験に関する第二の不満についても取り上げています。この部分の議論はより主観的ではありますが、アシスタントの性格は日々の製品体験に直接影響するため、重要です。
重要なのは、516パターンを隠れた打ち切りの証拠として扱わないことです。公開されている証拠は、調査に値するモデル挙動の異常として理解するほうが適切です。
開発者にとっての実践的な要点は単純です。AIコーディングエージェントの性能が突然悪化したように感じられたら、印象だけに頼るのではなく、メタデータを収集し、実行結果を比較し、再現可能なパターンを報告することです。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



