For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/gpt-6-astra-unitree-g1-homebody-kitchen-r-56df14d6.md.
スタンフォード大学とカリフォルニア工科大学のHomeBodyプロジェクトは、GPT AstraとUnitree G1ヒューマノイドを接続し、未知のキッチンを探索しながら空間記憶を構築し、デジタルツインを再現し、再利用可能なナビゲーションおよび操作スキルを呼び出して長期タスクを完了...
具現化AIにおける最新の進展は、卓上ロボットアームの新たなデモではありません。
Unitree G1ヒューマノイドは、未知のキッチンを探索し、物体の場所を記憶し、部屋の反対側にある物を片付け、引き出しを開け、見えなくなった薬を取り出し、それを人に手渡す様子を実演しました。
このプロジェクトはHomeBodyと呼ばれ、スタンフォード大学とカリフォルニア工科大学の研究者によって開発されています。
その中心的な考え方は、驚くほどシンプルです。
最先端の視覚言語モデルに、ロボットのスキルをツールとして扱わせる。
モデルにすべての関節指令を出力させるのではなく、HomeBodyではGPT Astraがタスクを理解し、次に何をすべきかを判断し、移動、ピッキング、配置、引き出しの開閉、物体の取り出しに対応する再利用可能なスキルを呼び出します。
これにより、モデルは低レベルのモーターコントローラーではなく、高レベルのプランナーとして機能します。
その結果、一般的な「物体を見る、拾う、停止する」という構成よりも、長い時間軸でロボットを動作させるワークフローが実現します。
キッチンでのデモでは、ロボットはまず環境を探索し、持続的な空間記憶を構築します。その後、デジタルツインを再構成し、その表現を実際の部屋と位置合わせして、記憶した観察結果を後続の指示の実行に利用します。
たとえば、ユーザーは次のように指示できます。
「キッチンを片付けて。コーヒーバッグをアイランドに置き、傷んだ箱は捨てて。」
G1はその後、異なる場所の間を移動し、コーヒーバッグを集め、指定された箱を廃棄します。
2つ目のタスクは、さらに示唆に富んでいます。
「薬を忘れてしまったので、取ってきてくれる?ついでに悪くなった箱も捨てて。」
依頼された時点で、薬は見えていません。
HomeBodyは保存された空間記憶を検索し、薬が以前に観察された引き出しを思い出し、そこへ移動し、引き出しを開け、薬を取り出して人に手渡し、それでも箱を廃棄するタスクまで完了します。
ここが重要な転換点です。
ロボットは、カメラの前に現在見えているものだけに反応しているわけではありません。現在の知覚、記憶した観察結果、部屋の形状、ナビゲーション、操作、タスクの順序付けを、空間全体にわたって組み合わせています。
HomeBodyの中核設計は、次の一文にまとめられます。
GPT Astraが構造化されたツール呼び出しを通じて、ロボットのスキルを選択し、順序付ける。
モデルはユーザーの目的を理解し、次に何を起こす必要があるかを判断します。
ロボットスタックは、物理的な詳細を処理します。
簡略化すると、次のようになります。
ユーザーの指示
      ↓
GPT Astra/System 2
      ↓
スキルと対象を選択
      ↓
ナビゲーション/ピック/配置/引き出しを開く/引き出しからピック
      ↓
知覚+モーションプランニング+低レベル制御
      ↓
実行結果
      ↓
結果をGPT Astraに返す
      ↓
次のアクションを選択
しかし、ロボットが未知のキッチンから何かを取りに行くには、スキルライブラリだけでは不十分です。
キッチンがどのような場所で、記憶した物体がどこにあるのかを把握する必要があります。
HomeBodyは、3つの段階でこのコンテキストを構築します。
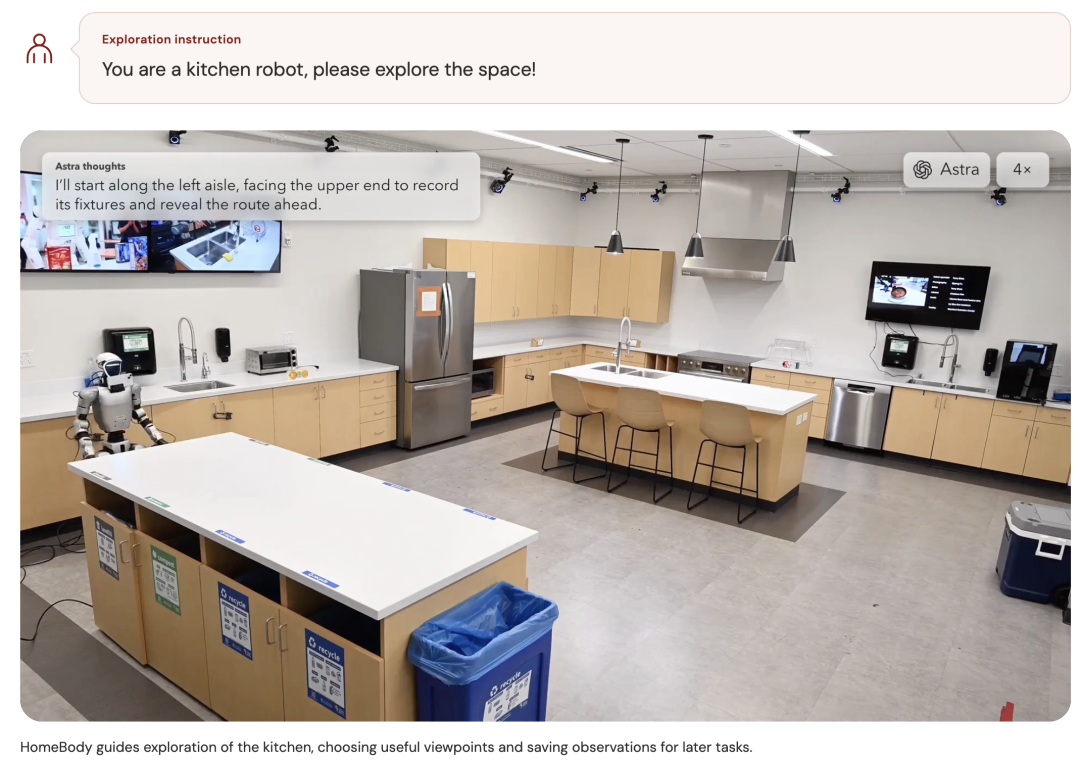
最初の指示は意図的にシンプルです。
あなたはキッチンロボットです。空間を探索してください!
GPT Astraはその後、有用な視点を選び、G1を部屋の中へ誘導します。
探索中、HomeBodyは次のような複数のデータを収集します。
カメラは部屋の中身を映します。
LiDARやその他のセンサーは、測定された空間構造を提供します。
SLAM(自己位置推定と同時地図作成)は、ロボットが地図内の自分の位置を推定しながら、同時に地図を構築するのを支援します。
重要なのは、情報が保持されることです。
G1が物体から視線をそらしても、その情報がカメラの視野とともに消えることはありません。
HomeBodyは観察結果を保存し、それを位置と関連付けることで、後続のタスクから取得できるようにします。
これにより、薬が現在引き出しの中に隠れている場合や、ロボットの視野外にある場合でも、「薬を持ってきて」という依頼を実行できます。
探索だけでは十分ではありません。
次にHomeBodyは、GPT AstraをReal2Simエージェントとして利用し、NVIDIA Isaac Sim内に環境のデジタル再構成を作成します。
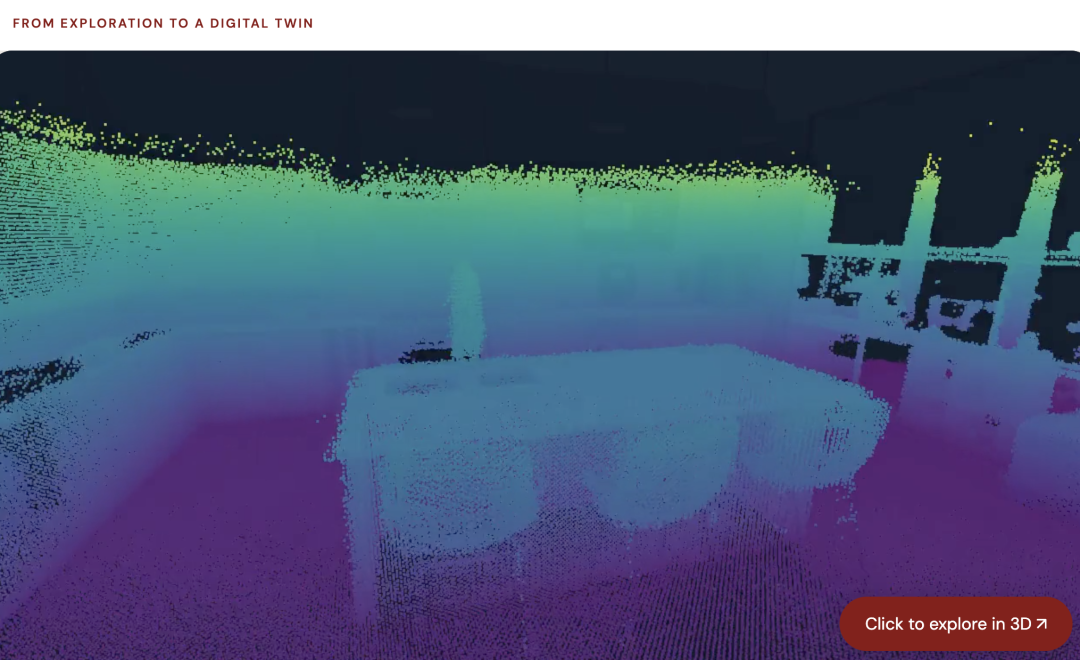
デジタルツインは、キッチンの空間モデルとして機能します。
このモデルによって、システムは次のような構造化された表現を得ます。
重要なのは、再構成が外観だけに基づいていないことです。
HomeBodyは、測定されたSLAMの形状情報もReal2Simプロセスに入力します。
これにより、再構成に現実世界の寸法上の制約が加わります。
これは、見た目に優れた視覚的再構成だけではロボティクスに不十分だからです。
ロボットは、通路が実際に歩行可能な幅か、引き出しの近くまで本体を寄せられるか、環境に衝突せずにアームが対象物へ届くかを把握する必要があります。
その後、システムは実世界のSLAMマップと、再構成されたシミュレーションを共通の座標系で位置合わせします。
保存されたカメラ観察、意味的な説明、ロボットの位置を、部屋の物理的な場所と関連付けられるようになります。
つまり、単に次のように記憶するのではなく、
薬のボトルを見た。
HomeBodyは、次に近い形で保存できます。
この引き出しの中で薬を見た。
記憶されたこの位置にあり、
共有された部屋の座標系の中にある。
これによって、後から取り出せるようになります。
探索と再構成が終わると、ユーザーは日常的なタスクを指示できます。
たとえば、次のような指示です。
キッチンを片付けて。
コーヒーバッグをアイランドに置き、
傷んだ箱は捨てて。
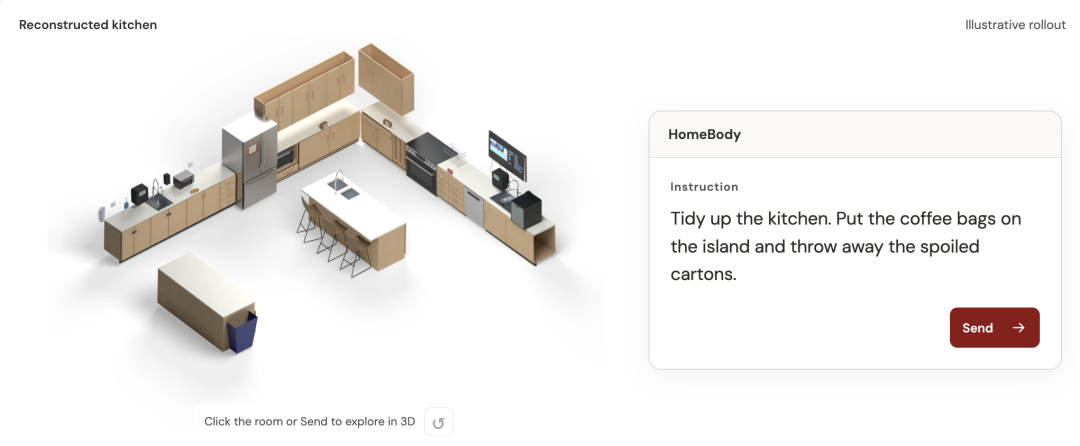
各段階でGPT Astraは、次の情報を考慮できます。
そして、次のスキルと対象を選択します。
薬のデモは、これが有用な理由を示しています。
ユーザーは引き出しを指定していません。
モデルは以前の観察結果を思い出し、正しい場所まで戻り、引き出しを開け、ボトルを取り出して手渡し、残っている片付けの指示を続けて実行できます。
このタスクは、1枚のカメラフレームだけでは完了に必要な情報をすべて得られないほど長いものです。
だからこそ、持続的な空間記憶が価値を持ちます。
これはHomeBodyにおける最も重要なアーキテクチャ上の詳細です。
「GPTがヒューマノイドロボットを制御する」と聞くと、言語モデルがすべての関節角度を直接出力すると想像しがちです。
しかし、HomeBodyはそのようなシステムではありません。
RoboCurveなどの先行研究では、カメラ画像とロボット状態を観察し、グリッパーの位置、向き、開閉状態を指定するツールを使用することで、最先端モデルがロボットアームのタスクを制御する方法を示しました。
HomeBodyは、より高い抽象度で動作します。
モデルは、完成された再利用可能なスキルを呼び出します。
プロジェクトでは、一般的なヒューマノイドスタックを、次の3つの概念レベルで説明しています。
従来型の学習済みアクションアーキテクチャは、次のようになります。
System 2 VLM
     ↓
System 1 VLA
     ↓
System 0 全身コントローラー
HomeBodyは、このパイプラインの中間部分を変更します。
学習済みVLAに高レベルの意図をアクションへ変換させるのではなく、VLMが構成可能なスキルライブラリを直接呼び出します。
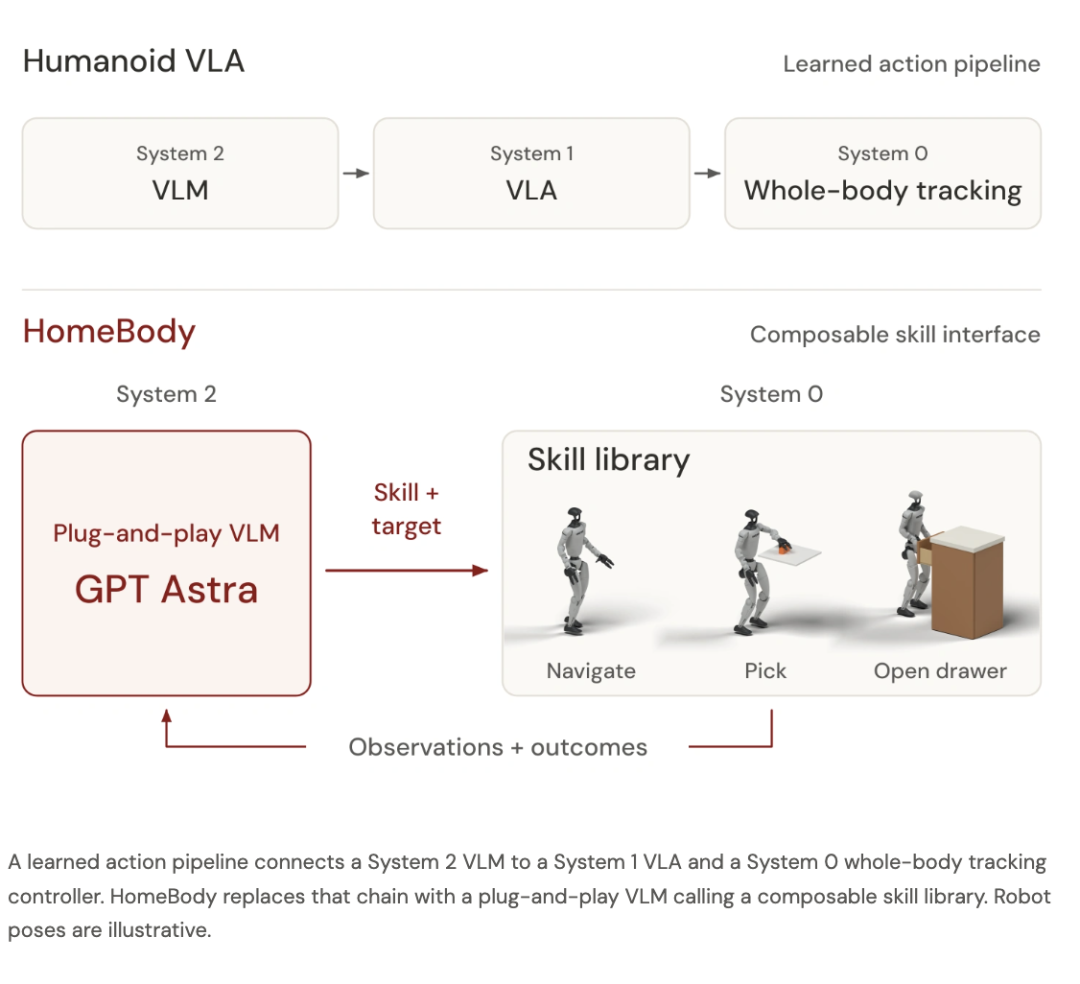
その構造は、次のようになります。
System 2 VLM
     ↓
スキルライブラリ
     ↓
モーションプランニング+知覚
     ↓
System 0 全身制御
HomeBodyの現在のスキル語彙には、次のものが含まれます。
| スキル | 高レベルモデルが提供するもの | スキルが処理するもの |
|---|---|---|
| ナビゲーション | 対象の位置と向き | 経路計画と歩行実行 |
| ピック | 画像上の点と使用する手 | セグメンテーション、深度、把持姿勢、アーム軌道、再試行 |
| 配置 | 手と3Dの解放目標 | 持っている物体を対象位置まで移動して解放 |
| 引き出しを開く | 引き出し/取っ手の対象 | 位置合わせ、引っ掛け姿勢、後方へ引く動作の順序 |
| 引き出しからピック | 開いた引き出し内の物体対象 | 到達、把持、持ち上げ、局所的な再試行ロジック |
すべてのスキルは、対象と実行結果のための共通インターフェースを使用します。
モデルは各スキルの内部にある低レベル実装を理解する必要がありません。
どのスキルを実行し、対象を何にするかを決めればよいのです。
ピック動作では、GPT Astraが一人称カメラ画像内の点を選び、どちらの手を使うかを決定します。
そこから先は、スキルスタックが処理を引き継ぎます。
HomeBodyの実装によれば、次の処理が行われます。
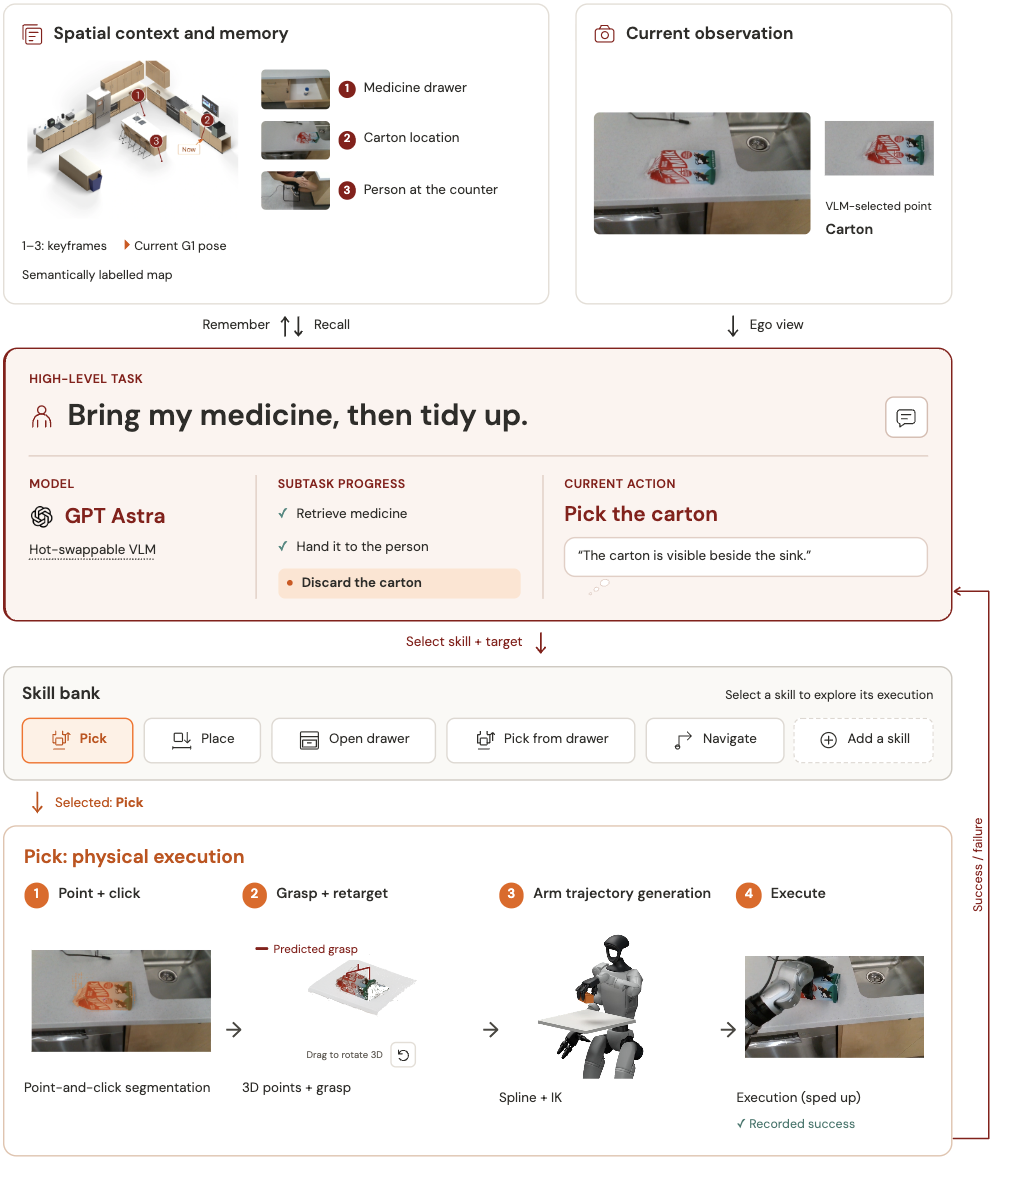
つまり、次のように役割が分かれています。
GPTは何を拾うか、
どちらの手を使うかを決める。

ロボットのスキルは、
手を物理的にどう移動させるかを決める。
この分離により、最先端モデルはリアルタイムのモーター制御を担当せず、推論とタスクの順序付けに集中できます。
物理世界にはノイズがあります。
ロボットが対象に近づくにつれて、対象物がカメラ画像内で移動することがあります。
把持動作を行っても、接触できずに手が閉じることがあります。
ロボットは姿勢を調整する必要があるかもしれません。
そのためHomeBodyでは、細かな修正のたびにGPTが新たな判断を下す必要はありません。
このプロジェクトでは、セグメンテーションとSAM 2.1のトラッキングに、SAMURAI方式のメモリ選択を組み合わせ、フレーム間で対象を追跡します。
その後、ビジュアルサーボによって局所的に位置合わせを修正できます。
把持に失敗した場合、スキルは別の把持候補を試すか、位置を変更して再計画できます。
こうした局所的な再試行には上限があります。
局所スキルで復旧できなくなった場合、失敗理由をGPT Astraへ返します。
VLMはその後、別の対象を選択したり、ロボットを再配置したり、高レベルの計画を変更したりできます。
ループは次のようになります。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
判断
  ↓
スキルを実行
  ↓
結果を観察
  ↓
可能なら局所的に再試行
  ↓
結果をGPT Astraに返す
  ↓
必要に応じて再計画
これにより、次のような複数スキルの連鎖が可能になります。
引き出しまで移動
→ 引き出しを開く
→ 薬をピック
→ 人のところまで移動
→ 薬を手渡す
→ 箱を探す
→ 箱を捨てる
高レベルプランナーが正しいスキルを選択しても、ヒューマノイドは歩行やリーチ動作中にバランスを保たなければなりません。
HomeBodyは、上半身を考慮した下半身制御に、学習済みの**AMO(Adaptive Motion Optimization)**を使用します。
このコントローラーは、歩行を調整しながら上半身の目標を考慮します。
プロジェクトページによれば、アームとハンドの指令は250Hzで実行され、AMOポリシーは制御ティック5回ごと、つまり50Hzで更新されます。
これも、「追加学習なし」という表現には文脈が必要な理由です。
新しいキッチンについて、環境固有の新しいアクションポリシーを学習する必要はありません。
しかし、システムは依然として、VLMの下で動作する既存の学習済みコンポーネントと設計済みコンポーネントに依存しています。
HomeBodyの最も強力な主張の一つは、環境固有の学習データを収集したり、その部屋のために新しいアクションポリシーを学習したりせずに、これまで見たことのないキッチンへ移行できることです。
これは意味のある進展です。
従来のロボット導入では、ロボットが安定して動作できるようになるまで、デモンストレーション、ポリシー学習、環境固有の調整が必要になることがよくあります。
HomeBodyは代わりに、次の要素を組み合わせます。
これにより、適応の負担の一部が再学習から推論+マッピング+再利用可能なツールへ移されます。
HomeBodyの全体フローは、次のようにまとめられます。
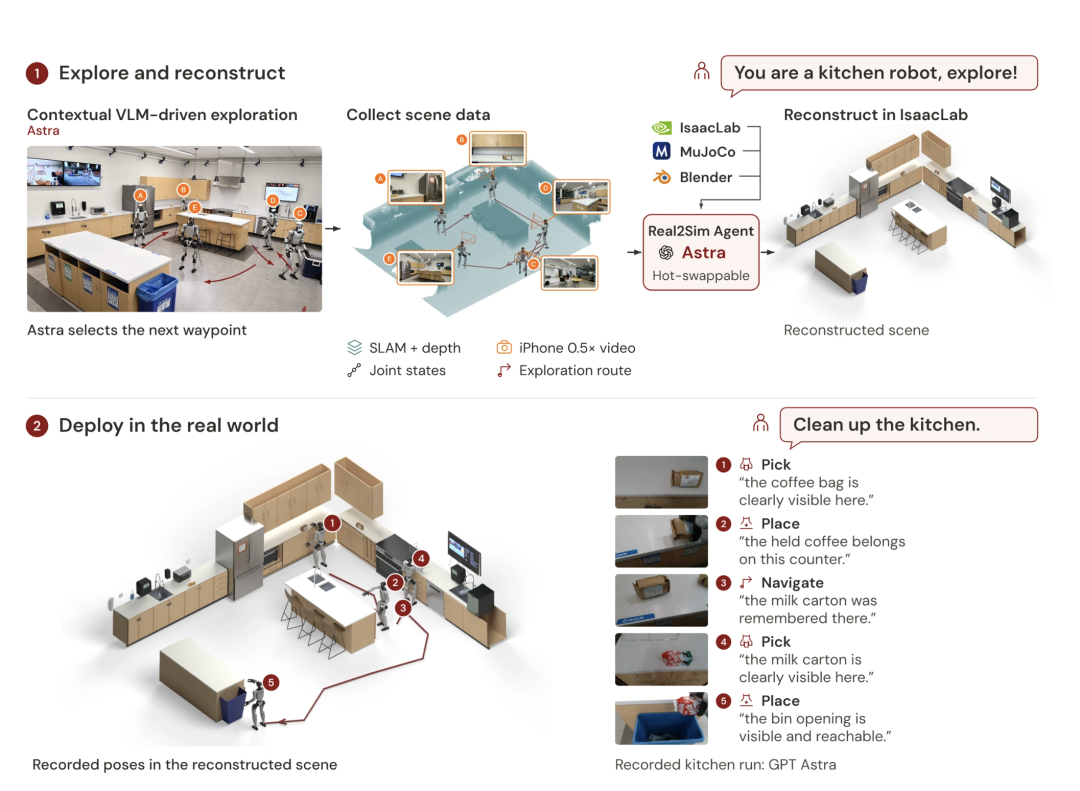
未知の部屋を探索
        ↓
一人称観察+SLAM+姿勢を収集
        ↓
Real2Simでデジタルツインを構築
        ↓
実世界とシミュレーションの座標系を位置合わせ
        ↓
空間観察を保存
        ↓
日常的な指示を受け取る
        ↓
GPT Astraがスキルと対象を選択
        ↓
ローカルのロボティクススタックが実行
        ↓
結果を返す
        ↓
タスクが完了するまで継続
研究デモは印象的ですが、G1を購入してAPIキーを入力すれば家庭用ロボットが動くという話ではありません。
現在のHomeBodyスタックには、依然として相当なロボティクス基盤が必要です。
研究者によれば、知覚、モーションプランニング、スキル実行は、RTX 4090 GPUを搭載したRazer Bladeノートパソコン1台で動作します。
GPT Astraはリモートで動作し、ローカルマシンへスキル要求と対象を送信します。
つまり、アーキテクチャは2つの計算環境に分かれています。
リモートの最先端モデル
→ 高レベルの推論とスキル選択

ローカルのRTX 4090システム
→ 知覚、形状理解、計画、スキル、実行
プロジェクトでは、実用上のコストと制約もいくつか挙げています。
フルワークフローで空間表現を利用する前に、デジタルツインを作成する必要があります。
これには準備時間がかかります。
リモートの最先端モデルは、計画とReal2Sim処理の間に呼び出されます。
そのためAPI費用が発生します。
Astraは瞬時には応答しません。
研究者は、高レベルの推論が完了するまで、スキル間に停止時間が生じると説明しています。
家庭内作業では、物理的なタスクは純粋なデジタルタスクよりすでに大幅に時間がかかるため、こうした停止時間が重要になります。
長時間のヒューマノイドによる操作には、機械的な制限もあります。
HomeBodyのページでは、長時間の動作中に指サーボが過熱することが具体的に言及されています。
ロボットが実行できるのは、現在の手、リーチ、バランス、知覚、実装済みのスキルセットが対応するタスクに限られます。
したがって、このプロジェクトは長期的な自律性を示す研究デモであり、任意の家事に対応できる汎用家庭用アシスタントではありません。
HomeBodyは、最先端モデルと物理ロボットを接続する、より広範な研究の流れに位置付けられます。
元の記事では、ますます一般的になっている3つのアプローチが取り上げられています。
RoboCurve型の構成では、モデルが画像とロボット状態を受け取り、次のような対象を指定するツールを呼び出します。
低レベルの逆運動学または制御スタックが、これらの対象をロボットの動きへ変換します。
モデルは、頻繁な観察・判断・行動のループに留まります。
2つ目のアプローチでは、最先端の言語・視覚モデルを遅い高レベル推論に使い、学習済みVLAをアクション生成に利用します。
概念的には、次のようになります。
VLMプランナー
→ VLAアクションモデル
→ 低レベルコントローラー
この構成では、最先端モデルをモーター層より上位に置きながら、学習済みポリシーを使って計画を物理的な動作へ変換します。
HomeBodyは別のルートを採用します。
中間にある学習済みVLAを必要とせず、最先端VLMが再利用可能なスキルを直接呼び出せるようにします。
これらのスキルには、古典的なアルゴリズム、学習済みポリシー、その他のコントローラーを利用できます。
HomeBodyプロジェクトでは、共通インターフェースを通じて新しいスキルを追加できます。
これにより、アーキテクチャはモジュール化されます。
VLMを置き換える
または
新しいスキルを追加する

全体のロボットスタックを再設計する必要はない
より深い意味で重要なのは、単に「System 0層をもう一つ追加する」ことではありません。
それは、推論と物理的な実行を接続する別の方法です。
空間記憶と組み合わせることで、この接続により、ロボットは1つの卓上周辺だけでなく、部屋全体にわたって作業できるようになります。
元の記事は最後に、RoboCurveによる第三者のロボット制御評価結果を取り上げています。
これらの結果は、タスク固有のロボティクスベンチマーク測定値として読むべきであり、モデル全体の知能に関する普遍的な主張ではありません。
Jay Chooiが共有したRoboCurveの結果では、GPT-6 SolはロボティクスタスクセットでGPT-5.6 Solの約1.6倍のスコアを記録し、1試行あたりのコストは約47%低かったと報告されています。
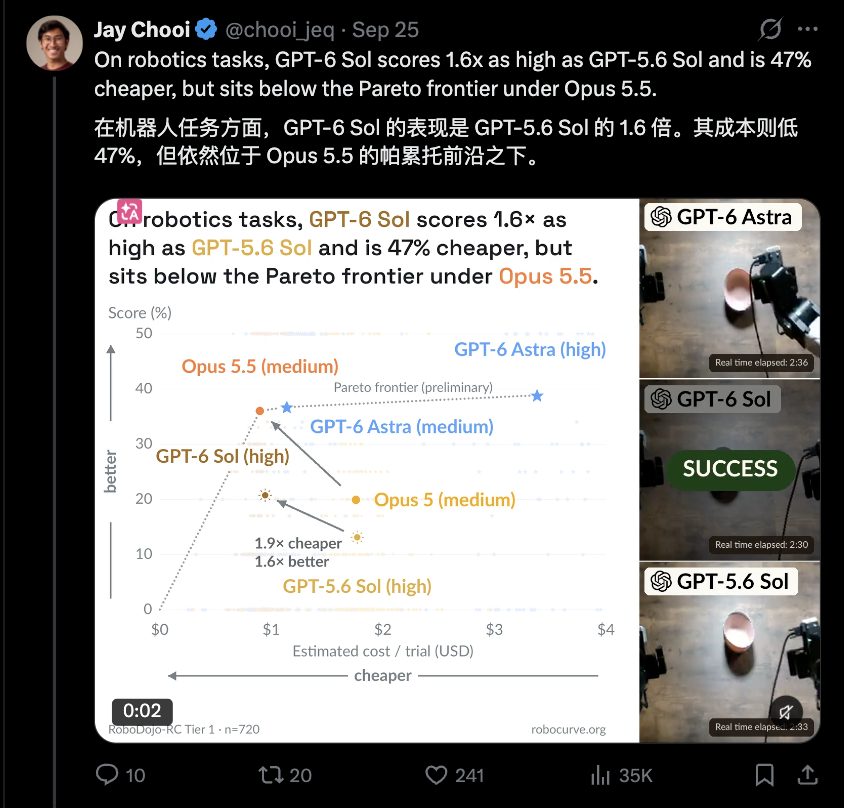
同じチャートでは、この評価におけるより強力なOpus 5.5構成による暫定的なパレートフロンティアを、GPT-6 Solが下回っていました。
これは、コストとロボット制御性能が必ずしも同じ方向に動くわけではないことを示す有用な証拠です。
別のモデルがより高いスコアを達成している場合でも、より安価なモデルの方が運用上の選択肢として優れている可能性があります。
別のRoboCurveの結果では、360回のロボティクス試行が対象となりました。
報告された平均値では、Opus 5.5はOpus 5の約1.8倍のスコアを、約半分のコストで達成しました。また、Astraとほぼ同じ平均スコアを、約21%低いコストで記録したとされています。
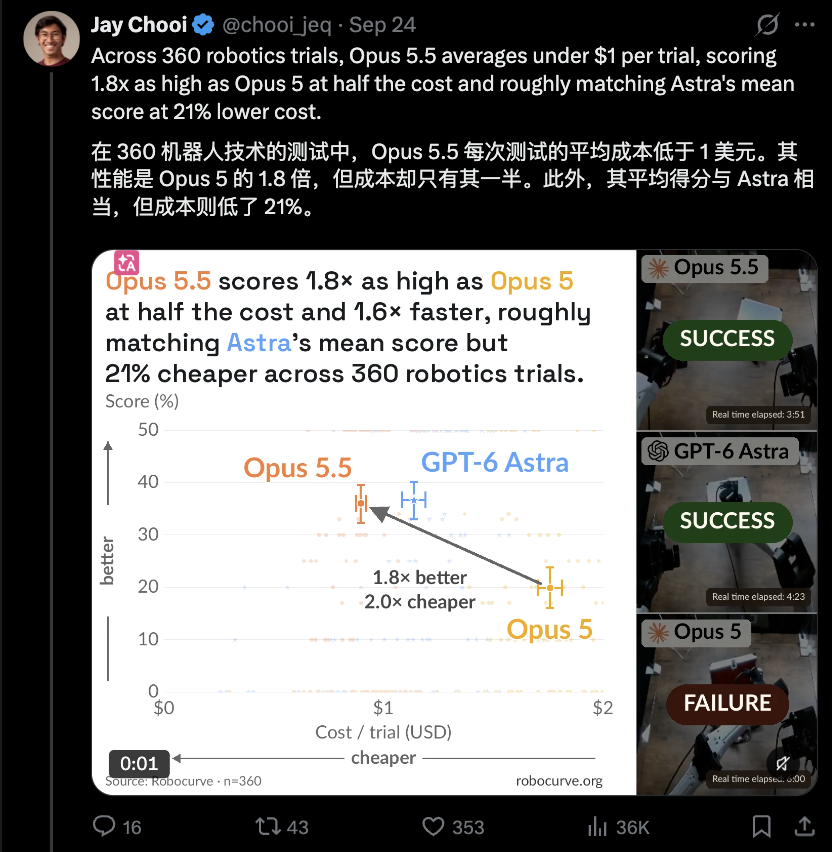
繰り返しになりますが、これはAnthropicやOpenAIによる一般的なベンチマークではありません。
特定のタスク、ハードウェア、プロンプト、試行条件による第三者のロボット制御評価です。
この区別は重要です。なぜなら、具現化AIの性能はシステム全体に依存するからです。
モデル
×
プロンプト設計
×
ロボットハードウェア
×
知覚
×
制御スタック
×
スキル設計
×
タスク定義
コーディングベンチマークで最も高い性能を示すモデルが、ロボット制御におけるコストと性能の比率でも最良とは限りません。
HomeBodyで最も興味深いのは、ヒューマノイドがコーヒーバッグを移動させたことではありません。
ロボットは何年も前から物体を操作してきました。
重要なのは、アーキテクチャ上の転換です。
HomeBodyは、次の要素を実用的に組み合わせる方法を示しています。
最先端モデルは、すべてのモーターの詳細を学習する必要がありません。
ロボットも、キッチンごとに新しいエンドツーエンドポリシーを学習する必要がありません。
その代わり、汎用モデルが構造化された環境について推論し、再利用可能な能力を指揮します。
これは、ソフトウェアエージェントの動作方法に似ています。
モデルが推論する
→ ツールを呼び出す
→ 結果を読み取る
→ 次のツールを選択する
HomeBodyは、このパターンを物理世界へ持ち込みます。
ツールは、もはやウェブ検索、Python、データベースではありません。
それは次のようなものです。
ナビゲーション
ピック
配置
引き出しを開く
引き出しからピック
だからこそ、このプロジェクトは具現化エージェントにとって重要な一歩に感じられます。
HomeBodyは、ヒューマノイドロボットに持続的な空間記憶と、構成可能なモータースキルのライブラリを与える、スタンフォード大学とカリフォルニア工科大学の研究システムです。最先端の視覚言語モデルが長期タスクを計画し、構造化されたツールインターフェースを通じてスキルを呼び出します。
いいえ。HomeBodyのプロジェクトページでは、プランナーをGPT Astraと表記し、高レベルのSystem 2モデルとして利用しています。ナビゲーション、操作、知覚、モーションプランニング、再試行、全身制御は、低レベルのロボティクスモジュールと学習済みコントローラーが処理します。
研究者によれば、実演された未知のキッチンでは、環境固有の学習データや追加のポリシー学習は必要ありません。ただし、システムは学習済みの知覚モデル、再利用可能なスキル、SLAM、計画ソフトウェア、学習済みのAMO全身コントローラーに依存しています。
探索中、HomeBodyは一人称カメラの観察結果を、意味的な内容や共有された空間座標系内の位置とともに保存します。後から視野外の物体を指す依頼を受けると、GPT Astraは保存されたキーフレームを思い出し、記憶された場所まで戻ることができます。
Real2Simの段階によって、高レベルプランナーは部屋の構造化された空間モデルを利用できます。HomeBodyは、測定されたSLAMの形状情報によって再構成を現実の寸法に結び付けるため、判断が視覚的な外観だけに依存しません。
プロジェクトによれば、ローカルのスキル、知覚、モーションプランニングはRTX 4090 GPUを搭載したRazer Bladeノートパソコンで動作し、GPT Astraはリモートで実行されます。現在の構成には、ヒューマノイド本体、カメラ、LiDAR/SLAMコンポーネント、ネットワーク、プロジェクトのロボティクスソフトウェアスタックも必要です。
いいえ。このプロジェクトは意味のある長期自律性を示していますが、Real2Simのセットアップ時間、APIコスト、推論レイテンシ、操作上の制限、指サーボの過熱などのハードウェア耐久性の問題といった制約も自ら文書化しています。
いいえ。元の記事で扱われている数値は、独立した第三者評価機関であるRoboCurveによるもので、同社のロボティクスタスクセットと試行条件に適用されます。この文脈を離れて、モデル全体のランキングとして一般化すべきではありません。
HomeBodyは、最先端モデルがすべての低レベルモーター指令を直接生成せずに、ヒューマノイドの高レベルプランナーになれることを示しています。GPT Astraは未知の部屋を探索し、Real2Simによる再構成と持続的な空間記憶を利用し、ナビゲーションと操作のスキルを組み合わせて、長期的なキッチンタスクを完了します。
重要な設計上の選択はモジュール性です。モデルが次に何を起こすべきかを決め、知覚、形状理解、モーションプランニング、局所的な再試行、全身制御が、ロボットが物理的にどのように実行するかを決めます。これにより、システムは環境固有の新しいアクションポリシーを学習せずに新しいキッチンへ入ることができます。一方で、相当な学習済みロボティクス基盤と設計済みインフラには依然として依存しています。
現在の実装は、プラグアンドプレイの家庭用ロボットではなく、研究システムです。RTX 4090クラスのローカルマシン、リモートモデル推論、シミュレーションのセットアップ、APIアクセス、堅牢なロボットハードウェアが必要です。研究者は、長時間の現実世界タスクにおいて依然として重要なレイテンシと耐久性の制約も記録しています。
重要なのは、単に「GPTがロボットを制御できる」ということではありません。汎用モデルが、ソフトウェアエージェントがツールを使うのと同じように、空間記憶と再利用可能な物理スキルを利用できるようになったことです。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



