
OpenAIは2026年9月3日、GPT-6 Astraを発表しました。北京時間ではすでに9月4日です。OpenAIはAstraを、これまでで最もインテリジェントかつアラインメントに優れたモデルと位置付け、コンピューター操作、ブラウジング、ソフトウェアエンジニアリング、サイバーセキュリティ、科学、専門業務など、難度の高いエンドツーエンドの作業向けに提供しています。
この位置付けが重要なのは、Astraを単純な「次世代チャットボット」として理解するのが適切ではないからです。
最も目立つ改善は、モデルが多くのステップをまたいで作業し続けなければならないタスクに集中しています。環境を調査し、ツールを使い、計画を修正し、失敗に対処し、ソフトウェアを操作し、単一の回答ではなく完成した成果物を出力する、といった作業です。
元の記事では、この変化を「ネイティブなエージェント時代」の始まりと表現しています。この方向性は有用ですが、エージェントハーネス全体がモデルの重みに移されたと説明するほど単純ではありません。
OpenAI自身のドキュメントでは、協調して動作する2つの層が説明されています。
- GPT-6 Astra:長時間にわたる複数ステップのワークフローを処理し、ツールを効果的に使い、作業を分割し、サブエージェントに委任し、要件が変化しても一貫性を維持できるよう訓練されたモデル。
- エージェント型ハーネス:CodexやChatGPT Workで使われるオーケストレーション層など。モデルをツール、ユーザー環境、コンテキスト管理、権限、実行ループに接続します。
つまり、Astraは大幅にエージェント指向になっていますが、アプリケーション側には依然としてモデルを取り巻く実行環境が必要です。
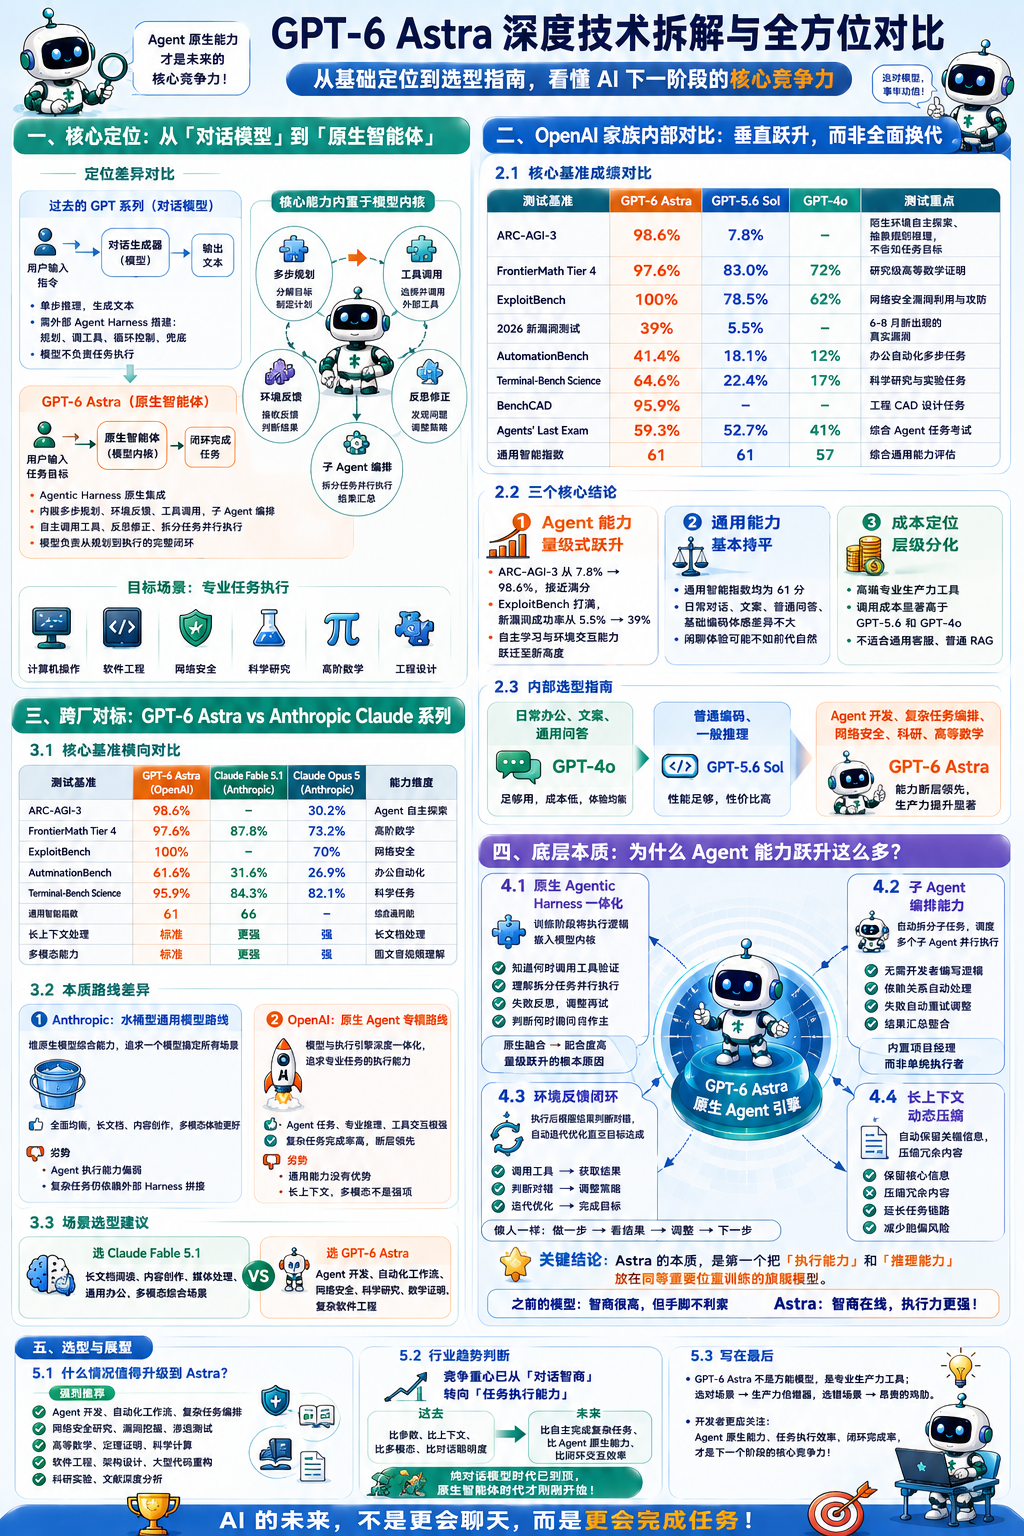
この記事では、元記事の5部構成を維持し、Astraを次の5つの観点から検討します。
- 中核となる位置付け。
- OpenAIモデルファミリー内での比較。
- Anthropic Claudeとのベンダー横断比較。
- エージェント性能が飛躍した技術的理由。
- モデル選定の指針と、この変化が開発者に与える意味。
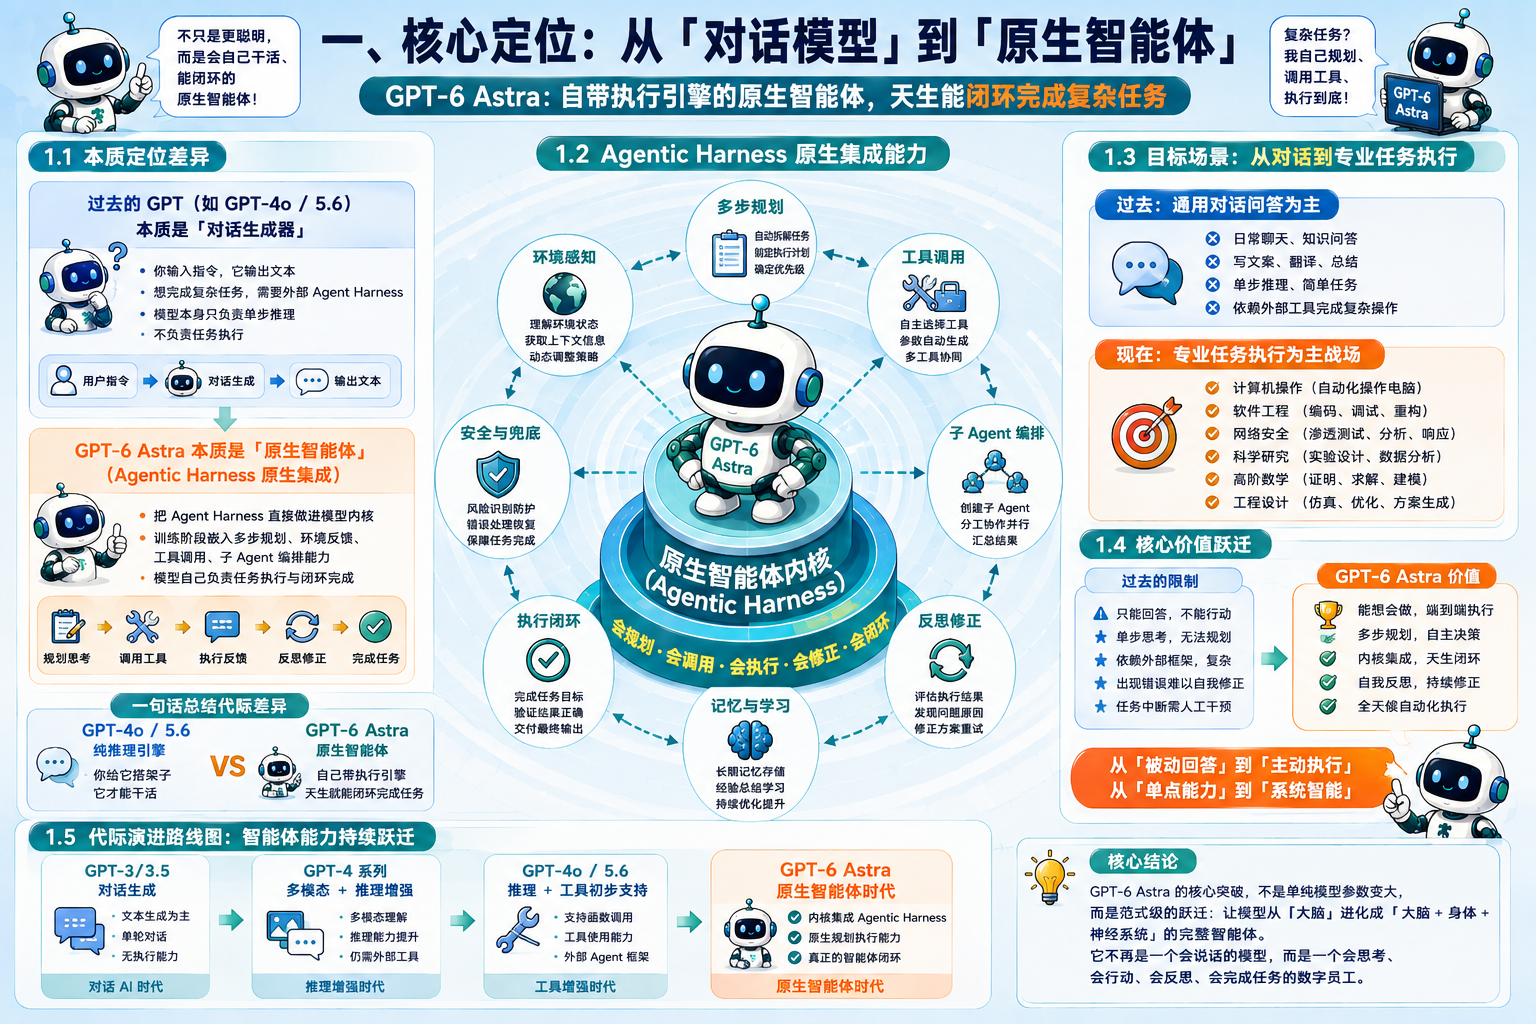
ベンチマークの数値を見る前に、モデルと周辺のプロダクトスタックを分けて考えることが重要です。
1.1 これまでのGPTワークフローでは、通常より多くの外部オーケストレーションが必要だった
従来型の言語モデルワークフローは、次のように簡単にイメージできます。
ユーザーのプロンプト
→ モデルの推論
→ モデルの回答
より複雑なエージェントでは、通常、周辺アプリケーションが別の層を追加します。
ユーザーの目標
→ エージェントハーネス
→ モデル
→ ツール呼び出し
→ 環境からの結果
→ モデル
→ 次のアクション
→ 最終結果
この外部ハーネスは、ツールの公開方法、結果の返却方法、コンテキストの引き継ぎ、適用する権限、ループを停止するタイミングを決定します。
OpenAIは現在もこのアーキテクチャを採用しています。実際、CodexやChatGPT Workのエージェント型ハーネスを、モデル、ツール、ユーザー環境を接続するRust製のオーケストレーション層として個別に説明しています。
1.2 GPT-6 Astraで実際に変わったこと
Astraは、ハーネスを有用にする行動をより深く学習しています。
OpenAIのモデルガイダンスでは、次のような能力が強調されています。
- コード、ブラウザー、専門ソフトウェアにまたがる複雑な複数ステップのワークフローを継続する。
- 非同期ツールの実行中も推論を続ける。
- 完了済みの作業を破棄せず、ターンの途中で指示を受け入れる。
- 長時間にわたる会話でも作業を維持する。
- ハーネスが協働ツールを提供している場合、作業を分割してサブエージェントに委任する。
- コンピューター操作ツールをより効果的に使う。
- タスクの境界をより適切に守り、判断によって結果が大きく変わる場合には焦点を絞った質問をする。
したがって、その違いは「ハーネスがモデル内に消えた」というより、モデルとハーネスの共同設計と表現する方が正確です。
1.3 対象となるワークロードが変化した
実務上の対象は、もはや次のような作業だけではありません。
- 一般的な質疑応答。
- 文章の下書き。
- 一度きりのコード生成。
- 単純な要約。
Astraは主に、次のような難度の高い実行ワークロードを対象としています。
- コンピューター操作。
- ブラウザーワークフロー。
- ソフトウェアエンジニアリング。
- 科学分析。
- 専門文書の作業。
- 複雑な調査。
- 許可を受けたサイバーセキュリティおよび防御的セキュリティ研究。
- CADおよびエンジニアリング作業。
OpenAIの発表資料では、会話の人格を改善することよりも、エンドツーエンドの作業が繰り返し強調されています。
1.4 要点
世代交代を理解するには、次のように考えると分かりやすいでしょう。
従来のモデル中心ワークフロー:
高度な推論 + 外部オーケストレーション

GPT-6 Astraのワークフロー:
より強力なエージェント訓練済み推論 + その能力を引き出すよう設計された外部オーケストレーション
2つ目のシステムがより高い能力を発揮するのは、モデル自体が計画を立て、フィードバックを利用し、ツールを操作し、作業を委任し、長いタスクの軌跡全体で一貫性を保つことに長けているためです。
2. OpenAIファミリーの比較:全用途を置き換えるのではなく、垂直方向の飛躍
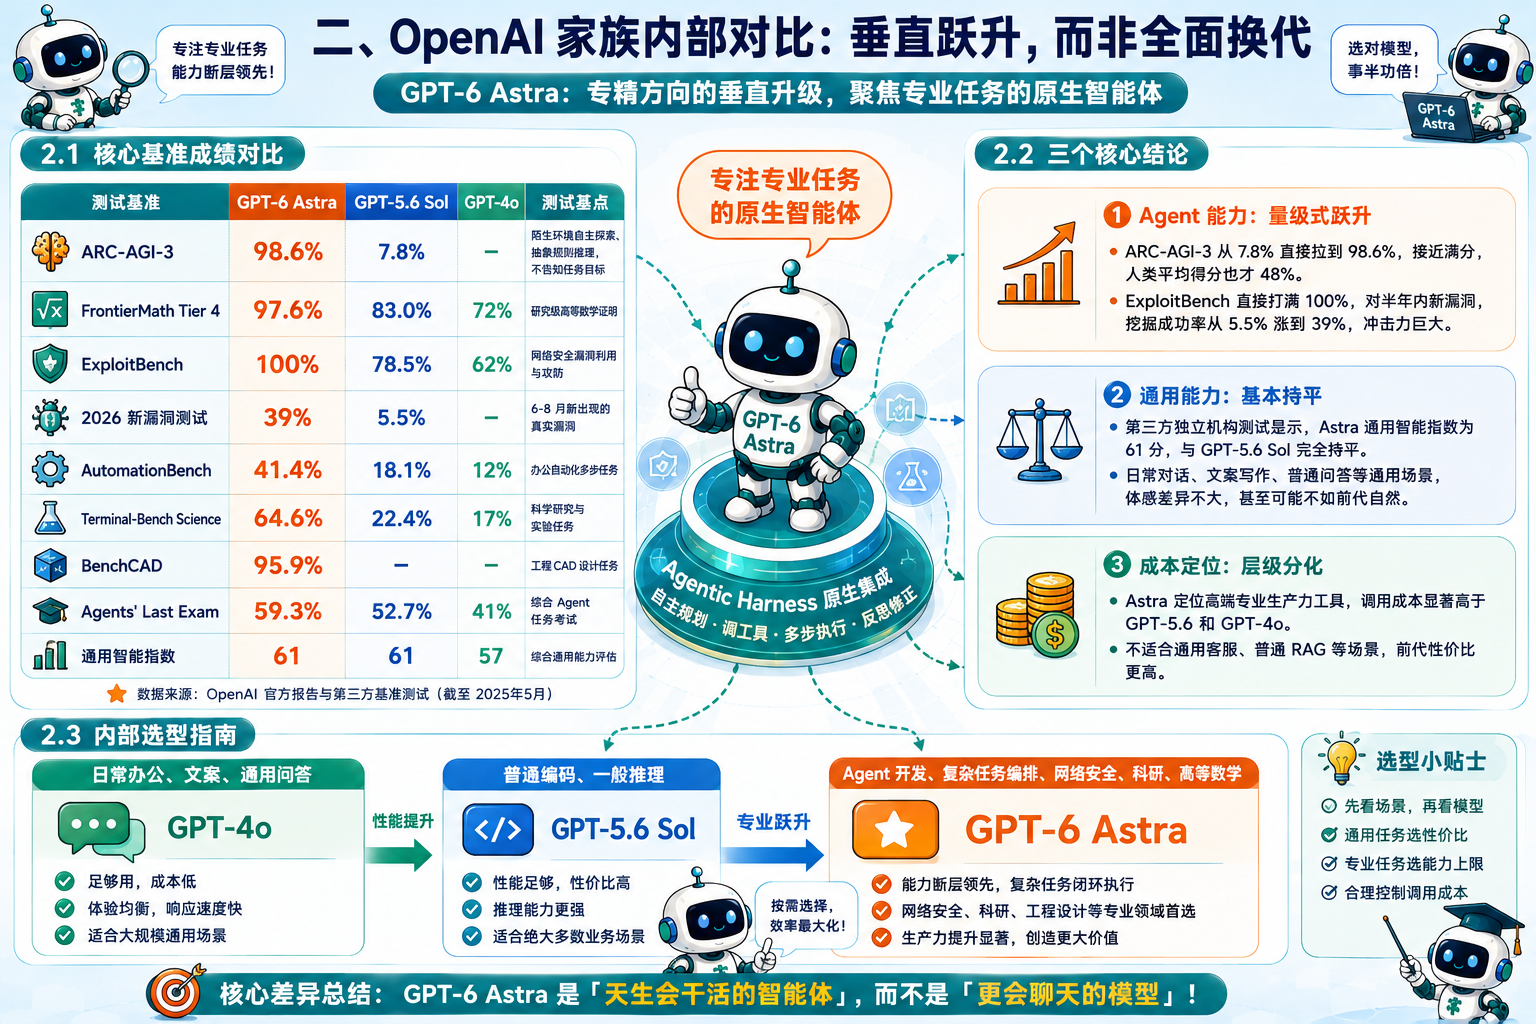
元記事で最も有用な指摘は、Astraがあらゆるワークロードで安価なモデルを自動的に置き換えるわけではない、という点です。
最大の改善は、難度の高いエージェント型タスクや専門業務で現れています。
2.1 中核ベンチマークの比較
次の表では、入手可能な範囲でOpenAI公式のGPT-6 Astra発表時の比較値を使用しています。
| ベンチマーク | GPT-6 Astra | GPT-5.6 Sol | 評価対象 |
|---|---|---|---|
| ARC-AGI-3 | 99.9% | 7.8% | 新規のインタラクティブ環境と抽象ルールの発見 |
| FrontierMath Tier 4(v2) | 97.6% | 83.0% | 研究レベルの数学 |
| ExploitBench | 100.0% | 78.5% | 評価環境における既知の脆弱性のエクスプロイト開発 |
| ExploitBench、2026年6月~8月 | 39.0% | 5.5% | モデルの知識カットオフ後に発見された新しい脆弱性 |
| AutomationBench | 41.4% | 18.1% | 複数ステップの専門業務自動化 |
| Terminal-Bench Science 0.1 | 64.6% | 22.4% | コードとターミナルツールを用いる科学ワークフロー |
| BenchCAD | 95.9% | 83.3% | 複数視点のレンダリングからのCAD再構成 |
| Agents’ Last Exam | 59.3% | 53.6% | 複雑な専門業務のコンピューター操作タスク |
| 発表時のArtificial Analysis Intelligence Index v4.1.1 | 61.2 | 60.9 | 複数指標による独立した総合知能指数 |
この表を読む際には、いくつかの点が重要です。
第一に、OpenAIの見出しではFrontierMath Tier 4を98%に丸めていますが、ベンチマーク表ではv2評価について97.6%としています。
第二に、ARC-AGI-3の際立った結果は、エージェント型のインタラクティブベンチマークによるものです。OpenAIは、AstraをResponses APIのハーネスとともに実行したこと、また評価設定が本番のChatGPTと異なる可能性があることを説明しています。
第三に、サイバーセキュリティのスコアは、管理された評価条件で測定されています。OpenAIは現在、Preparedness Frameworkに基づき、Astraがクリティカルなサイバーセキュリティ能力のしきい値に達したと分類し、これらの能力に対してより強力な保護策を導入しています。
2.2 3つの中核的な結論
① エージェント型タスクと環境操作タスクで最大の飛躍が見られる
ARC-AGI-3が最も分かりやすい例です。
OpenAIが公開した評価では、Astraは99.9%で、GPT-5.6 Solの7.8%を大きく上回っています。このベンチマークでは、静的なプロンプトから回答するのではなく、インタラクションを通じて目標やルールを推測する必要があります。
同じ傾向は複数の運用ベンチマークにも現れています。
- AutomationBench:41.4%対18.1%。
- Terminal-Bench Science:64.6%対22.4%。
- 新しいExploitBenchポート:39.0%対5.5%。
そのため、通常のチャットよりもエージェントワークフローで、Astraははるかに大きな世代交代のように感じられます。
② 一般的な総合知能はかなり近い
発表時のArtificial Analysis Intelligence Index v4.1.1について、OpenAIは次の数値を報告しました。
GPT-6 Astra:61.2
GPT-5.6 Sol:60.9
Claude Fable 5.1:65.7
この総合指数におけるAstraとSolの差は、ARC-AGI-3やTerminal-Bench Scienceでの差と比べるとごく小さいものでした。
Artificial Analysisはその後、異なるベンチマーク構成のv4.2へ移行しており、絶対値は変化しています。それでもより広い結論は変わりません。Astraの突出した優位性は、一般知能のあらゆる指標が突然2倍になったことではありません。
③ 料金は明確にプレミアム層に位置付けられる
GPT-6 Astraの標準API料金は次のとおりです。
| トークン種別 | 100万トークンあたりの料金 |
|---|---|
| 入力 | $10.00 |
| キャッシュ済み入力 | $1.00 |
| キャッシュ書き込み | $12.50 |
| 出力 | $50.00 |
GPT-5.6 Solは現在、入力100万トークンあたり4ドル、出力100万トークンあたり20ドルと、より低い料金に設定されています。
したがってAstraは、タスク完了率の向上によって高いトークン料金を相殺できる場合に最も適しています。
長いコンテキストに関しては、もう1つ料金上の注意点があります。入力トークンが272Kを超えるリクエストでは、リクエスト全体に対して高い料金が適用されます。現在のAstraモデルページによると、入力およびキャッシュ料金は2倍、出力料金は1.5倍です。
2.3 内部モデル選定ガイド
元記事では、低コストの汎用オプションとしてGPT-4oを使用していました。GPT-4oはAPIカタログに引き続き存在しますが、OpenAIの現在のモデルガイダンスでは、新規の統合の大半に、より新しいGPT-5.6ファミリーのモデルを推奨しています。
より現行に近い選定ガイドは次のとおりです。
| シナリオ | 最初に検討するモデル | 理由 |
|---|---|---|
| 大量処理、コスト重視の一般タスク | GPT-5.6 LunaまたはTerra | 多くの日常的なワークロードに十分な能力を、より低い料金で提供 |
| 専門的な推論とコーディング | GPT-5.6 Sol | Astraより低い料金で高い専門業務性能を提供 |
| 難度の高いエンドツーエンドのワークフロー、コンピューター操作、科学タスク、高度なエージェント作業 | GPT-6 Astra | 難しい複数ステップの実行とツールを多用する作業に最適 |
| 従来のGPT-4o統合 | 状況に応じてGPT-4oを継続利用可能 | 引き続き利用できるが、新しい最先端ワークフローの標準推奨ではない |
実務上のルールは単純です。
まず、そのタスクを安定して完了できる最も安価なモデルから始めます。トークン単価よりもタスク成功率、自律性、実行品質が重要になったら、Astraへ移行します。
3. ベンダー横断比較:GPT-6 Astra対Anthropic Claude
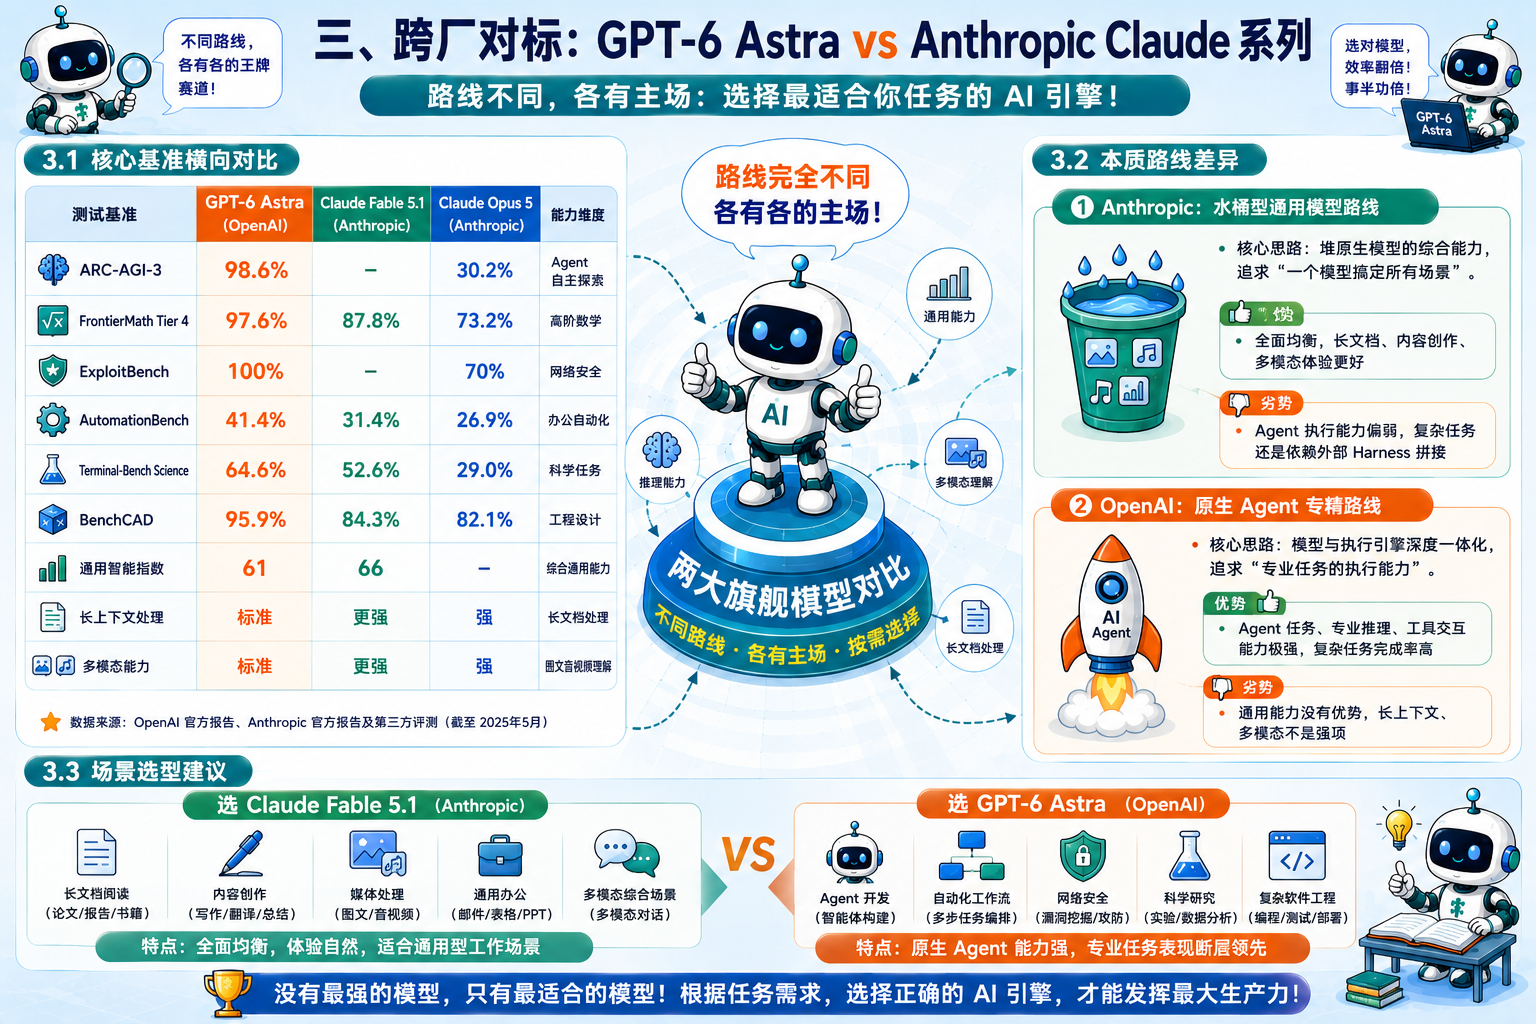
元記事では、OpenAIとAnthropicがまったく異なる道を進んでいると説明しています。
強調点が異なるという意味では一部正しいものの、現在の製品はその説明ほどかけ離れていません。
Claude Fable 5.1も、長時間実行されるエージェント、コーディング、ブラウザー操作、エンタープライズワークフロー、管理型エージェント実行向けに明確に設計されています。Astraも、1Mコンテキストに対応するマルチモーダルモデルであり、一般的な推論能力に優れています。
したがって、より正確な比較は「一方はエージェントで、もう一方はそうではない」というものではありません。
重要なのは、現時点で各システムが最も強い証拠を示し、どこに製品上の重点を置いているかです。
3.1 中核ベンチマークの比較
次の数値は、特に記載がない限り、OpenAIの発表時比較表から引用しています。
| ベンチマーク | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5 | 能力の側面 |
|---|---|---|---|---|
| ARC-AGI-3 | 99.9% | — | 30.2% | インタラクティブな抽象推論 |
| FrontierMath Tier 4(v2) | 97.6% | 87.8% | 73.2% | 高度な数学 |
| ExploitBench | 100.0% | — | 70.0% | サイバーセキュリティ評価 |
| AutomationBench | 41.4% | 31.4% | 26.9% | 専門業務の自動化 |
| Terminal-Bench Science 0.1 | 64.6% | 52.6% | 30.0% | 科学ワークフロー |
| BenchCAD | 95.9% | 84.3% | 82.1% | エンジニアリングおよびCAD |
| Agents’ Last Exam | 59.3% | — | 55.5% | 専門業務のコンピューター操作タスク |
| Astra発表時のArtificial Analysis Intelligence Index v4.1.1 | 61.2 | 65.7 | 63.1 | 独立した総合指数 |
ダッシュは、そのモデルに能力がないことを意味しません。OpenAIの比較表で、その項目について直接比較可能なスコアが公開されていないことを意味します。
3.2 より有用な進化の違い
① Anthropic:高い汎用能力を備えた長時間の知識業務とコーディング
AnthropicはClaude Fable 5.1を、意欲的なコーディングと知識業務向けの、一般提供モデルとして最も高性能なモデルと位置付けています。
公式製品ページでは、次の能力が強調されています。
- 数時間かかる長時間のプロジェクト。
- コードベース全体にまたがるコーディング。
- 管理型エージェント。
- ブラウザー操作。
- エンタープライズワークフロー。
- 図、グラフ、表、ファイル、PDFの視覚的理解。
- 1Mクラスのコンテキスト。
- 高度な調査と専門業務。
Fable 5.1は、発表時のArtificial Analysis v4.1.1総合指数でも首位となり、現在の独立ランキングでも、バージョンや推論設定によっては最も強力なモデルの1つです。
そのため、Claudeを「依然として外部ハーネスを必要とするチャットモデル」とだけ捉えるのは不正確です。Astraと同様に、Claudeもエージェントスタックの一部として機能します。重要なのは、モデルと周辺の実行環境の両方です。
② OpenAI:複数のコンピューター操作およびツール実行ベンチマークで強い証拠
Astraの発表時の評価結果は、特に次の領域で強力です。
- コンピューター操作。
- AutomationBench。
- ARC-AGI-3。
- Terminal-Bench Science。
- BenchCAD。
- サイバーセキュリティ評価。
OpenAIはAstraに合わせて、非同期ツール呼び出しやターン途中の指示変更など、エージェントに焦点を当てたAPI機能も導入しました。また、ハーネスが協働ツールを提供する場合、Astraが作業を分割してサブエージェントに委任できることを文書化しています。
このため、洗練された回答を1つ生成することよりも、ツールや環境をまたぐ難しいワークフローを完了することが重要な業務では、Astraが特に魅力的です。
3.3 長いコンテキストとマルチモーダル機能は、一方だけの優位性ではない
元記事では、Astraの長いコンテキストとマルチモーダル機能を「標準的」とし、Claudeの方が優れているとしています。
しかし、現在の仕様からは、この結論を広く一般化するのは適切ではありません。
GPT-6 Astraは次に対応しています。
- 1,050,000トークンのコンテキストウィンドウ。
- 画像入力。
- テキスト出力。
- ウェブ検索。
- ファイル検索。
- コンピューター操作。
- MCP。
- Responses APIを通じたコードインタープリターとホスト型シェル。
Claude Fable 5.1も、おおむね1Mクラスのコンテキスト、画像入力、ファイルおよびPDF理解、コーディング、ブラウザー操作、長時間実行されるエージェントワークフローに対応しています。
したがって、適切な判断はコンテキストウィンドウの大きさだけでなく、具体的なワークロードと評価結果に基づくべきです。
3.4 シナリオ別の選定
次のような業務が中心なら、まずClaude Fable 5.1を選びます。
- 大規模な知識業務プロジェクト。
- Claudeのワークフローがチームに適合する長期的なコーディングプロジェクト。
- 文書を多用する分析。
- PDF、表、グラフを詳しく解釈する作業。
- Anthropicのネイティブな管理型エージェントワークフロー。
次のような業務が中心なら、まずGPT-6 Astraを選びます。
- 複雑なコンピューター操作タスク。
- ツールを多用するエンドツーエンドの自動化。
- 難度の高い科学ワークフロー。
- CADおよびエンジニアリングの自動化。
- OpenAIエコシステム内でのエージェントオーケストレーション。
- 適用される保護策とポリシーの下で許可された防御的サイバーセキュリティ研究。
重要な本番システムでは、標準モデルを決める前に、自社を代表するタスクで両方をベンチマークしてください。
4. 技術の核心:なぜエージェント性能はこれほど飛躍したのか
数分で紹介サイトを作り、リード獲得を伸ばす
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
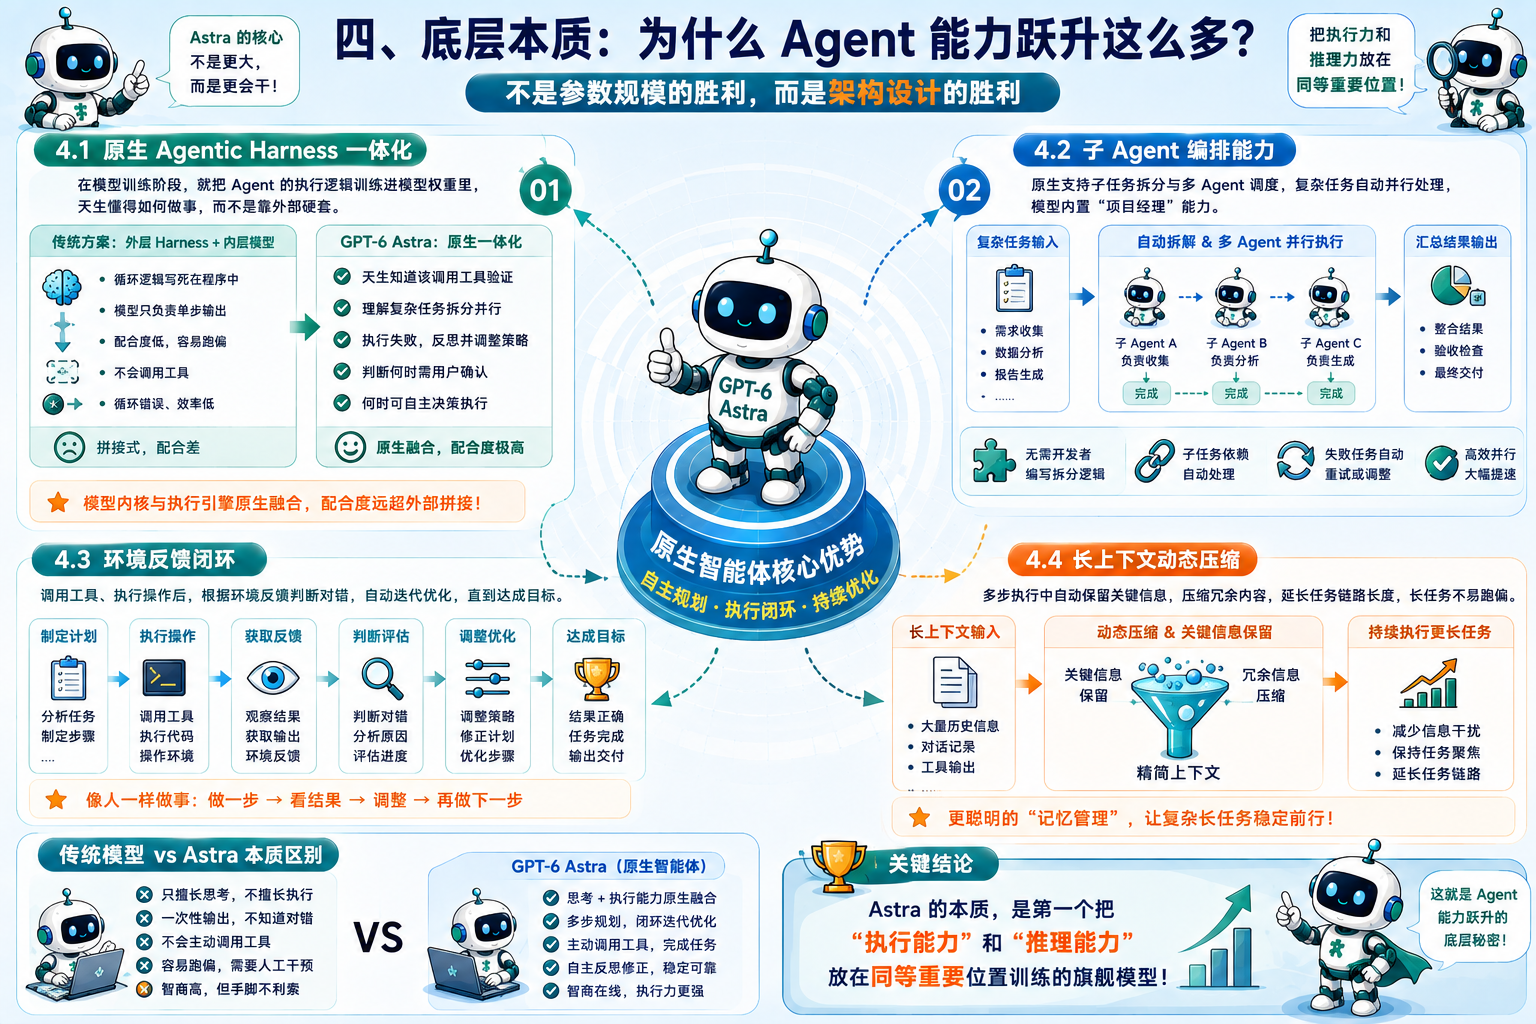
元記事では、Astraの性能向上はパラメーター数よりも主にアーキテクチャによるものだとしています。
OpenAIはAstraのパラメーター数を公開していないため、モデルサイズがどの程度寄与したかについての主張を直接検証することはできません。
OpenAIが文書化しているのは、モデルの訓練、推論の改善、エージェント型ハーネスの設計を組み合わせたアプローチです。
4.1 モデルとハーネスの共同設計
元記事を最も大きく修正すべき点はここです。
OpenAIは、エージェント型ハーネス全体が文字どおりAstraのモデルの重みに組み込まれたとは説明していません。
OpenAIは、モデル、ツール、ユーザー環境を接続するオーケストレーション層として、エージェント型ハーネスを別途文書化しています。また、Astraはそのようなシステム内で複数ステップの作業をより効果的に実行できるよう訓練されていると説明しています。
実際のアーキテクチャは、次のように考えると近いでしょう。
ユーザーの目標
   ↓
エージェント型ハーネス / Responses API
   ↓
GPT-6 Astra
   ↓
ツール要求または委任されたサブタスク
   ↓
アプリケーション / ツールが作業を実行
   ↓
結果がAstraに返る
   ↓
Astraが計画を更新
   ↓
完了するまで継続
この区別は開発者にとって重要です。アプリケーション側には、次のような重要な責任が残るからです。
- ツールの実装。
- 権限。
- 認証。
- 環境の分離。
- 承認ポリシー。
- 再試行と失敗への対応。
- ログ記録と可観測性。
- セキュリティ境界。
より強力なモデルによって、壊れやすいプロンプトやオーケストレーションロジックの量は減らせます。しかし、システムエンジニアリングそのものが不要になるわけではありません。
4.2 サブエージェントへの委任
OpenAIによると、GPT-6 Astraは作業を分割し、並行して動作するサブエージェントに委任するよう訓練されています。
ただし、公式ガイダンスでは、この機能はハーネスでマルチエージェントシステムを実装し、協働ツールを提供した場合に利用できると明記されています。
つまりAstraは、次のようなプロジェクトマネージャーに近い動作を実現できます。
複雑な目標
→ 独立した作業ストリームに分割
→ 並行して委任
→ 結果を収集
→ 依存関係を解決
→ メインタスクを継続
ただし、サブエージェントの実際の作成、実行環境、通信チャネルは、依然として周辺のエージェントシステムが提供します。
4.3 環境からのフィードバックループ
Astraが最も強い結果を示すのは、環境と対話し、結果を観察できるベンチマークであることが多いです。
堅牢なエージェントループは、次のように動作します。
計画
→ 実行
→ 結果を観察
→ 成功したか判断
→ 計画を修正
→ 再度実行
これは、一度きりのテキスト生成とは根本的に異なります。
モデルは返されたツール結果を使って、継続、再試行、戦略変更、ユーザーへの確認依頼を判断できます。
OpenAIの現在のResponses API機能も、次の要素によってこのスタイルの作業を支えています。
- ツール呼び出し。
- 非同期ツール呼び出し。
- ターン途中の指示変更。
- 推論状態の保持。
- 会話状態。
- コンパクション。
- コンピューター操作。
4.4 長いコンテキストの管理とコンパクション
長時間にわたるエージェントタスクでは、コンテキスト管理が問題になります。
ツールの結果、ファイル、推論の分岐、過去のアクションは、履歴を次々に増やします。システムがすべてを単純に再送し続けると、コンテキストは高価になり、ノイズも増えます。
Astraのコンテキストウィンドウは105万トークンですが、OpenAIは長時間にわたるResponses APIの会話向けに、明示的なコンパクションもサポートしています。
有用なパターンは次のとおりです。
大量のタスク履歴
→ 重要な最新状態を保持
→ 古い情報を圧縮
→ 継続に必要な事実を維持
→ 作業を継続
コンパクションは魔法の記憶ではありません。開発者は、1つの会話が無期限に増え続けることに依存せず、リポジトリ、データベース、ドキュメントなどのストレージに永続的なプロジェクト状態を保存すべきです。
4.5 非同期ツール呼び出しが長時間作業を変える
Astraの新しいAPI機能の1つが、非同期ツール呼び出しです。
モデルは、アプリケーションが別のツールを実行している間も推論を続けたり、他のツールを呼び出したり、タスクの独立した部分に回答したりできます。そのツールが完了したら、アプリケーションは元の呼び出し識別子を使って結果をモデルに返します。
これにより、1つのツールに時間がかかるワークフローで不要な待機時間を減らせます。
この点からも、エージェント性能の飛躍は単にニューラルネットワークを大きくした結果ではなく、システムレベルの改善であることが分かります。
4.6 安全性はエージェントアーキテクチャの一部
自律的な実行能力が高まるほど、ミスのコストも増大します。
そのためOpenAIは、Astraにより強力な保護策とミスアラインメント監視を組み合わせています。安全性に関する資料では、Astraがクリティカルなサイバーセキュリティ能力のしきい値に分類されたOpenAI初のモデルであると説明しています。
OpenAIはまた、モデルが許可されたタスクの境界を越えるかどうかを測定するテストでも、行動が改善されたと報告しています。
開発者にとって、これはアーキテクチャに次の要素を含める必要があることを意味します。
- ツール権限を狭く設定する。
- 明確な認可境界を設ける。
- リスクの高い環境を分離する。
- 重要なアクションには人による確認を求める。
- 監視と監査ログを導入する。
- 信頼できる停止および緊急停止の仕組みを用意する。
より強力なエージェントモデルの登場によって、これらの制御は不要になるのではなく、むしろ重要になります。
重要な結論: Astraの飛躍は、エージェント向けに訓練されたモデルの行動が強化されたことと、より高性能な実行スタックが組み合わさった結果と捉えるのが最も正確です。推論と実行の連携はより緊密になりましたが、ハーネス、ツール、権限、環境は依然として分離されたエンジニアリング層です。
5. モデル選定と今後の展望
5.1 GPT-6 Astraへのアップグレードに価値があるのはどのような場合か
適した候補
次のような作業では、Astraは有力な選択肢です。
- 複雑なエージェントアプリケーション。
- 長時間実行される自動化ワークフロー。
- 実際のソフトウェアをまたぐコンピューター操作タスク。
- 大規模なソフトウェアエンジニアリングタスク。
- コードとツールを含む科学ワークフロー。
- CADおよびエンジニアリングの自動化。
- 高度な数学的推論。
- アクセスが許可された、認可済みの防御的サイバーセキュリティおよび脆弱性研究。
これらは、OpenAIが公開した評価でGPT-5.6 Solとの差が最も明確に示されている領域です。
通常は必要ないケース
次のような作業では、Astraは不要なことが多いでしょう。
- 定型的なコピーライティング。
- 単純な分類。
- 基本的な抽出。
- 大量処理が必要でリスクの低いカスタマーサポート。
- 単純なRAGによる質疑応答。
- 安価なモデルですでに品質要件を満たせる小規模な変換。
- Astraの高いトークン料金を、タスク完了率の向上によって正当化できないワークロード。
これらのシナリオでは、GPT-5.6 TerraまたはLunaをより経済的な開始点にできます。一方、Solは専門業務向けの有力なデフォルトモデルです。
5.2 コストはトークン単価だけでなく、完了タスク単位で測定する
Astraのトークン料金は入力10ドル、出力50ドルで、GPT-5.6 Solの入力4ドル、出力20ドルを大幅に上回ります。
しかし、エージェントワークフローでは、トークン単価が最も安いモデルを選べば常に最安になるとは限りません。
低価格のモデルでは、次のコストが増える可能性があります。
- 再試行の増加。
- ツール呼び出しの増加。
- 手作業による修正の増加。
- 人による監督の増加。
- タスク軌跡の長期化。
OpenAIによると、発表時の複数の評価において、Astraはより少ない出力トークンで高い結果を達成し、トークン単価が高いにもかかわらず、完了したベンチマークタスクあたりの推定APIコストが低くなる場合もありました。
本番環境でエージェントモデルを評価するには、次の考え方が適切です。
成功したタスクの総コスト
= モデルのトークン費用
+ ツール費用
+ 再試行費用
+ レイテンシー
+ 人によるレビュー
+ 失敗コスト
5.3 競争の指標はタスク完了へ移行している
元記事が示す大きな潮流は説得力があります。
長年、最先端モデルの比較では次の要素が重視されてきました。
- パラメーター規模。
- コンテキスト長。
- 静的な推論テスト。
- 一般的な会話品質。
- マルチモーダル入力。
これらは現在も重要です。
しかし次の段階では、次の問いがますます重視されます。
- モデルは数時間に及ぶタスクを完了できるか。
- ソフトウェアを安定して使えるか。
- ツール呼び出しの失敗後に復旧できるか。
- 認可の境界内にとどまれるか。
- 作業をインテリジェントに委任できるか。
- 作業中に新しい指示を取り込めるか。
- 提案ではなく完成した成果物を出せるか。
Astraは、この変化を示す最も明確な例の1つです。
5.4 「エージェントネイティブ」と「ハーネス不要」を混同しない
これは最も重要なエンジニアリング上の教訓です。
モデルが高いエージェント性を持っていても、ハーネスは必要です。
実際、モデルが複雑なタスクを実行する能力が高まるほど、適切に設計されたハーネスの価値は高まります。ハーネスは次の要素を提供するからです。
- 安全なツールアクセス。
- 信頼できる状態管理。
- コンテキスト管理。
- 並行実行。
- 承認。
- サンドボックス化。
- 可観測性。
- 復旧ロジック。
Astraがエージェントに強くなったからといって、開発者がエージェントエンジニアリングの学習をやめるべきではありません。
むしろ、より深く学ぶべきです。
5.5 最終的な見方
GPT-6 Astraを万能な代替モデルとして扱うべきでも、一般的な総合スコアが別の最先端モデルと近いからといって過小評価すべきでもありません。
Astraの最大の価値は、問題がプロンプトではなくワークフローである場合に現れます。
アプリケーションが主に短い回答を必要とするなら、安価なモデルの方が適切なエンジニアリング上の選択になる可能性があります。
一方、アプリケーションがAIシステムに対して、多くのステップにわたって調査、判断、実行、検証、復旧、継続を求めるなら、Astraははるかに興味深い選択肢です。
それが、この世代交代が示す本当の意味です。
FAQ
GPT-6 Astraとは何ですか?
GPT-6 Astraは、難度の高いエンドツーエンドの作業向けに設計された、OpenAIの現在のフラッグシップモデルです。OpenAIは、複雑な推論、コーディング、コンピューター操作、調査、専門業務、ツールを多用するエージェントタスク向けにAstraを位置付けています。
GPT-6 Astraは本当に「ネイティブなエージェント」モデルですか?
エージェントハーネス全体がモデル内に存在すると説明するより、Astraをエージェント向けに最適化されたモデルと呼ぶ方が正確です。Astraは複数ステップの作業、ツール利用、サブエージェントへの委任向けに訓練されています。一方、Codex、ChatGPT Work、または独自アプリケーションが、外部ハーネス、ツール、権限、実行環境を提供します。
GPT-6 AstraのAPIモデルIDは何ですか?
APIモデルIDはgpt-6-astraです。OpenAIは現在、Responses APIとChat Completionsを通じて提供していますが、Astraのツール呼び出しについてはResponses APIを中心に文書化しています。
GPT-6 Astraの料金はいくらですか?
標準API料金は、入力100万トークンあたり10ドル、出力100万トークンあたり50ドルです。キャッシュ済み入力は100万トークンあたり1ドル、キャッシュ書き込みは12.50ドルです。入力が272Kトークンを超えるリクエストには、現在の料金ルールに基づき、より高い長文コンテキスト料金が適用されます。
GPT-6 AstraはGPT-5.6 Solとどう違いますか?
Astraは、ARC-AGI-3、AutomationBench、Terminal-Bench Science、最近のサイバーセキュリティタスクなど、公開されている複数のエージェント型および環境操作型の評価で大幅に高い性能を示しています。Solは大幅に安価であり、Astraレベルのタスク実行が必要ない場合、一般的な専門業務の推論やコーディングに適した強力な選択肢です。
GPT-6 AstraはClaude Fable 5.1とどう違いますか?
どちらも、複雑で長時間にわたる作業向けに設計された最先端モデルです。Astraは現在、OpenAIのコンピューター操作、業務自動化、科学、CAD、サイバーセキュリティ比較で特に強い結果を示しています。一方、Claude Fable 5.1はコーディングと知識業務で非常に高い能力を持ち、指数のバージョンや推論設定によっては、最近のArtificial Analysis総合評価で首位となっています。
GPT-6 Astraのコンテキストウィンドウはどのくらいですか?
OpenAIは、最大128,000トークンの出力に対応する1,050,000トークンのコンテキストウィンドウを文書化しています。非常に長いリクエストには高い料金が適用されるため、開発者は長時間のエージェントワークフローで、コンパクションと永続的な外部状態も利用すべきです。
より安価なモデルではなくAstraを選ぶべきなのはいつですか?
難度の高い複数ステップの作業で、完了率の向上がプレミアム料金を正当化できる場合にAstraを選びます。定型的な抽出、サポート、コピーライティング、単純なRAG、大量処理が必要でリスクの低いタスクでは、通常は低コストモデルから始める方が適切です。
関連ツール
- OpenAI Responses API:GPT-6 Astraを使うツール中心および状態を保持するエージェントワークフロー向けの主要APIです。
- OpenAI Codex:最先端モデルを外部のエージェント型ハーネスや開発ツールと組み合わせた、OpenAIのコーディングエージェント環境です。
- GPT-6 Astraモデルページ:公式のモデル仕様、料金、コンテキストウィンドウ、ツール、レート制限を確認できます。
- Anthropic Claude:コーディング、知識業務、視覚理解、長時間実行エージェント向けのClaude Fable 5.1公式製品ページです。
- Artificial Analysis:モデルベンチマークとAPI性能を独立して比較するプラットフォームです。
- ARC Prize:インタラクティブな抽象推論ベンチマークを含むARC-AGI評価を運営する組織です。
関連リンク
- OpenAI:GPT-6 Astra — 新世代のインテリジェンス:公式発表、ベンチマーク表、提供状況、料金に関する情報です。
- OpenAI GPT-6 Astraモデルドキュメント:公式APIモデルの詳細、対応ツール、コンテキスト制限、トークン料金です。
- OpenAI GPT-6 Astraモデルガイダンス:非同期ツール、ターン途中の指示変更、サブエージェント委任、プロンプト、移行に関する公式ガイダンスです。
- GPT-6 AstraのOpenAI安全性概要:Astraの安全性と導入に関する概要情報です。
- OpenAI:Astraへの道 — クリティカル能力とフロンティア保護策:Astraのサイバーセキュリティ能力評価と保護策の背景です。
- Anthropic Claude Fable 5.1:Fable 5.1の公式提供状況、料金、用途、保護策、ベンチマーク情報です。
- Artificial Analysis:GPT-6 Astra:Astraの独立した性能、料金、Intelligence Indexの推移を確認できます。
- 元のCSDN記事:CC BY-SA 4.0で許諾された元記事です。
まとめ
GPT-6 Astraはエージェント型ワークフローにおける重要な前進ですが、最も正確な説明は「OpenAIがエージェントハーネス全体をモデル内に組み込んだ」というものではありません。Astraは長時間にわたる複数ステップの実行に適した訓練を受けており、Codex、ChatGPT Work、Responses API、独自アプリケーションが、その周囲でオーケストレーション、ツール、権限、環境を提供します。
公開された評価で特に大きな改善が見られるのは、インタラクティブ推論、コンピューター操作、専門業務の自動化、科学ワークフロー、CAD、サイバーセキュリティです。広範な総合知能指標では、他の最先端モデルとの差がはるかに小さい場合もあります。そのため、Astraが日常的な作業向けの安価なモデルを自動的に置き換えるわけではありません。
開発者にとっての戦略的な変化は明確です。モデル選定では、チャット画面上の回答品質だけでなく、システム内でタスクを成功裏に完了できるかがますます重要になります。
GPT-6 Astraが最も重要になるのは、問題が「AIは何と言うべきか」ではなく、「AIは安全に作業を最初から最後まで遂行できるか」になったときです。


